
speech-training-recorder
daanzu/speech-training-recorder加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
深夜,你终于拿到了公司 GPU 集群的训练好的语音识别模型 Demo,满怀期待地对着麦克风说了一句"打开文档"——模型却毫无反应。第二天你排查日志,发现训练数据里全是新闻播音员的标准普通话,而你的用户说的都是带口音的"川普""东北话""粤语文"。模型再强,也治不了训练数据的"偏食症"。
语音模型的性能上限,由训练数据的质量和多样性直接决定。 这就是 daanzu/speech-training-recorder 存在的意义:它让你用最简单的方式,批量录制贴合真实使用场景的高质量语音训练数据。
Speech Training Recorder 由开发者 daanzu 创建,定位是一个轻量级语音训练数据采集工具。作者同时维护了 kaldi-active-grammar 和 kaldi_ag_training 等语音相关项目,构成了一套从数据录制到模型训练到实际部署的完整工具链。
该项目在 2020 年曾在 Hacker News 上引发讨论,众多语音 ML 研究者认可其设计思路:比起购买商业数据集,自己录制的数据更贴合特定场景(如医疗口述、工业指令),成本也更低。
用户只需准备一个纯文本提示词文件(每行一句话),工具会:
.wav 文件)recorder.tsv 元数据文件(记录每条音频对应的文本)内置三个提示词文件,覆盖不同场景:
timit.txt:TIMIT 语料库标准句子集(学术研究标准)arctic.txt:CMU Arctic 数据集句子(语音合成研究常用)rainbow_passage.txt:彩虹段落(语音病理学评估标准文本)用户也可以自定义提示词文件,灵活适配自己的业务场景。
| 参数 | 说明 |
|---|---|
-p | 指定提示词文件路径 |
-d | 录音保存目录 |
-c | 每次训练会话的句子数量 |
-l | 句子长度软上限(字符数) |
-o | 改为顺序朗读(不打乱) |
录制完成后,用户可以:
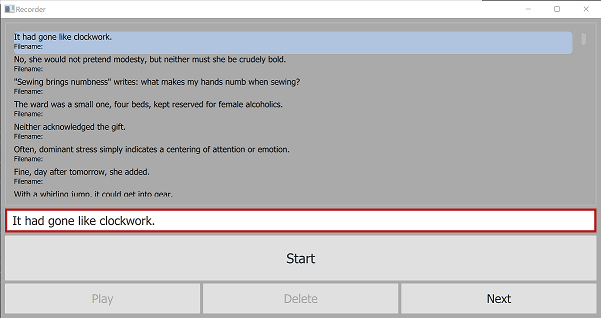
项目代码结构非常简洁,仅三个核心文件:
| 文件 | 职责 |
|---|---|
recorder.py | 主入口,QML GUI 界面逻辑,命令行参数解析 |
audio.py | 音频录制核心(基于 PyAudio) |
recorder.qml | Qt/QML 界面描述文件 |
技术栈:
.py 各约 200-300 行),可读性强优势:
局限:
由于是桌面 GUI 应用,不支持 Docker 快速部署,也没有 Web 接口。最直接的运行方式:
git clone https://github.com/daanzu/speech-training-recorder.git
cd speech-training-recorder
pip install -r requirements.txt
python3 recorder.py -p prompts/timit.txt
需要 Python 3 环境 + 物理麦克风输入。适合个人研究者或小型团队在本地机器上使用。
语音模型训练的数据采集,长期被商业数据集垄断(LibriSpeech、Common Voice 等)。但这些通用数据集有两个天然缺陷:
Speech Training Recorder 提供了一个最小化的自采集路径:5 行命令,10 分钟配置,立刻开始录制自己的语音数据。对于需要个性化语音模型的团队,这个工具的实用价值远超其 41 颗星所反映的流行度。
| 维度 | 评分 | 说明 |
|---|---|---|
| 部署便捷度 | ⭐ | 纯桌面 GUI,无容器化,需本地 Python 环境 |
| 功能完整性 | ⭐⭐⭐ | 覆盖录制-回放-重录全流程,支持自定义提示词 |
| 代码质量 | ⭐⭐⭐ | 代码简洁透明,逻辑清晰,无多余依赖 |
| 场景适配性 | ⭐⭐⭐⭐ | 垂直场景语音数据自采集的轻量首选工具 |
如果你正在训练医疗语音助手、方言语音识别、游戏 NPC 对话系统,或者任何通用数据集无法覆盖的场景,又或者你关心数据隐私和版权合规,Speech Training Recorder 是值得一试的起点。
