
VelesDB
cyberlife-coder/VelesDB加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你正在用 Claude Code 开发一个大型项目,凌晨 2 点,你问它:"之前我们讨论过数据库选型,你为什么最后选了 VelesDB?"
Claude 沉默了很久,然后给出一个似是而非的答案——因为它根本想不起来。
这不是模型的错。GPT-4o、Claude 3.5 的上下文窗口再大,也装不下你整个开发生涯的记忆。更关键的是:即使有记忆,那些记忆是否可信?AI 为什么会选择某个答案——这本身就是个黑盒。
VelesDB 正在解决这个问题。
开发团队来自法国公司 Wiscale(联系邮箱 contact@wiscale.fr),创始人 Julien Lange 在 2024 年初意识到一个根本矛盾:今天的 AI 开发者想给 AI 代理加上记忆,需要同时部署 pgvector(向量检索)+ Neo4j(图数据库)+ PostgreSQL(结构化数据),写一堆胶水代码,配置三个不同的查询语言。
这就是"数据库地狱"(Database Hell)。而触发他动手的导火索,是 2022 年美国《云法案》(CLOUD Act)的出台——美国政府可以合法要求任何美国云服务商交出存在其服务器上的欧盟用户数据,无论数据中心在哪里。
这让数据主权从一个法律概念变成了工程问题。VelesDB 的第一个设计原则由此诞生:数据永远不离开你的机器。
VelesDB 的核心创新是在一个 ~9MB 的单二进制文件中融合了三种数据库引擎:
使用 HNSW(Hierarchical Navigable Small World)算法进行近似最近邻搜索,支持 AVX2/NEON SIMD 加速。在 x86-64 平台上,查询延迟可低至微秒级。
支持原生的 MATCH 子句,可以表达复杂的关系查询。例如:
MATCH (doc:Document)-[:AUTHORED_BY]->(author:Person)
WHERE similarity(doc.embedding, $question) > 0.8
  AND author.department = 'Engineering'
RETURN author.name, doc.title
提供带类型的列级索引,支持精确过滤和聚合。
三种引擎背后共享同一套 VelesSQL 查询语言,上层的 MemoryService API 将三者融合成一个统一接口。
这是 VelesDB 最令人印象深刻的设计。
传统向量数据库的 recall() 只做语义相似度匹配——找到"看起来像"的文本。但 why() 方法不同:它从最佳匹配出发,然后沿着图中的关系边向外扩展,找到解释该答案的其他事实。
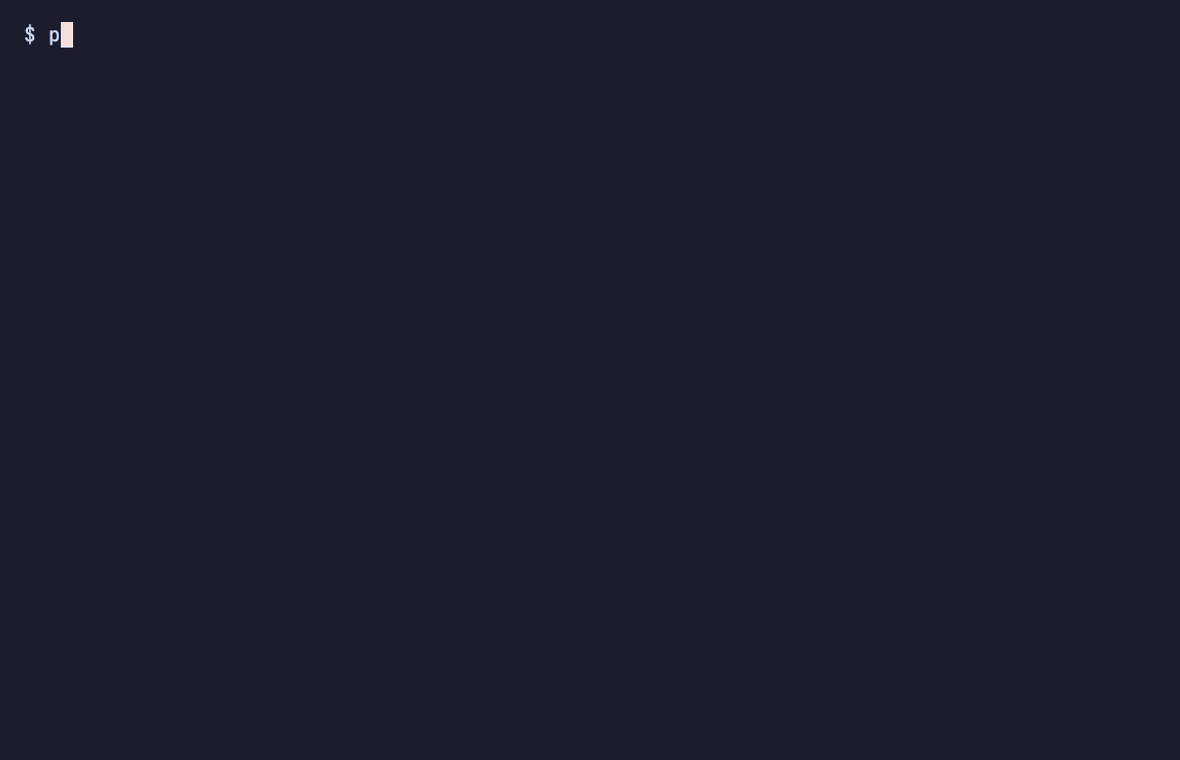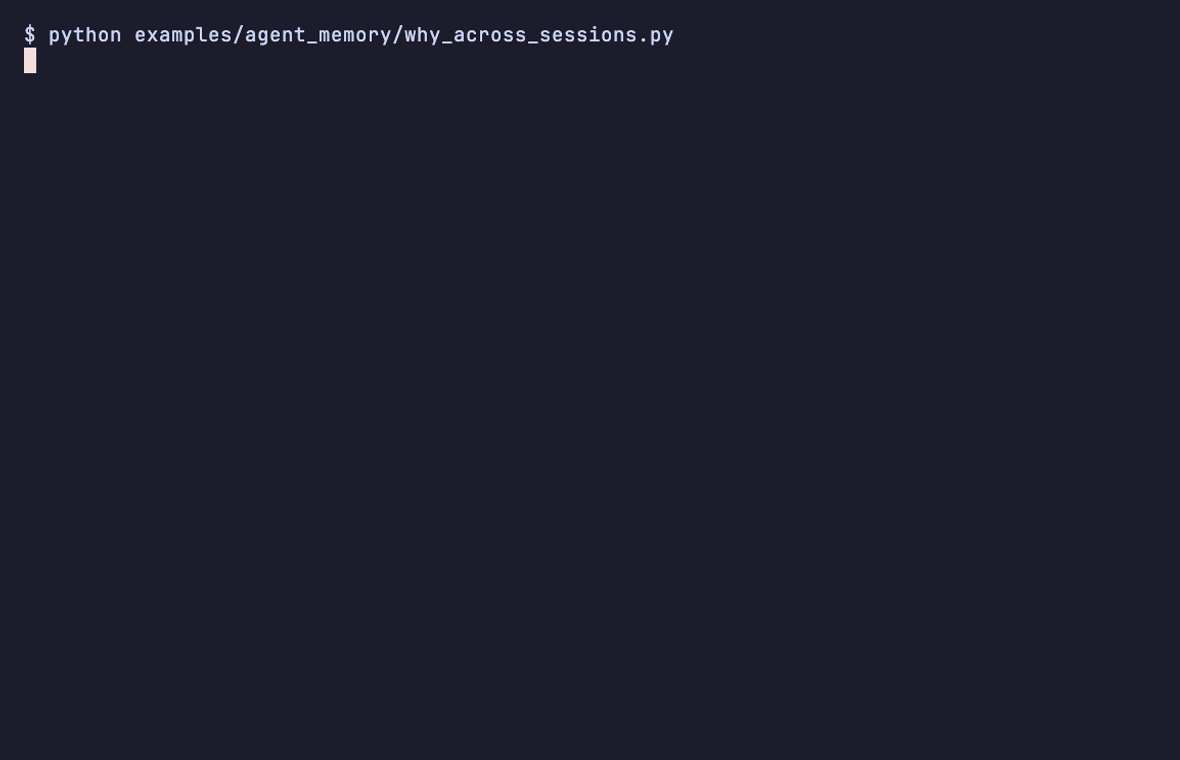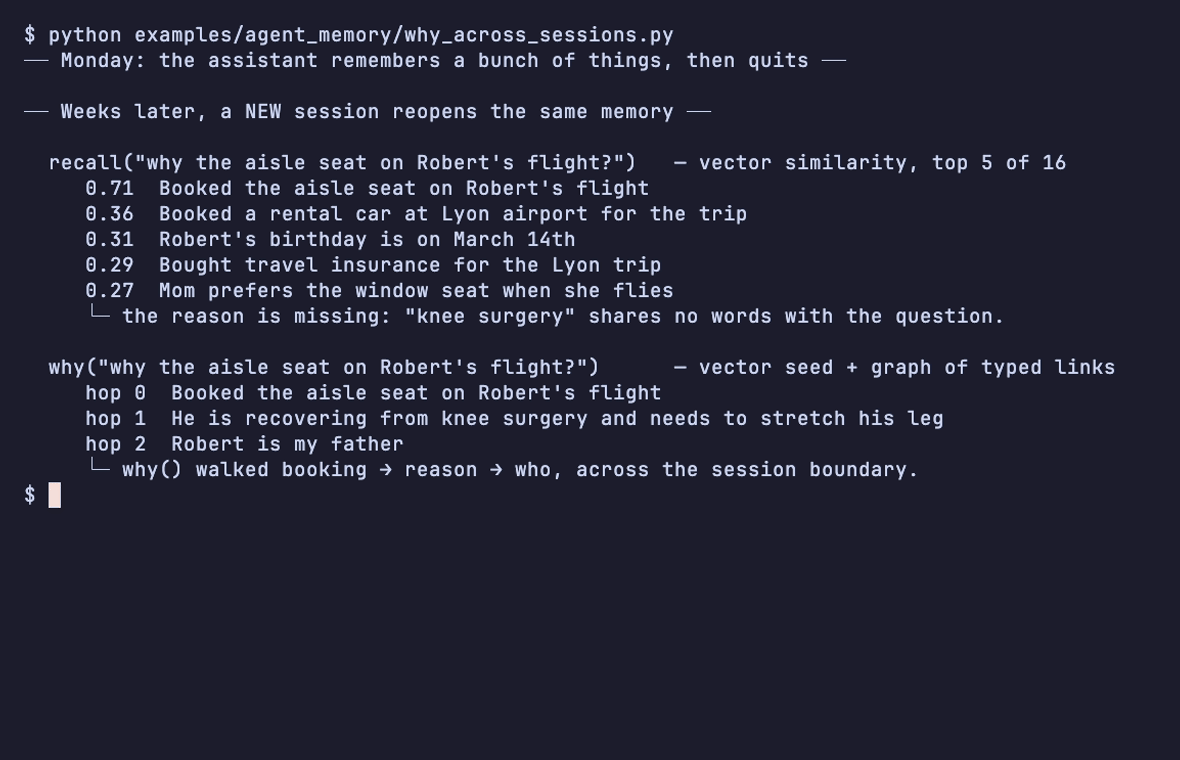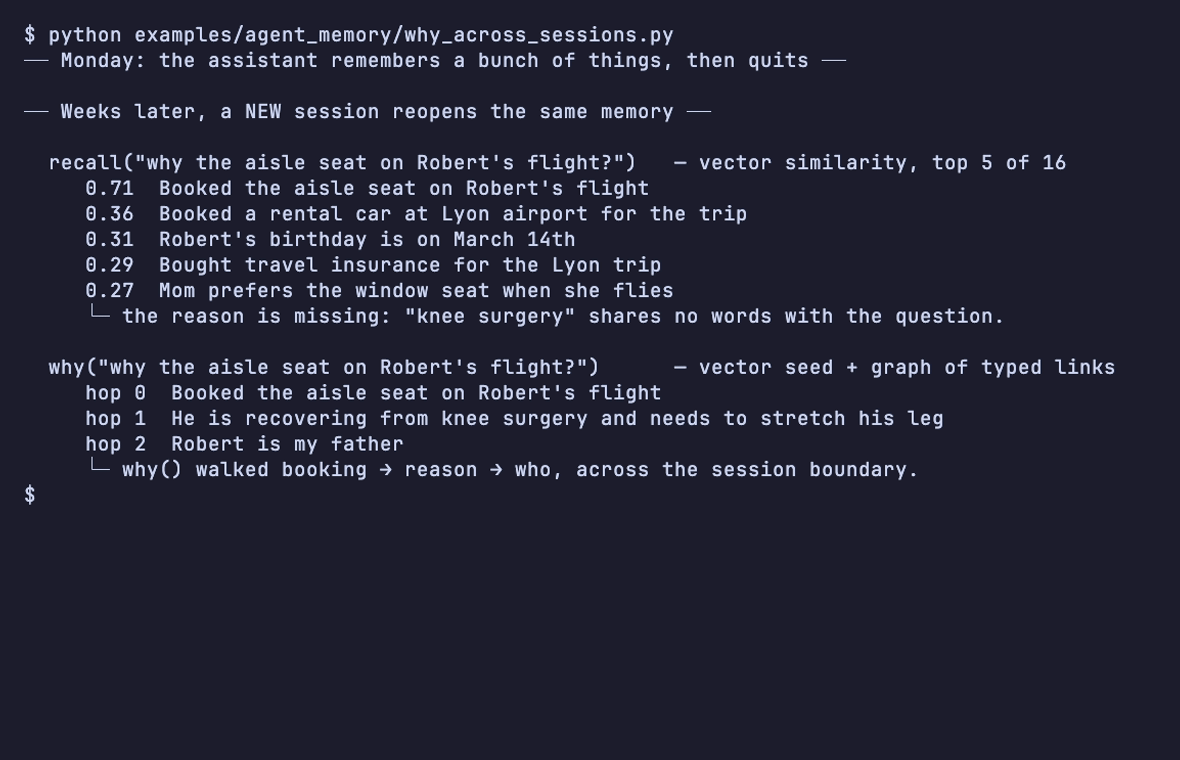
一个真实的例子:
# Session A:
mem.remember("Robert 膝盖手术恢复中")
mem.remember("Robert 预订了靠过道的座位", links=[(reason_id, "因为")])

# Session B(几天后,新的进程):
mem.why("为什么 Robert 预订了靠过道的座位?")
→ 返回:因为他膝盖手术恢复中
即使新进程重新打开同一个存储,why() 依然能找到原因——因为图中的边没有被遗忘。这是语义相似度搜索做不到的事。
2026 年 8 月,欧盟 AI Act(《人工智能法案》)正式强制执行。其中对"高风险 AI 系统"有一条要求:必须能够解释为什么做出某个决策。
VelesDB 的 why() 方法和确定性上下文编译器天然满足这一要求——每个压缩决策都记录了规则 ID、原因和风险等级,可随时通过 explain_compilation 重新推导。这不是"获得认证",而是"帮助满足"合规要求。
VelesDB 提供六种安装方式,覆盖了从零依赖到专业部署的全部场景:
| 安装方式 | 适用场景 | 命令 |
|---|---|---|
| pip | Python 应用 | pip install velesdb |
| cargo | Rust 应用/服务器 | cargo install velesdb-server velesdb-cli |
| npm | Node.js 应用 | npm i @wiscale/velesdb-sdk |
| Docker | 一键部署 | docker run -d -p 8080:8080 velesdb/velesdb:latest |
| MCP Server | AI 代理集成 | Claude Code / Codex CLI 等 |
| WASM | 浏览器端 | ~674KB gzipped,客户端运行 |
项目在质量保障上投入了大量工程资源:Codacy 代码覆盖率追踪、Clippy Rust linter、Semgrep 安全扫描、Gitleaks 敏感信息检测、GitHub Actions CI 多平台测试、Criterion 性能基准测试框架。多架构 Docker 镜像支持(linux/amd64 + linux/arm64),确保 Apple Silicon Mac 也能直接使用。
项目对主流 AI 开发框架均有官方集成:LangChain、LlamaIndex、Haystack、LangGraph。还有 Claude Code 的 MCP(Model Context Protocol)集成,Windsurf、Devin CLI 等代理工具也支持。
项目在 README 中坦承了当前版本的一些限制:
why() 的表现和普通搜索无异。需要配合 remember_extracted() 处理段落级别的输入,自动建立关系链接。VelesDB 代表了一个正在壮大的趋势:将 AI 记忆从云端移到本地。这不仅是隐私考量,更是一种架构哲学——数据主权、可审计性、低延迟。
项目在 GitHub 上快速增长,收获了 Rust、向量数据库、AI Agent 三个社区的关注。考虑到 Mem0(类似定位的 Python 项目)已有大量用户基础,VelesDB 作为 Rust 实现,在性能和可移植性上具有天然优势。
未来随着 EU AI Act 的强制执行和全球数据隐私法规的收紧,类似 VelesDB 这样的本地优先数据引擎,将会变得越来越重要。
