
quickstart-streaming-agents
confluentinc/quickstart-streaming-agents加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样的场景:一家电商平台,每秒处理数千笔订单。当竞争对手悄悄降价,传统的做法是人工监控、手动调价——等你发现时,订单早已流失。
Streaming Agents on Confluent Cloud 带来了一种全新的解题思路:让 AI Agent 实时"监听"Kafka 数据流,当检测到竞品价格变化时,自动调用 MCP(Magnetic Codeless Platform)工具抓取数据、匹配价格,并在毫秒级触发邮件通知。整个过程无需人工干预,全部在 Confluent Cloud 的托管 Apache Flink 引擎上运行。
这是由 Confluent(Kafka 创始公司)官方出品的快速入门项目,将事件驱动架构与Agentic AI深度融合,展示了在大规模数据流场景下如何构建真正生产级别的 AI Agent 系统。
Apache Kafka 诞生之初,解决的是"海量数据的高速传输"问题。但当 AI 时代到来,一个新的挑战浮现:如何在数据流动的过程中,让 AI 模型实时"看到"数据、做出决策、触发行动?
传统做法是"批处理"——先把数据存下来,再做分析。但这有延迟,在价格监控、欺诈检测、风控告警等场景,延迟等于损失。
Confluent Cloud 的答案是:让 Flink(Flink on Confluent)直接在流上跑 AI 推理。Flink 是流处理领域的工业标准,Confluent 将其做成托管服务,你无需运维集群,直接写 SQL 或 Python UDF,就能让 AI 模型参与每一次事件处理。
这个项目包含四个循序渐进的手把手实验(Lab),覆盖了流式 AI Agent 的主流应用场景:
这是整个项目的核心 demo。一个 Agent 监听 Kafka 中 incoming 的订单流,通过 MCP 协议调用远程 MCP Server,自动抓取竞品网站价格。如果发现竞品更便宜,Agent 立即执行价格匹配,并通过 Gmail SMTP 发送通知邮件给客户。
架构清晰:Kafka → Flink(Agent 逻辑)→ MCP Server(远程工具)→ Gmail。
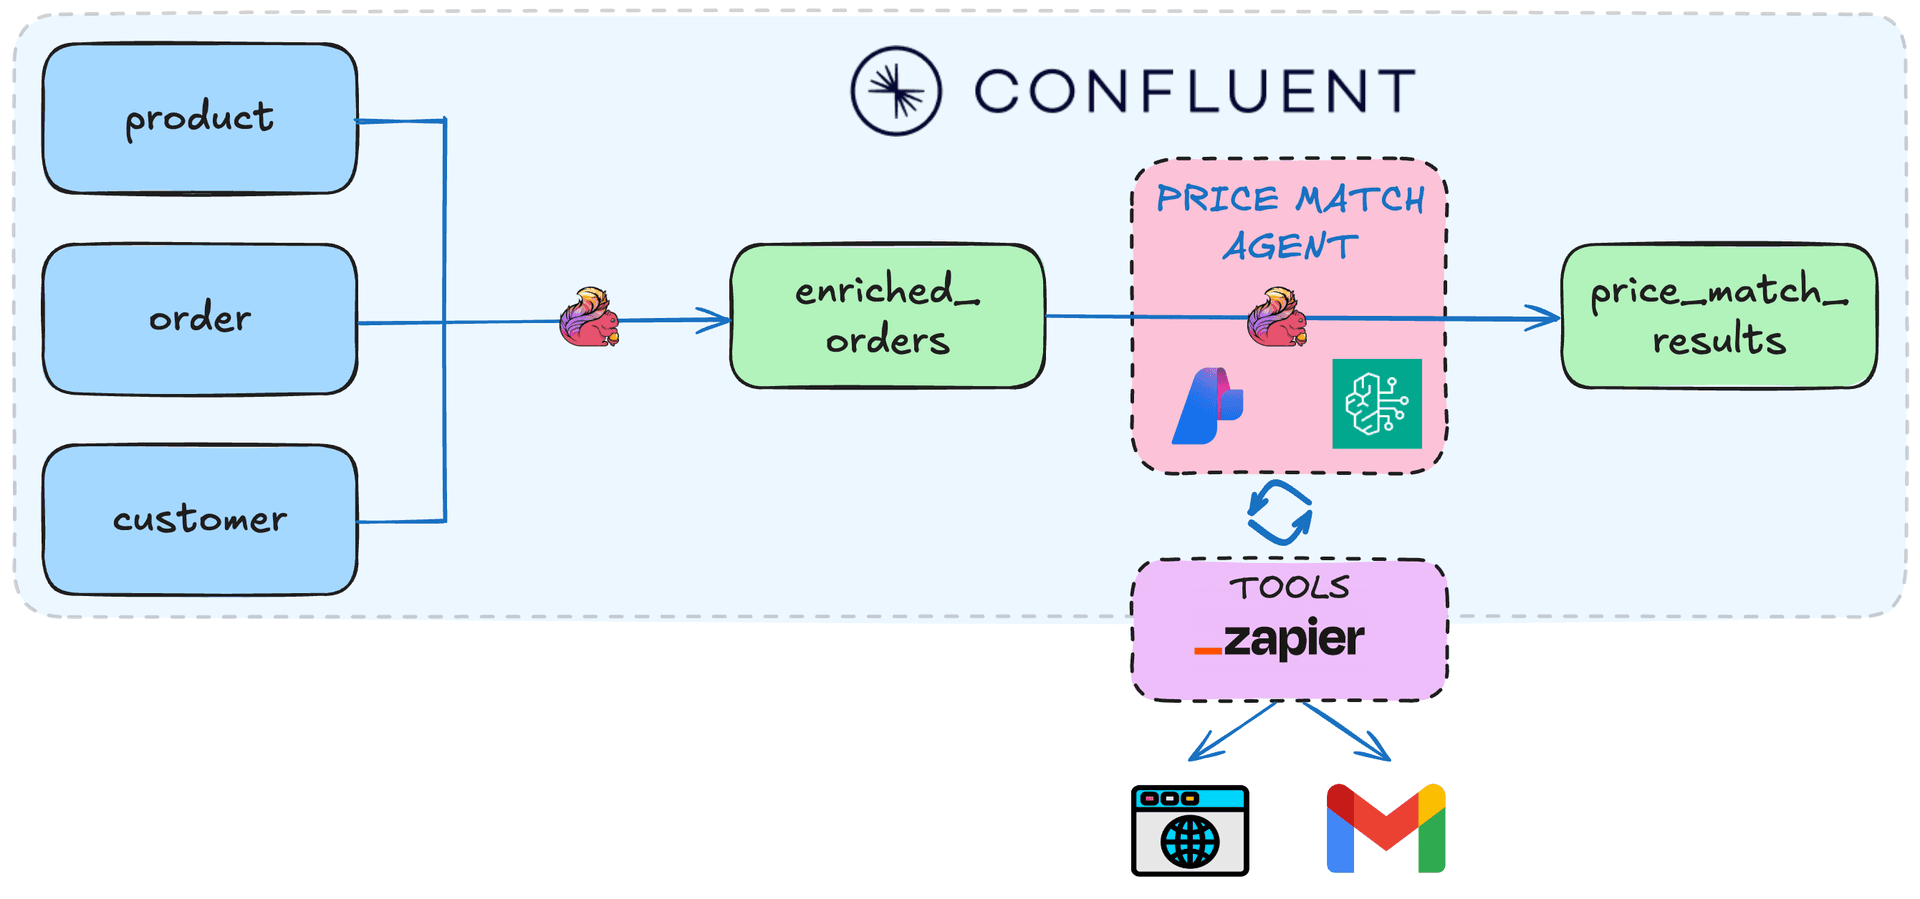 Lab1 架构:订单流经 Flink 处理后,Agent 通过 MCP 协议调用远程竞品价格查询和邮件发送工具
将向量数据库(基于 Confluent 的语义搜索功能)引入数据流 pipeline。Flink 作业将输入数据转换为 embedding,存储到向量索引中,LLM 在推理时实时检索最相关的上下文,实现 RAG(检索增强生成)。
这一场景适合:客服对话系统、文档问答、产品推荐——所有需要结合企业私有数据做实时推理的场景。
一个端到端的船队管理演示,同时展示了 Agent Definition(CREATE AGENT 语法)、MCP 工具调用、向量搜索和异常检测四大能力。Flink 内置了 Confluent Intelligence 异常检测函数,Agent 可以自动识别船队运营中的异常行为。
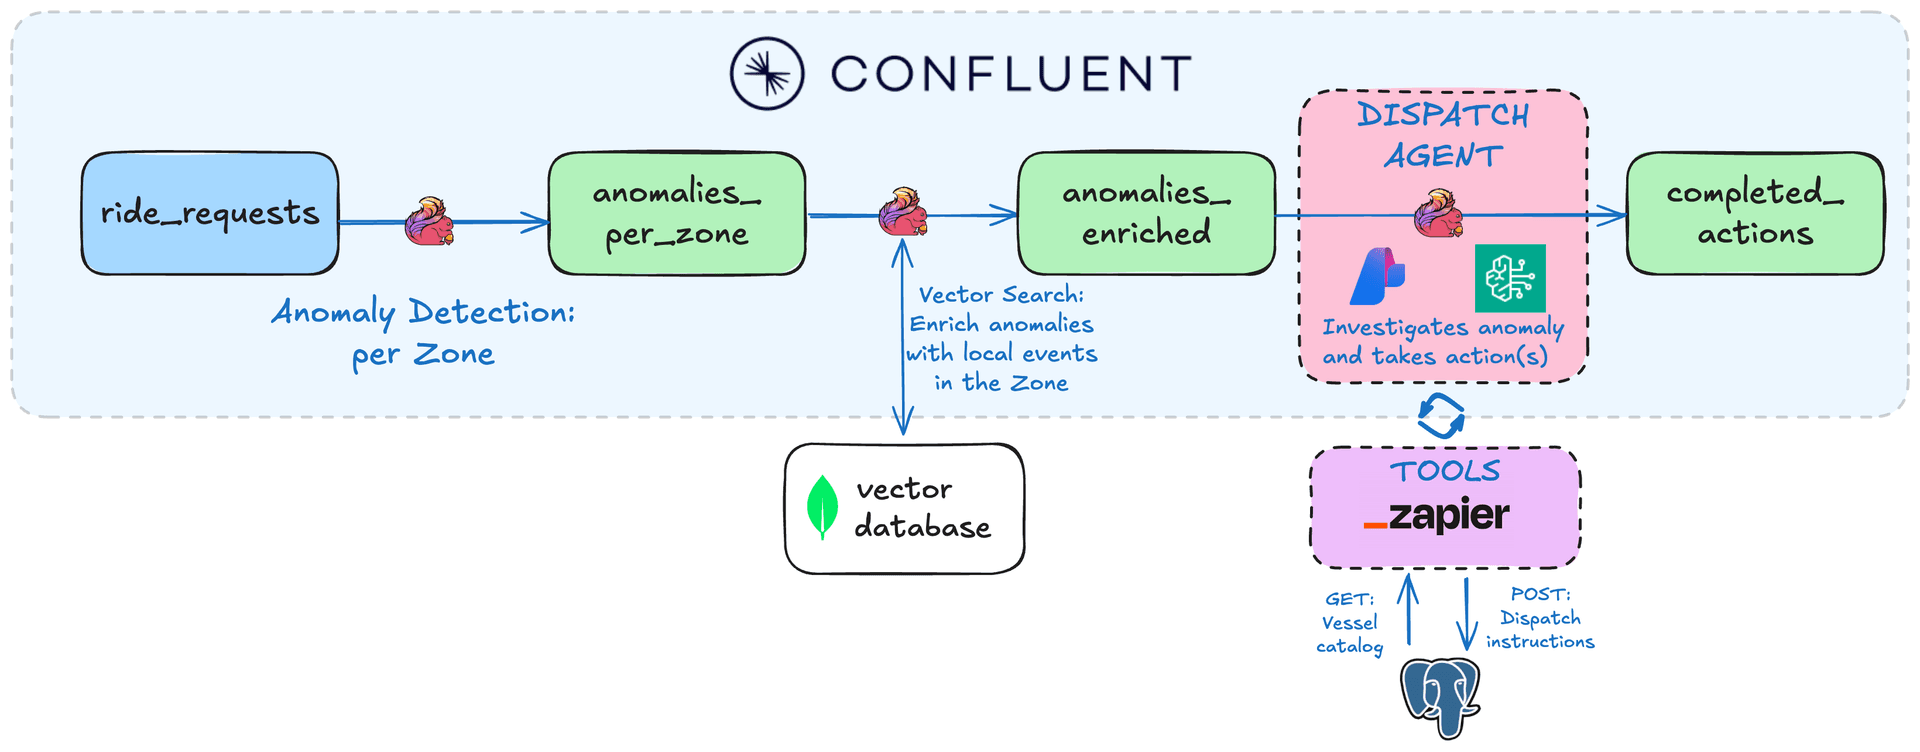 Lab3 展示了在 Confluent Cloud 上部署的完整 AI Agent 系统架构
针对灾难保险理赔场景的实时欺诈检测系统。使用异常检测 + 模式识别 + LLM 分析三重能力,自动识别可疑理赔模式。
Python 3.10+ 作为主开发语言,通过 confluent-kafka 库与 Kafka 集群交互。
Apache Flink on Confluent Cloud 是整个架构的核心执行引擎。区别于开源 Flink 需要自己运维集群,Confluent Cloud 的 Flink 提供完全托管的 SQL 工作区,开发者可以直接写 SELECT ... FROM ... LATERAL TABLE(ML_PREDICT(...)) 这样的 SQL 语句,让 AI 推理嵌入流处理管道。
AI 模型层支持两套主流方案:
MCP 协议(Magnetic Codeless Platform)是项目的重要亮点。MCP 提供了一种标准化的方式让 Flink Agent 调用外部工具——远程 HTTP 抓取、Gmail 发送邮件、MongoDB 查询等。Confluent 提供了官方托管的 MCP Server,用户也可以接入 Zapier 等第三方 MCP 生态。
向量搜索基于 Confluent Cloud 的语义搜索功能,无需额外部署向量数据库,Flink 作业直接写入语义索引。
Terraform 负责所有云端基础设施的代码化管理:Core 模块(共享基础设施)+ 每个 Lab 独立模块。从 Confluent 环境到 Kafka 集群、Flink 计算资源,全部自动化创建。
terraform/
  core/               # Confluent 环境、Kafka 集群、VPC 等共享基础设施
  lab1-tool-calling/  # Lab1 专用 MCP Server + Flink 作业
  lab2-vector-search/ # Lab2 向量搜索 pipeline
  lab3-agentic-fleet-management/ # Lab3 船队管理
  lab4-pubsec-fraud-agents/      # Lab4 欺诈检测

scripts/
  common/             # 共享凭证管理、Terraform 运行器、UI 提示
  lab1_datagen.py     # 订单数据生成器
  lab2_publish_queries.py # RAG 查询发布
  lab3_datagen.py     # 船队数据生成器
  mcp_setup.py        # MCP Server 配置
  run_tests.py        # 测试框架

deploy.py             # 主入口,一行命令部署全部
代码质量方面,项目结构清晰,Python 依赖通过 pyproject.toml 管理(hatchling 构建系统),支持 uv 包管理器(比 pip 快 10 倍)。开发依赖包含 pytest、black、flake8、mypy、pre-commit 等完整工程化工具链,贡献规范明确。
虽然项目大量使用了 LLM 推理(Bedrock/Azure OpenAI),但并未依赖 LangChain、LlamaIndex 等主流 Python AI 框架,而是通过 Confluent Cloud 内置的 ML_PREDICT 和 AI_TOOL_INVOKE 函数直接调用模型。这种做法将 AI 逻辑与流处理逻辑深度耦合,避免了中间层的性能开销。
uv run deploy 一条命令自动完成凭证填充 + Terraform 部署这个项目的价值不只是技术 demo,更代表了一种新的系统设计思路:让 AI 推理从"事后分析"变成"实时决策"。
在金融风控、实时定价、IoT 监控、网络安全等领域,事件驱动 AI Agent 正在快速落地。Confluent 将 Kafka 的流处理能力与 LLM 结合,为这一趋势提供了可参考的架构范式。
从 GitHub 数据来看,该仓库创建于 2025 年 8 月,Topics 包含了 agentic-ai、agentic-framework、bedrock、claude、flink 等关键词,反映了当前 AI 行业对流式 Agent 架构的高度关注。
# 1. 克隆仓库
git clone https://github.com/confluentinc/quickstart-streaming-agents.git
cd quickstart-streaming-agents

# 2. 自动生成云端凭证
uv run api-keys create

# 3. 一键部署(交互式选择 Lab)
uv run deploy
# 选择 Lab1-4 中的任意一个,等待 Terraform 创建资源

# 4. 在 Confluent Cloud SQL Workspace 运行 Flink 查询测试
详细操作步骤请参考各 Lab 的 Walkthrough 文档(LAB1-Walkthrough.md ~ LAB4-Walkthrough.md)。
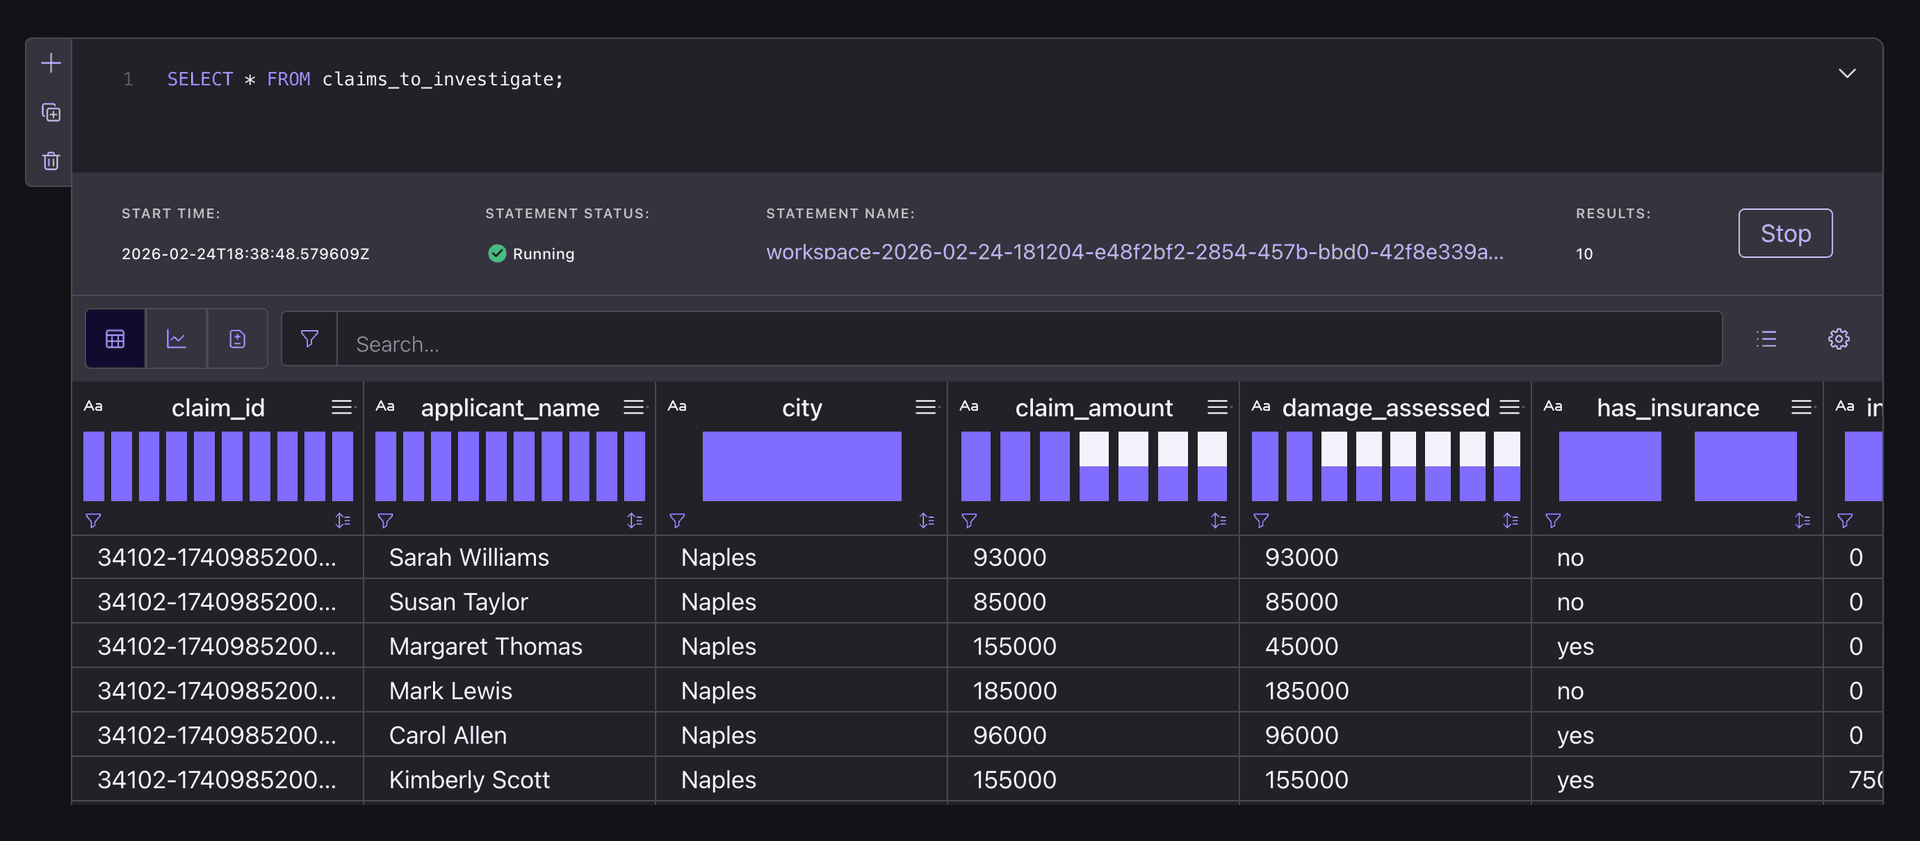 Lab4 的欺诈检测可视化界面,展示可疑理赔的自动识别结果
