
lora
cloneofsimo/lora加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2022 年底,一个叫 Simo Ryu 的韩国研究者在 Reddit 上抛出一个反常识的观察:Stable Diffusion 的社区微调模型太重了。
当时的现实是这样的——想在 SD 1.5 上加一个"迪士尼画风",用 DreamBooth 全量微调,产出物是一个 2~7GB 的完整 checkpoint。你想换一种风格?重新下 7GB。你想试 5 种风格?35GB 的流量包和一张显存塞不下的显卡。
Ryu 的方案来自一个当时刚在 NLP 圈爆火的思想:低秩适配(LoRA)。它的核心断言是——微调不需要改动全部权重,只需要学一个"残差",而这个残差可以被分解成两个极瘦的矩阵相乘。
$W' = W + \Delta W$,其中 $\Delta W = AB^T$,$A \in \mathbb{R}^{n \times d}$,$B \in \mathbb{R}^{m \times d}$,且 $d \ll n$。
用生活类比:原模型是一栋 100 层的摩天大楼,你不想拆楼重建(那要花几周时间和巨额成本),你只是在楼外挂了一块"主题皮肤贴纸"——一块只有几 MB 的补丁,随时撕下来换另一张。
效果是:微调速度比 DreamBooth 快约一倍,产物只有 1MB~6MB。这就是 cloneofsimo/lora,GitHub 7,557 星、497 fork、Apache-2.0 协议,至今仍是该领域被引用最多的原始实现之一。
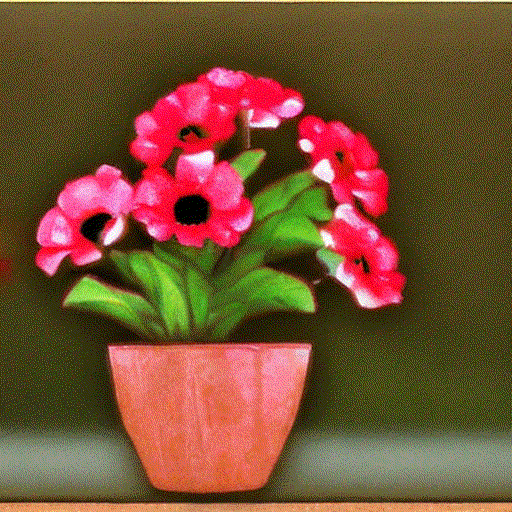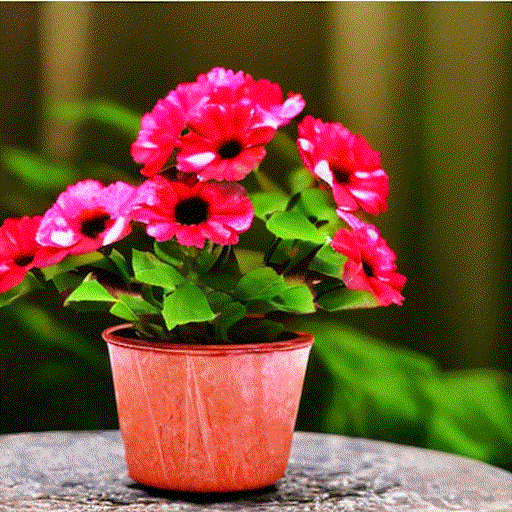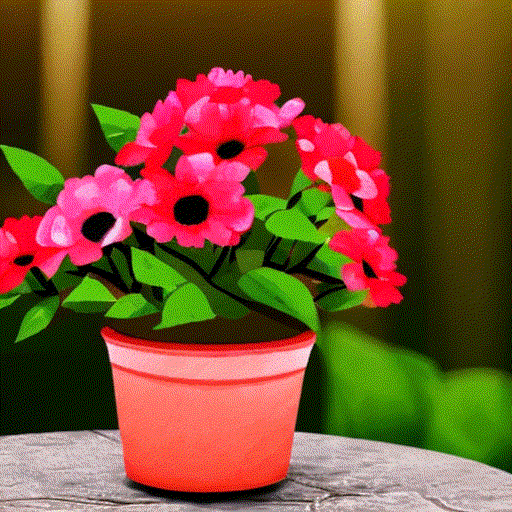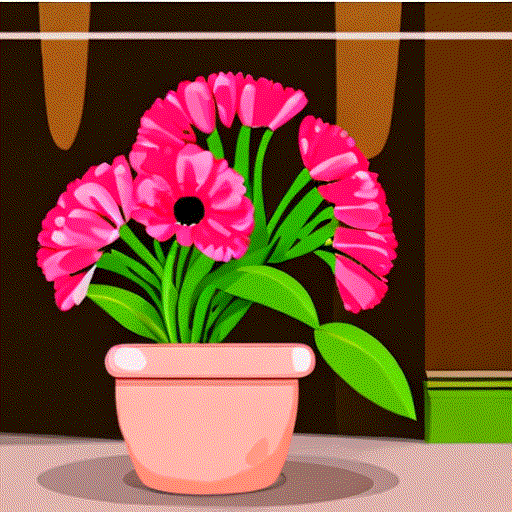
图注:把 α 从 0 调到 1,即从"原模型"连续过渡到"完全微调模型",这是 LoRA 相比全量微调独有的可控性
LoRA 论文《Low-Rank Adaptation of Large Language Models》(arXiv:2106.09685)原本是给大语言模型设计的,仓库的 homepage 也直接指向了这篇论文。Ryu 的贡献是把这套方法平移到扩散模型的 UNet 和 CLIP 文本编码器上,并且做了一件社区此前做不到的事:让微调产物小到可以直接在社交群里传。
但要理解这个仓库为什么长成今天这样,得先看它内部的三条技术路线:
train_lora_dreambooth.py):在 UNet 的注意力层注入 LoRA,同时用先验保持类(prior preservation class images)做正则化,防止模型过拟合到具体图片上。train_lora_w_ti.py):LoRA 本身没法用于文本嵌入,但这个仓库把它和文本反演组合,用 --train_text_encoder 让 CLIP 也参与低秩微调。cli_lora_pti.py):仓库作者自称"效果最好"的路线,把文本反演得到的 token 嵌入 + 先验保持类图像 + LoRA 三者合一,README 明确说这是 DreamBooth 和 Textual Inversion 的严格泛化。这三条路线对应 setup.py 里注册的四个命令行入口:lora_pti、lora_add、lora_distill(SVD 蒸馏,把训好的全量模型压回 LoRA)、lora_ppim(图像预处理)。
这个仓库最被低估的能力是 LoRA 的可组合性。
因为 LoRA 权重是矩阵增量而非模型本身,数学上多个 LoRA 可以直接相加:
$\Delta W = (\alpha_1 A_1 + \alpha_2 A_2)(\alpha_1 B_1 + \alpha_2 B_2)^T$
lora_add 命令行提供三种模式:
upl:把 LoRA 合并进完整模型(支持本地路径或 HF 模型名)lpl:LoRA 合并 LoRA,输出新的 LoRAupl-ckpt-v2:合并后转成 A1111 传统 ckpt 格式这意味着社区可以"搭积木":一个角色 LoRA + 一个画风 LoRA + 一个服装 LoRA,各自在 1MB 级别,按权重混合出一款新的定制模型,随用随拆。README 里的经典例子就是"小狮子 + 迪士尼风格"和"超人 + 流行艺术风"。
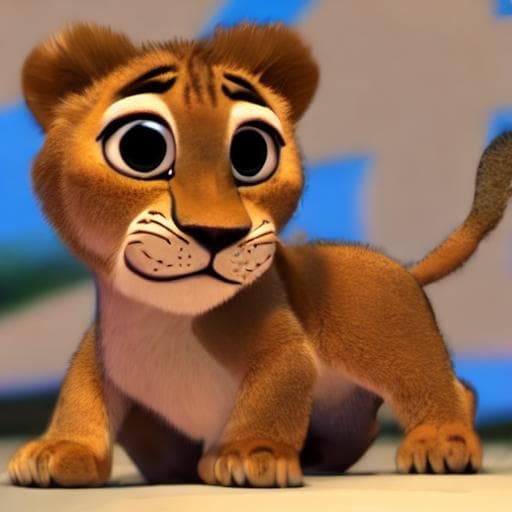
图注:"baby lion in style of <s1><s2>",两个 LoRA 权重混合后的结果
| 路径 | 门槛 | 说明 |
|---|---|---|
| Colab 一键跑 | ⭐ 最低 | README 提供了 @pedrogengo 的 Google Colab 笔记本,开箱即用,适合零基础体验 |
| HuggingFace Spaces | ⭐⭐ | 作者提供了 Gradio 集成 Demo:lora-library/LoRA-DreamBooth-Training-UI,网页上传图片即可训练 |
| CLI 本地训练 | ⭐⭐⭐⭐ | pip install git+https://github.com/cloneofsimo/lora.git 后用 lora_pti 等命令,需要 ≥12GB 显存的 NVIDIA GPU |
关键参数由 README 直接给出(作者示例图全部用这套参数训练):--resolution=512、--train_batch_size=1、--gradient_accumulation_steps=4、--learning_rate_unet=1e-4、--lora_rank=1。注意 --lora_rank=1 就能出效果——rank 1 意味着每个注入层只学一个基向量,这正是产物能压到 1MB 的原因。
另外,--train_inpainting、--use_extended_lora(把 LoRA 也应用到 ResNet)、--use_face_segmenting_condition(配合 mediapipe 做人脸分割条件)等开关覆盖了局部重绘、扩展注入范围和人脸一致性等进阶需求。
第一,仓库已经停止维护。 最后一次代码推送是 2024 年 3 月 22 日,README 的更新日志停在 2023 年 2 月。作为对比,官方 diffusers 早已在 2023 年 1 月就把 LoRA 集成进主库(README 自己也标注"NOTE: It is CURRENTLY DIFFERENT FILE FORMAT"),今天的 diffusers 已通过 PEFT 的 LoraConfig 原生支持 LoRA 训练与推理,覆盖 SD 1.5、SDXL、Kandinsky 2.2 及后来的 Flux、SD3 系列。这个仓库的历史价值 > 当前实用价值。
第二,格式已经分叉。 本仓库产出的是自定义 .safetensors LoRA 格式,与 diffusers/kohya 的 PEFT 格式不互通,需要用仓库自带的 to_ckpt_v2.py 或 cli_pt_to_safetensors.py 做转换。这在 2022 年是优势(当时没标准),今天成了迁移成本。
第三,更成熟的替代品已经出现。 社区事实标准是 kohya-ss/sd-scripts(2025 年 3 月仍在更新至 v0.9.1,支持 LoRA+、LoRA-LierLa/LoRA-C3Lier、SD3/FLUX 分支),以及 diffusers 官方的 train_text_to_image_lora.py。如果目标是今天要出图而不是研究 LoRA 原理,用 kohya-ss 或 diffusers 更省事。
训练数据的版权与伦理风险也不可忽视:仓库示例包含迪士尼角色 IP,LoRA 微调常被用于未经授权的角色/画风复刻,商业使用前必须评估许可。
回头看,这个仓库的历史贡献有三点值得肯定:
diffusers 提供 set_adapters、add_weighted_adapter(TIES/DARE 去冗余合并)、fuse_lora,把"按权重混合多个 LoRA"变成了标准 API——而这在 2022 年只是这个仓库 lora_add 命令行里的一个 flag。从 stars 曲线看,仓库在 2023 年初达到关注峰值,此后随生态成熟而进入长尾维护状态。这个状态本身很健康:一个成功把某项技术从"研究代码"变成"平台内置功能"的开源项目,最成功的归宿就是被上游吸收,然后自己安静下来。
kohya-ss/sd-scripts 或 diffusers 官方 LoRA 脚本,不要用本仓库from lora_diffusion import inject_trainable_lora, extract_lora_ups_down 这一对 API 至今可用,是理解"LoRA 注入 UNet"的最好实现本文基于 GitHub 仓库 cloneofsimo/lora 的实际代码结构、README、依赖清单与 GitHub API 元数据(stars/forks/issues/许可证/贡献者数/最后推送时间)分析生成。
