
AI-research-feedback
claesbackman/AI-research-feedback加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
假设你是一名经济学在读博士,导师下周要看你投稿 AER 的初稿。传统做法是:自己通读两遍、查文献、核对表格数字、再把稿子发给两位同门——而后两位同门都在赶自己的 deadline,一周后才回你一句话说「整体还行」。这个项目想做的事,就是把这段「等待反馈」的空白期填上:装上它,然后在你自己的终端里敲一条 /review-paper AER,八个分工不同的智能体并行开工,几分钟后给你一份带优先级排序的评审报告。
更狠的一个设计出现在 audit-analysis 上。作者 Claes Bäckman(德国波茨坦 Leibniz Institute for Financial Research SAFE 的经济学家)在这个技能里刻意要求:审计代码必须在一个全新上下文的子智能体中执行,审计者不得被作者影响。如果你在写代码的同一个会话里问 Claude「这段代码对吗」,它大概率会顺着你的思路说;而这个技能把 diff 交给一个看不见你对话的审计者,并明确告诉它「作者希望你现在就把它搞砸」。这是把「评审的独立性」从道德要求变成了工程约束。
Bäckman 在 Substack 的专栏文章《Feedback Machines II》里写得很坦白:这些技能的底层提示词不是他自己写的,他只是向 Claude 描述自己需要什么,让 Claude 生成技能,再让另一个 Claude 扮演「批评这个技能的批评者」,找出覆盖不足、判据模糊、专家评审还会追问但技能没覆盖的地方,然后据此反复修改。整个过程迭代了好几轮。
这解释了这个仓库最有意思的地方:它的产物不是「一段很长的 system prompt」,而是一套带元方法的提示词工程。作者公开了设计思路(Aarhus 2026「Practical AI for Academics」工作坊页面),把学术写作反馈拆成了「机械性检查」和「判断性评价」两层——前者可以放心交给 AI(拼写、内部一致性、交叉引用、无支撑的论断),后者必须留给真人(研究问题是否重要、实证设计是否可信、论文是否优于既有文献)。
如果把学术写作类比成制造业,这个项目更像质检流水线 + 外协审片,而不是「自动写作机」。
review-paper 是八条并行工位:拼写风格、内部一致性、无支撑论断与识别策略、数学与符号、表与图、外加一个扮演副主编的贡献评估员;再加一个「钢人化」(steelman)辩护者和一个「攻击者」,两者都要求以论文自身的文献为依据。产出按 critical / major / minor 分级。review-paper-light 只有两个智能体,聚焦贡献与识别,适合还在改稿的阶段。review-paper-checks 是纯机械检查,不做编辑判断,还会在检查后主动提出把无歧义的修改直接应用到 .tex 文件。review-pap(预分析计划,按 AEA/EGAP/OSF 等注册标准审)、review-grant(按 NSF/NIH/ERC/Horizon Europe 的标准做六人评审小组)走的是同样的多智能体骨架。explorable-deck 与 explorable-beamer 是输出端:把论文做成 Nicky Case 风格的「可探索解释」演示——一页一个论点、断言式标题、现场可操作的图表舞台。仓库共 12 个技能,目录结构非常克制:Skills/<name>/SKILL.md,另附模板与辅助脚本。整体代码量约 12.2 万字节语言统计中,Python 41.6KB、TeX 33.9KB、JavaScript 21.9KB、SCSS 18.1KB、Shell 6KB——绝大部分「代码」其实是 Markdown 提示词与前端/排版资产。
几个技术细节值得留意:
YAML frontmatter 即接口。技能通过 allowed-tools(白名单)、disable-model-invocation: true(禁止 Claude 自主触发)、argument-hint 声明契约。作者把 review 类技能全部设为只能手动 / 触发,明确写道「Claude 绝不会自己启动一次多智能体评审」——这是对 token 成本和打扰用户双重负责的设计。只有 pdf-to-markdown、explorable-deck、explorable-beamer 允许模型自主调用。
产物隔离。评审报告写入项目下的 reviews/ 目录,带日期与 -v2/-v3 版本号,且每次运行放在独立子目录,避免污染后续运行。这正是「技能不应污染工作区」的良好实践。
主文档自动识别。技能用 Glob 扫 **/*.tex,排除 beamer 类、旧稿目录、response/letter 文件,再按 \input{}/\include{} 包含图规模最大的那个作为正文。这种「考古式」的文档定位逻辑,是把人类经验固化进提示词的典型例子。
抽样可核验。review-paper-code 检查表格是否真由代码生成、样本构造是否与论文数据节一致、论文说 IV 而代码跑 OLS 这类错配,并抓硬编码路径、缺随机种子、没有主脚本等可复现性问题。audit-analysis 更进一步:每条发现必须引用文件、行号与原文摘录,并打上 CONFIRMED(代码中可见)或 SUSPECTED(需数据验证)标签,无锚点的发现直接丢弃并计数。
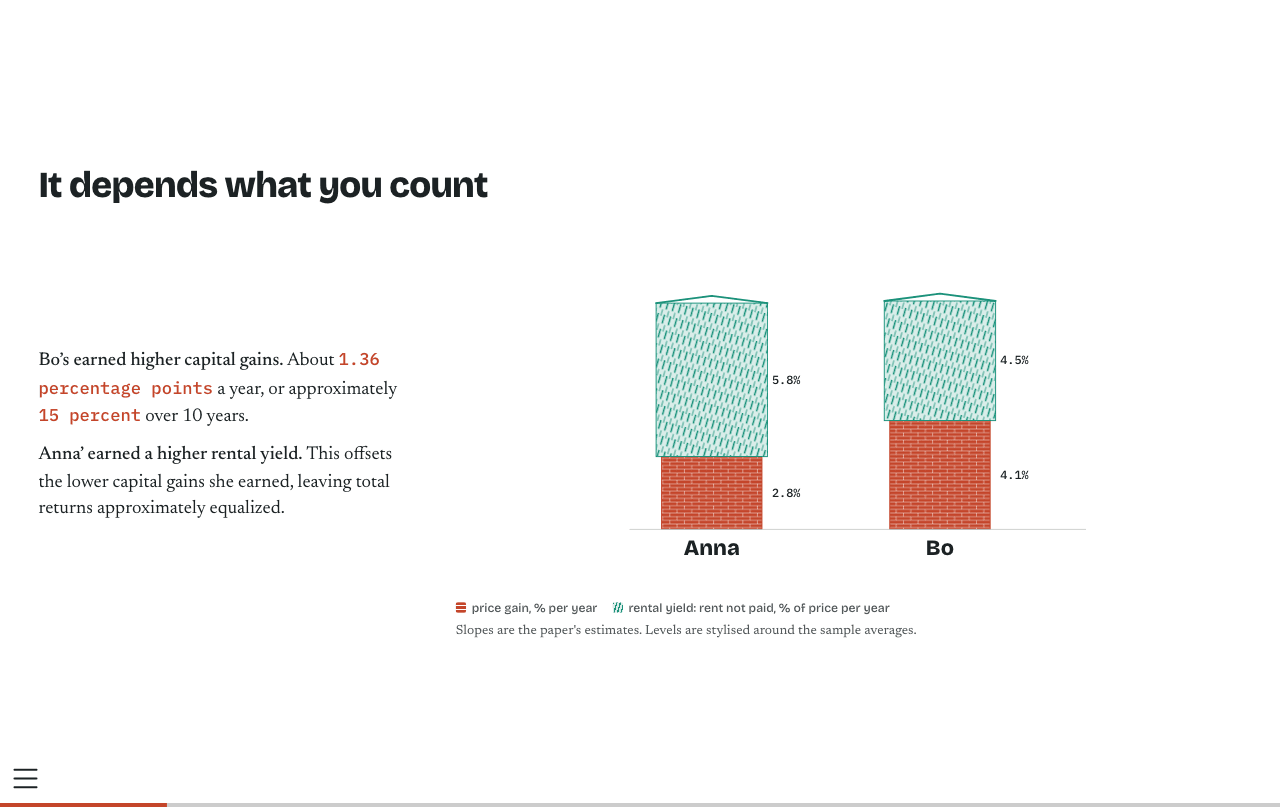
图:explorable-deck 生成的运行时 SVG 舞台,演讲者可现场驱动阶段切换
门槛极低,但有层次:
Skills/ 下任意技能文件夹拷进 ~/.claude/skills/(Windows 是 C:\Users\you\.claude\skills,macOS 是 /Users/you/.claude/skills),重启 VS Code 或 Claude Code 即可。有终端的用户一条命令装全部:git clone --depth 1 <repo> /tmp/airf && mkdir -p ~/.claude/skills && cp -R /tmp/airf/Skills/. ~/.claude/skills/。pdf-to-markdown 优先走 pdftotext(快 10-100 倍且不占模型上下文),没有则回退到 Read 工具;两个 deck 技能需要 Quarto / LaTeX + latexmk 工具链和 Chrome(用于截图自检)。general-purpose 子智能体能力;论文评审假定 LaTeX 稿件,预分析计划与基金申请可读 .md/.txt/.tex 并尝试 .pdf/.docx。作者自己承认了两类局限,值得如实转述:
此外还有工程层面的隐患:allowed-tools 包含 Bash 的技能一旦安装,等于本地 shell 权限;论文正文、基金申请书等未发表材料会被读入 Claude 上下文并上传,对涉密或未公开稿件存在外传风险。项目采用 MIT 许可、单一贡献者(contributors 仅 1 人)、28 次提交,事实上是个人作品的公共化,无版本化发布与 CI 保证,也没有自动化测试——技能的「正确性」只能靠人工按文档执行来验证。此外,作者本人 2026 年 4 月的专栏文章中还提到某些技能「仍在完善中」。
这个仓库放在一个更长的趋势里看更有意思:从「AI 替人写」到「AI 替人审」的转变正在发生。开源社区 2025 年以来大量涌现论文评审类工具,但多数是单轮提示、无法并行、无法自我批评。这个项目的差异化在于三点——并行多智能体分工、元批评回路(让 AI 批评 AI 写的技能)、以及隔离式敌对审计。
506 star、95 fork、MIT 许可,且已被纳入 Aarhus 大学「Practical AI for Academics」工作坊的官方教程,配套工作坊页面提供无终端安装指南。这意味着它已经不只是个人玩具,而是进入教学场景的参考实现。从 2026 年 3 月创建到 10 月仍在高频更新(最近一次推送 2026-10-24),迭代节奏稳定。
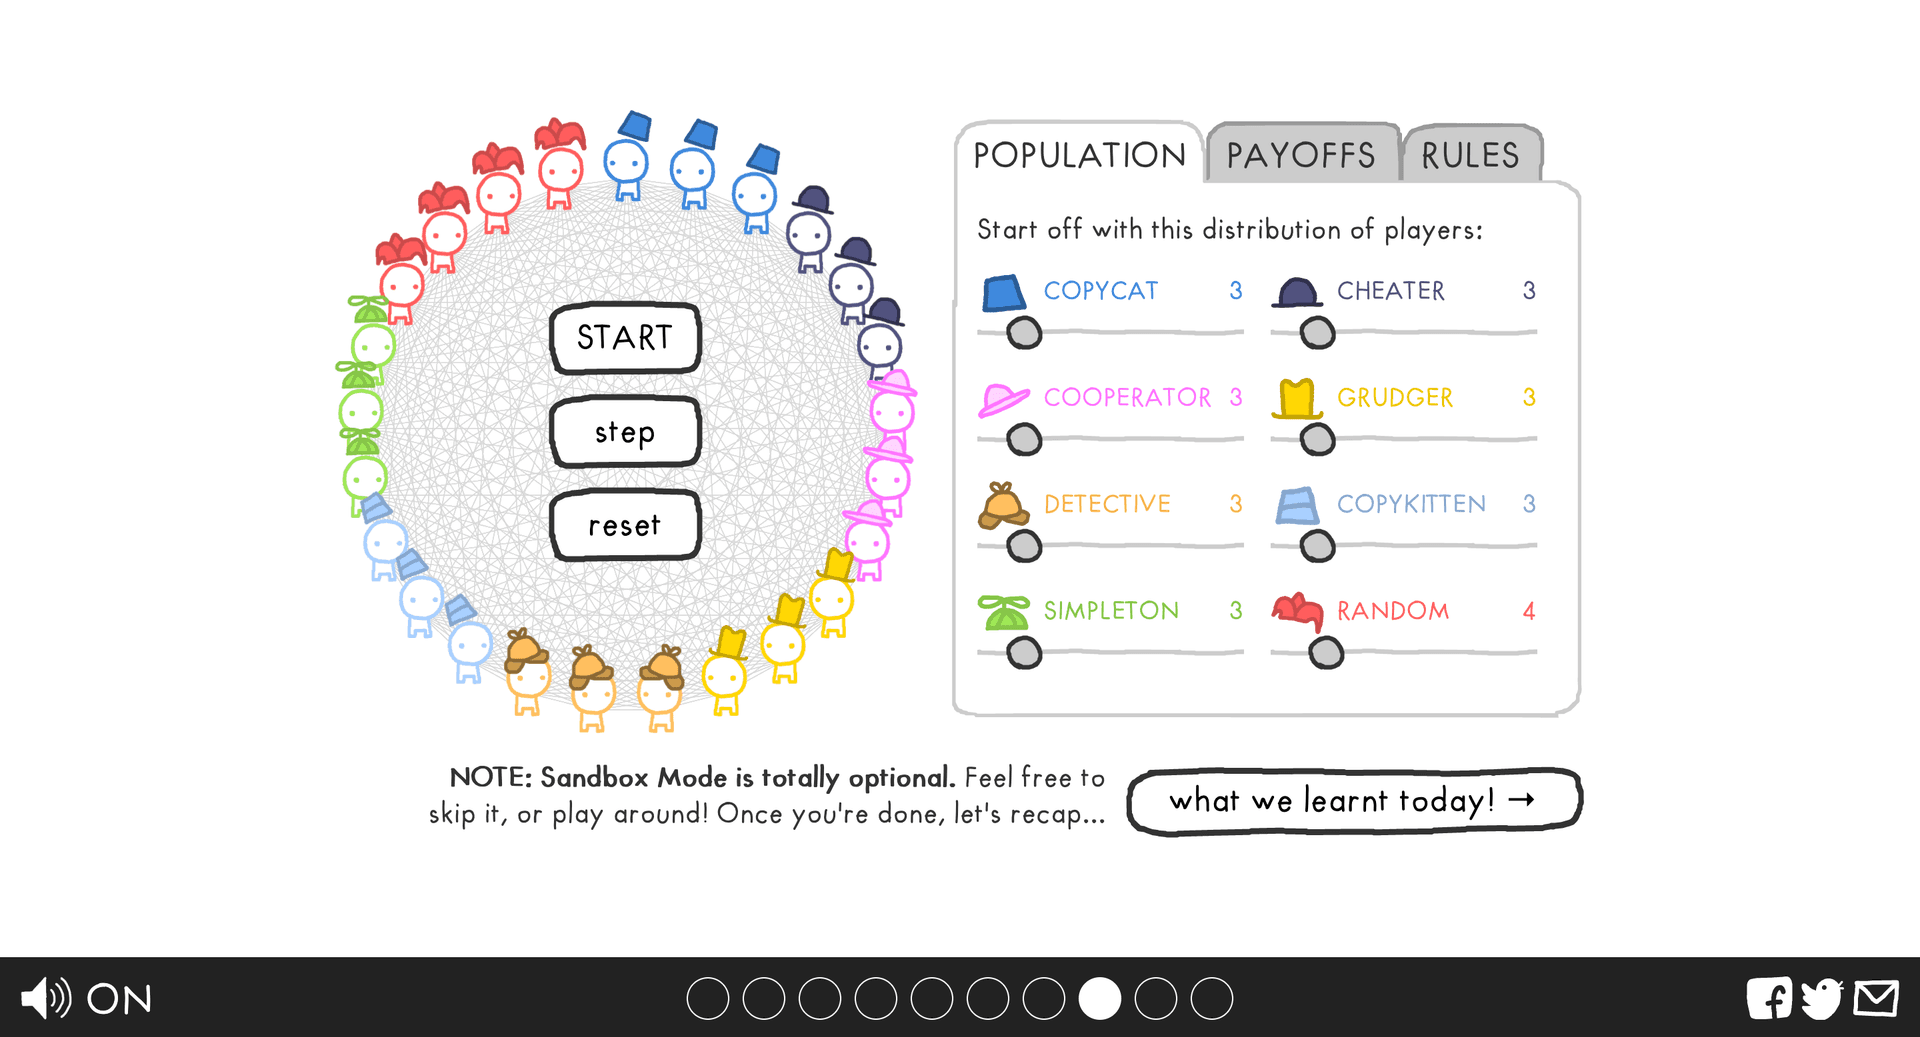
图:explorable-deck 模板中的沙箱交互设计参考
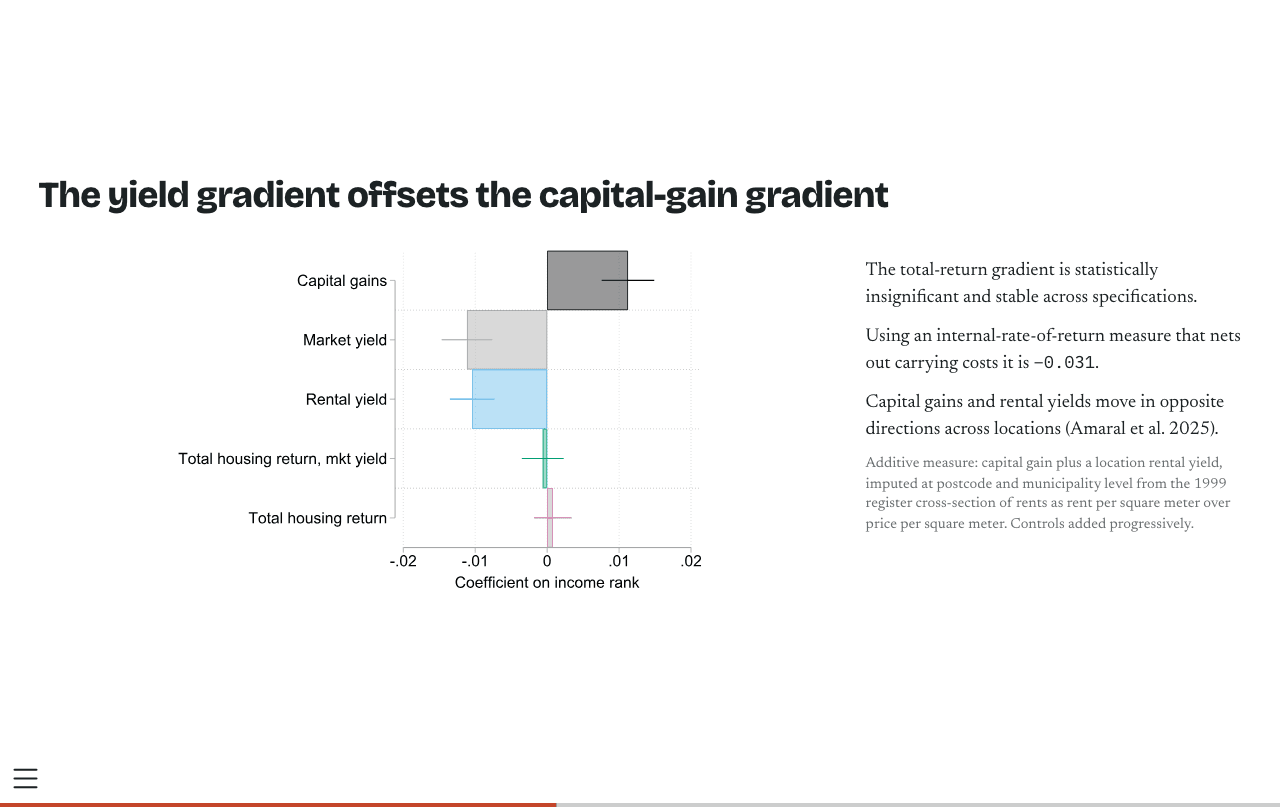
图:deck 模板中从论文原图转换并重新着色的系数图
这个项目的价值不在于「让 AI 写论文」,而在于把一位经济学家的评审直觉拆解成了可复用、可审计、可教学的方法论。它当然不能替代同行评议,但能让你在把稿子发出去之前,先承受一轮不留情面的机器审阅——用作者的话说:让工具处理掉机械劳动,好让你和同门的对话集中在真正要紧的地方。
