
machine-learning-systems-design
chiphuyen/machine-learning-systems-design加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2019 年 11 月,Chi Huyen(曾任 Airbnb、Recruit、Stripe 的机器学习平台工程负责人,后任 NVIDIA 应用 AI 负责人)在一个仓库里放下了自己手写的一份小册子:Machine Learning Systems Design。仓库里没有一行 Python,没有模型权重,也没有可运行的训练脚本——只有 5 个 Markdown 文件、若干张示意图,以及 27 道开放式机器学习系统设计题。
它的缘起很朴素。Chi 后来在推特上发起了一个提问:"面试官在系统设计面里到底看什么?" 收到的回答让他意识到,这类问题既没有标准答案,也没有评分标准,更没人教过。于是他把自己在生产环境里踩过的坑、给团队做设计评审时反复追问的问题,一条条写下来,变成了这份免费公开的"设计清单"。
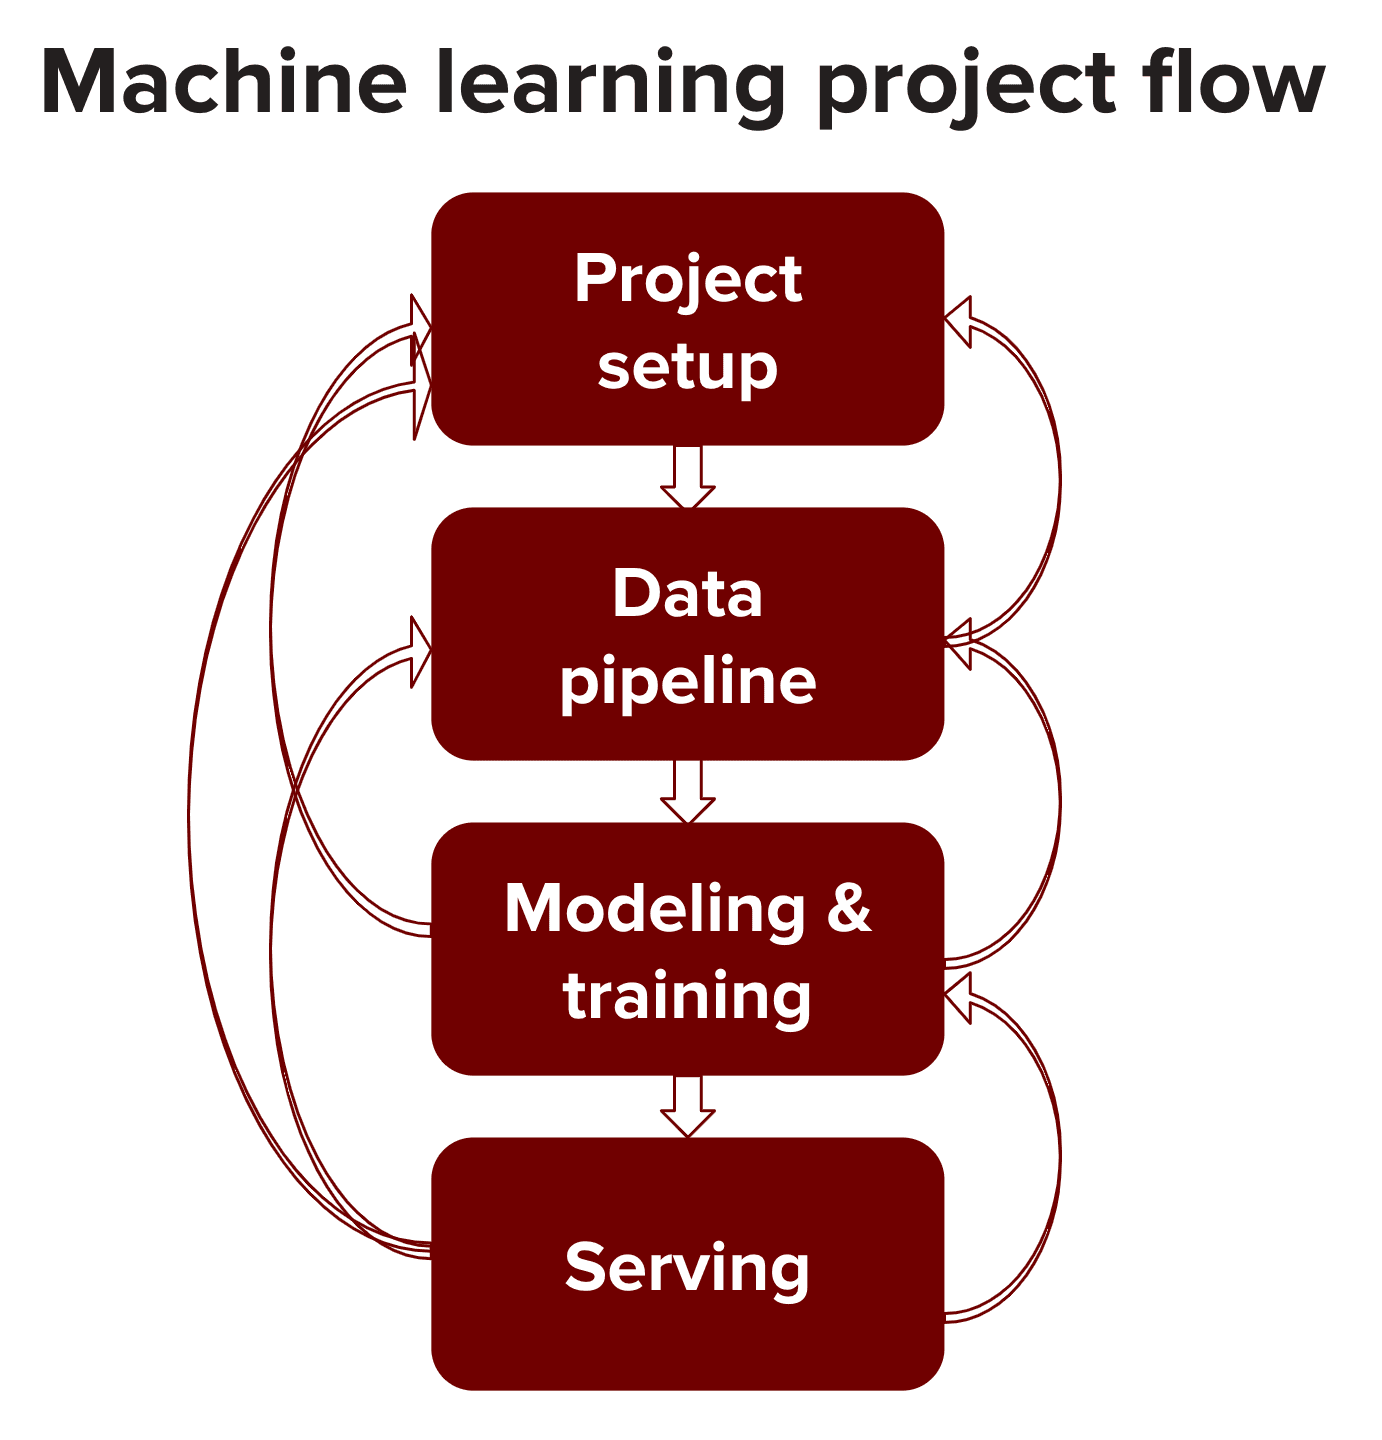
图:机器学习项目的四个主要环节——项目立项、数据管道、建模(选择/训练/调试)、服务化(测试/部署/维护)。任一环节的产出都可能反过来推翻上一环节的假设。
手册正文的主干是 content/design-a-machine-learning-system.md,它把"设计一个机器学习系统"拆成四步:
| 环节 | 关键追问 |
|---|---|
| 项目立项 | 目标是什么?用户体验如何?性能约束(延迟、精确率 vs 召回率、漏报代价)?离线与在线如何分别评估? |
| 数据管道 | 数据从哪来?训练与服务两侧的特征如何保持一致?标签怎么来、延迟多少? |
| 建模 | 选哪类模型?依赖哪些特征?训练/调试/监控怎么做? |
| 服务化 | 如何测试?如何上线?如何监控模型退化与数据漂移?如何回滚? |
作者反复强调的一个反直觉观点是:上线之后线上数据会反过来打脸你的假设。训练时以为用户会这么用,真实用户按下按钮的方式完全不同;训完才发现数据不够、需要重新标注;立项时定义的问题根本拿不到所需数据,只能重新定义问题。系统设计因此不是线性流程,而是四个环节之间的反复迭代。
第二块内容是 content/exercises.md 里的 27 道开放题,覆盖真实业务场景:Duolingo 的故事难度分级、信用卡欺诈检测、电商相似商品推荐、Twitter 关注推荐、Google 搜索联想词与相似图片、Twitter 热门话题、Quora 答案排序、Airbnb 房源搜索 Top 10、StackOverflow 相似问题、Lyft/Uber 拼车匹配。每道题都故意写得含糊——作者明说,候选人的第一任务不是给方案,而是反问面试官澄清需求、主动收窄问题范围。
第三块 content/case-studies.md 汇总了 Airbnb 房产价值预估、Netflix 流媒体质量优化、Booking.com 150 个上线模型的六条经验等大厂技术博客,是给"想看别人怎么做"的人准备的资源索引。第四块 research-vs-production.md 则专门讨论"研究与生产"之间那道鸿沟,以及系统设计面该如何评判候选人的思考过程。
把它当成"机器学习版的《Designing Data-Intensive Applications》"可能更准确。作者不是给你一个能跑的框架,而是给你一套提问清单——像建筑师交付图纸而非盖房子。就像做菜谱不会只写"番茄炒蛋",而会告诉你"为什么先炒番茄而不是先炒蛋""火候和时机如何影响口感"。ML 系统失败的绝大多数原因不是模型不够强,而是设计时漏掉了某个环节的约束——训练与服务特征不一致、监控缺失、上线后无法定位退化。
npm install magicbook → 克隆仓库 → 修改 content/ 下的 Markdown → magicbook build,产物(HTML 与 PDF)落在 build/ 目录。仓库内已带 netlify.toml,配置为 npm -g install magicbook && magicbook build,发布目录 build,可直接托管到 Netlify。answers/ 目录用于沉淀社区答案,本仓库有 27 道题的开放讨论入口。由于它是纯静态文档站,没有 Dockerfile、没有 docker-compose、没有 Kubernetes 编排,也不需要 GPU——普通笔记本几分钟就能把站点跑起来或直接部署上线。真正的门槛在于阅读本身:需要具备基本的模型训练与线上服务概念,才能读懂作者那些看似平淡的追问。
NOASSERTION,法律上属于"保留所有权利"。虽然内容是免费可读的,但严格来说没有明确的再利用授权,企业内部分发或改编需谨慎。有意思的是,这个仓库 2026 年仍在 GitHub Trending 级别的 star 增速里——超过 1 万 star、1653 fork,说明在 LLM 应用层出不穷的今天,"如何把模型做成系统"这个基本功反而被更多人重新重视。大量团队从"调 API 做个 Demo"转向"上生产",卡住他们的往往不是模型能力,而是数据管道一致性、监控、回滚这些本文反复强调的工程问题。
这份小册子的历史价值在于:它比大多数 MLOps 课程更早、比大多数框架文档更中立,把"设计评审"这种隐性知识显性化了。它甚至影响了 Chi 自己后来的写作路线——从博客文章到 O'Reilly 图书,再到成为 MLOps 领域最有影响力的独立作者之一。而 2026 年兴起的 LLM 应用工程、Agent 编排、数据飞轮等新议题,追根溯源仍在回答这本册子提出的同一组问题。
图:模型调试是一个逐层排查的过程——数据有问题、特征有问题、还是训练过程本身有问题。定位能力决定了系统上线后出问题时你能否自救。
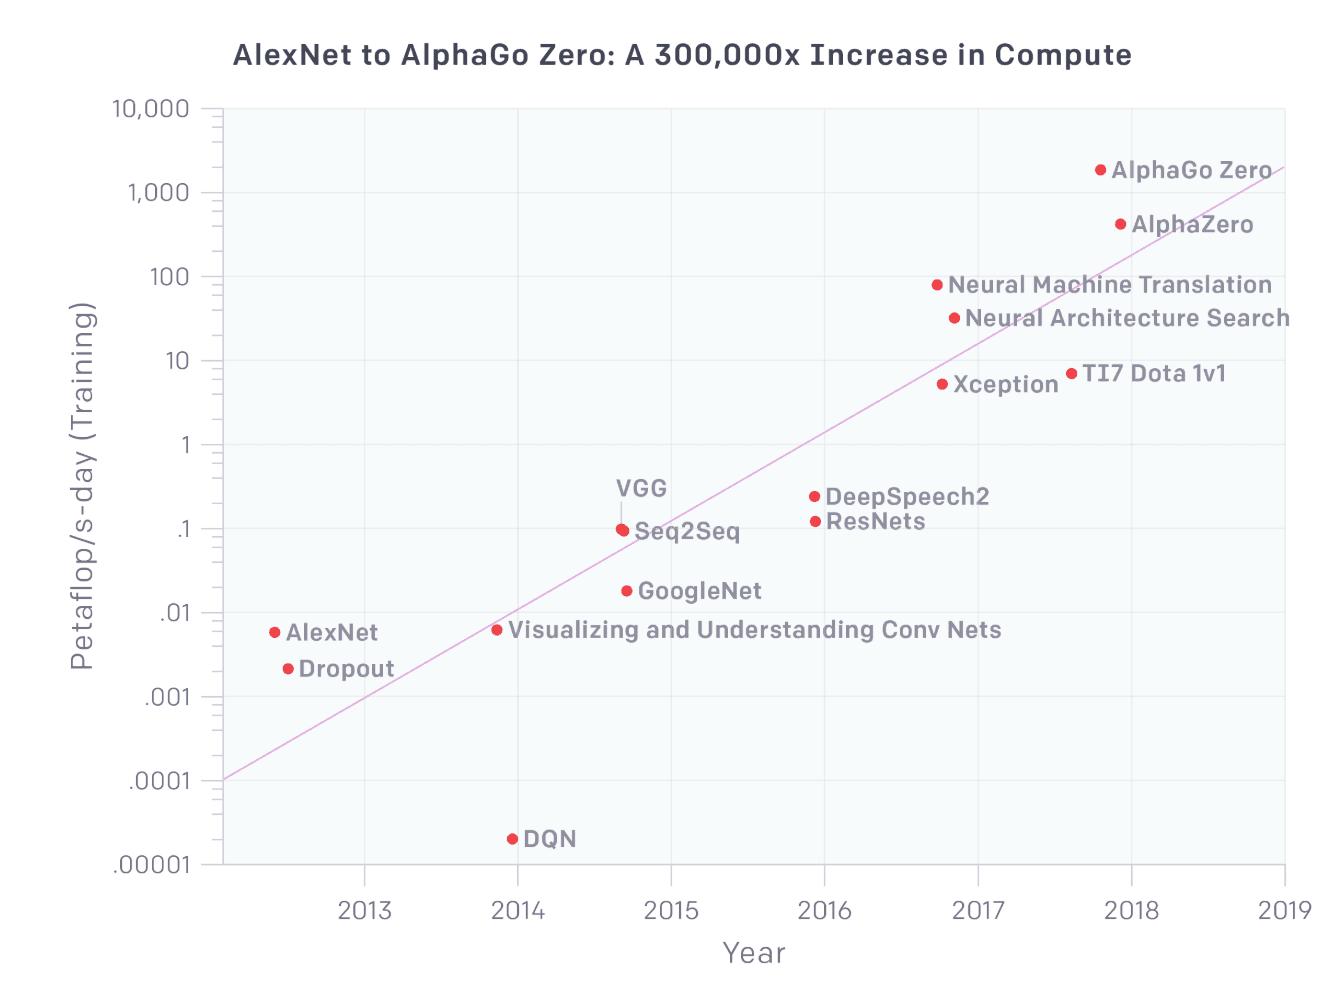
图:算力成本不是线性增长的,它与模型规模、数据规模强相关。这一张图解释了为什么"训练与服务策略"必须作为系统设计的一等公民来讨论。
如果你正在做机器学习平台、准备带 AI 团队,或者正在为一场 ML 系统设计面做准备,这份小册子的性价比极高:免费、开放、结构清晰、语言精炼,一个下午可以读完核心部分。读完之后最该做的,是拿它那 27 道题自己推演一遍——作者说得很清楚,面试官真正想看的是你如何在约束和权衡中把问题想清楚,而不是背出一个标准答案。
至于要不要 fork 下来改成自己的团队版——技术上完全可行(改 content/ 下的 Markdown 就行),但请注意上面提到的 LICENSE 缺失问题。
项目信息速览
| 项目 | 说明 |
|---|---|
| 仓库 | chiphuyen/machine-learning-systems-design |
| Stars / Forks | 10,716 / 1,653 |
| 主要语言 | HTML(Markdown + Jinja2 模板 + magicbook 构建) |
| License | 未声明(根目录无 LICENSE 文件) |
| 贡献者 | 2 人 |
| 在线阅读 | https://huyenchip.com/machine-learning-systems-design/toc.html |
| 构建方式 | Node.js + magicbook,产物在 build/;含 netlify.toml 一键部署 |
