
aie-book
chiphuyen/aie-book加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景。2025 年春天,一家做企业服务的公司决定上线一个「AI 客服助手」。工程师花了两周,用 LangChain 拼出一个能查订单、能写回复的 Agent,演示效果很好,Demo 惊艳全场。但真正上线的第一周,麻烦接踵而来:
问题不在于模型不够强,而在于团队缺少一套把「模型能力」翻译成「可交付应用」的系统性方法。而这套方法,恰恰是当前 AI 工程化领域最缺的东西。
Chip Huyen 在《AI Engineering》(O'Reilly,2025 年 1 月出版,532 页)里给出的答案是:AI 工程不是「调 API」,而是一套完整的、可以照着走的工程学科。这本 1.8 万星的开源仓库 chiphuyen/aie-book,就是这本书的全套配套资料库——它把 15 万字正文之外的所有"可检索资产"都搬到了 GitHub 上。

《AI Engineering》英文版封面,作者 Chip Huyen,O'Reilly Media 2025 年 1 月出版
Chip Huyen 的履历几乎就是一部 AI 工程化的编年史:她在 Netflix 做研究员,在 NVIDIA 是 NeMo 生成式 AI 框架的核心开发者,在 Stanford 教过 Machine Learning Systems Design,后来创办 AI 基础设施公司 Claypot AI,目前在 Voltron Data 加速 GPU 上的数据分析。她的前作《Designing Machine Learning Systems》(DMLS)是 Amazon 上的 ML 类畅销书。
而《AI Engineering》的写作背景是这两年行业最真实的阵痛:基础模型以 API 形式人人可用,AI 从"少数人的专业学科"变成了"人人都能用的开发工具"。但模型可用之后,该建什么应用、怎么评估、幻觉从哪来、什么时候该微调、数据要多少、怎么把成本压下来这些问题没有一个统一的答案。
Chip Huyen 在书里明确提出的「AI 工程栈」三层结构,就是她的核心主张:
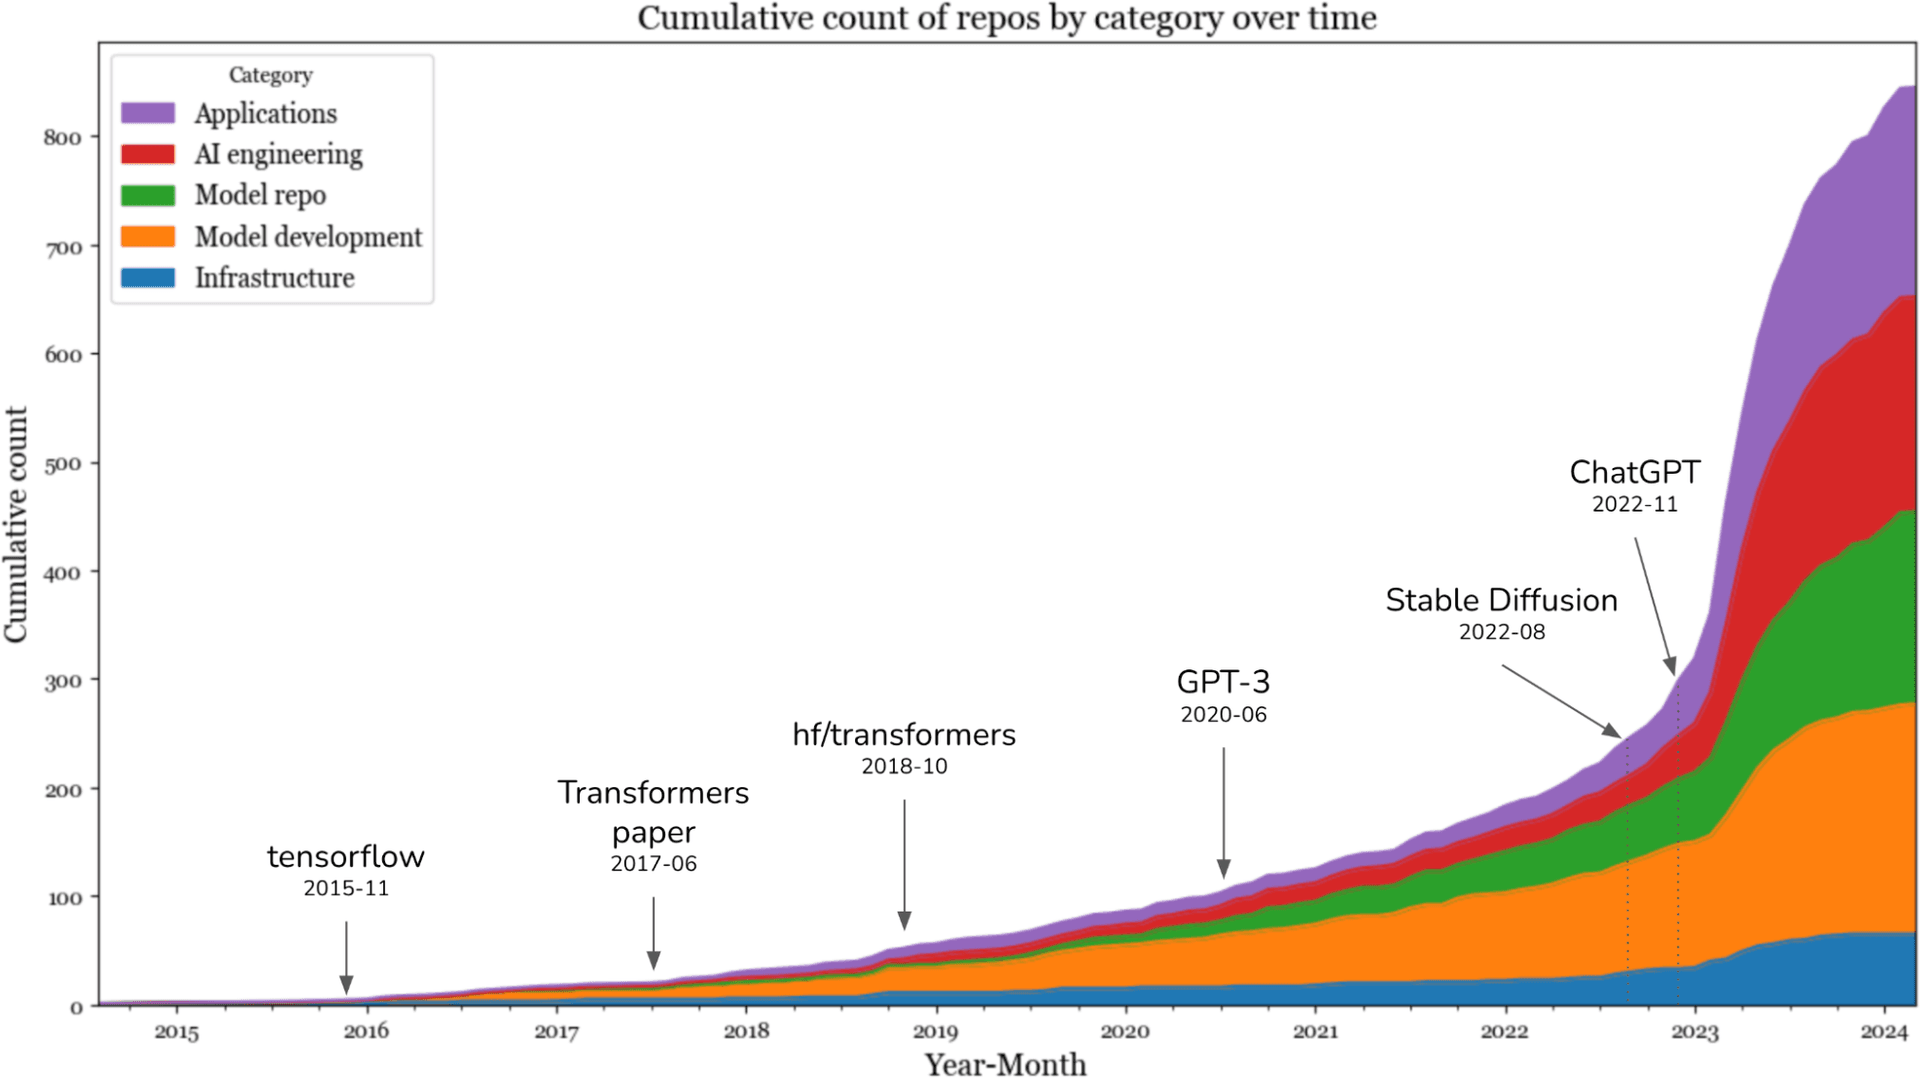
AI 工程栈的演进:从传统 ML 工程到 AI 工程的分层理解
她强调的一个反直觉观点是:工具会过时,基础原理不会。所以这本书刻意不绑定任何具体框架——不讲 LangChain 怎么调,不讲某个 API 怎么用——而是讲"为什么 RAG 会有效""Agent 和 Workflow 的边界在哪""AI as a Judge 什么时候会失灵"。这套取向在这个"三个月一换代"的行业里显得格外稀缺。
这本书已被译成日、韩、简中、繁中、越南、西、意、法、葡、德、泰、俄、波兰等十余种语言,配套的 GitHub 仓库目前 18,207 星、2,673 fork,贡献者 6 人。
如果非要用一个生活化的比喻:这本书像是给厨师看的「味觉与火候原理全书」,而不是菜谱。
菜谱告诉你"番茄炒蛋放糖不放醋",但原理书告诉你"为什么糖能中和番茄酸度""为什么大火会让蛋白质变性发硬""为什么同样的配方在不同产地食材上会翻车"。前者让你今晚有菜吃,后者让你在没有菜谱的厨房里也能做出一道新菜。
对应到 AI 工程:
而这个仓库的角色,是"原理书旁边的工具箱":它把散落在全书 1200+ 条引用链接中的精华,压缩成一份可以直接当索引用、也可以当资源地图用的清单。
全书 10 章构成一条端到端主线,仓库的 chapter-summaries.md 提供了每章的独立摘要文件:
| 章节 | 主题 | 解决的核心问题 |
|---|---|---|
| 1 | 用基础模型构建 AI 应用 | 该不该做?AI 工程栈长什么样? |
| 2 | 理解基础模型 | 训练数据、架构、采样、后训练 |
| 3 | 评估方法论 | 困惑度、功能正确性、AI as a Judge |
| 4 | 评估 AI 系统 | 评估标准、模型选型、评估流水线设计 |
| 5 | 提示工程 | 防御性提示工程、结构化输出 |
| 6 | RAG 与 Agent | 检索增强、Agent 与 Workflow 的边界 |
| 7 | 微调 | 何时微调、何时不微调、PEFT 参数高效方法 |
| 8 | 数据集工程 | 需要多少数据、怎么验证数据质量 |
| 9 | 推理优化 | 让模型更快、更便宜、更安全 |
| 10 | AI 工程架构与用户反馈 | 分层架构、流水线编排、反馈闭环 |
注意第 3、4 章被明确分开——评估方法论(怎么测)与评估系统(测什么、选型怎么做)是两个不同的问题,这个切分本身就体现了作者的工程经验。
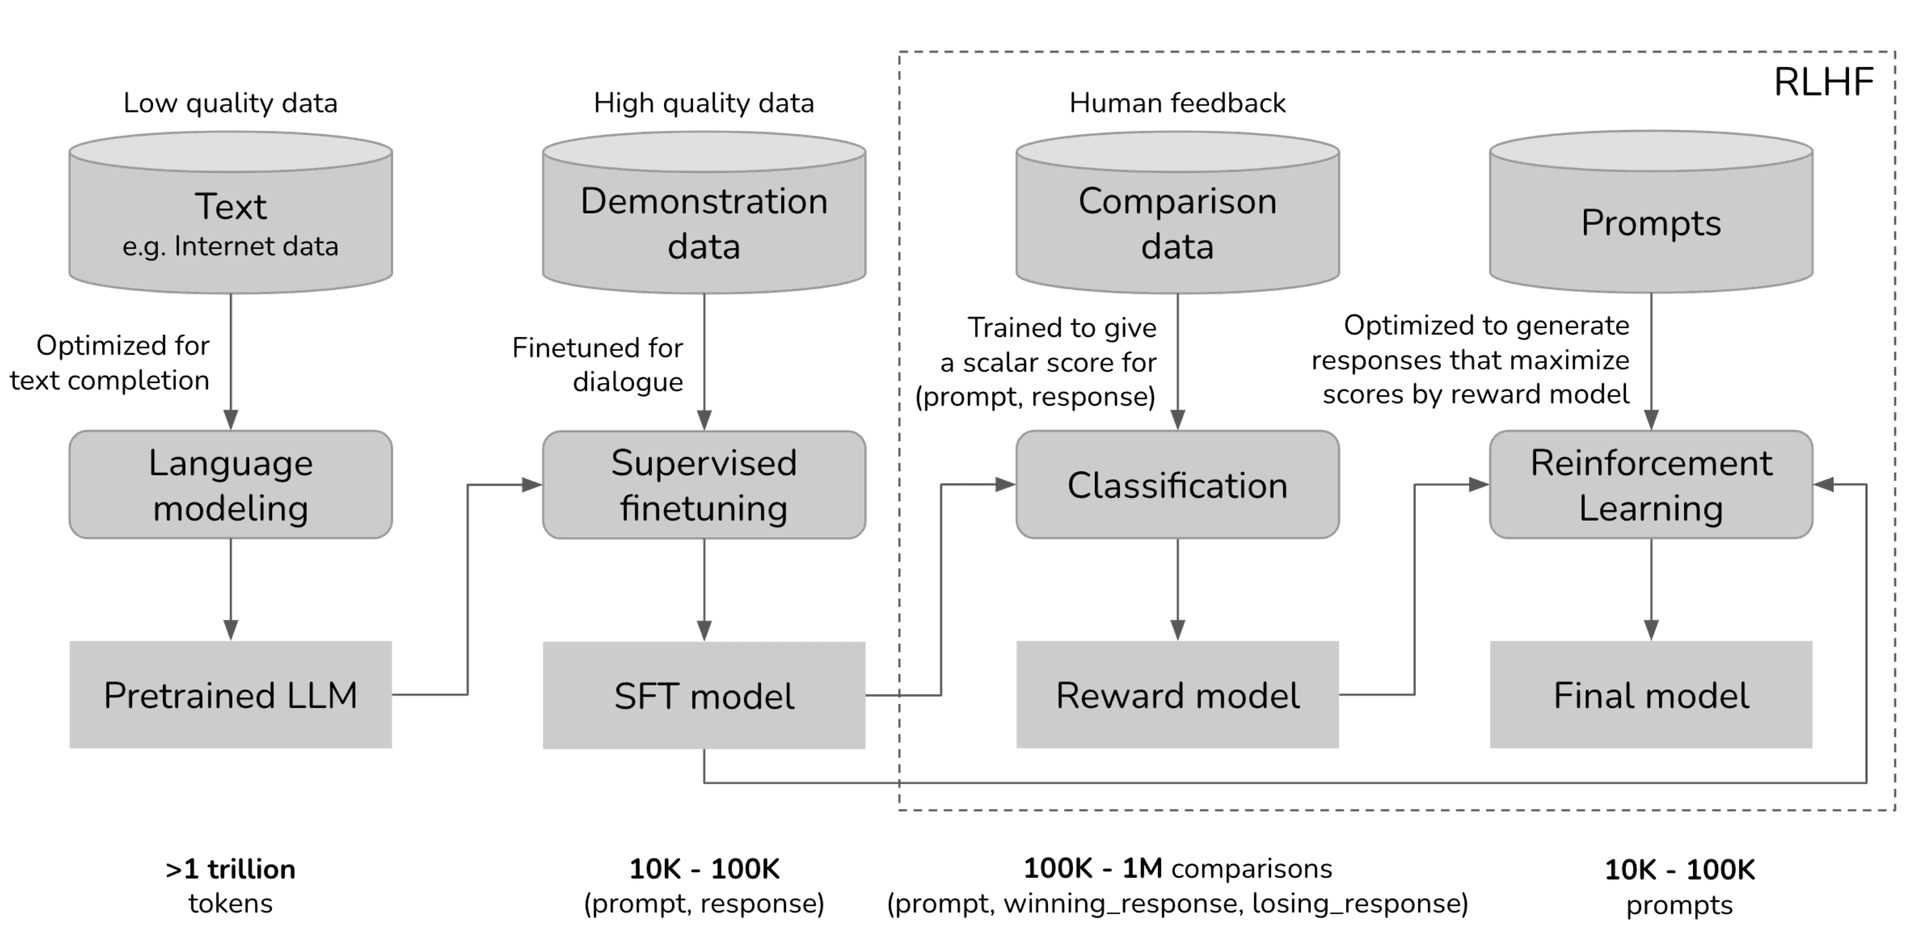
基础模型的完整训练流程:预训练、监督微调、RLHF 三阶段
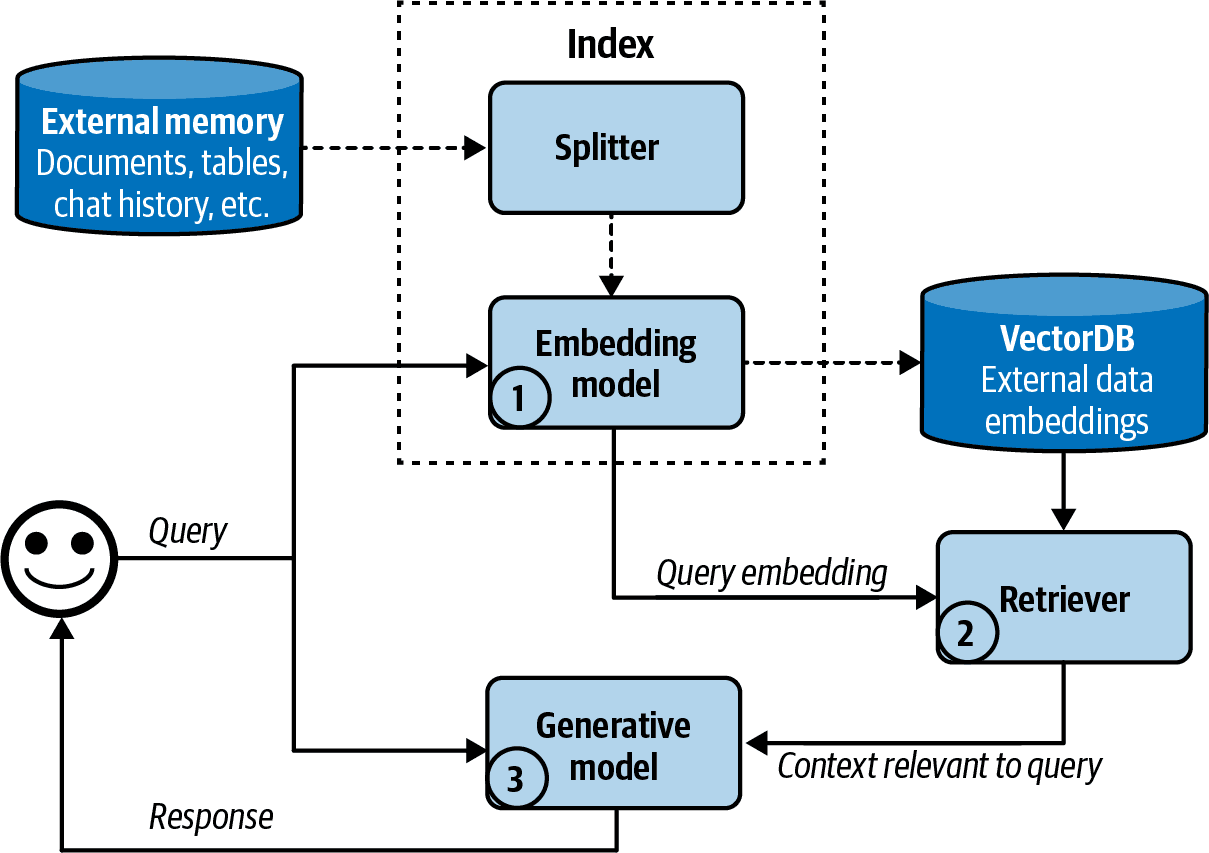
RAG 的架构拆解:检索、分块、重排、生成各环节的职责边界

提示词的解剖结构:任务指令、示例、上下文、输出格式各占什么位置
这三张图在书里是没有的原始素材(正文出版时受版面限制),仓库里以高清 PNG 形式单独提供,是免费阅读本书时最高价值的补充。
resources.md:一份 35KB 的 AI 工程资源地图这是仓库里信息密度最高的文件。它不是简单的链接墙,而是按章节组织、带作者个人判断注释的策展清单,覆盖:
每条都附有"为什么值得读"的一句话说明,这部分内容即便完全不买书也有独立参考价值。
study-notes.md:社区共建的读书笔记索引作者把社区里公开的读书笔记收拢到一处,包括 Alex Strick van Linschoten 的逐章精读笔记(覆盖 RAG/Agent、微调、推理优化、架构四章)、李刘的读书会文档、以及多个 AI from Scratch 阅读小组的讨论线索。这是一个书友社区自组织形成的"分布式书评网络"。
translations.md + case-studies.md + misalignment.md翻译清单覆盖 13 种语言(含简中/繁中实体书 ISBN)。case-studies.md 目前内容极简(仅 14 字节,尚未展开),misalignment.md 则收录了关于"模型与人类意图不一致"的专题讨论——这是全书中最有争议也最有价值的一块。
仓库里唯一可运行的代码是 scripts/ai-heatmap.ipynb——一个分析你个人 ChatGPT / Claude 使用习惯的可视化工具。它读取你从 ChatGPT 设置里导出的 conversations.json,按本地时区把每条对话的时间戳映射到一年中的具体日期,再用 matplotlib 画出 GitHub 风格的贡献热力图;修改一个变量还能叠加 ChatGPT 与 Claude 的双模型对比热力图。
它用到的技术栈非常轻:纯 Python + numpy + pandas + matplotlib + pytz,无框架依赖,一个 Notebook 单元格一个步骤。诚然这只是个小玩具,但作为"仓库不只有干巴巴文档"的一个注脚,它让这份资料库有了点可动手的成分。
这个仓库没有统一的"安装"步骤,因为它的价值入口根本不是代码,而是检索。按不同角色,可以这样用:
路线 A|AI 工程师 / 开发者的系统补课
直接读 chapter-summaries.md 建立全局观感 → 读 ToC.md 定位自己最薄弱的章节 → 按章节回看 resources.md 里对应的延伸材料 → 买/借实体书或 O'Reilly 电子版精读该章。整条路径 0 依赖、0 安装。
路线 B|团队 onboarding 用的规范参考
把 resources.md 里的评估方法论、RAG、Agent 三节单独抽出来做内部技术评审 checklist。这是典型的"用别人的框架,省下自己造轮子的时间"。
路线 C|想把概念可视化的动手党
克隆仓库,pip install numpy pandas matplotlib pytz jupyter,打开 scripts/ai-heatmap.ipynb,改 convo_folder 与 local_tz 两个变量,跑全部单元格。环境要求仅 Python 3.9+,普通笔记本 CPU 即可,无需 GPU。
门槛评估:技术门槛极低(Markdown 阅读 + 一个纯 Python Notebook),但认知门槛高——书中大量内容是「反直觉结论」,比如"AI as a Judge 的绝对评分不可靠,但相对比较更可靠""数据集质量比数量重要一个数量级""微调前应该先修好提示词和 RAG"。这些结论没法靠读代码获得,必须真的读完并对照自己的项目反思。仓库提供的所有资产都是辅助理解的脚手架,不是知识的替代品。
第一,它本质上是"一本书的配套",不是独立作品。 README 顶部就挂着 [WIP] 标记,仓库描述里也写着"还会在未来几周持续更新"。读者若期待一个能独立运转的框架或工具库,会失望——它只有 1 个可运行的 Notebook。
第二,方法论存在时效性风险。 书出版于 2025 年 1 月,到今天已近两年。书中第 9 章的推理优化、第 6 章的 Agent 框架对比、第 4 章的公开基准解读,都明显带着当时的时间戳。虽然"原理比工具耐久"的判断在方法论层面成立,但具体的技术选型清单、基准榜单排名、特定框架的优劣对比,需要读者自己用最新的信息二次校验。这正是作者坚持在 resources.md 里附上大量带日期材料的原因。
第三,case-studies.md 基本是空的。 书中最有说服力的"真实项目案例"部分,在仓库里尚未落地,只有 14 字节的占位。书里宣称"大量图解都来自我参与过的实际案例",但读者在仓库侧看不到这些细节,只能依赖书中正文。
第四,许可证问题需要特别注意。 GitHub API 对该仓库的 /license 端点返回 404,仓库根目录也没有 LICENSE 文件——这意味着代码与图片素材并没有被明确的开源协议覆盖。虽然 GitHub 界面显示为 "Other",但严格从法务角度看,仓库内的 assets/*.png 图表、chapter-summaries.md 的摘要文本都受版权保护。对于打算在自己的课程、内部培训或商业材料中直接复用这些图的用户,应当先取得作者授权,或仅作个人学习使用。这一条在很多同类资源仓库中会被含糊处理,但对企业和教育机构来说是不能跳过的一步。
附带一个小观察:仓库的 pushed_at 停留在 2026 年 7 月,22 个 open issue 未关闭,贡献者仅 6 人(其中一人贡献了 7 个 PR)。这说明它不是高频维护型项目,而是"一次做透、长期挂着"的作者型仓库。作为参考资料这没问题,但如果指望它像软件库那样持续跟进最新进展,就会有落差。
18,207 颗星放在 AI 领域是个值得玩味的数据。同期被大量 star 的 AI 项目大多是"能跑起来的工具",而这个仓库是纯文档 + 配图 + 一个 Notebook。它能拿到这个体量,说明市场正在从"模型能力竞赛"转向"工程落地竞赛"——而落地能力,恰恰无法靠调 API 获得,必须靠系统的工程方法论。
芯片 Huyen 的贡献可以概括为:她把行业里散落在上千篇博客、几十场 talk、上百个技术分享中的经验,收敛成了一套有目录、有框架、有评估方法的学科体系。很多从业者读完的感受是"终于有人把这件事讲清楚了"——这正是"定义一个学科"这件事的标志。
从这个角度看,《AI Engineering》的真正对手不是其他书,而是**"Demo 驱动"这种工业界长期存在的做法**:做一个看起来很酷的 demo,拿到资源,然后在生产环境被幻觉、成本、延迟、评估缺失四座大山压垮。这个仓库——以及它背后的那本书——是把"AI 工程"从形容词变成可执行清单的一次尝试。
对团队而言,它提供的其实是三样东西:一张技术地图(resources.md)、一套评估与选型的思考模板(第 3、4 章)、以及一个共同的行业语言(AI 工程栈、Agent、Workflow、反馈闭环)。第三样往往被低估——当产品、算法、工程三方用同一套词汇讨论"这个 Agent 该做记忆还是该做检索"时,协作成本会显著下降。
最后要说清楚的是它的边界:这是一本思考框架的载体,不是一套可以直接抄的代码。 你不会 clone 这个仓库就得到一个 AI 应用。但你会在遇到"该不该微调""怎么评估""Agent 错在哪里"这类问题时,翻开它找到一个能自洽的答案框架。对一个正在把大模型接进真实业务系统的团队来说,这恰恰是最值钱的部分。
数据采集时间:2026-11-03 | GitHub 数据源:chiphuyen/aie-book @ 18,207 stars / 2,673 forks / 6 contributors / main 分支 | 书籍信息源自 O'Reilly Media 及多语种译本出版页
