
OmniRoute
cheaper-inference/OmniRoute加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
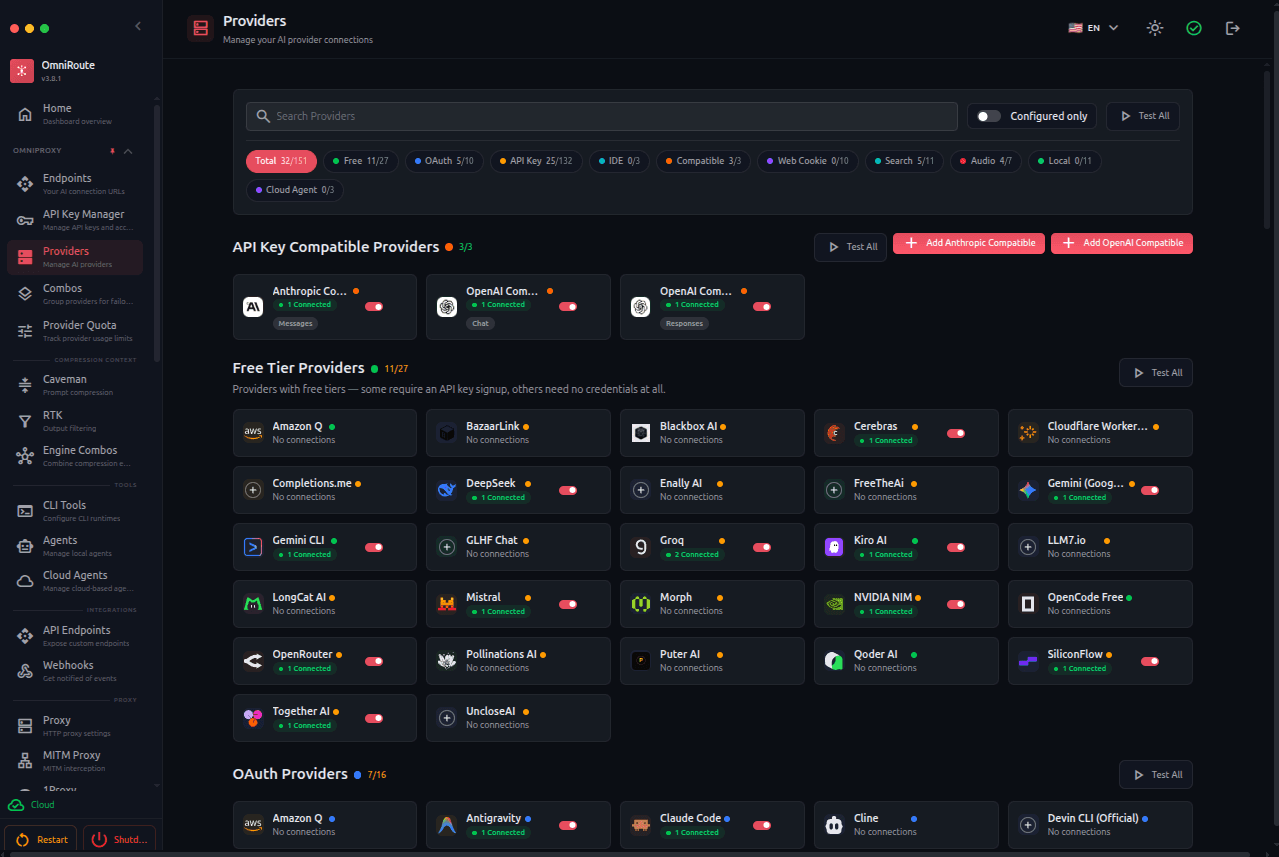
想象这样一个场景:周一早上,你打开 Claude Code 准备重构一个模块,屏幕右上角弹出 429 rate limit exceeded。你切到 Cursor 试另一家模型,提示余额不足;换 DeepSeek,勉强能用,但二十轮对话后又触发了另一家的配额限制。你在三个后台之间来回切换,每个工具都写着不同的 base URL、不同的 key、不同的模型名——真正烧掉的不是 token,是你的注意力。
OmniRoute 就是为这个场景而生的。它把 375 家模型供应商、1400 多个模型 ID 收敛到本机 http://localhost:20128/v1 这一个 OpenAI 兼容端点上,然后由它来替你处理"该调谁、还能调谁、这次该省多少 token"这三件事。
项目的作者 Diego Souza 原本只是被 AI 编程工具的账单和限流折磨的普通开发者。他的解法不是"再做一个模型",而是做一层反向代理式的"总机":所有请求先打到本地,由总机决定转给哪家上游。这个思路本身并不新鲜——LiteLLM、OpenRouter 都做过类似的事。真正让 OmniRoute 跑出来的是它近乎偏执的工程执行。
从 2026 年 2 月 13 日建仓到今天,这个仓库在八个月里积累到 79,500+ star、11,500+ fork,参与者规模达到数百人(GitHub contributors 接口返回的翻页量级约 43,100 人次)。版本号从 v3.8.49 一路推到 v3.8.52,发布节奏稳定在数周一次。它不是一个"AI 写的套壳项目"——仓库里有 26,030 个文件,其中测试相关文件 8,152 个,源码 4,024 个,文档 10,588 个(含 67 种语言的 README 副本),还有 52 个内置的 Claude Code / Cursor 技能包。
作者在 README 里给出的核心口号是 "Never stop coding",而支撑这句口号的,是一整套围绕"配额"构建的机制。
OmniRoute 最核心的设计是 Tier Cascade(层级降级)。它把可用的上游资源按优先级分成四层:
只要还有一层健康可用,请求就继续往下走。围绕这个骨架,项目又叠了三层独立的韧性机制:熔断器(连续失败自动隔离某个上游)、密钥冷却(配额耗尽的 key 自动进入冷却队列)、模型锁定(某个模型整体不可用时摘除)。这三层是相互独立的——熔断管的是"这个端点坏了",冷却管的是"这个 key 没钱了",锁定管的是"这类模型全挂了"。
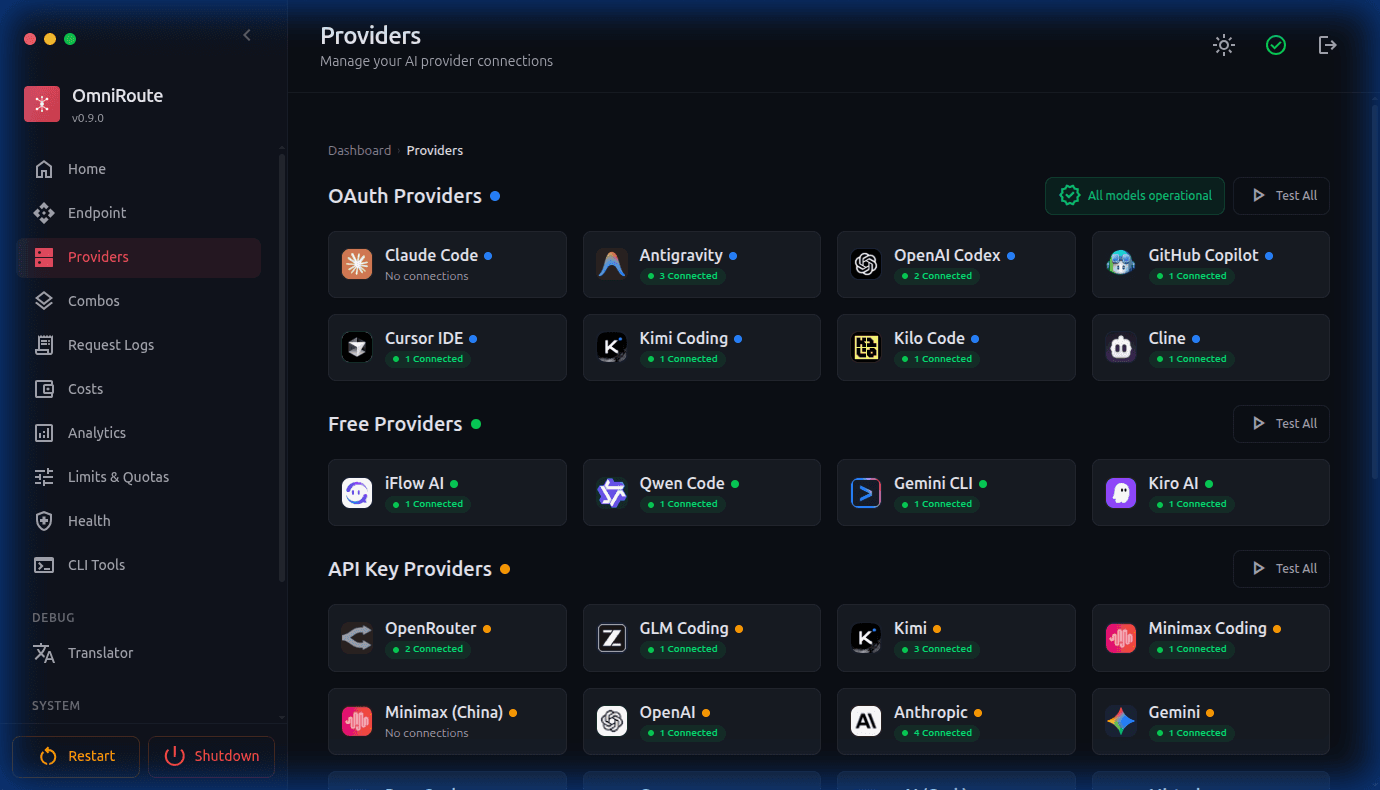
真正让这套机制跑起来的,是 Quota-aware 配额感知。OmniRoute 会持续探测各上游剩余配额,把"还能用多少"变成路由打分的一部分,而不是等到 429 报错才被动切换。配套的还有 Auto-Combo 引擎:20 种路由策略(LKGP、优先级、加权、成本优化、融合、流水线等),以及 OpenRouter 风格的组合语法——auto/coding:fast 表示"代码类模型池 + 低延迟权重",auto/reasoning:pro 表示"推理类模型 + 高端档位",auto/cheap 走成本优先。
项目自己维护了一份免费额度目录,收录 467 条免费档条目、34 个可复用的额度池,并按"同一池只计一次"的原则去重,得出约 16.2 亿 token/月 的稳态免费额度口径,首月叠加注册赠送约 22.2 亿。这个数字会每两周重新审计一次,涨落都会公开——作者明确说明它不包含需要区域身份验证的额度,也不把只有一次性的赠送算进长期口径。这种"愿意把口径写清楚并接受反证"的做法,在开源项目里并不常见。
第二个差异化点是 RTK + Caveman 压缩。Caveman 负责把自然语言 prompt 压缩成更短的等价表达,RTK 负责处理终端、shell、构建、测试和 git 的输出——这类日志通常占据 AI 编程会话 60% 以上的 token,但真正有信息量的往往只有最后几行。两者可以叠加成确定性流水线(默认 session-dedup -> lite,rtk -> caveman 可选开启)。
压缩引擎有 8 档模式,从 off(完全不改变)到 ultra(上下文超限时的抢救模式),还有一条比较特别的 OmniGlyph 引擎——把上下文渲染成图片再走视觉通道发给上游,用图像 token 换文本 token。这套组合宣称在符合条件的负载上可节省 15%–95%,平均约 89%。
这里要提醒一句:压缩本质上是有损的。官方文档把 OmniGlyph 的 profile 明确描述为"上限(ceiling)"而非保证,aggressive 档会丢弃图片系统提示、工具文档和密集历史。项目为此专门提供 balanced(保留最近 8 轮)和 coding-safe(保留工具 schema 与最近 12 轮)等更保守的档位,以及 passthrough 直通模式。工程上的正确做法是:日常用 lite/standard,只有在明确知道自己可以牺牲上下文时才开 aggressive。
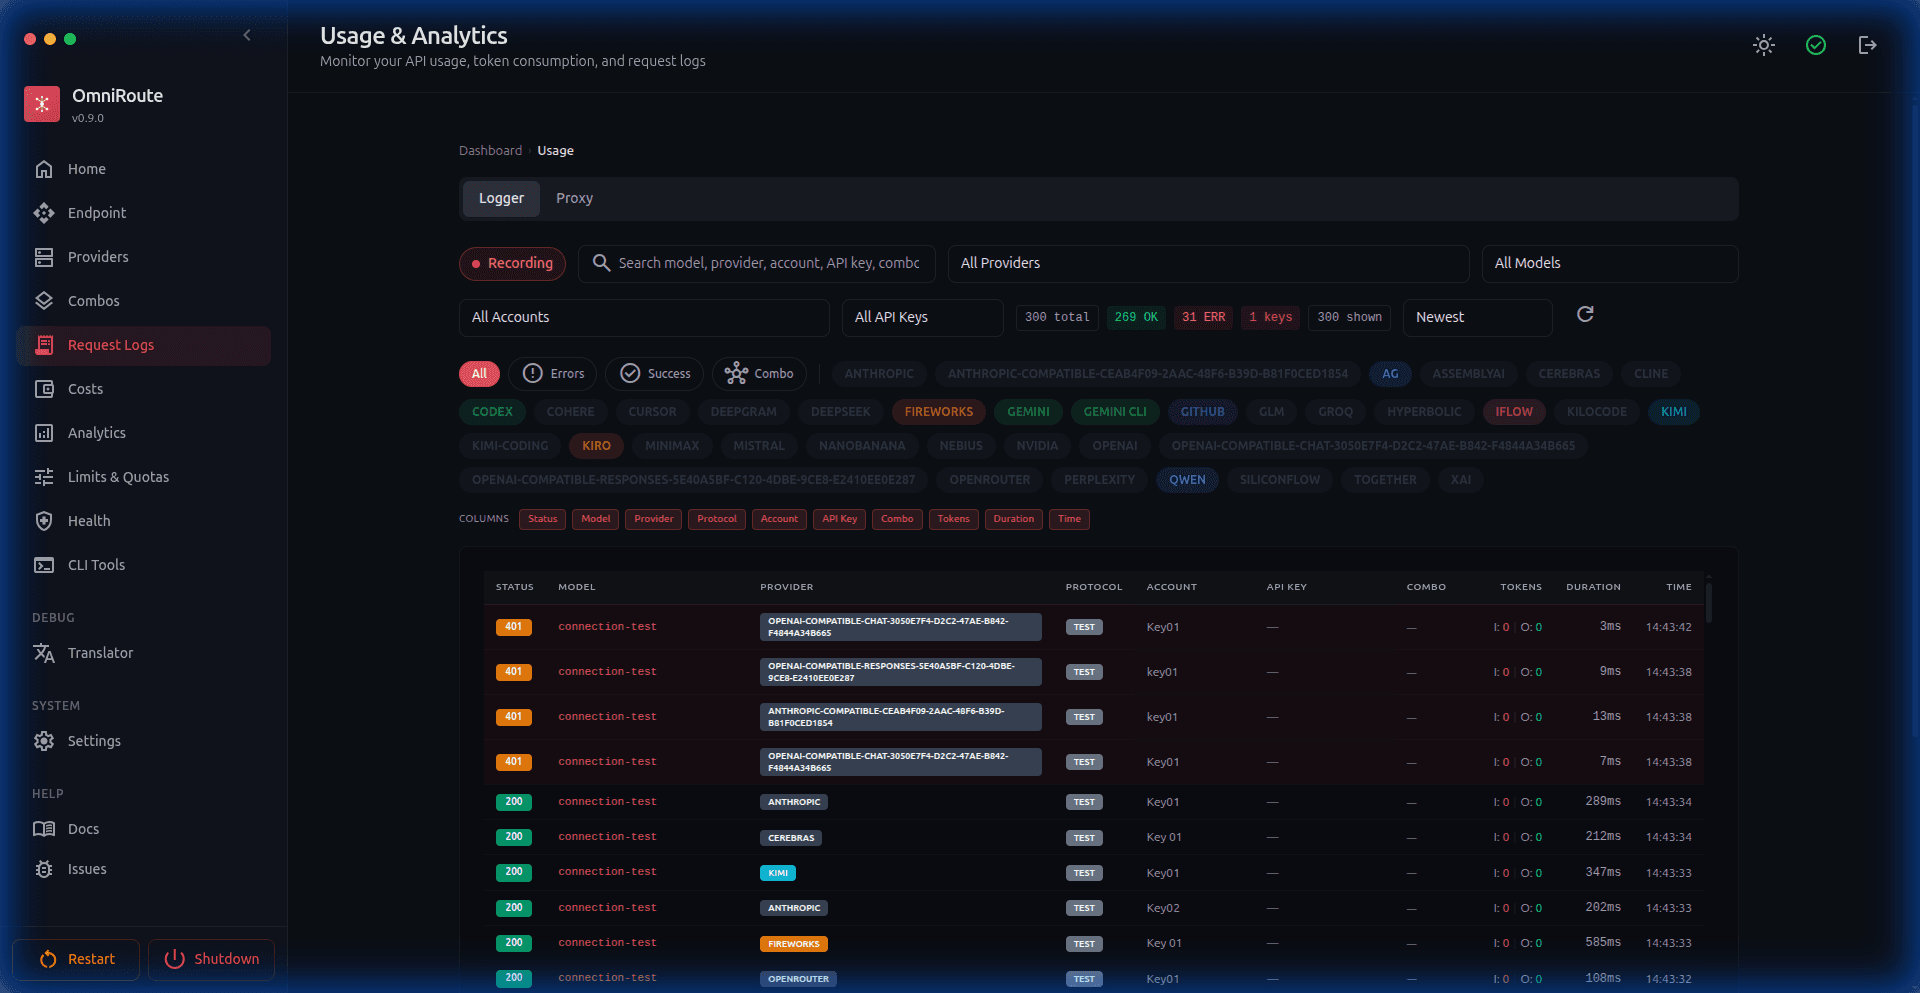
配套的 Guardrails 系统则走另一条路——它在网关与上游的边界上做检查,内置六个守卫:vision-bridge、audio-bridge、video-bridge(把非视觉模型的图片请求改路由或转描述)、pii-masker(PII 脱敏)、prompt-injection(提示词注入拦截)、credential-masker(凭据掩码)。文档里明确写了它 fail-open:守卫抛异常时记录并放行,唯一的例外是调用方主动 abort。
安装路径给得很干脆,三选一:
# npm(推荐)
npm install -g omniroute

# Docker
docker run -d --name omniroute -p 20128:20128 diegosouzapw/omniroute:latest

# 源码
git clone https://github.com/cheaper-inference/OmniRoute.git && cd OmniRoute && npm install
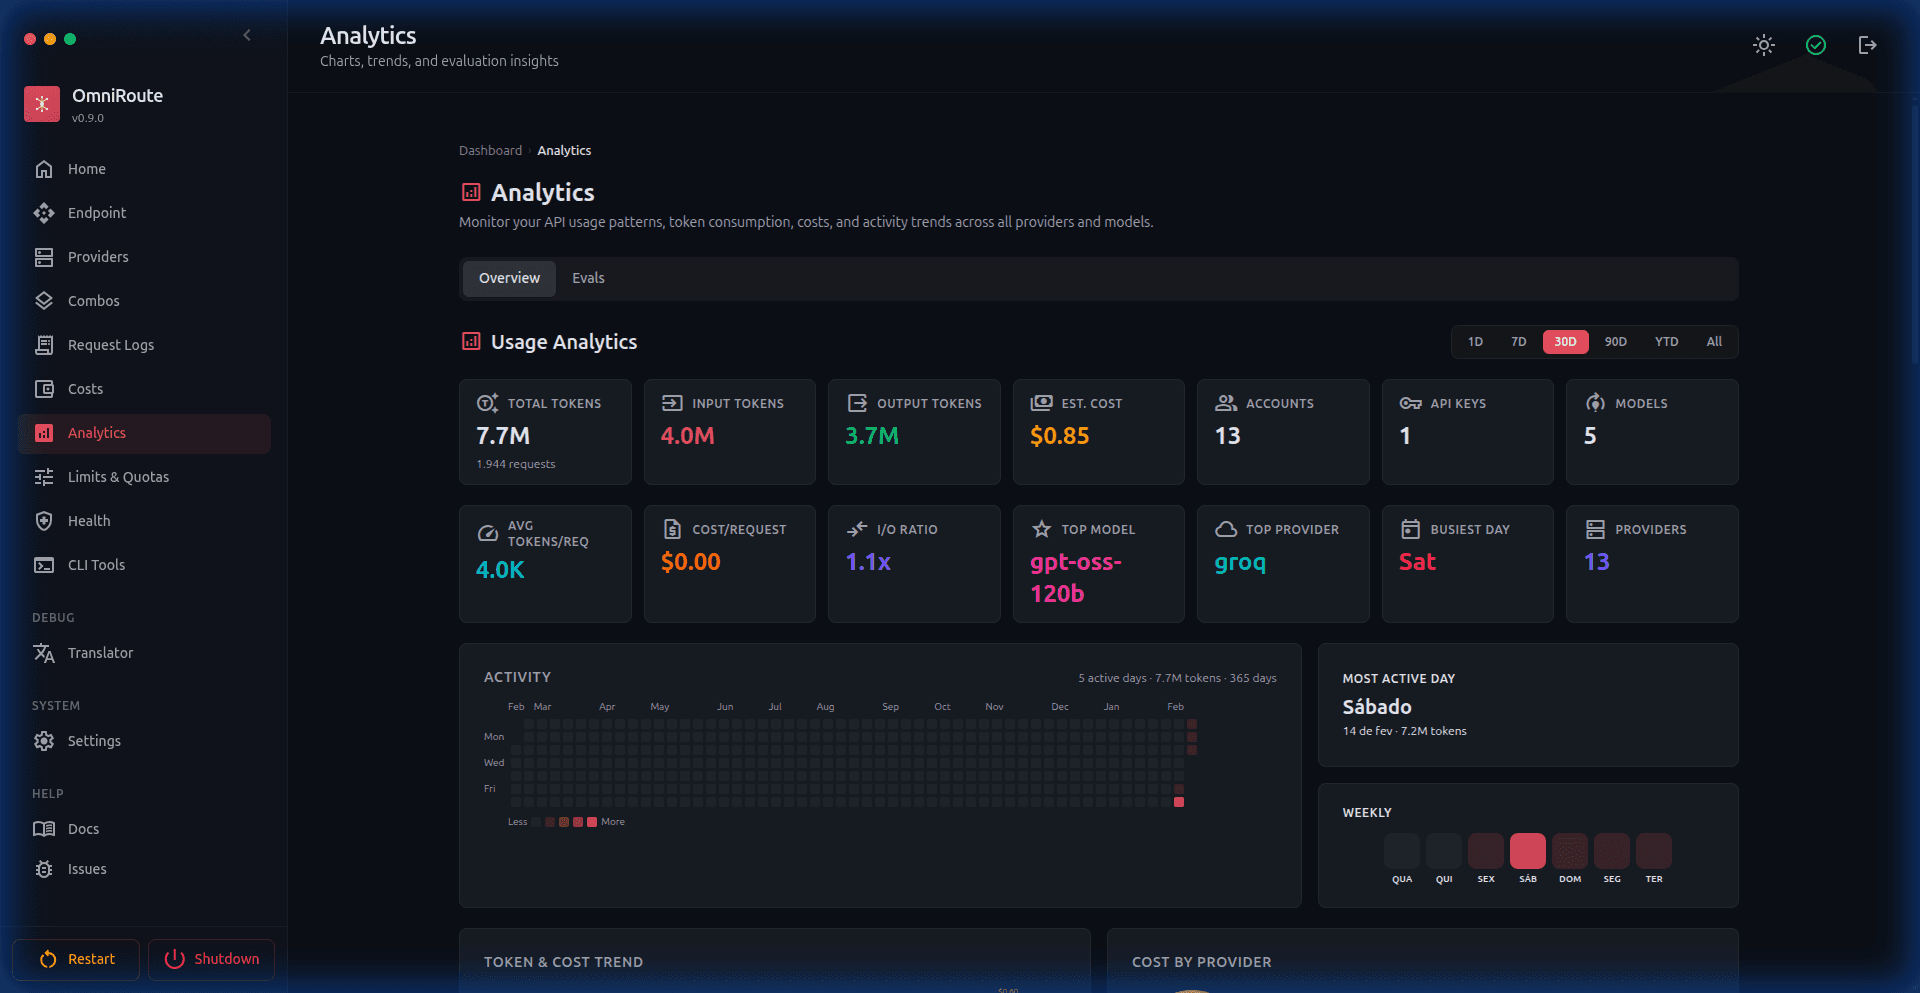
然后 omniroute 启动服务,浏览器自动打开 http://localhost:20128 控制台。在 Providers 面板接入你自己的账号或 API key,在 API Keys 页面生成一枚网关 key,最后把工具的 base URL 指到 http://localhost:20128/v1、模型填 auto 即可。
CLI 侧还提供了一键启动器:omniroute launch-codex --model auto,以及通用的 omniroute run <target>,支持 claude、codex、aider、goose、opencode、qwen、gemini。这一层包装的意义在于:它替你把环境变量、配置文件、模型名全部改写好了,而不是让你手动去改各家 CLI 的配置格式。
但有几个真实的坑必须知道:
>=22.22.2 <23 || >=24.0.0 <27,这是因为 better-sqlite3 的原生模块与 Node ABI 绑定较紧。web profile 会拉 Chromium,镜像体积和内存占用都明显上台阶。src/mitm/ 目录下的 TProxy 透明代理、证书签发等能力在 Linux 上需要 root 权限,项目用 sudoGate.ts 做了权限门控。不需要这层的用户可以完全不用它。docker compose up -d 只会起 Redis,需要显式 --profile base。想要"一条命令"体验,要用 v3.8.51+ 提供的 docker-compose.selfhost.yml 覆盖层。tos: avoid(如 Kiro),这些默认被排除在自动路由之外。技术栈是 TypeScript 全栈:Next.js 16 + React 19 + Tailwind 4 构建控制台,Express 5 承载 API,better-sqlite3 做本地持久化,Playwright 驱动浏览器型 provider,Electron 打包桌面客户端,pnpm workspace 组织 open-sse 与 packages/browser-pool 两个子包。运行时依赖 92 个,开发依赖 55 个,另有 Bun、Vitest 5、ESLint 10 + SonarJS、Prettier、Vale、markdownlint、Knip(死代码检测)、dpdm(循环依赖检测)、Stryker(变异测试)、promptfoo、fuzz(fast-check)等一整套质量工具链。
架构上是典型的 分层 + 领域驱动:src/domain/ 放组合解析、回落策略、配额、锁定策略等纯业务规则;src/lib/ 是 200+ 个能力模块(routing、compression、guardrails、quota、resilience、translator、proxyPool、evals、radar、memory…);src/app/ 是 Next.js 路由层;src/mitm/ 独立承担透明代理与证书管理;src/server/ 处理认证、鉴权、CORS 与 WebSocket;open-sse/ 是一个独立子包,承担 SSE 流式协议层。docs/architecture/ 下的 ARCHITECTURE.md、REPOSITORY_MAP.md、cluster-decisions.md 记录了每个模块的边界理由——这类"决策记录"通常只有成熟团队才会坚持维护。
值得肯定的是质量门禁的具体程度:Makefile 里直接写明覆盖率门禁是 60/60/60/60(四个维度),有独立的 check:cycles 循环依赖检查、typecheck:noimplicit:core 严格无隐式 any 检查、还有 CI 流水线和 47 个 .github/workflows 配置。
代价同样明显。 4,024 个源码文件、26,030 个总文件、67 种语言的文档副本——这对任何新接手的人都是巨大的认知负担。README 里的对比图把 OmniRoute 与 9router、OpenRouter、CLIProxyAPI、LiteLLM 逐项对比,姿态相当进攻性;而当一个项目同时维护 375 个 provider 适配、20 种路由策略、12 个压缩引擎、6 个守卫、MITM 代理、Electron 客户端、Termux/PWA 支持时,每一个"都支持"的背后都意味着一条容易腐烂的代码路径。项目自己也承认这一点——它把大量精力投在"如何让 375 个 provider 都能跑"而不是"把某一个 provider 做到极致"。
安全上要留意三点:一是 MITM/TProxy 能力本身会签发证书并解密流量,用途正当但配置门槛高,误用风险由使用者承担;二是 web-cookie provider 需要导入浏览器会话 cookie,等价于把登录态交给网关处理;三是 README 里商业链接统一带 aff=omniroute 标记(作者公开说明了这一点,属于透明披露)。项目提供了 docs/security/ 下的 STEALTH_GUIDE、GUARDRAILS、EGRESS_POLICY、INFERENCE_AUTH_POSTURE、COMPLIANCE 等 18 份安全文档,说明安全不是事后补的。
OmniRoute 最有代表性的意义,不在于它比 LiteLLM 多接了多少家供应商,而在于它抓住了一个被大厂产品忽视的真实需求:AI 编程工具的成本和配额管理,是一件"配网"级别的事,不该每次由用户手工重做一遍。
这个需求过去要么被"你直接买 API key"糊弄过去,要么由官方客户端自己做封闭的额度管理。而 79,500 star 说明,确实有大量开发者愿意把几十个第三方账号的凭据集中放在本机,换取一个"永不中断"的编码体验。
从开源生态看,它也代表了 2026 年 AI 基础设施的一个方向:AI 网关层正在从"企业 API 成本管控工具"下沉为"个人开发者的默认组件"。当模型调用从一个应用内部的能力,变成一个人日常使用的几十种服务的集合,那么统一入口、故障转移、额度可视化就不再是企业级功能,而是每个重度 AI 使用者的刚需。
值得注意的是它的克制之处——MIT 许可、纯自托管、默认不上传 prompt、免费额度口径公开可复核、作者主动标注 tos: avoid 的 provider 而非诱导使用。这类项目通常活不过第一次商业化诱惑;OmniRoute 目前挂着 "Open Source Friend" 赞助(Cheaper Inference 等),作者也明确写了"赞助只买曝光,不买路由优先级"。
如果你要做技术选型: 个人/小团队降本、需要配合 Claude Code / Codex / Cursor 且本地跑,OmniRoute 值得试;企业生产环境、对合规审计有硬要求,建议先用它跑通链路再评估自建 Gateway(它自带的 OpenAPI、鉴权、限流、审计日志是可复用的设计参考)。如果你只需要转发两三家模型,LiteLLM 或 OpenRouter 会更轻。
如果你要参与社区: 它的 skills/ 目录里放了 52 个技能包,docs/providers/ 下每家 provider 的接入方式都有独立文档——新增一家 provider 通常只需要在那儿补一份指南和一段适配代码,是门槛友好、贡献密度高的类型。
