
nightingale
ccfos/nightingale加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
线上有一条订单接口的 P99 突然爬升,值班手机开始震动。传统监控给出的只有一行 p99 > 500,接下来的排查要靠工程师自己在 Grafana 上扒时间窗口、在日志系统里捞 trace、在告警配置里翻规则。你知道"有问题",但不知道"问题在哪"。
夜莺(Nightingale)的 v9 版本想解决的正是这后半程。它是滴滴开源、后捐赠给 CCF ODC 的国产监控告警平台,如今在 GitHub 上有 13.4k Star、1700+ Fork,是国内自研可观测性生态里最活跃的项目之一。
夜莺刻意不替代 Prometheus、VictoriaMetrics、Elasticsearch、Loki,而是做它们上面的那一层。已有采集器(exporter、Categraf)、存储和 Grafana 面板全部保留,只把三件散落的事收拢到一处:
对团队管理,夜莺提供"业务分组"模型——把规则和仪表盘按业务线归口,分配团队权限,并支持 OIDC / OAuth2 / LDAP / CAS 单点登录。它还保留了一套完整的执行记录:每次规则评估的查询语句与结果、活跃与历史事件、通知投递结果,能从"一次查询"一路追溯到"一条通知落地"。
如果把监控系统比作航空管制:Prometheus、VictoriaMetrics 像地面雷达和气象站,负责"测到数据";夜莺则是塔台,负责"看数据 → 判断 → 决断 → 放行"。它不生产数据,但它决定了数据变成行动的方式。这种"中间层"定位让它的迁移成本极低——存量 Prometheus 告警规则可导入 YAML(表达式、时长、标签、注解都能转),但官方也明确说明这不是对 alertmanager.yml 的完整转换,建议双跑评估后再切。
v9 把 AI 直接做进了主链路,而不是外挂一个聊天框:
aiagent/skill/embedded/builtin/ 下内置多个监控场景技能,团队还可以把自己的值班手册、参考资料、脚本打包成自定义 Skill,支持从 Git 导入。/mcp 端点默认只暴露读工具(告警、机器、数据源、静默、通知规则、订阅、事件流水线、指标、日志、仪表盘、用户等十余个工具集、数十个细粒度工具),外部 AI 客户端(Claude、Cursor)配上 X-User-Token 即可把夜莺当工具用。写工具需要显式开启白名单。仓库提供 4 套 Compose 编排(bridge、host-network、host-network-metric-log、postgres),其中 docker/compose-bridge 是开箱即用栈:
git clone https://github.com/ccfos/nightingale.git
cd nightingale/docker/compose-bridge
docker compose up -d
一次拉起 Nightingale + MySQL + Redis + VictoriaMetrics + Categraf,浏览器打开 http://localhost:17000,默认账号 root / root.2020。要跑通第一条告警,需三步:接数据源(用栈内的 http://victoriametrics:8428 最快)→ 建规则(测试可用 vector(1) > 0、duration 设 0)→ 配通知渠道并把通知规则绑到告警规则。
架构上是"一个代码库、三个二进制":n9e(center,拥有数据库与 UI)、n9e-edge(远端数据中心节点,无数据库)、n9e-alert(独立告警引擎)。多实例共享元数据库与 Redis,嵌入式 TSDB 仅限单实例本地盘,生产多实例建议外接时序存储。Kubernetes 场景官方提供独立 Helm Chart(flashcatcloud/n9e-helm)。
硬件门槛很低:不需要 GPU,2GB 内存、1GB 磁盘起步,AI 功能只有你接了模型端点才产生额外开销。源码构建需 Go 1.25+。
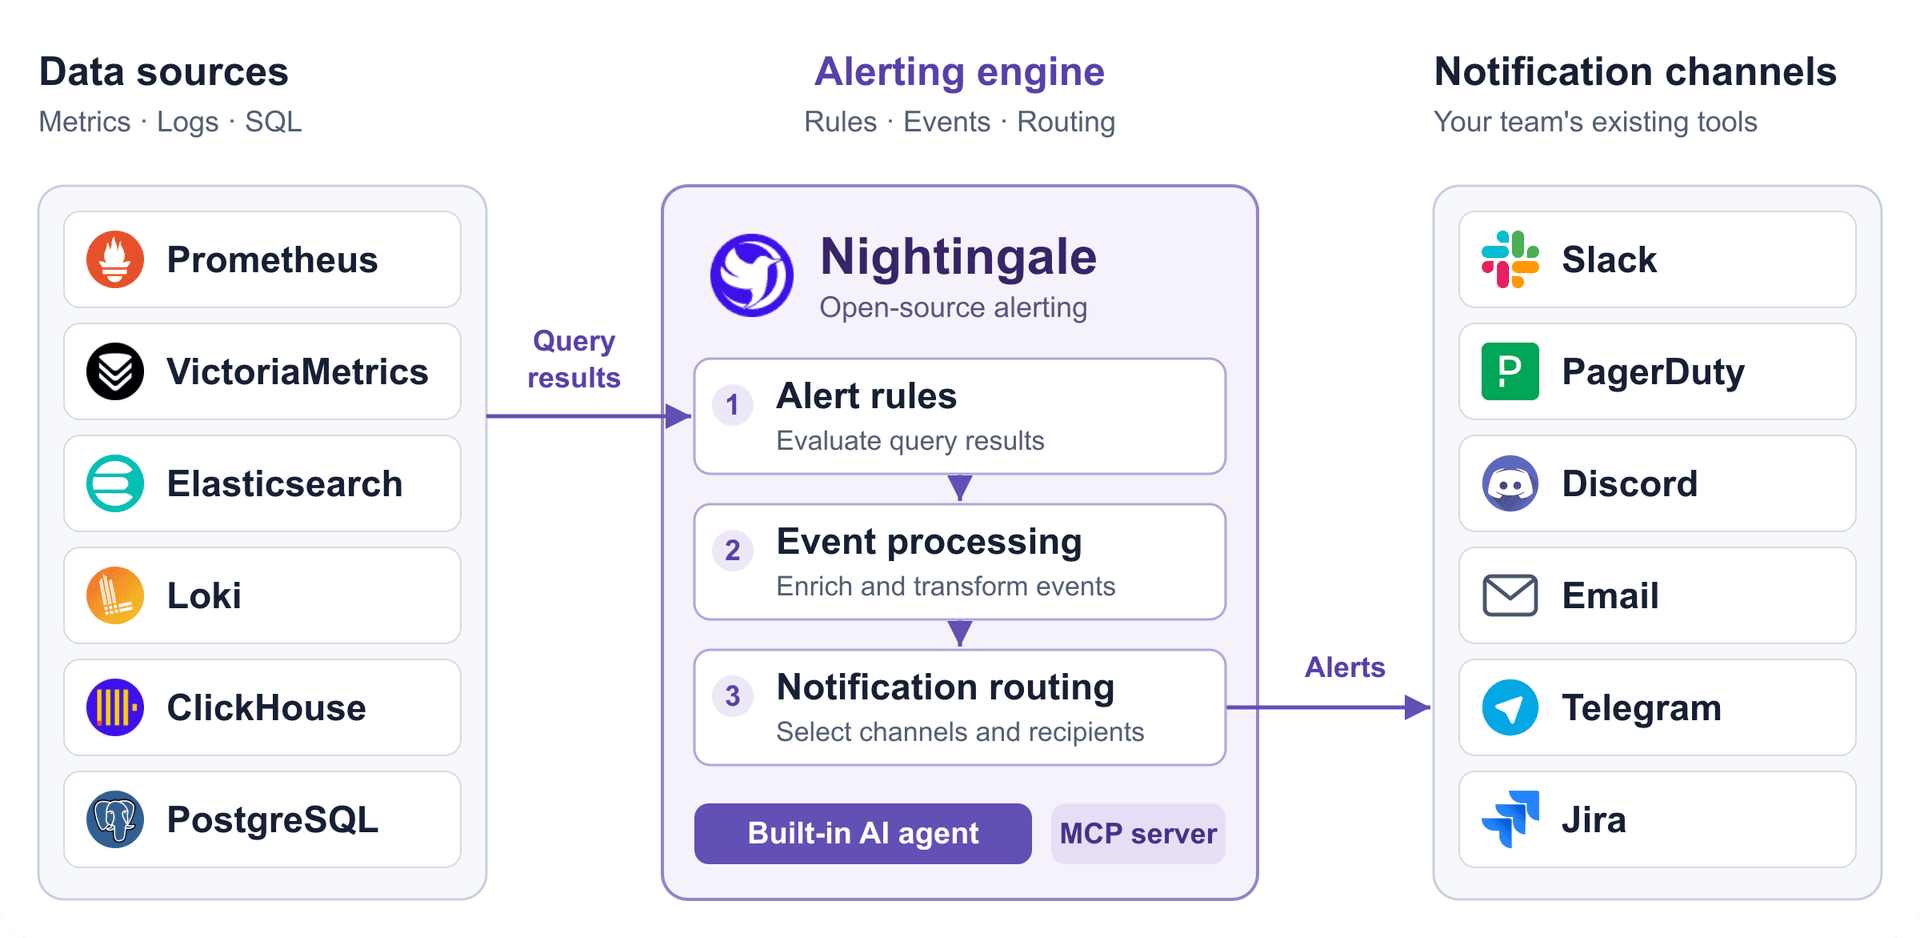
图:夜莺在既有数据栈之上承担规则评估、事件处理与通知路由
代码库 1892 个文件,其中 Go 源码 845 个、_test.go 测试文件 240 个,测试密度相当高——尤其是新增的 aiagent/ 目录(237 个文件)几乎每个模块都配了测试,aiagent/tools/dashboard_* 甚至包含端到端测试。后端采用 Gin + GORM,单元测试用内存 SQLite,无需外部依赖即可跑 go test ./...。CI 里除了 goreleaser,还设了两道"集成模板闸门"(integrations-alert-action、integrations-i18n),确保内置告警规则必须带 action 注解、英文模板不得夹中文——这是把规范写进流水线而非靠人自觉的做法。
前端是独立仓库 n9e/fe,构建时以 statik 形式嵌入后端二进制,因此后端仓库始终保持单二进制交付。代码注释大量使用中文,CLAUDE.md 对架构、缓存一致性约定、读写路径分支规则写得非常细致,对 AI 辅助开发是一份高质量参考。
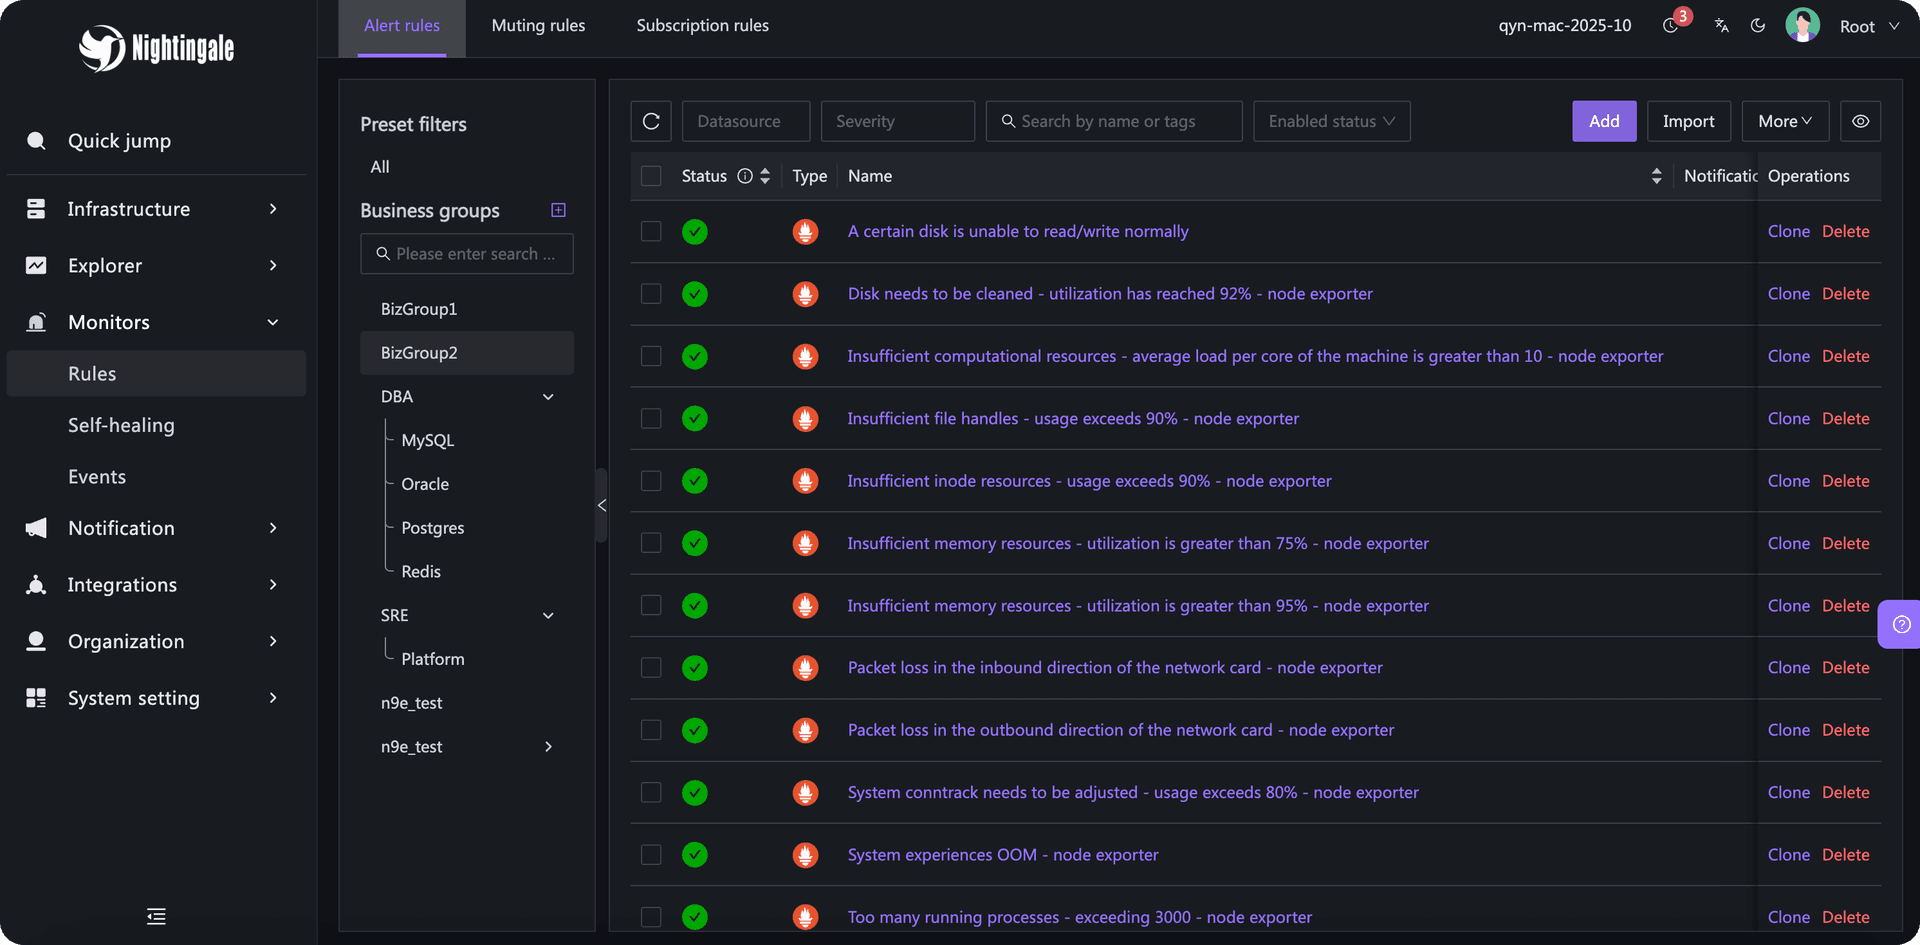
图:按数据源与业务分组组织的告警规则管理界面
需要清醒看待的几点:
root/root.2020,官方文档也提醒"部署到共享或公网主机前先改凭证、审网络暴露"。生产部署必须自行加固。夜莺代表了国产监控项目的一次形态跃迁:从"指标采集+阈值告警"走向"事件处理中枢+AI 副驾驶"。它把 AIOps 的口号落成了可运行的产品——不是让大模型去预测故障,而是让 Agent 去查数据、读规则、翻日志、给结论,最后收敛到确定性的告警与通知动作上。
更值得关注的是它同时向两个方向开放:向内把 Agent 嵌进产品,向外通过 MCP/A2A 把自己的 70+ 工具暴露给 Claude、Cursor 等外部客户端。这让夜莺从一个"监控平台"变成了"AI Agent 可调用的运维基础设施",也正是 2026 年可观测性产品的共同演化方向。
如果你正处在"Prometheus 指标有了、告警散在各处、排查全靠人肉"的阶段,夜莺 v9 值得放进评估清单;如果你只是想给单个服务加个告警,那它显然太重了。
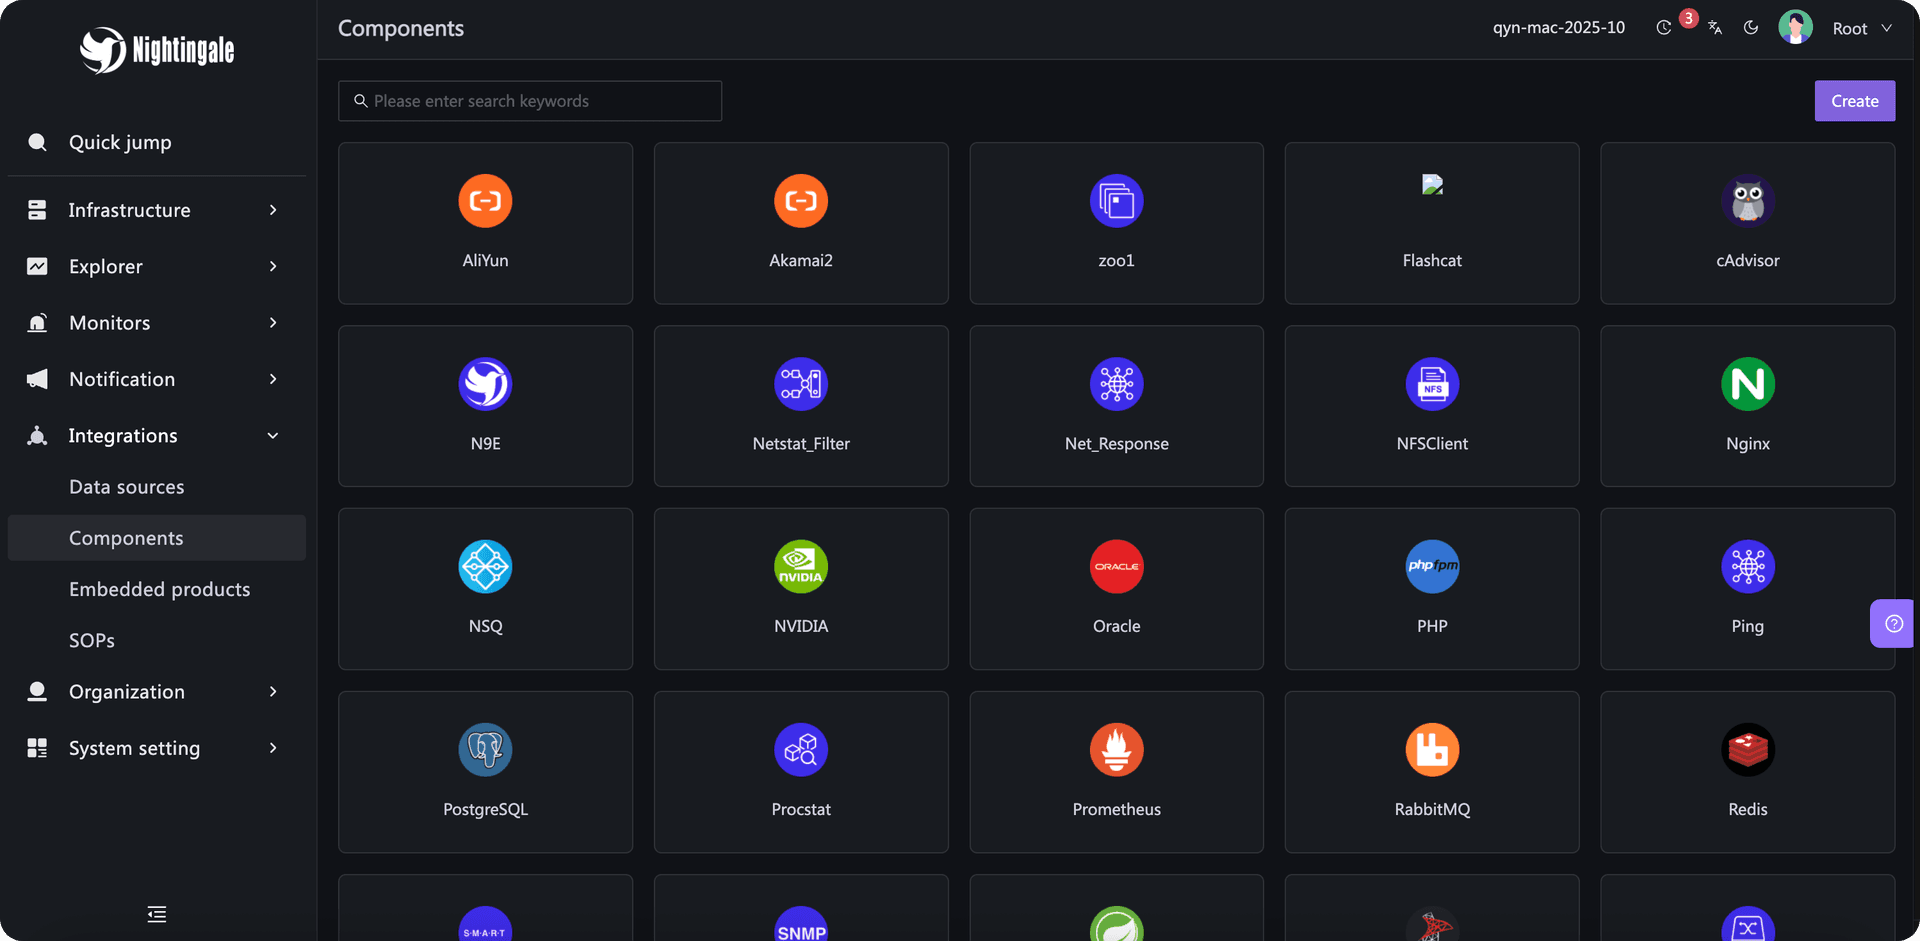
图:内置的采集器配置、告警规则与仪表盘集成组件
