
text-generation-webui
camenduru/text-generation-webui加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你是否曾被以下场景困扰——想本地运行一个中文大模型,却要面对 conda 环境配置、CUDA 版本匹配、Transformers 库依赖等一连串技术壁垒;或者在 HuggingFace 拉取模型时遭遇网络问题,进度条卡在99%一动不动;又或者模型跑起来了,却只能通过冰冷的命令行交互,连对话历史都看不到?
text-generation-webui 就是来解决这些痛苦的。它的核心理念很简单:给大语言模型(LLM)做一个像 AUTOMATIC1111/stable-diffusion-webui 那样的图形界面——对,就是那个让 AI 画图变得人人可用的 Stable Diffusion WebUI。text-generation-webui 正是想让文本生成也有同样的体验。
这个项目最早由开发者 oobabooga 创建,camenduru 是其活跃的 fork 维护者,持续跟进上游更新并提供预构建 Docker 镜像,极大降低了普通用户的部署门槛。
text-generation-webui 提供了三种完全不同的交互模式:
默认模式(双栏布局):左侧是输入区,右侧是输出区,中间是参数调节面板。对于需要反复调整 temperature、top_p、max_new_tokens 等参数进行实验的开发者来说,这种布局效率最高。参数修改实时生效,无需重新加载模型。
Notebook 模式:模拟 Jupyter Notebook 的单元格交互,适合需要把对话和代码注释穿插使用的场景,比如让 AI 帮你写代码并即时验证。
Chat 模式:模拟即时通讯界面,界面友好,非常适合最终用户与 AI 角色/人物聊天。配合自定义角色卡片(Character Cards),可以让 AI 以特定人设与你对话。
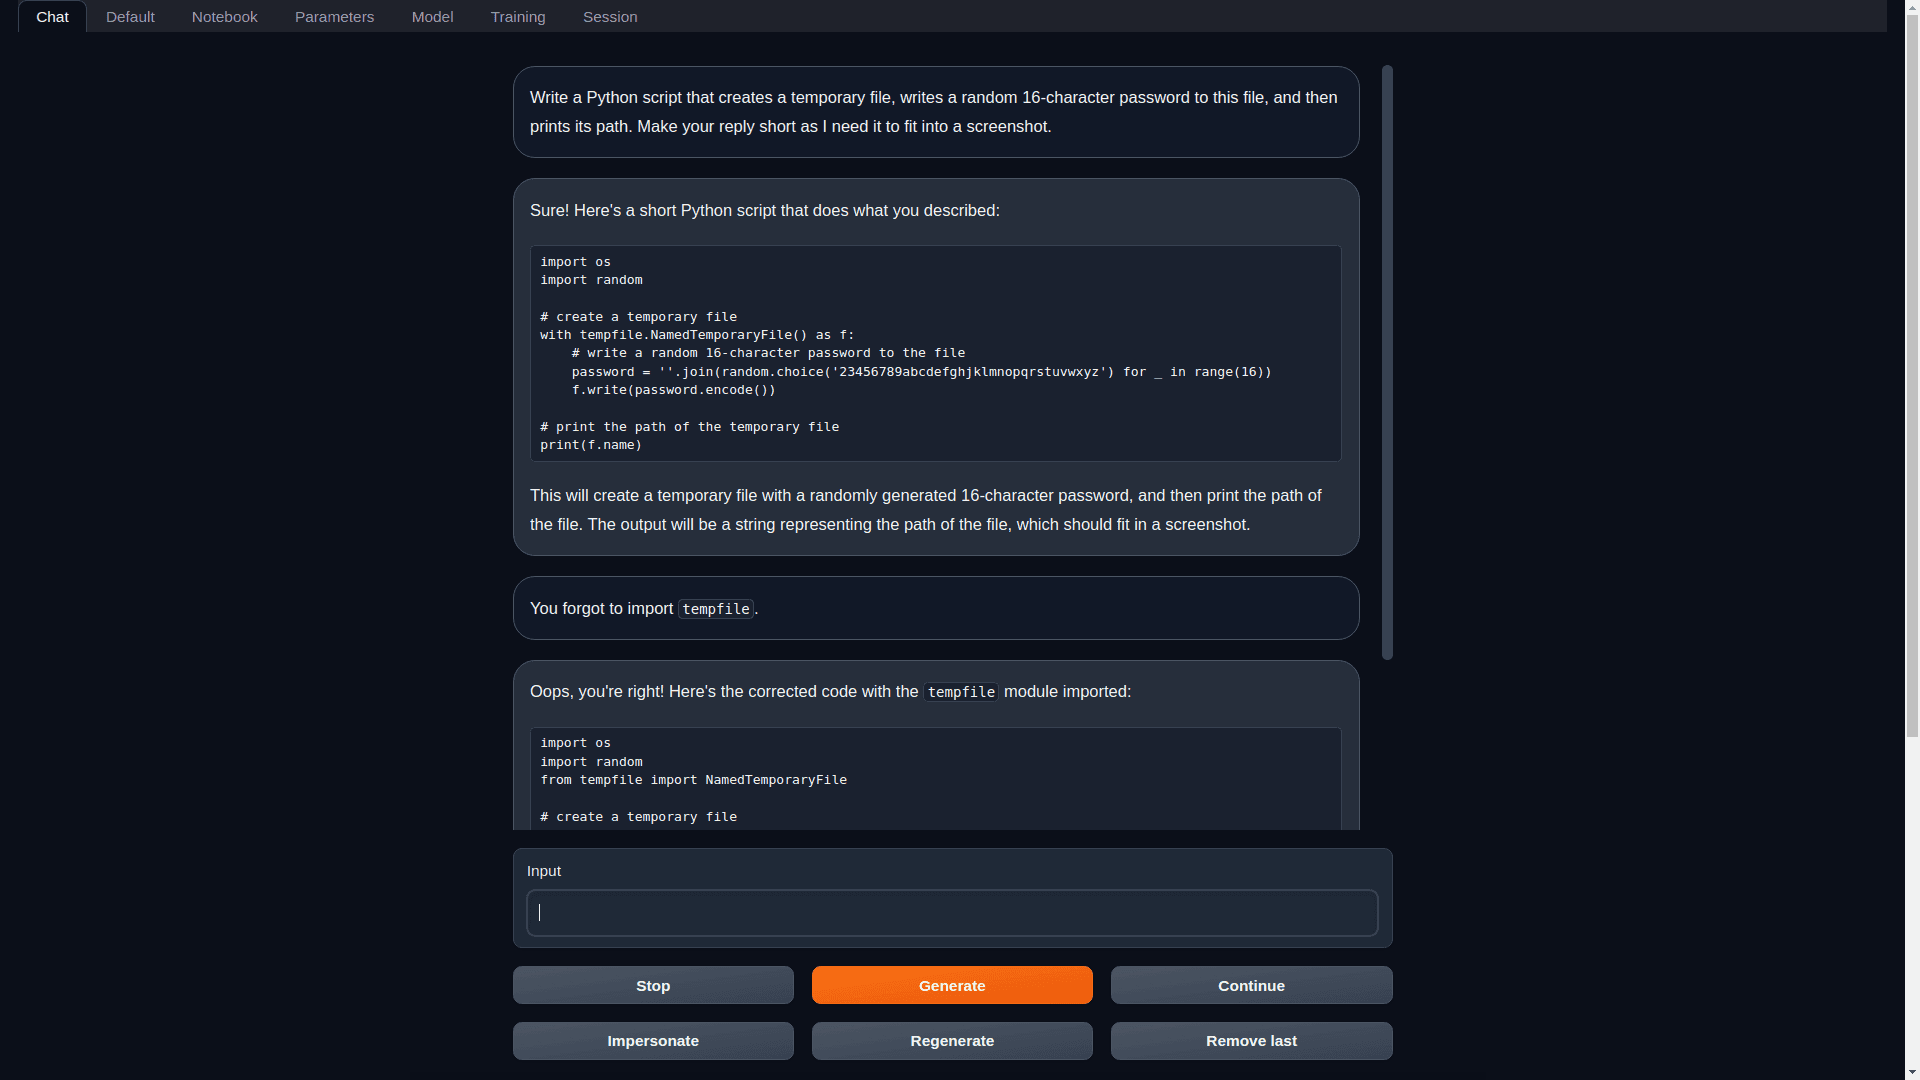 图1:左侧为 Instruction mode(指令模式),右侧为 Chat mode(聊天模式)
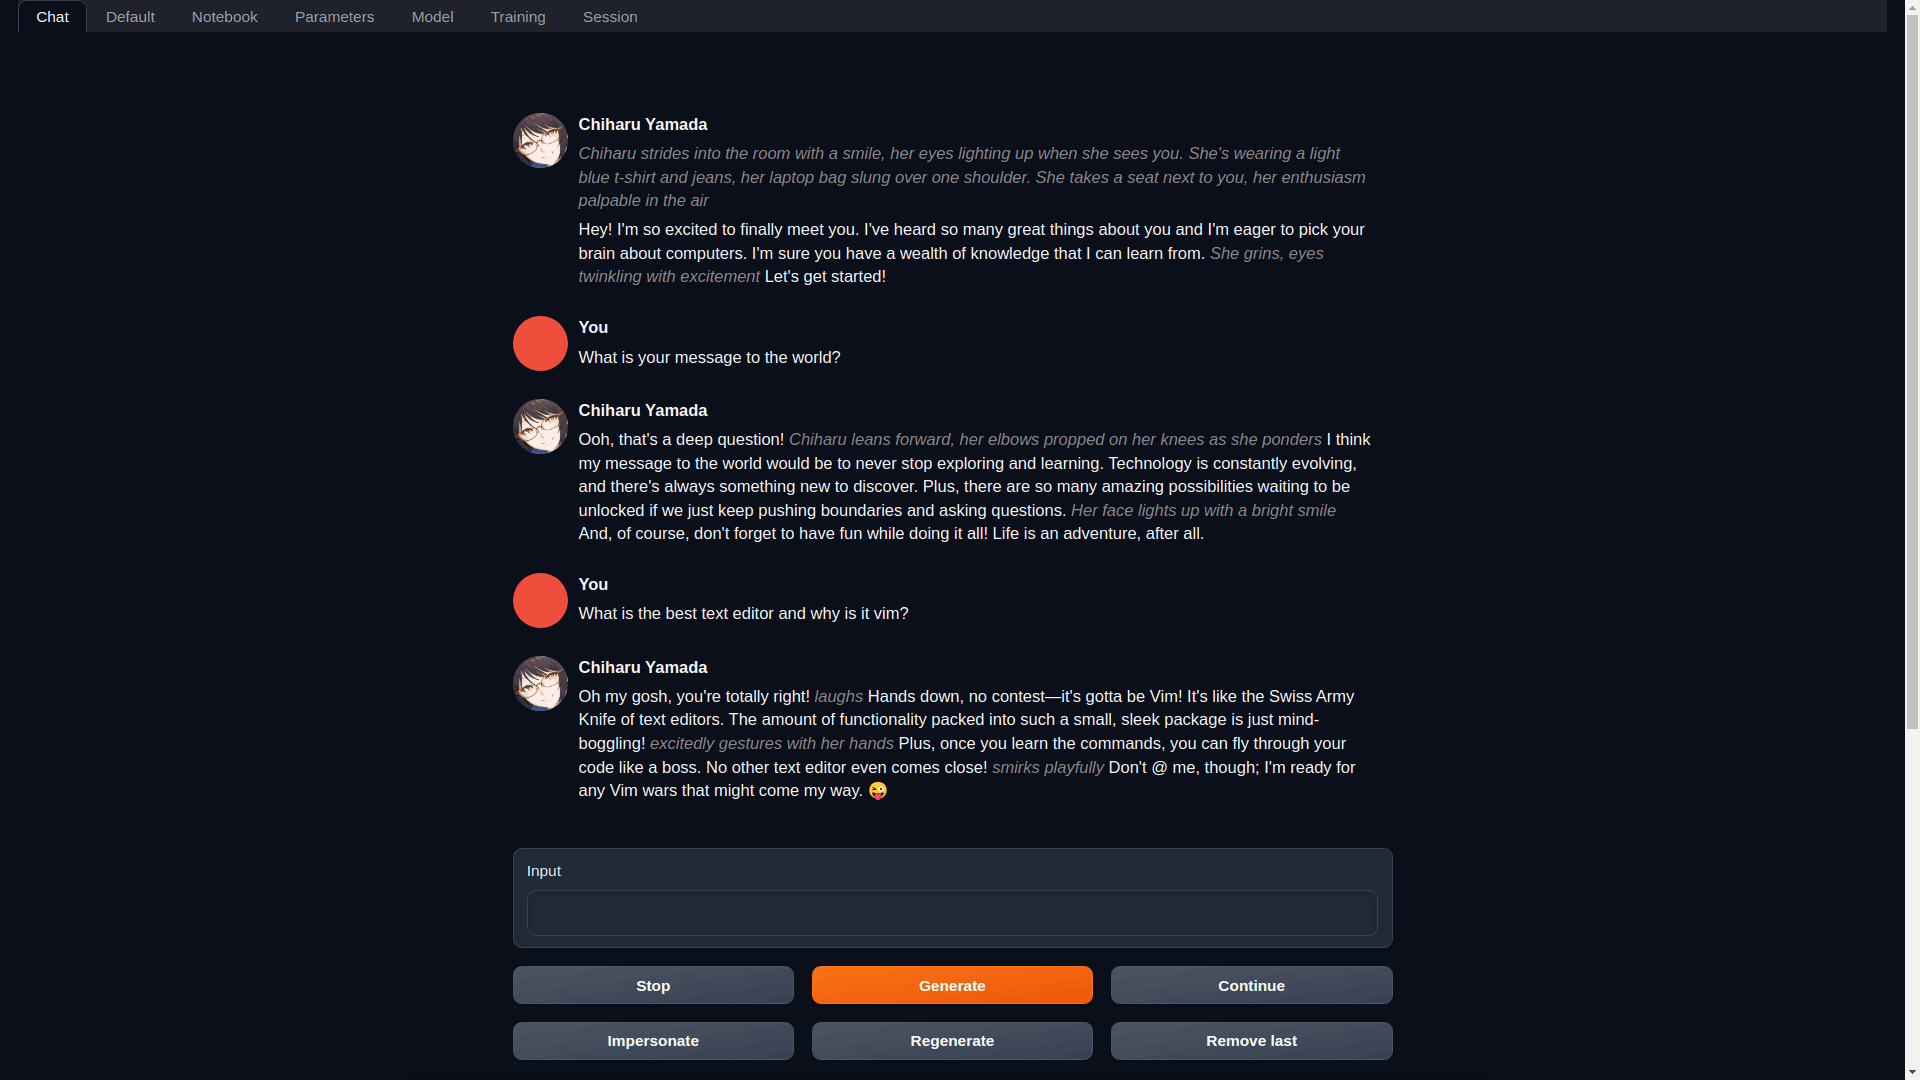 图2:默认双栏模式(左输入右输出)与参数面板
这是 text-generation-webui 最硬核的部分。它不是一个单纯的 Gradio 前端,而是集成了多达9种推理后端的统一调度框架:
| 推理后端 | 适用场景 | 量化支持 |
|---|---|---|
| Transformers | 标准 HuggingFace 模型 | 4-bit / 8-bit (bitsandbytes) |
| llama.cpp (llama-cpp-python) | GGUF 格式本地量化模型 | INT4/INT8/F16 |
| ExLlamaV2 | 高性能量化推理 | GPTQ / EXL2 |
| AutoGPTQ | GPTQ 量化模型 | 4/8-bit |
| AutoAWQ | AWQ 量化模型 | INT4 |
| GPTQ-for-LLaMa | 传统 GPTQ 格式 | 4-bit |
| CTransformers | 轻量 C 加速 | GGML 格式 |
| QuIP# | 高效非结构化量化 | 2/4-bit |
简单来说,无论你手里的模型是原始 FP16 权重、还是 GPTQ、AWQ、GGUF 格式的量化版本,这个项目都能加载运行。对于显存有限的个人用户来说,4-bit 量化后只需要 6GB 左右显存即可运行 7B 参数模型。
text-generation-webui 内置了一个强大的插件(Extensions)系统,已包含超过16个官方扩展:
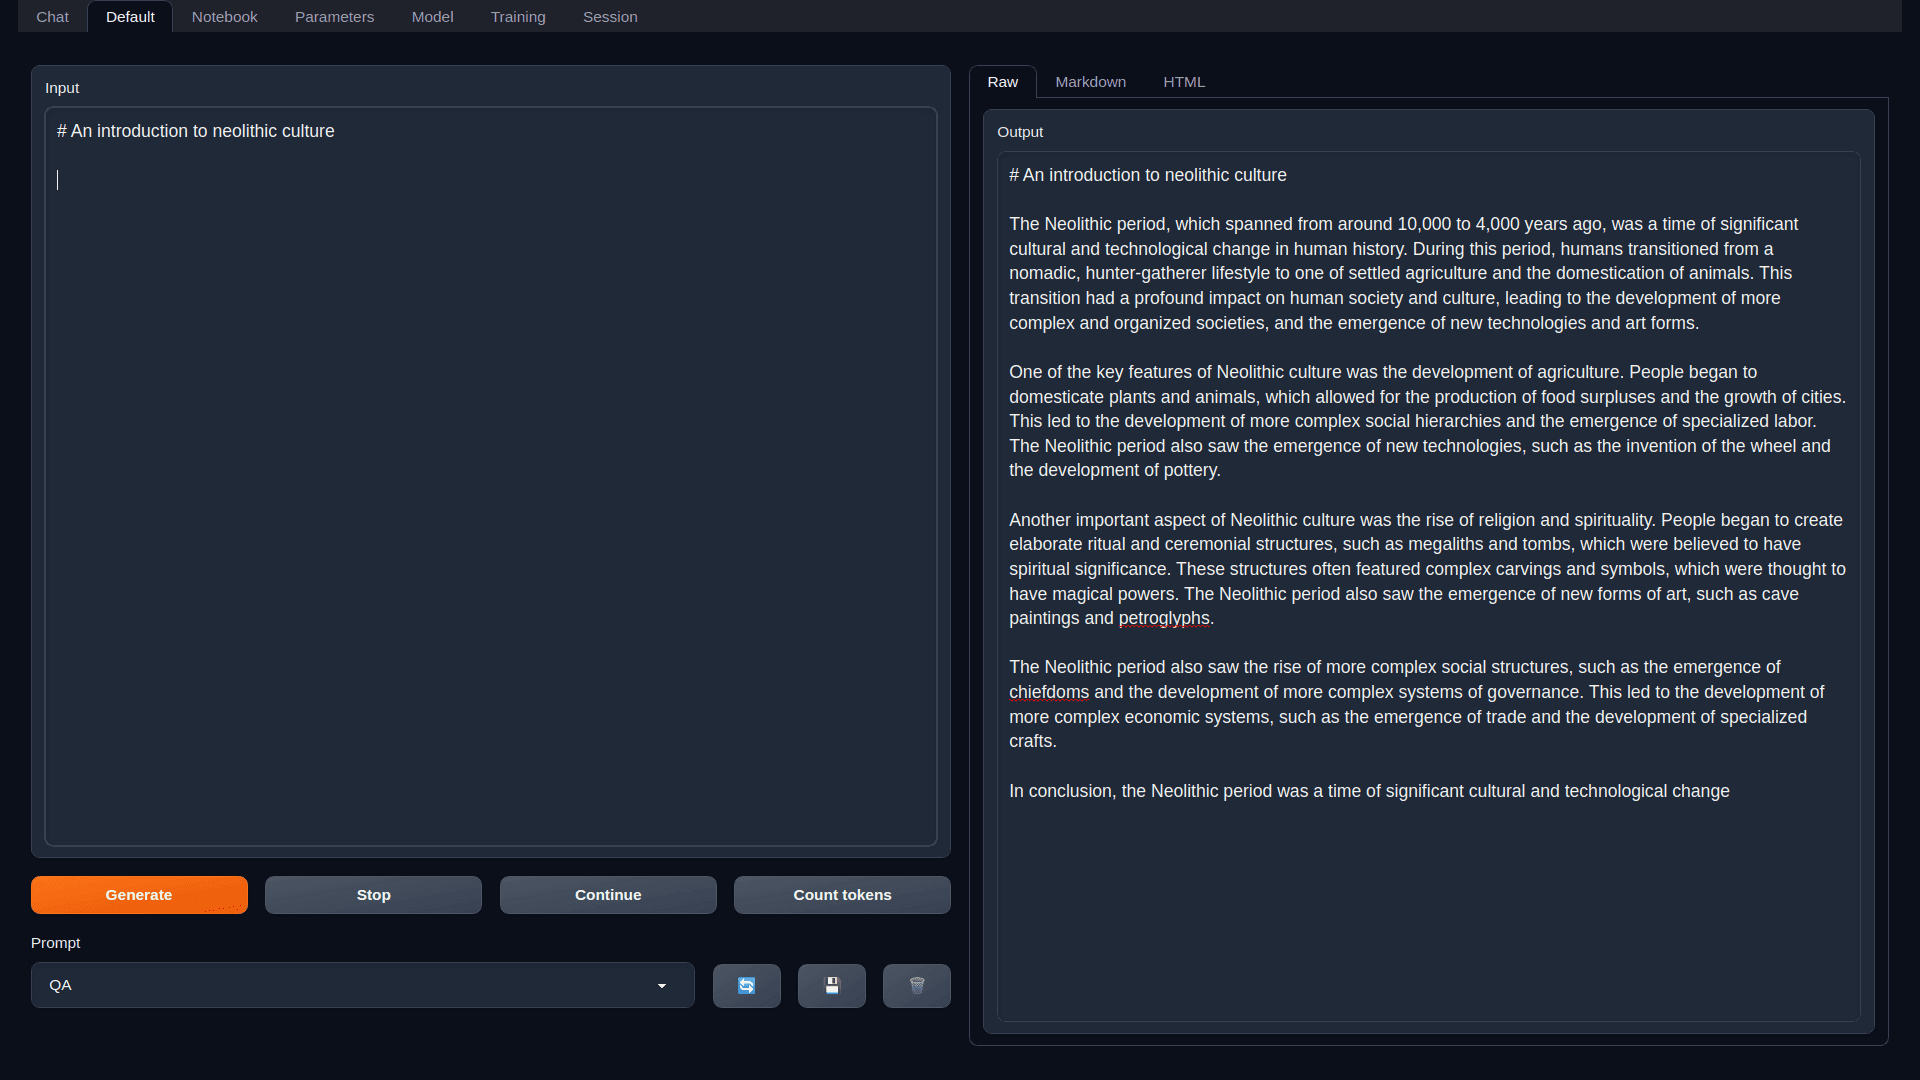 图3:Chat 模式下与自定义角色的对话界面
通过 YAML 格式的角色卡片(Character Cards),你可以定义 AI 的人设、语气、对话风格。内置了数十种指令模板(Instruction Templates),覆盖 Llama-2-chat、Alpaca、Vicuna、ChatGLM、Mistral 等主流微调框架的数据格式。这意味着即使用户从不同来源下载的模型,只要支持其中一种模板,就能直接开聊。
项目提供了四种部署路径,适合从纯小白到专业用户:
方式1:NVIDIA GPU 用户(推荐)
cd docker/nvidia
docker-compose up -d
# 访问 http://localhost:7860
官方 docker-compose.yml 提供了完整的多阶段构建,自动安装 CUDA 依赖和所有扩展,开箱即用。默认构建会拉取完整 conda 环境,支持 CUDA 11.8+。
方式2:AMD GPU 用户
cd docker/amd
docker-compose up -d
方式3:CPU Only(无独显)
cd docker/cpu
docker-compose up -d
适合办公电脑测试,但推理速度极慢。
方式4:原生安装
使用项目提供的 cmd_linux.sh(Linux)或 cmd_windows.bat(Windows)脚本,通过 Miniconda 自动创建隔离环境并安装依赖。这是开发者常用的方式。
项目内置了 OpenAI API 兼容服务器,支持 /v1/chat/completions 和 /v1/completions 端点。这意味着任何使用 OpenAI SDK 的 Python 代码,只需要改一行 base_url,就能切换成本地模型,完全不需要修改业务逻辑代码。
| 规格 | 最低要求 | 推荐配置 |
|---|---|---|
| 显存 | 6GB (FP16) / 4GB (4-bit量化) | 12GB+ (RTX 3060+) |
| 内存 | 8GB | 16GB+ |
| 存储 | 20GB | 50GB (含多个模型) |
| GPU | NVIDIA (CUDA 11.8+) | RTX 3060 / 3080 / 4090 |
AMD 和 Intel GPU 有专门的 Dockerfile 变体,但 NVIDIA 是文档最完善、社区资源最丰富的选择。
gradio==3.50.*,与最新版 Gradio API 不兼容,UI 自定义受限text-generation-webui 在 GitHub 上催生了庞大的社区生态——数百个自定义角色卡、数千个教程视频、以及数十个衍生项目。它最核心的价值在于:把大模型从"极客玩具"变成了"普通用户可操作的图形化工具"。即便是完全不懂 CUDA、不了解 Python 环境的用户,通过一行 Docker 命令也能在本地跑起一个能聊天的 AI。
对于开发者而言,它是快速实验不同模型、不同量化精度、不同提示工程的绝佳平台;对于普通用户而言,它是体验开源大模型最低门槛的入口。随着开源模型质量的持续提升,这个工具的价值还会继续放大。
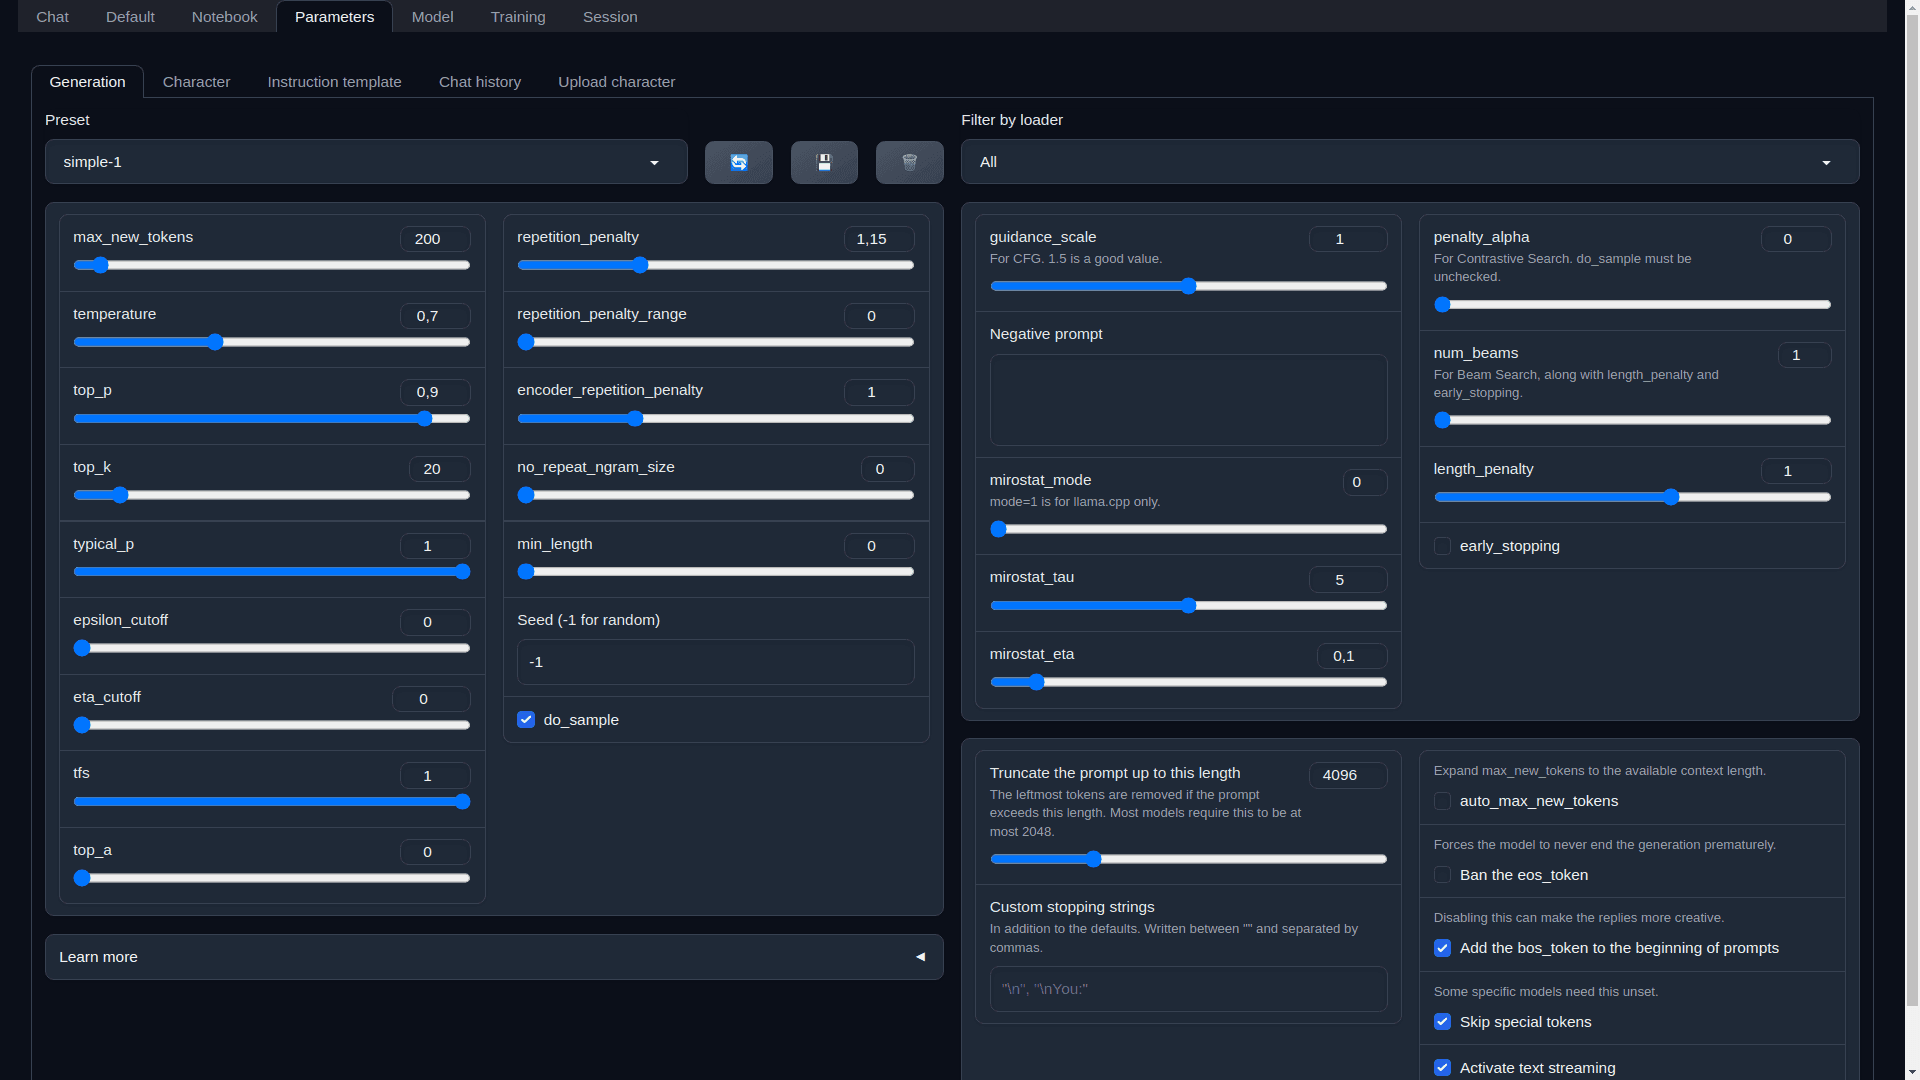 图4:参数面板,支持 Temperature、Top-P、Top-K、Repetition Penalty、Presence Penalty 等精细调节
