
MTLNAS
bhpfelix/MTLNAS加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你是一名工厂流水线主管,你需要同时训练一名工人完成三件完全不同的事:识别零件缺陷、测量零件尺寸、判断零件是否合格。传统做法是让这名工人同时学习所有技能,结果往往是——哪件事都做得马马虎虎。这就是**多任务学习(Multi-Task Learning, MTL)**长期面临的困境:不同子任务之间相互干扰,强行共享特征反而让每个任务都变差了。
2019 年前后,研究者们开始意识到:问题的根源可能在于网络架构本身——也许不是学习策略不够好,而是我们手工设计的网络结构从根子上就不适合多任务。于是,一个大胆的想法诞生了:能不能让机器自己来设计这个网络? 也就是用 Neural Architecture Search(NAS,神经架构搜索)来自动发现最优的多任务网络结构。这就是 MTL-NAS 诞生的背景。
MTL-NAS 是发表在 CVPR 2020 的学术论文《Task-Agnostic Neural Architecture Search towards General-Purpose Multi-Task Learning》的官方 PyTorch 实现,由来自国内外多所高校的研究者联合贡献。论文第一作者来自南开大学等机构,该工作探索了一个极具前瞻性的课题:能否构建一个任务无关的通用多任务网络,不需要针对每个新任务重新设计架构,而是让 NAS 算法自动找到适合当前任务组合的最优结构?
项目的 GitHub 页面清晰地展示了这一工作的核心思路——通过强化学习驱动的 NAS 搜索,MTL-NAS 能够在给定的多任务集合(如语义分割 + 深度估计)上,自动搜索出一个最优的参数共享与任务特定分支的混合结构,让多个任务在同一个网络中各取所需、相得益彰。
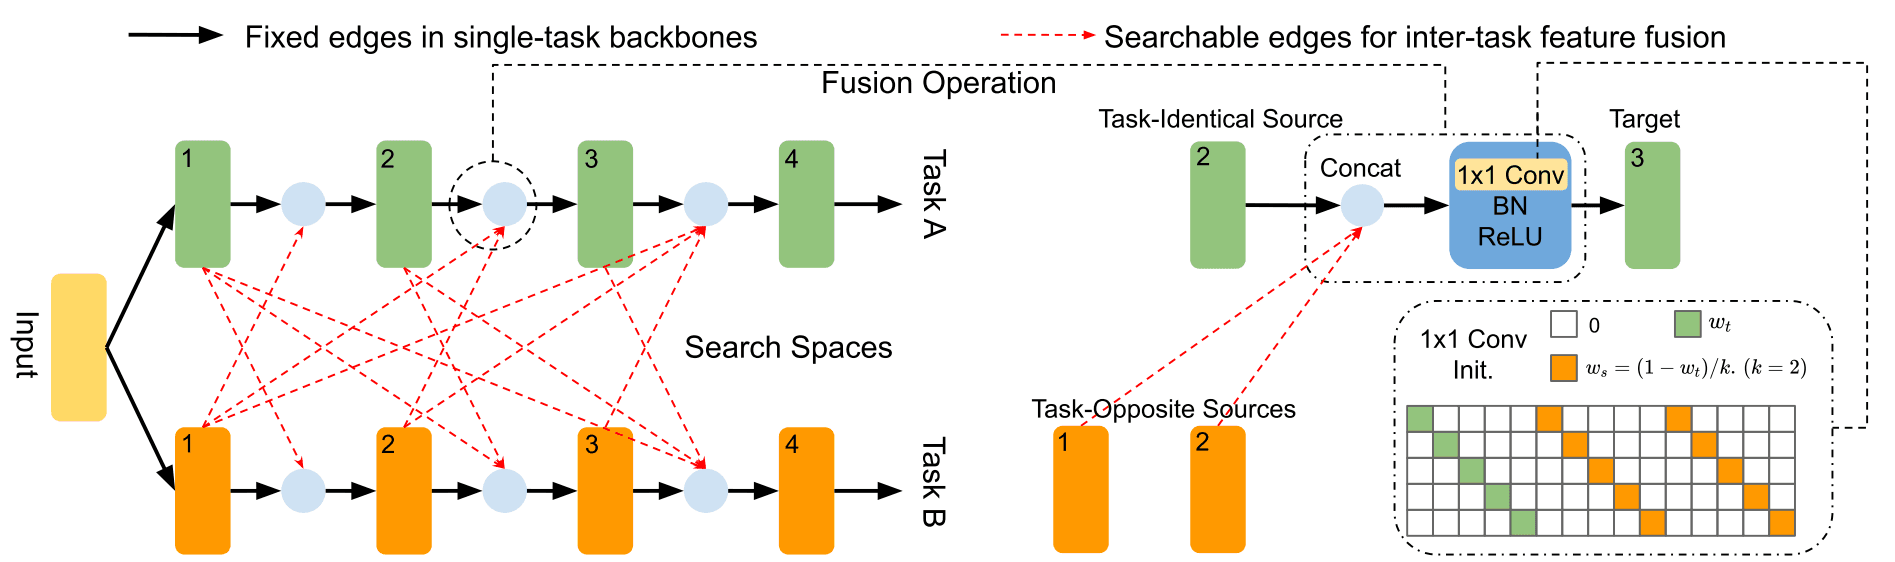
图注: MTL-NAS 的核心思想是用 NAS 自动搜索适合多任务学习的网络架构,图中展示了搜索空间设计以及最终搜索得到的网络结构。
MTL-NAS 的代码采用 PyTorch 1.4.0 实现,核心代码组织如下:
core/models/ — 网络架构搜索空间定义与模型实现core/tasks.py — 多任务定义(目前支持 NYU v2 数据集上的语义分割和法向量估计两个任务)core/data/ — 数据加载与预处理core/utils/ — 损失函数(seg_loss、normal_loss)、评估指标(compute_hist、compute_angle)和可视化工具tools/train_nas.py — NAS 训练主入口,支持分布式训练(DistributedDataParallel)关键依赖包括:tensorboardX(训练可视化)、yacs(配置文件管理)、PyYAML(训练配置)。代码接受 YAML 格式的配置文件(位于 configs/ 目录),支持多种实验配置(vgg/ 和 ablation/ 目录)。
分布式训练支持:代码原生支持 torch.distributed 多卡训练,通过 DistributedDataParallel 包装模型,支持单机多卡和多机多卡场景。搜索过程中各 GPU 进程需要显式同步(dist.barrier()),体现了严谨的工程实现。
训练数据集:项目使用 NYU v2 深度数据集,该数据集包含 1449 张带有多任务标注(语义分割、法向量、深度估计)的室内场景图片。数据集需要从外部链接下载(约数 GB),并需预先处理为特定格式。
MTL-NAS 的定位是学术研究复现,而非开箱即用的产品级工具,这一点从代码的组织方式可以清晰看出:
优势方面:作者提供了完整的 requirements.txt,依赖明确;README 包含数据集准备指南和训练命令示例,有基本的可复现性;代码结构清晰,模块化良好,有 tensorboard 可视化。
挑战方面:
无容器化支持:没有任何 Dockerfile 或 docker-compose.yml,无法通过容器一键部署,所有依赖都需要手动安装。对于不熟悉 PyTorch 环境配置的研究者而言,光是解决 CUDA 版本和 PyTorch 1.4.0 的兼容性问题就可能耗费数小时。
PyTorch 1.4.0 偏旧:该版本发布于 2020 年初,与最新的 PyTorch 2.x API 有较大差异,在新显卡上可能遇到兼容性问题。
数据集依赖外部源:NYU v2 数据集需要从 Google Drive 下载(约 4.5GB),下载速度受网络环境影响较大,且预处理步骤有一定门槛。
无预训练权重(需手动下载):作者提供了转换好的 PyTorch 模型权重,但存放在 Google Drive,且需要在本地创建 weights 目录手动解压。
无 Web UI:纯命令行工具,需要通过 python tools/train_nas.py --config-file <path> 启动训练,没有图形化界面。
MTL-NAS 作为研究复现代码,不可避免地存在一些局限性。首先,搜索空间相对有限,目前仅支持 VGG 风格的基础网络和 NYU v2 这一特定数据集,扩展到其他数据集(如 CityScapes)需要自行修改代码。其次,NAS 搜索过程计算量巨大,在单卡上运行完整的架构搜索可能需要数天时间,这与现代高效 NAS 方法(如 Once-for-All、BigNAS)的理念背道而驰。再者,代码缺乏测试覆盖,没有单元测试或集成测试,修改代码后无法自动验证正确性。最后,搜索结果的可复现性依赖于随机种子和硬件环境,同一配置在不同机器上可能搜索出不同的最优架构。
从工程实践角度看,这个项目更像是一个"方法论验证器"而非"生产级框架"。作者的核心目标是证明"NAS 驱动的多任务学习确实有效",而非提供一个易用、稳定、可扩展的工具链。
MTL-NAS 的核心贡献在于揭示了一个重要洞察:多任务学习的效果瓶颈,很大程度上来自人工设计的网络结构,而非学习算法本身。通过将 NAS 引入 MTL,论文证明自动搜索的架构在多个任务上可以显著超越人工设计的参数共享方案。
这一思路对后续研究产生了深远影响。例如,2021-2022 年间出现的多项工作(如硬参数共享的 NAS 变体、自适应任务平衡的 NAS 方法)都可以追溯到 MTL-NAS 的启发。MTL-NAS 也代表了 AutoML 领域的一个重要方向:不是让算法优化权重,而是让算法同时优化结构和权重,这比单纯的超参数搜索更接近"自动机器学习"的终极目标。
从 GitHub 社区的反馈来看,项目获得了 93 个 stars,虽然数量不算庞大,但考虑到这是一个纯粹的学术复现项目(而非通用工具),这个关注度已经相当可观。项目的 topics 标签(automl、multitask-learning、neural-architecture-search、pytorch)也精准地反映了其学术定位。
MTL-NAS 是一把解开多任务学习"性能枷锁"的钥匙——它证明了当网络架构可以自动搜索时,原本相互干扰的多个任务可以找到和谐共处的最优结构。对于 AI 研究者来说,这是一个值得深入研读的 CVPR 论文复现;对于工程师而言,需要清醒认识到这是一份研究级代码,部署门槛较高,建议有深度学习环境和数据集准备经验后再尝试运行。
