
guidance-for-low-cost-semantic-search-on-aws
aws-solutions-library-samples/guidance-for-low-cost-semantic-search-on-aws加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下这个场景:一家 20 人规模的律师事务所,想用 AI 帮助律师快速检索数万份案件文档。团队调研后发现,主流向量数据库(如 Pinecone、Milvus Cloud)的月费用轻松破万人民币——这对中小企业来说,AI 还没产生价值,先被基础设施成本"杀死了"。
问题出在哪里?向量数据库本质上是专门为向量检索优化的数据库,它需要独立的服务器集群、内存优化、索引维护,这些资源成本最终都会转嫁给用户。而中小企业实际需要的 RAG 场景,往往只是几千到几万条文档的小规模数据。
亚马逊云科技(AWS)官方解决方案团队(AWS Solutions Library)推出的 Guidance for Low Cost Semantic Search on AWS(以下简称 Low Cost RAG)正是为解决这个问题而来:把向量数据库换成 DynamoDB,把成本从每月数百美元压到不足 30 美元。
传统向量数据库的核心价值在于向量索引——一种专门加速高维向量相似度搜索的数据结构(如 HNSW、IVF)。但这个索引本身并不"魔法",它的本质是:在大量向量中,快速找到与查询向量最接近的 Top-K 个结果。
DynamoDB 怎么做到这一点?方案采用了分桶策略 + 精确检索的组合:
这样做有一个关键前提:数据规模必须"小"。官方明确标注了 100~400 份 PDF 文档的测试场景,盲猜在 1 万条 chunks 以内 DynamoDB 方案有成本优势;一旦数据量达到数十万条,向量数据库的 HNSW 索引优势会显现。所以这个方案的核心定位是:小规模 RAG 的极致性价比之选。
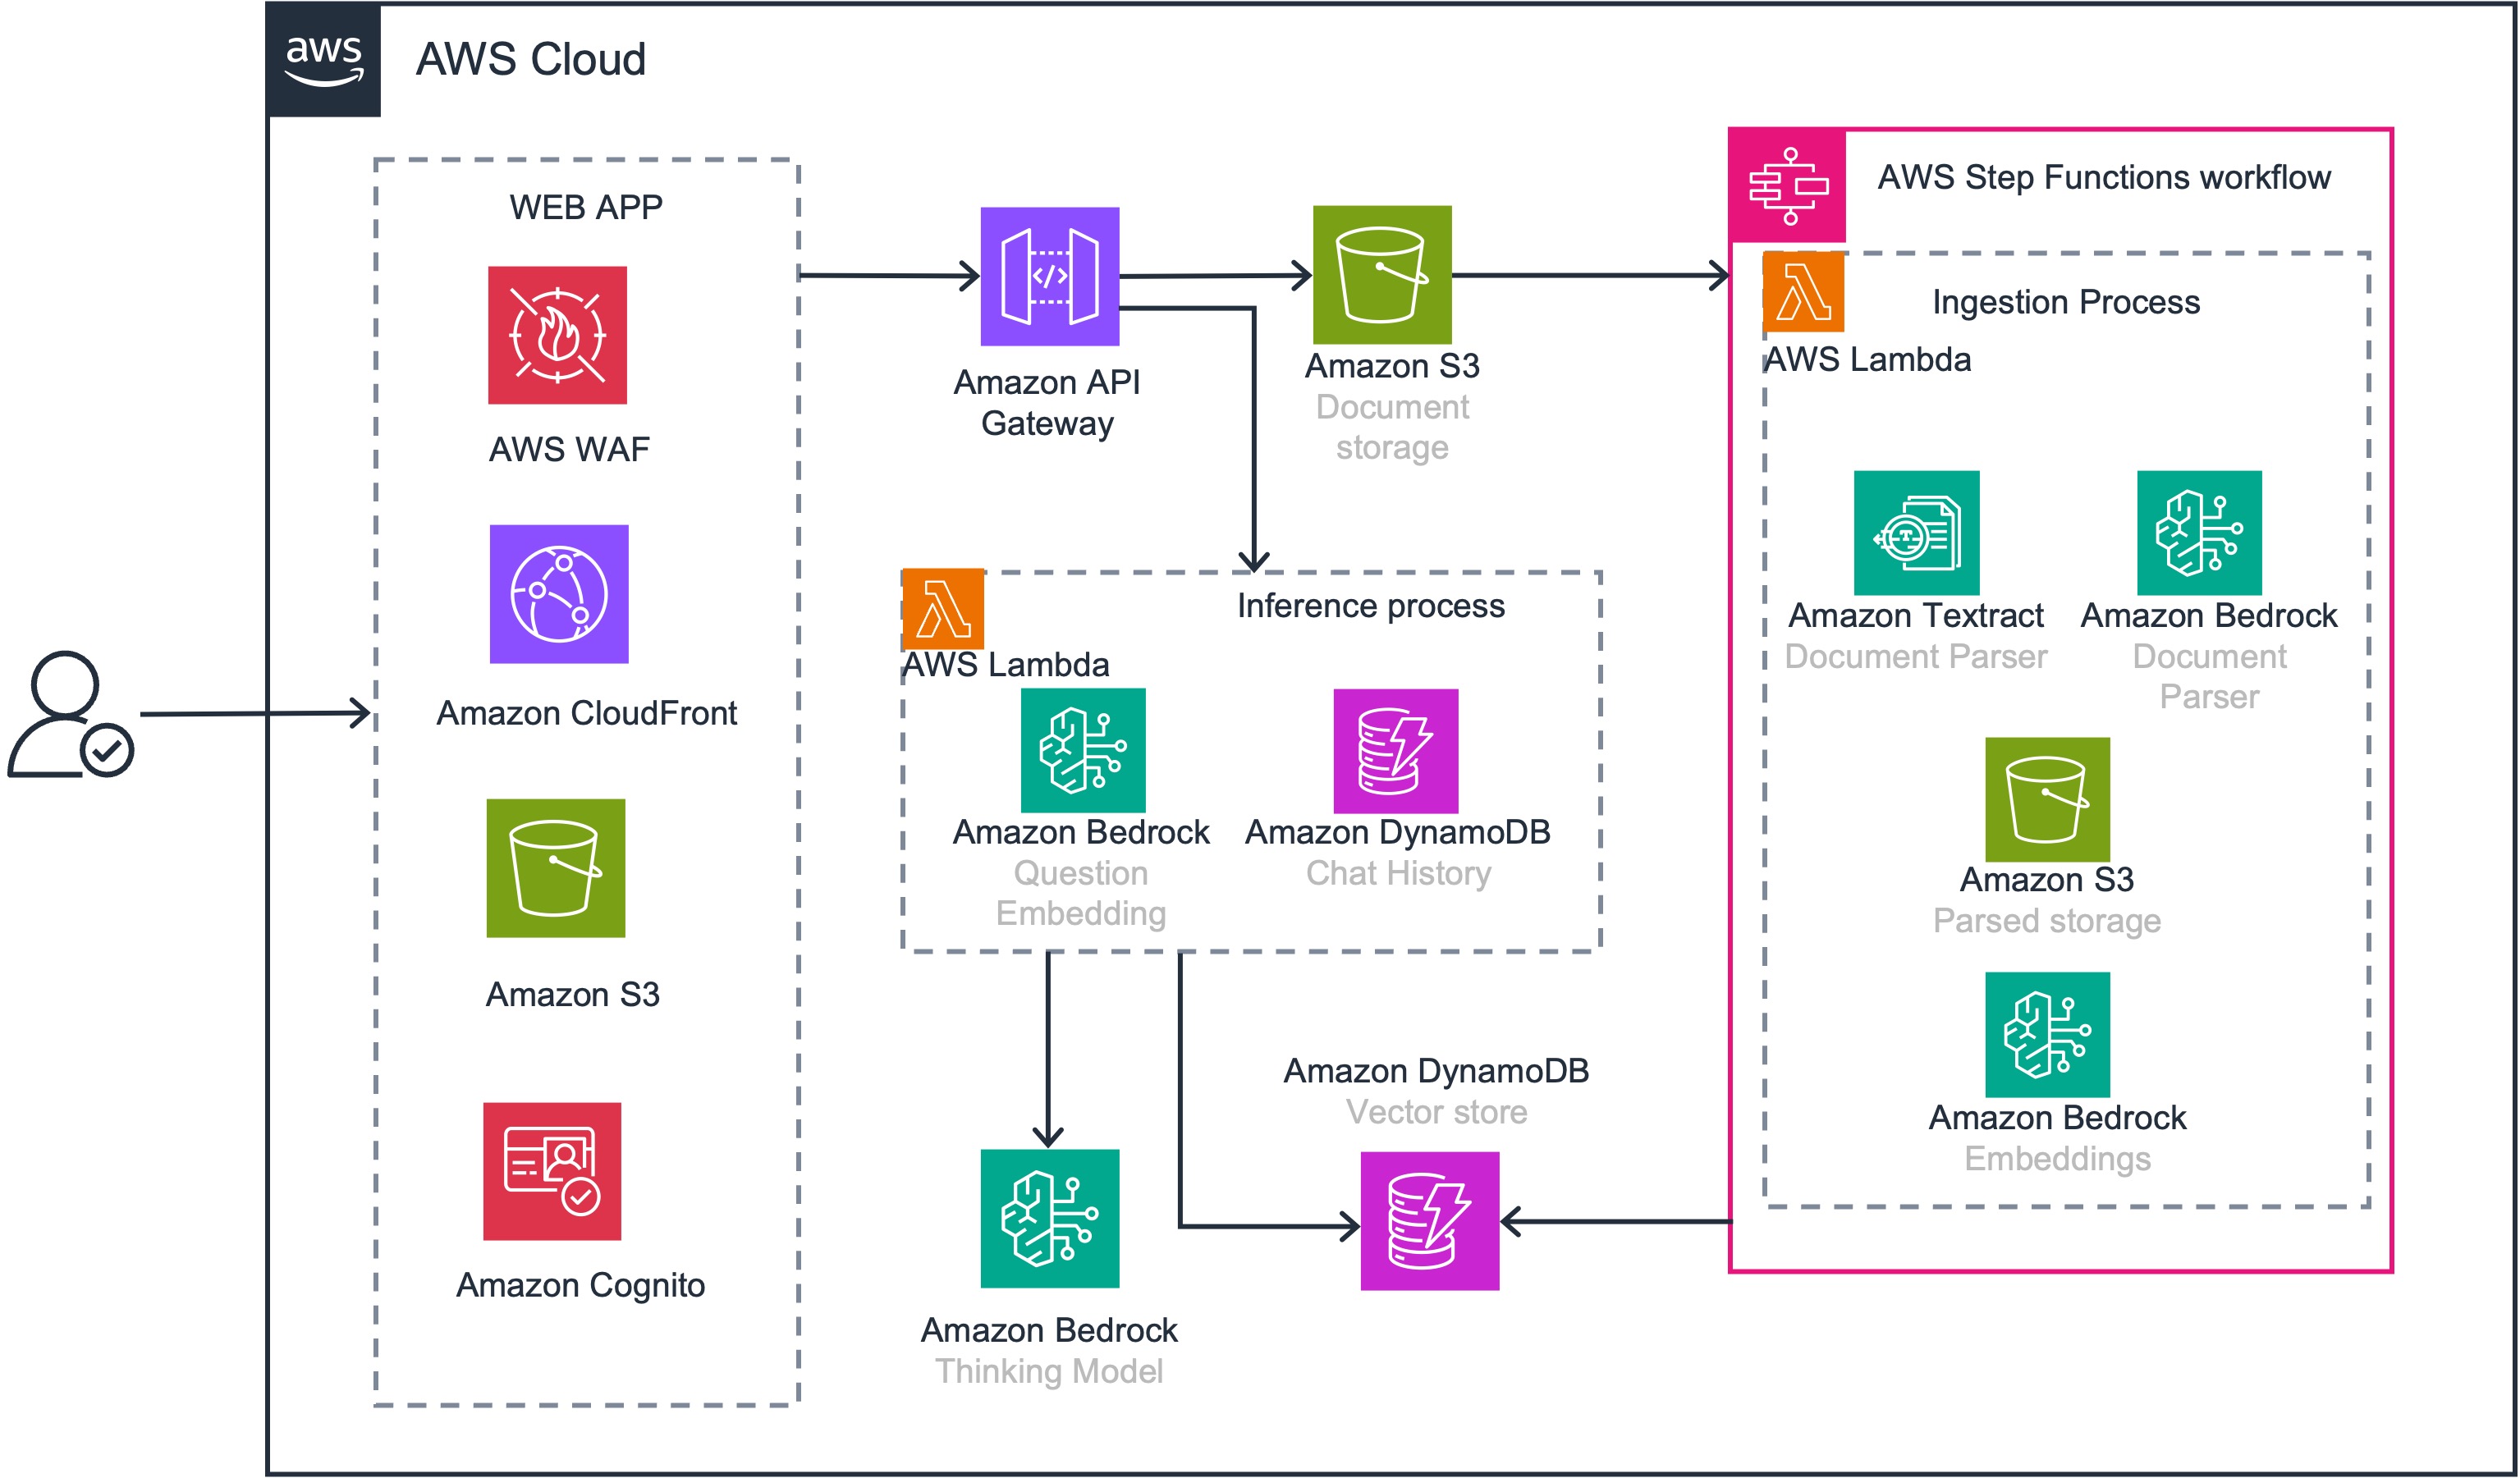
图注:Low Cost RAG 完整系统架构,涵盖文档处理流水线、RAG 推理链、前端交互层
当用户上传一份 PDF 文档后,系统经历了以下处理阶段:
整个流水线由 AWS Step Functions 编排,支持重试、错误处理和状态追踪。
用户在前端 Web UI 输入自然语言查询后:
项目提供了一个基于 HTML/JS 的单页应用(S3 + CloudFront 托管),支持:
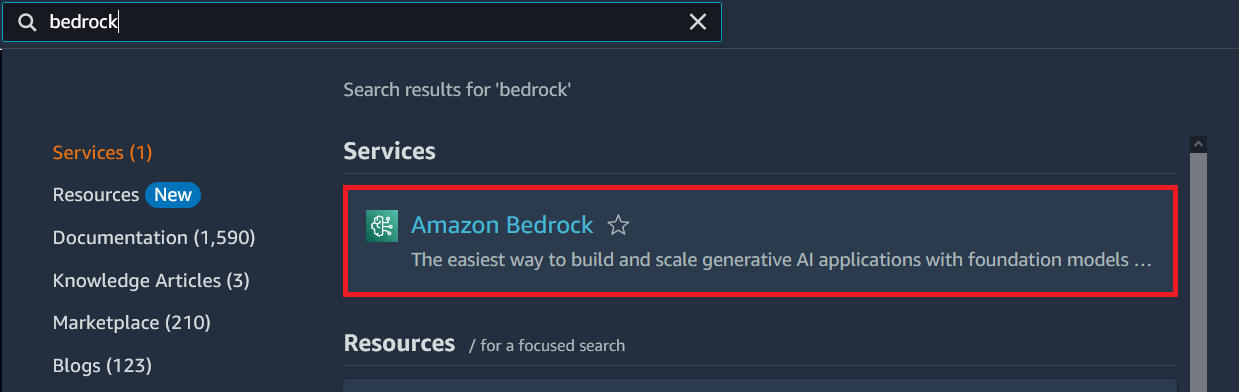
图注:Amazon Bedrock 模型访问配置界面
图注:Claude 3 Sonnet 模型权限启用
| 维度 | Pinecone/Milvus | DynamoDB 方案 |
|---|---|---|
| 月费用(1万条数据) | ~$100+ | |
| 部署复杂度 | 托管版简单,自托管需运维 | 完全托管,零运维 |
| 查询延迟(小数据) | <50ms(HNSW) | 50~200ms(精确匹配) |
| 数据规模上限 | 百万~亿级 | 建议万级 |
| 额外成本 | 向量存储+计算资源 | 仅 DynamoDB RCU/WCU |
| 配套功能 | 向量检索为主 | DynamoDB 全特性(事务、GSI、流) |
DynamoDB 的优势在于它是AWS 原生服务:无需额外部署,与 Lambda、Step Functions、API Gateway 等服务天然集成,计费模型透明(按读写容量单元计费)。
项目的部署完全基于 AWS CDK(Cloud Development Kit),这是一个用 TypeScript/Python 等编程语言定义云基础设施的工具。相比于手写 CloudFormation YAML,CDK 的优势是代码可复用、逻辑可编程。
从 chatbot_stack.py 可以看出,整个系统的 CDK 定义了约 20+ 个云资源:
CDK 栈通过 cdk deploy 一键部署,但前提是本地机器配置好 AWS CLI 凭证和 CDK 环境——这一步对非 AWS 深度用户来说并不简单。
官方提供的 4 个测试场景月费(美国东区默认配置):
| 场景 | 文档量 | 查询频率 | 月费(美元) |
|---|---|---|---|
| 场景 1 | 100 PDF | 6次/小时 | $23.78 |
| 场景 2 | 200 PDF | 6次/小时 | $29.26 |
| 场景 3 | 300 PDF | 6次/小时 | $40.70 |
| 场景 4 | 400 PDF | 10次/小时 | $67.95 |
主要费用来源:
对比 Pinecone 的 $70+/月(入门级),节省幅度相当可观。
适用场景:
不适用场景:
Low Cost RAG 的出现体现了云原生时代一个重要趋势:基础设施解耦。过去做 RAG,似乎"必须"用专用向量数据库。但 AWS 团队用 DynamoDB + 分桶策略证明了,只要满足业务需求的精度,通用的云服务完全可以替代专用数据库,成本可以降低一个数量级。
这一思路与"用 S3 做向量存储"、"用 PostgreSQL pgvector 插件做向量检索"一脉相承,本质上都是在说:向量检索不是只有一种实现方式,在特定数据规模下,简化的方案往往更实用。
随着 Claude、Gemini 等 LLM 的上下文窗口不断扩展(Gemini 1.5 Pro 已支持 100 万 token),有人认为向量检索的必要性在下降——直接把所有文档扔进上下文不就行了?但对于需要实时更新、快速检索、结构化元数据过滤的场景,向量数据库(或 DynamoDB 替代方案)仍然不可替代。
