
sample-genai-on-eks-starter-kit
aws-samples/sample-genai-on-eks-starter-kit加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你是一家 AI 创业公司的技术负责人,团队需要快速部署一套生产级的生成式 AI 基础设施——LLM 推理服务、向量数据库、AI 网关、可观测性平台,一个都不能少。团队有 GPU 服务器,跑的是 AWS EKS(Elastic Kubernetes Service),但从零搭这套系统需要多少天?答案是:用这个 Starter Kit,只需要一条命令。
这就是 aws-samples/sample-genai-on-eks-starter-kit 的核心价值——一个来自 AWS 官方示例仓库的生产级生成式 AI 基础设施工具包,让企业和开发团队能够以 Kubernetes 为底座,快速搭建、自托管运行 LLM 推理和 AI Agent 工作负载,而无需从零造轮子。
2024 年开始,大模型(LLM)平权运动席卷 AI 领域。Qwen3、DeepSeek-R1、Llama-4 等开源模型的性能直逼 GPT-4 和 Claude,但调用成本是 GPT-4 的几十分之一。这让越来越多的企业选择自托管——在自己的 GPU 集群上部署开源大模型,既省钱又保证数据隐私。
然而,自托管说起来容易,做起来难。部署一个大模型到 Kubernetes 集群中,需要解决:GPU 调度、模型加载、推理引擎选型(vLLM 还是 SGLang)、AI 网关(统一路由多家模型)、向量数据库、多模型可观测性、MCP Server(Model Context Protocol)……每一个组件都有独立的部署文档,各自的 Helm Chart 和 YAML 配置文件交织在一起,版本兼容问题层出不穷。
sample-genai-on-eks-starter-kit 正是为了解决这个问题而生的。它是 AWS 官方团队在 2025 年 7 月发布的一个开源项目(MIT-0 许可证),目标是成为在 AWS EKS 上部署生成式 AI 基础设施的"一站式"解决方案。
这个 Starter Kit 的架构非常清晰,核心是 Node.js 编写的 CLI 工具,配合 Terraform IaC 代码,通过 Helm 在 Kubernetes 上编排所有组件。
支持的 LLM 推理引擎:
支持的向量数据库:
Qdrant(生产级向量数据库)、Chroma(轻量级)和 Milvus(大规模场景)。
AI 网关:
内置 LiteLLM 代理,支持 OpenAI 兼容接口,一个端点调用所有模型(vLLM、SGLang、Bedrock、Claude 等),同时内置 Token 计数、限流、LLM 成本追踪。
可观测性:
集成 Langfuse(LLM 可观测性平台)和 Arize Phoenix(ML 追踪),覆盖请求追踪、Token 消耗、延迟监控。
AI Agent 支持:
支持 OpenClaw(多 Agent 协作框架)、Strands Agents、Agno,以及 FastMCP 2.0 服务器,提供计算器、MCP 计算等示例。
项目的使用体验设计得相当顺滑,核心流程只需要三步:
第一步,安装依赖并配置。需要提前准备 AWS CLI、Terraform、Node.js、kubectl、Helm 和 Docker 环境。克隆仓库后,运行 npm install 安装 Node.js 依赖,然后执行 ./cli configure,交互式填写 AWS 区域、EKS 集群名和 HuggingFace Token。
第二步,选择部署模式。如果是快速验证场景,执行 ./cli demo-setup,系统会自动调用 Terraform 创建一个完整的 EKS 集群(包含 EFS 存储、ACM 证书、ALB 入口等),然后通过 Helm 安装 demo 配置中的所有组件(vLLM + Qwen3-30B、LiteLLM 网关、Qdrant 向量库、Langfuse 可观测性和 Open WebUI)。整个过程大约需要 20-30 分钟,全部自动化。
如果需要自定义组件组合,运行 ./cli interactive-setup,CLI 会列出所有可用组件分类(AI 网关、LLM 模型、向量数据库、可观测性、AI Agent、MCP 服务器、工作流自动化等),用户按需勾选。
第三步,配置并部署模型。通过 ./cli llm-model vllm configure-models 选择要部署的模型,config.json 中预置了 Qwen3-30B-Instruct-FP8、Qwen3-32B、DeepSeek-R1-Qwen3-8B 等多个模型的部署配置,默认部署 FP8 量化的 Qwen3 系列,性价比最优。
对于 NVIDIA GPU 用户,项目还支持 Dynamo 平台,通过 ./cli nvidia-platform ... 系列命令安装 Prometheus + Grafana 监控、NVIDIA GPU Operator、Dynamo CRDs 和 Operator、vLLM 模型服务,以及可选的 AIPerf 基准测试和 AIConfigurator 自动 TP/PP 推荐。
这个项目有几个值得关注的技术设计。
CLI-first 的用户体验。 所有操作都通过 ./cli 完成,Terraform apply、Helm install/upgrade、Kubernetes 资源管理全部封装在 CLI 背后,用户不需要懂 Kubernetes 也能完成复杂部署。CLI 使用 Commander.js 构建,交互式菜单使用 Inquirer.js,体验接近现代化 DevOps 工具。
Terraform IaC 的基础设施即代码。 基础设施层完全通过 Terraform 管理(VPC、EKS Auto Mode、EFS、ACM 证书、ALB 入口、ExternalDNS、Ingress-Nginx),版本可控,可重复。EKS 模式支持 Auto Mode(零运维)和 Standard Mode 两种。
多推理引擎并行支持。 同一个集群可以同时运行 vLLM、SGLang 和 Ollama,通过 LiteLLM AI 网关统一暴露 OpenAI 兼容 API,客户端无需修改代码即可切换推理引擎。
NVIDIA Dynamo 的前沿支持。 项目支持英伟达 Dynamo 分布式推理平台,这是 2025 年发布的新技术,支持聚合模式和分解模式,通过 KV 缓存路由优化推理吞吐量。配合 NVIDIA GPU Operator 和 Prometheus/Grafana 监控,形成完整的 GPU 推理监控体系。
这个 Starter Kit 的局限性也很明显。首先,部署复杂度仍然较高——需要深入理解 AWS EKS、Terraform、GPU 实例采购(g6e/g6/g5g 系列)、Kubernetes 调度等,不适合 Kubernetes 新手。其次,成本不容忽视——即使使用 Spot 实例,一个配置了 4x NVIDIA A10G 的 EKS 节点组月费用也在数千美元量级。
此外,项目高度依赖 AWS 生态,迁移到 GKE 或自建 Kubernetes 集群需要较大改造。NVIDIA Dynamo 平台的支持虽然前沿,但文档仍在完善中,生产环境使用需要谨慎评估。
这个项目代表了 2025 年企业级 GenAI 基础设施的一个重要趋势:从"大厂专属"走向"普惠化"。通过将复杂的 LLM 推理、向量检索、AI Agent、可观测性等组件打包成可复用的 Helm Chart 和 Terraform 模块,AWS 降低了企业在自有 GPU 集群上部署生产级 GenAI 系统的门槛。
从增长曲线看,项目自 2025 年 7 月发布以来不到一年已获得 93 颗星,虽然绝对数量不大,但考虑到其受众是基础设施/DevOps/MLOps 工程师,这个增长是健康的。项目中包含的 NVIDIA Dynamo 支持表明它正在快速跟进最新的 GPU 推理优化技术。
总体而言,sample-genai-on-eks-starter-kit 是一个面向有一定 Kubernetes 和 AWS 经验的团队的强工具。它不是给个人开发者快速体验 LLM 用的玩具,而是一套需要认真对待的生产级参考架构。如果你的团队计划在 AWS EKS 上自托管 LLM 服务,并且需要同时管理多个模型、向量数据库和 AI Agent,这个 Starter Kit 值得认真研究。
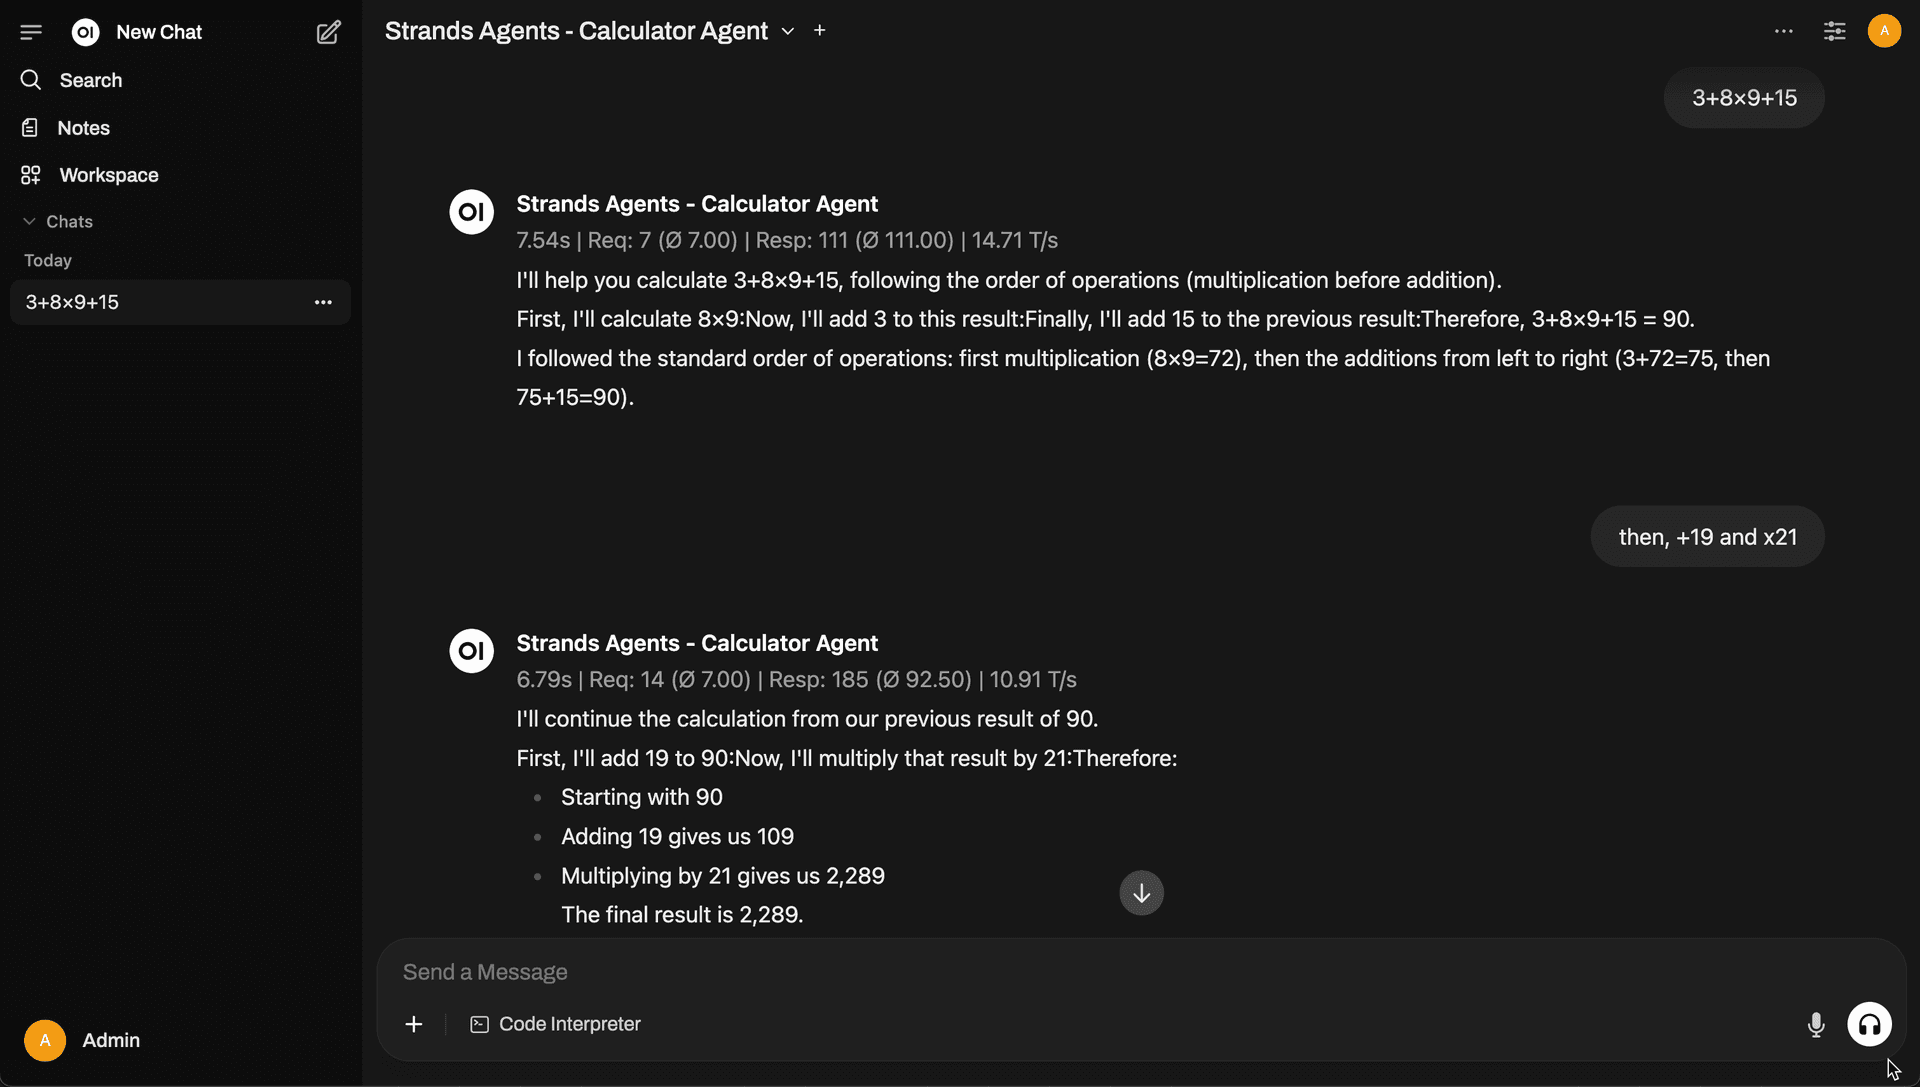
图:Open WebUI 集成 Embedding 模型和 Calculator Agent 示例
