
adk-vertex-ai-rag-engine
arjunprabhulal/adk-vertex-ai-rag-engine加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你手头有一堆 PDF 文档、Word 报告、技术手册,想要快速找到某个问题的答案——比如"去年Q3季度的收入增长了多少"。传统方式下,你需要逐一打开文件、Ctrl+F 搜索,耗时耗力。而 Google ADK + Vertex AI RAG Engine 告诉你:只需 2 分钟配置,就能拥有一个会"读"文档的 AI 助手,开口问,它来答。
2024 年 Google I/O 大会上,Google 正式发布了 Agent Development Kit(ADK),这是一个用于构建 AI Agent 的开发框架。与 OpenAI 的 GPTs 或 Anthropic 的 Claude Agent 不同,ADK 的核心优势在于与 Google Cloud 生态的深度整合——特别是 Vertex AI 平台提供的 RAG Engine。
RAG(Retrieval-Augmented Generation,检索增强生成)是当前企业级 AI 应用的主流架构。它的原理并不复杂:在用户提问时,先从知识库中检索相关内容,再将这些内容作为上下文喂给大语言模型生成答案。相比纯参数知识,RAG 能有效减少"幻觉",同时支持企业私有数据的实时更新。
arjunprabhulal/adk-vertex-ai-rag-engine 是一个基于 ADK 和 Vertex AI RAG Engine 的生产级 RAG 框架,2025 年 5 月开源,目前已有 106 stars、36 forks。虽然作者 arjunprabhulal 并非 Google 官方团队成员,但项目充分利用了 ADK 的 Agent 架构和 Vertex AI RAG 的全套 API,设计上颇具巧思。
整个项目采用三层架构设计,从底层到顶层依次是:
第一层:存储层(Google Cloud Storage)
项目使用 Google Cloud Storage(GCS)作为文档存储层。用户上传的文件首先落入 GCS 桶(Bucket),再通过 Vertex AI RAG Engine 的导入接口进入向量知识库。这一设计的优势在于:GCS 本身支持海量文件存储、版本控制、访问权限管理,无需额外自建文件服务器。
第二层:RAG 检索层(Vertex AI RAG Engine)
Vertex AI RAG Engine 负责文档的 chunking(分块)、embedding(向量化)和 indexing(索引构建)。项目默认使用 text-embedding-004 模型进行向量化,分块大小和向量距离阈值均可通过 rag/config.py 配置。RAG Engine 会将文档切分成语义单元,生成向量存入 corpus(语料库)。
第三层:Agent 交互层(ADK Agent)
ADK Agent 是整个框架的"大脑"。它由 rag/agent.py 定义,核心是一个配置了 RAG 工具的 Agent 实例。Agent 的 instruction 中预设了三大类任务:GCS 操作(上传/创建/列举 Bucket)、RAG 语料管理(创建/更新/删除 corpus)、语料检索(单 corpus 查询、跨 corpus 搜索)。当用户提问时,Agent 自动选择最合适的工具执行,并将结果格式化返回。
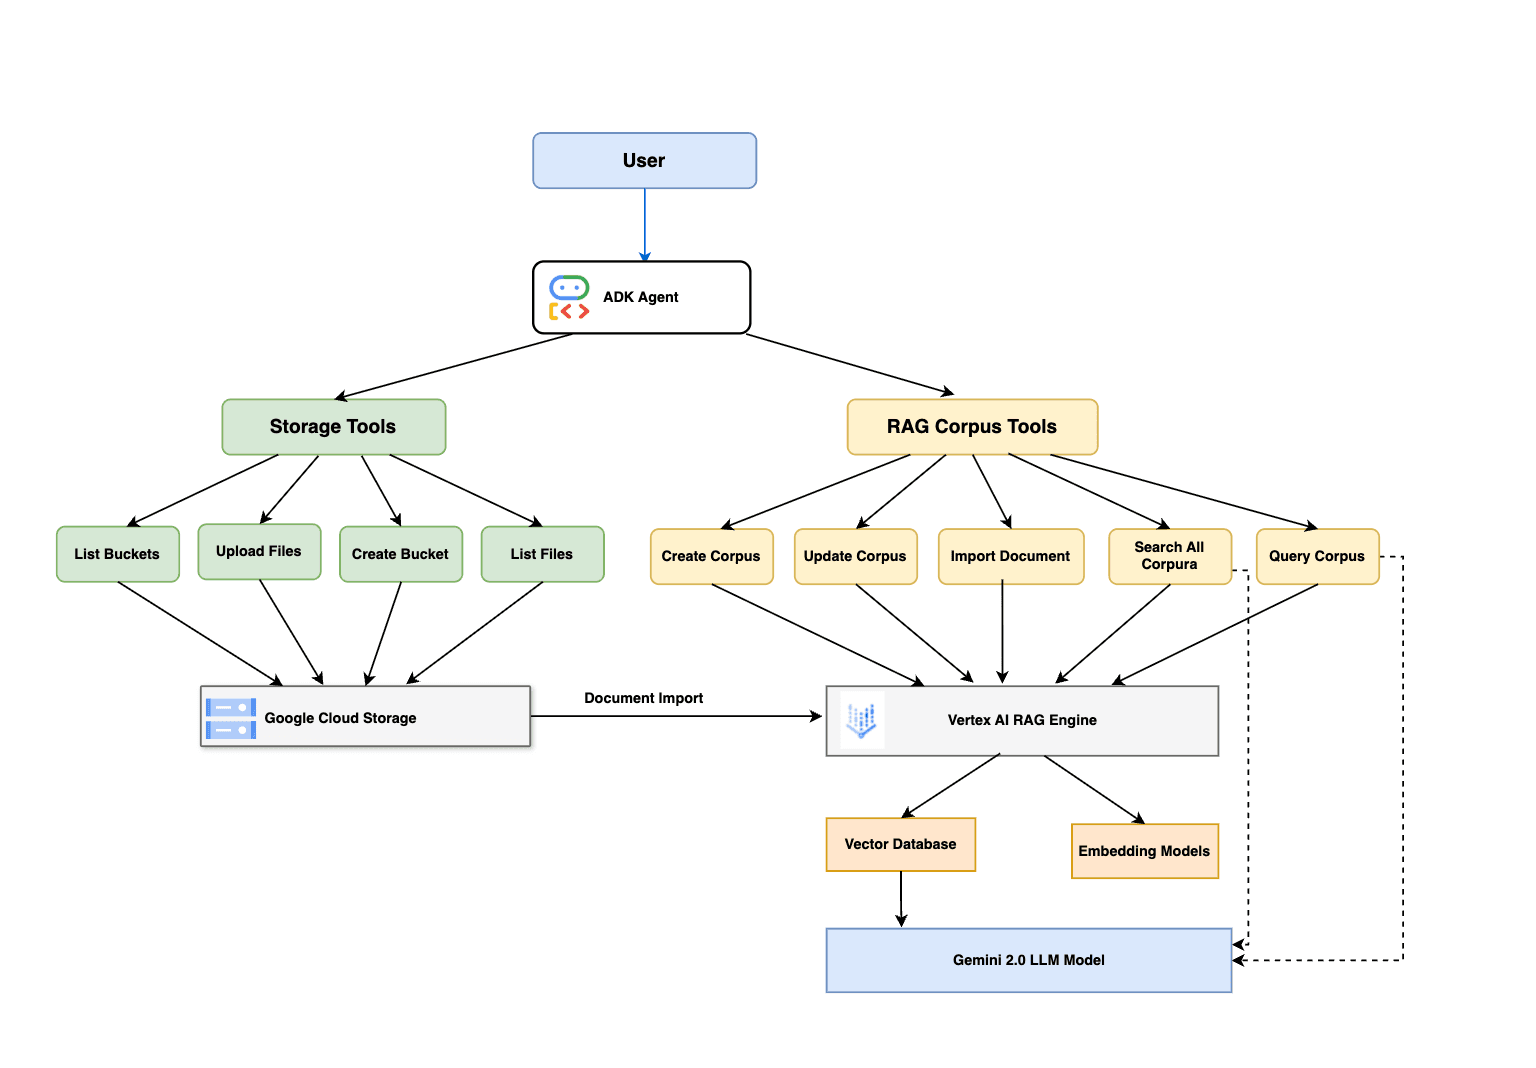
ADK + Vertex AI RAG 整体架构,展示了从文档上传到问答的全流程
多 Corpus 跨库搜索 — 这是项目最有特色的功能之一。大多数 RAG 实现只支持单语料库查询,而本项目通过 search_all_corpora 工具实现了跨多个 corpus 的并发检索。用户提出一个问题,系统会同时在所有 corpus 中搜索相关片段,并按相关性排序返回。
完整的文件生命周期管理 — 从 GCS Bucket 创建、文件上传,到 RAG corpus 创建、文档导入,再到查询和删除,整个文件生命周期都有对应的 Agent 工具支持。用户无需记忆繁琐的 gcloud CLI 命令,用自然语言即可完成操作。
CLI + Web 双界面 — 项目同时提供了 CLI 和 Web 两种交互方式。ADK 自带的 adk web 命令可以启动本地 Web 界面,图形化地管理 Agent 和对话历史。对于习惯命令行的开发者,也有完整的 CLI 工具可用。
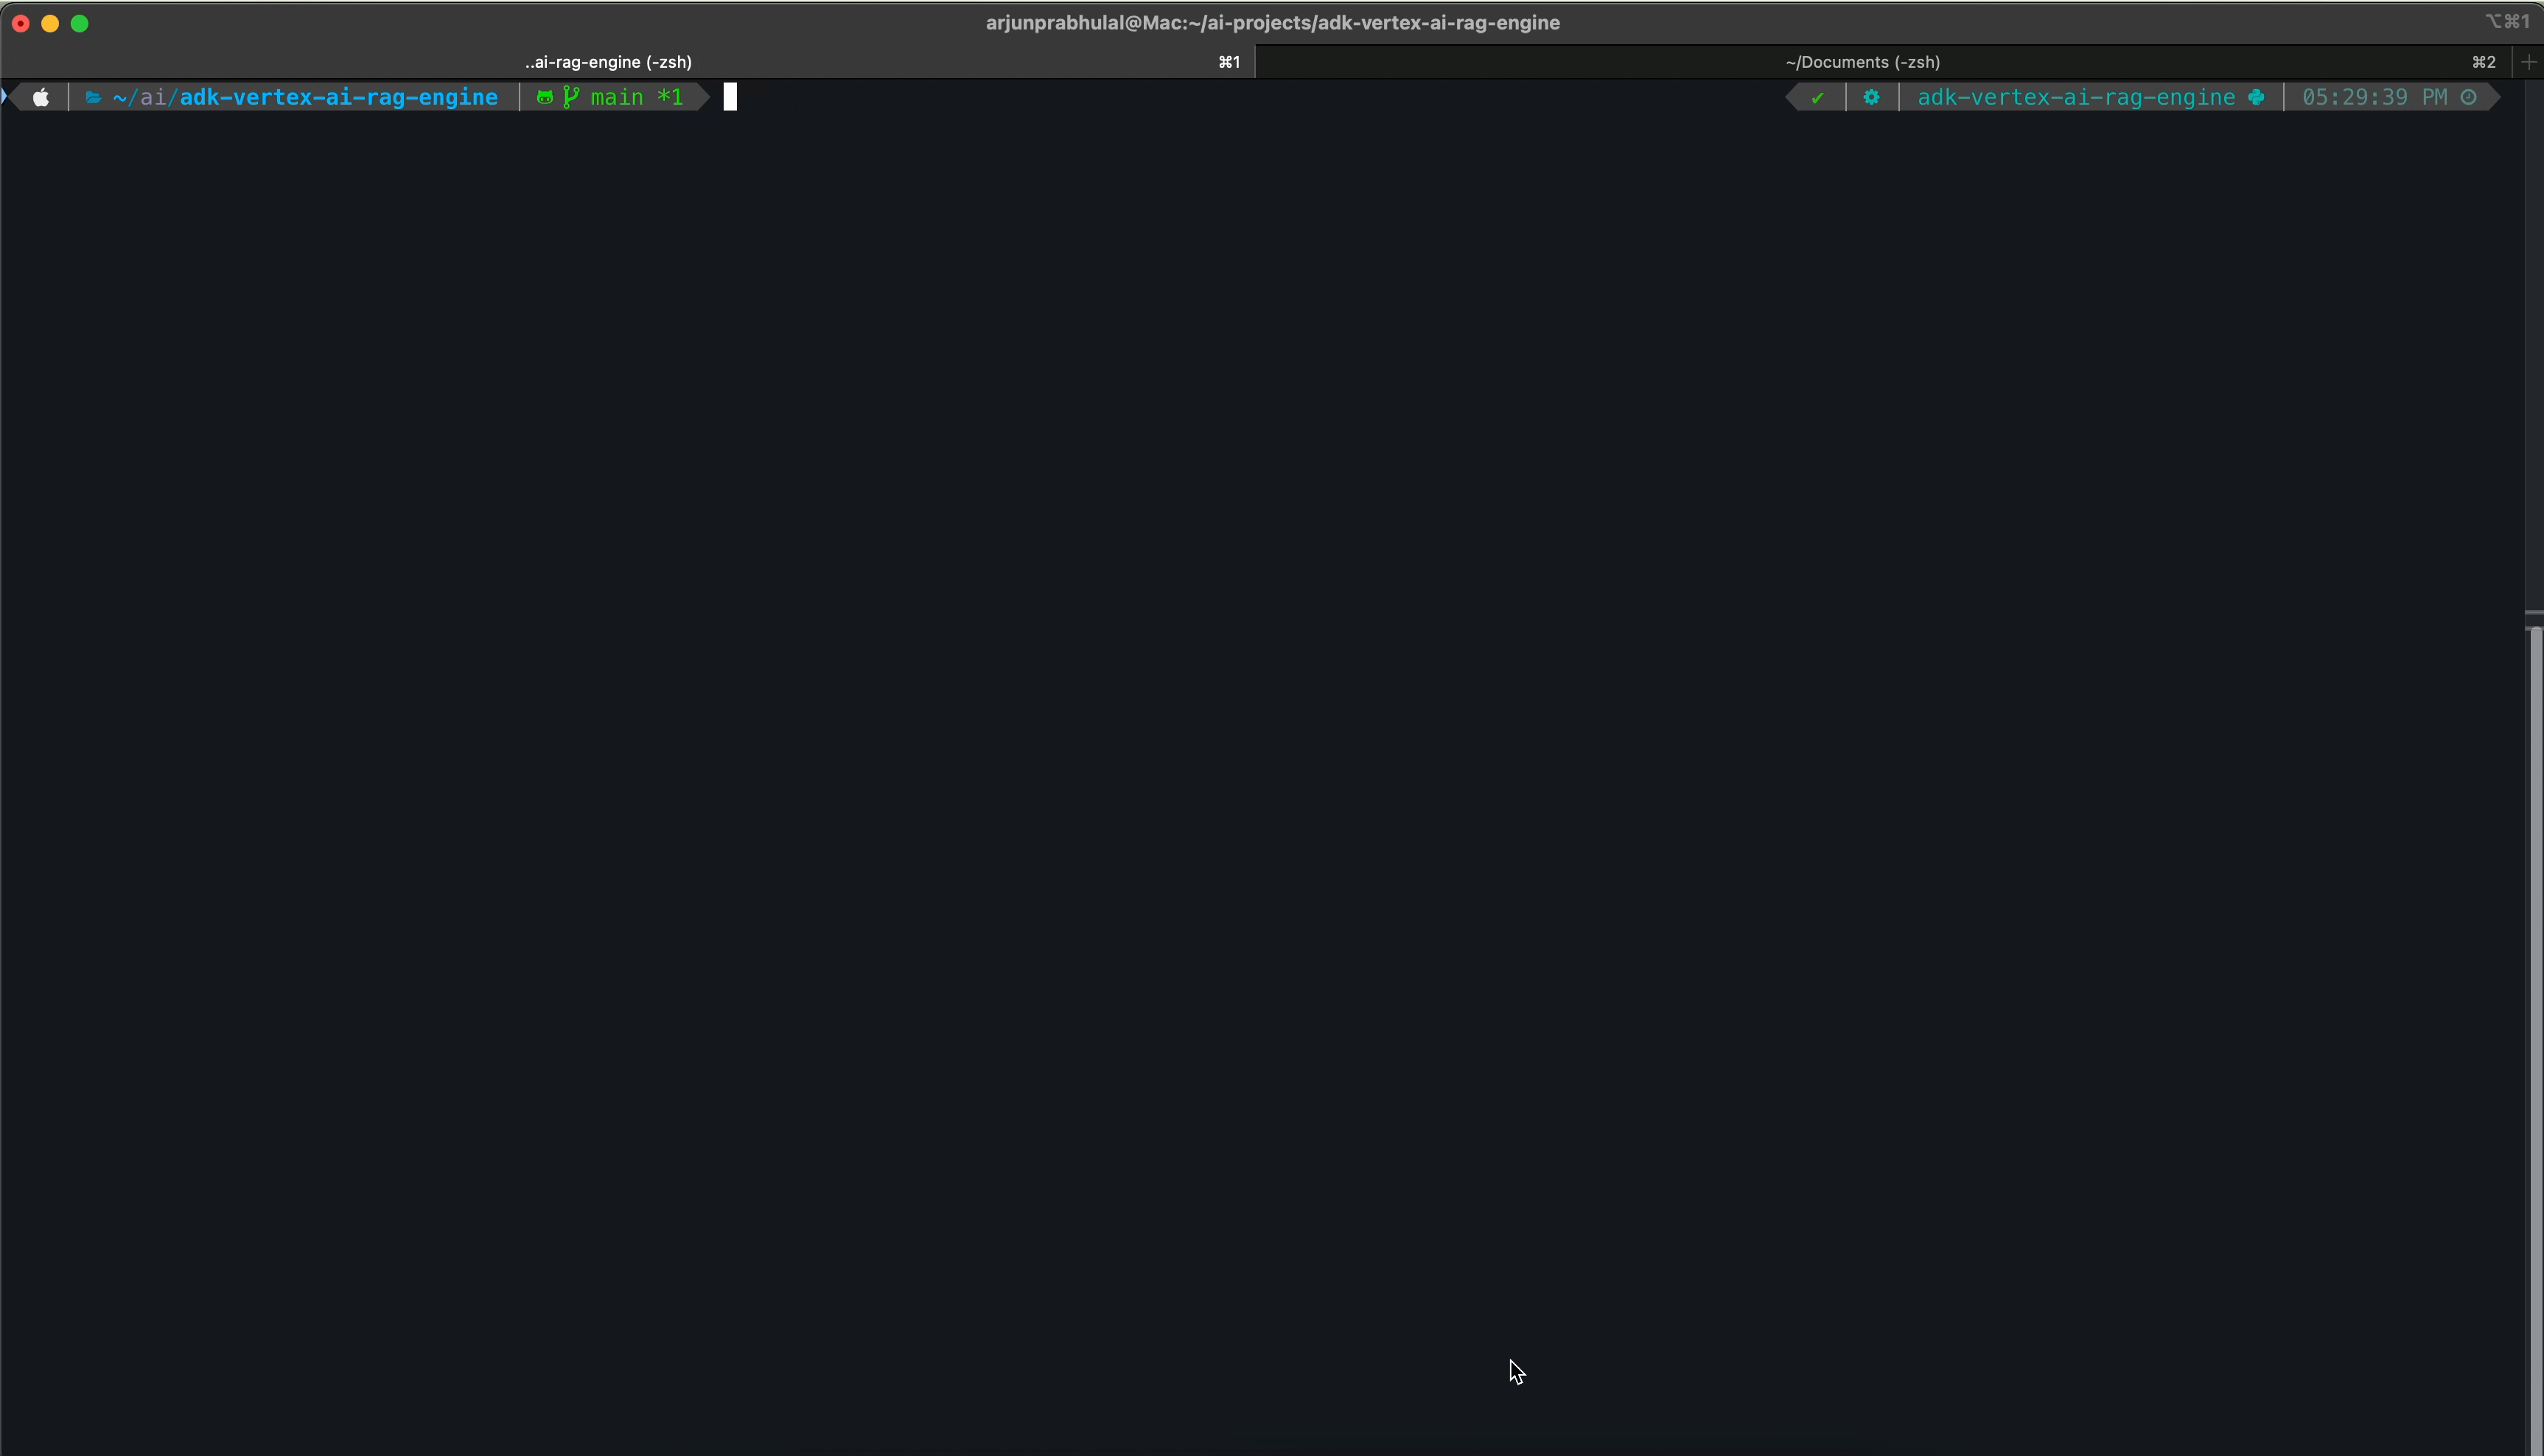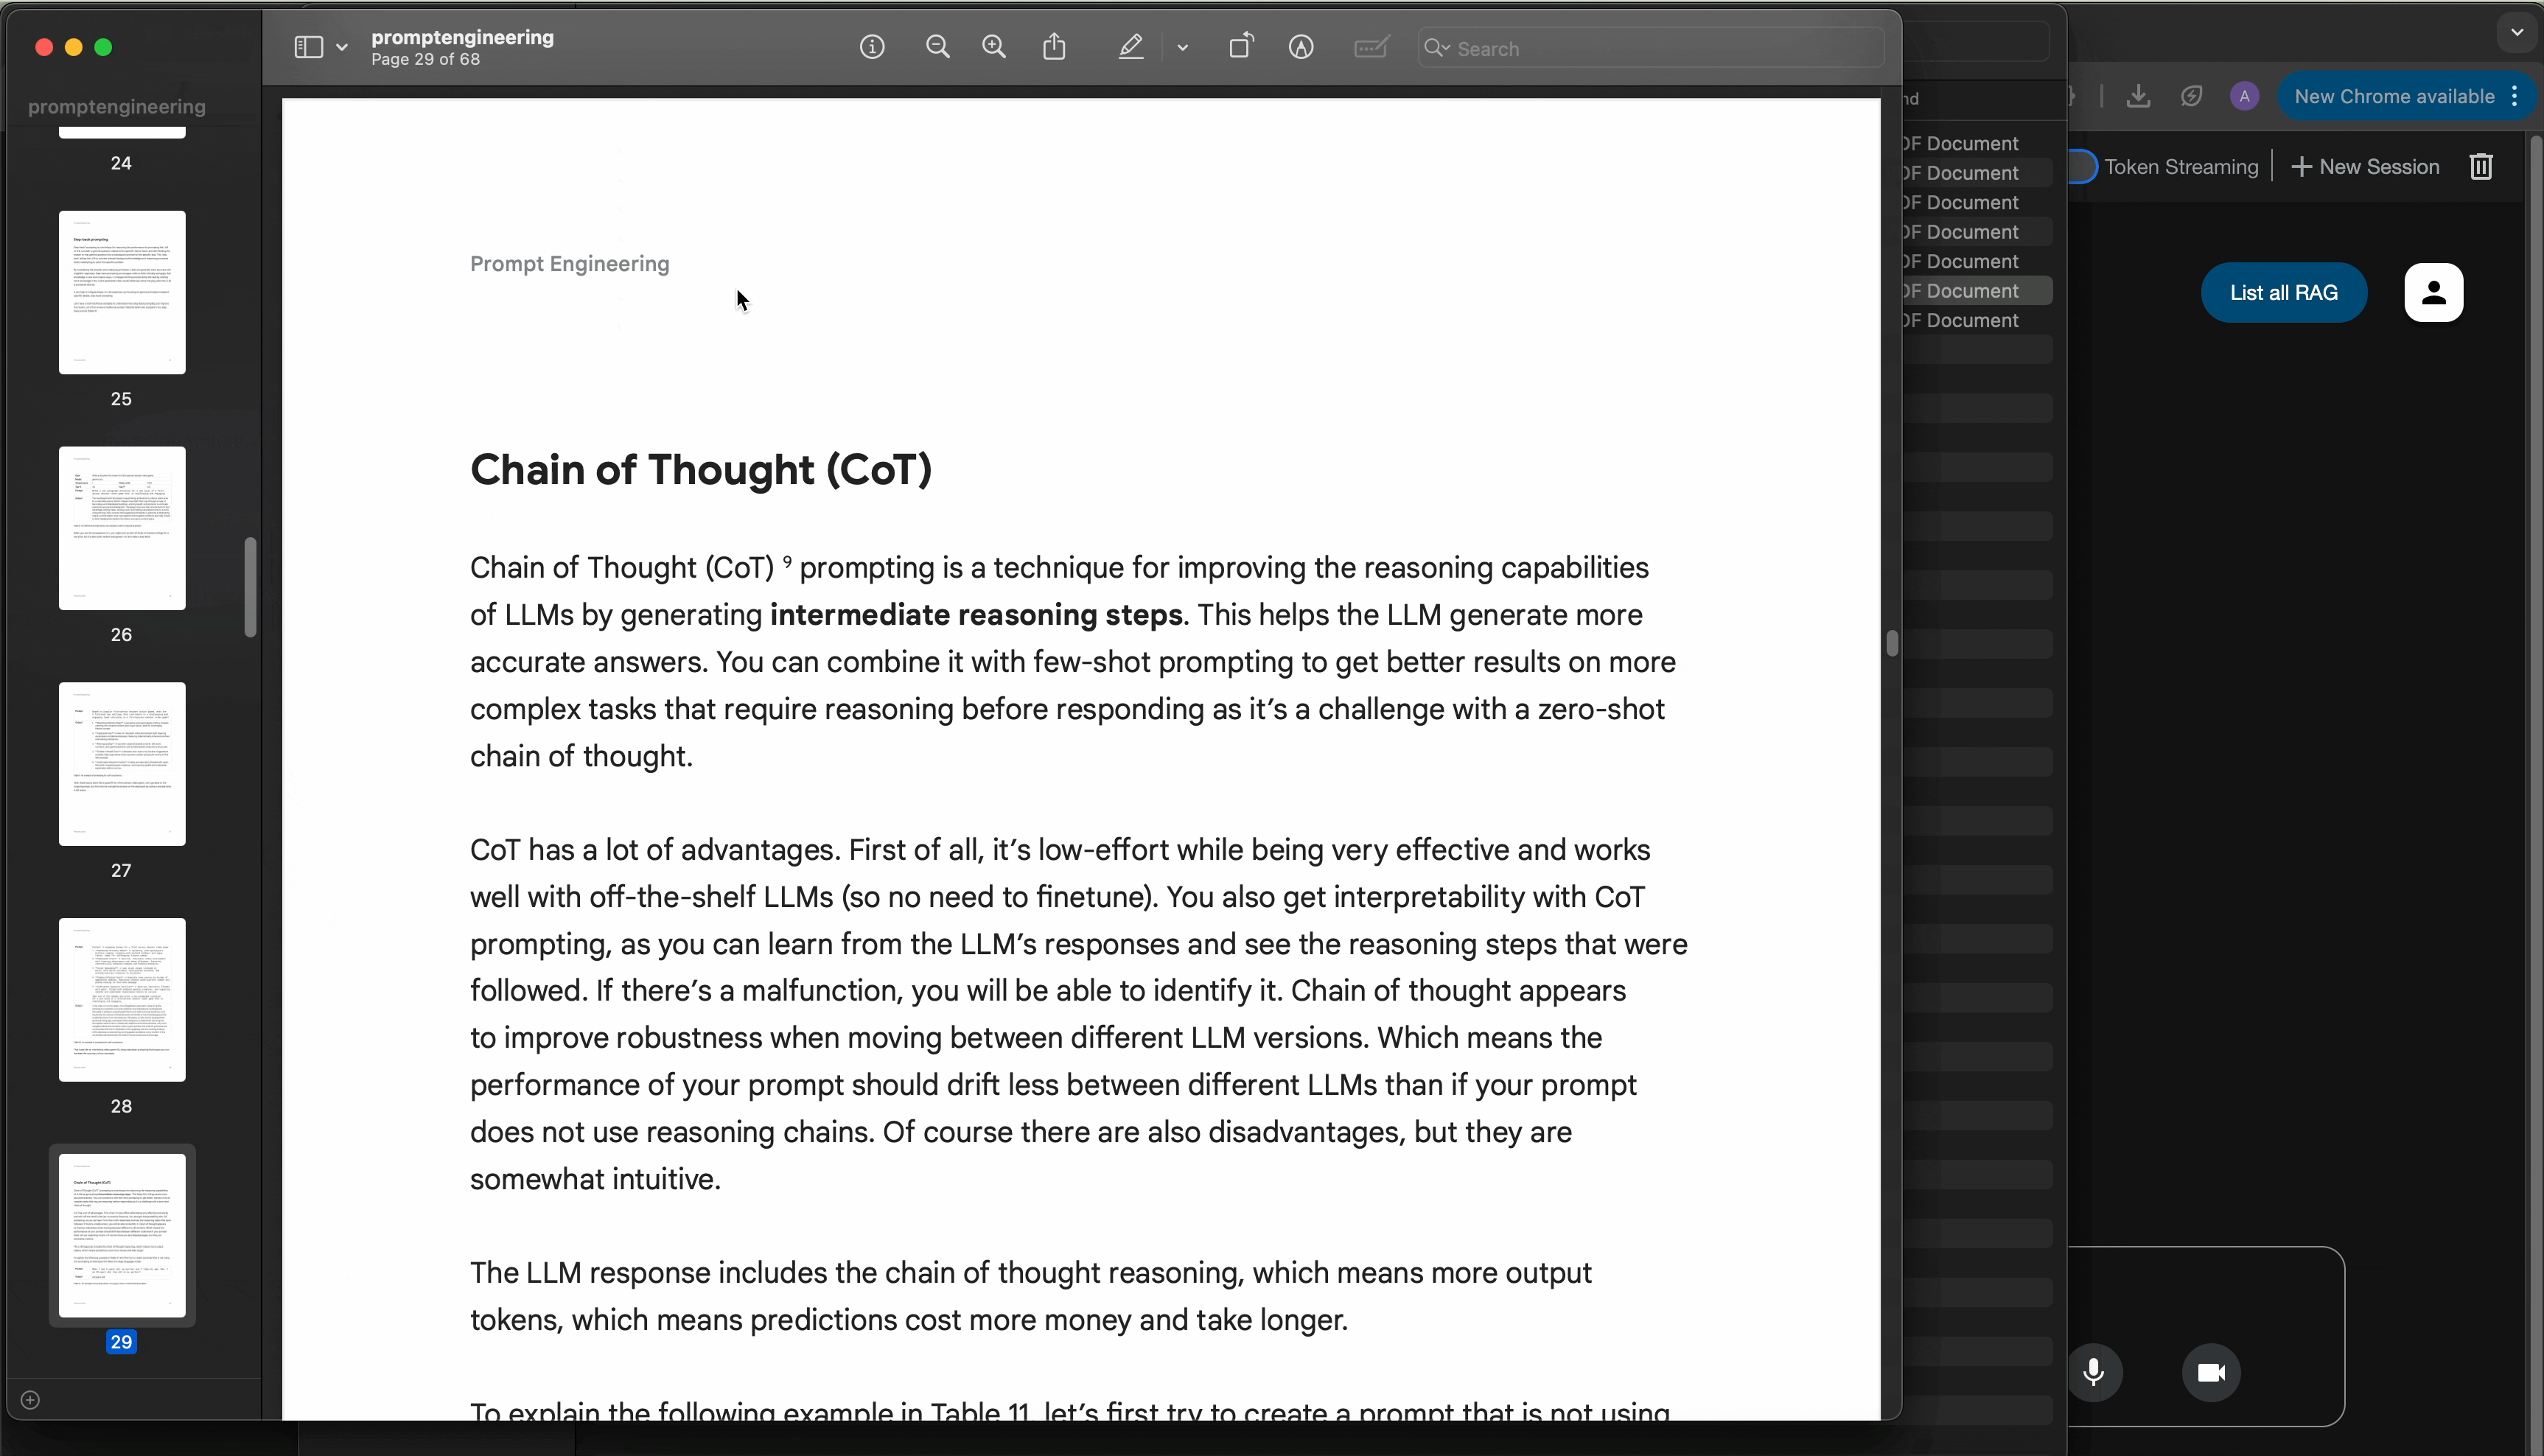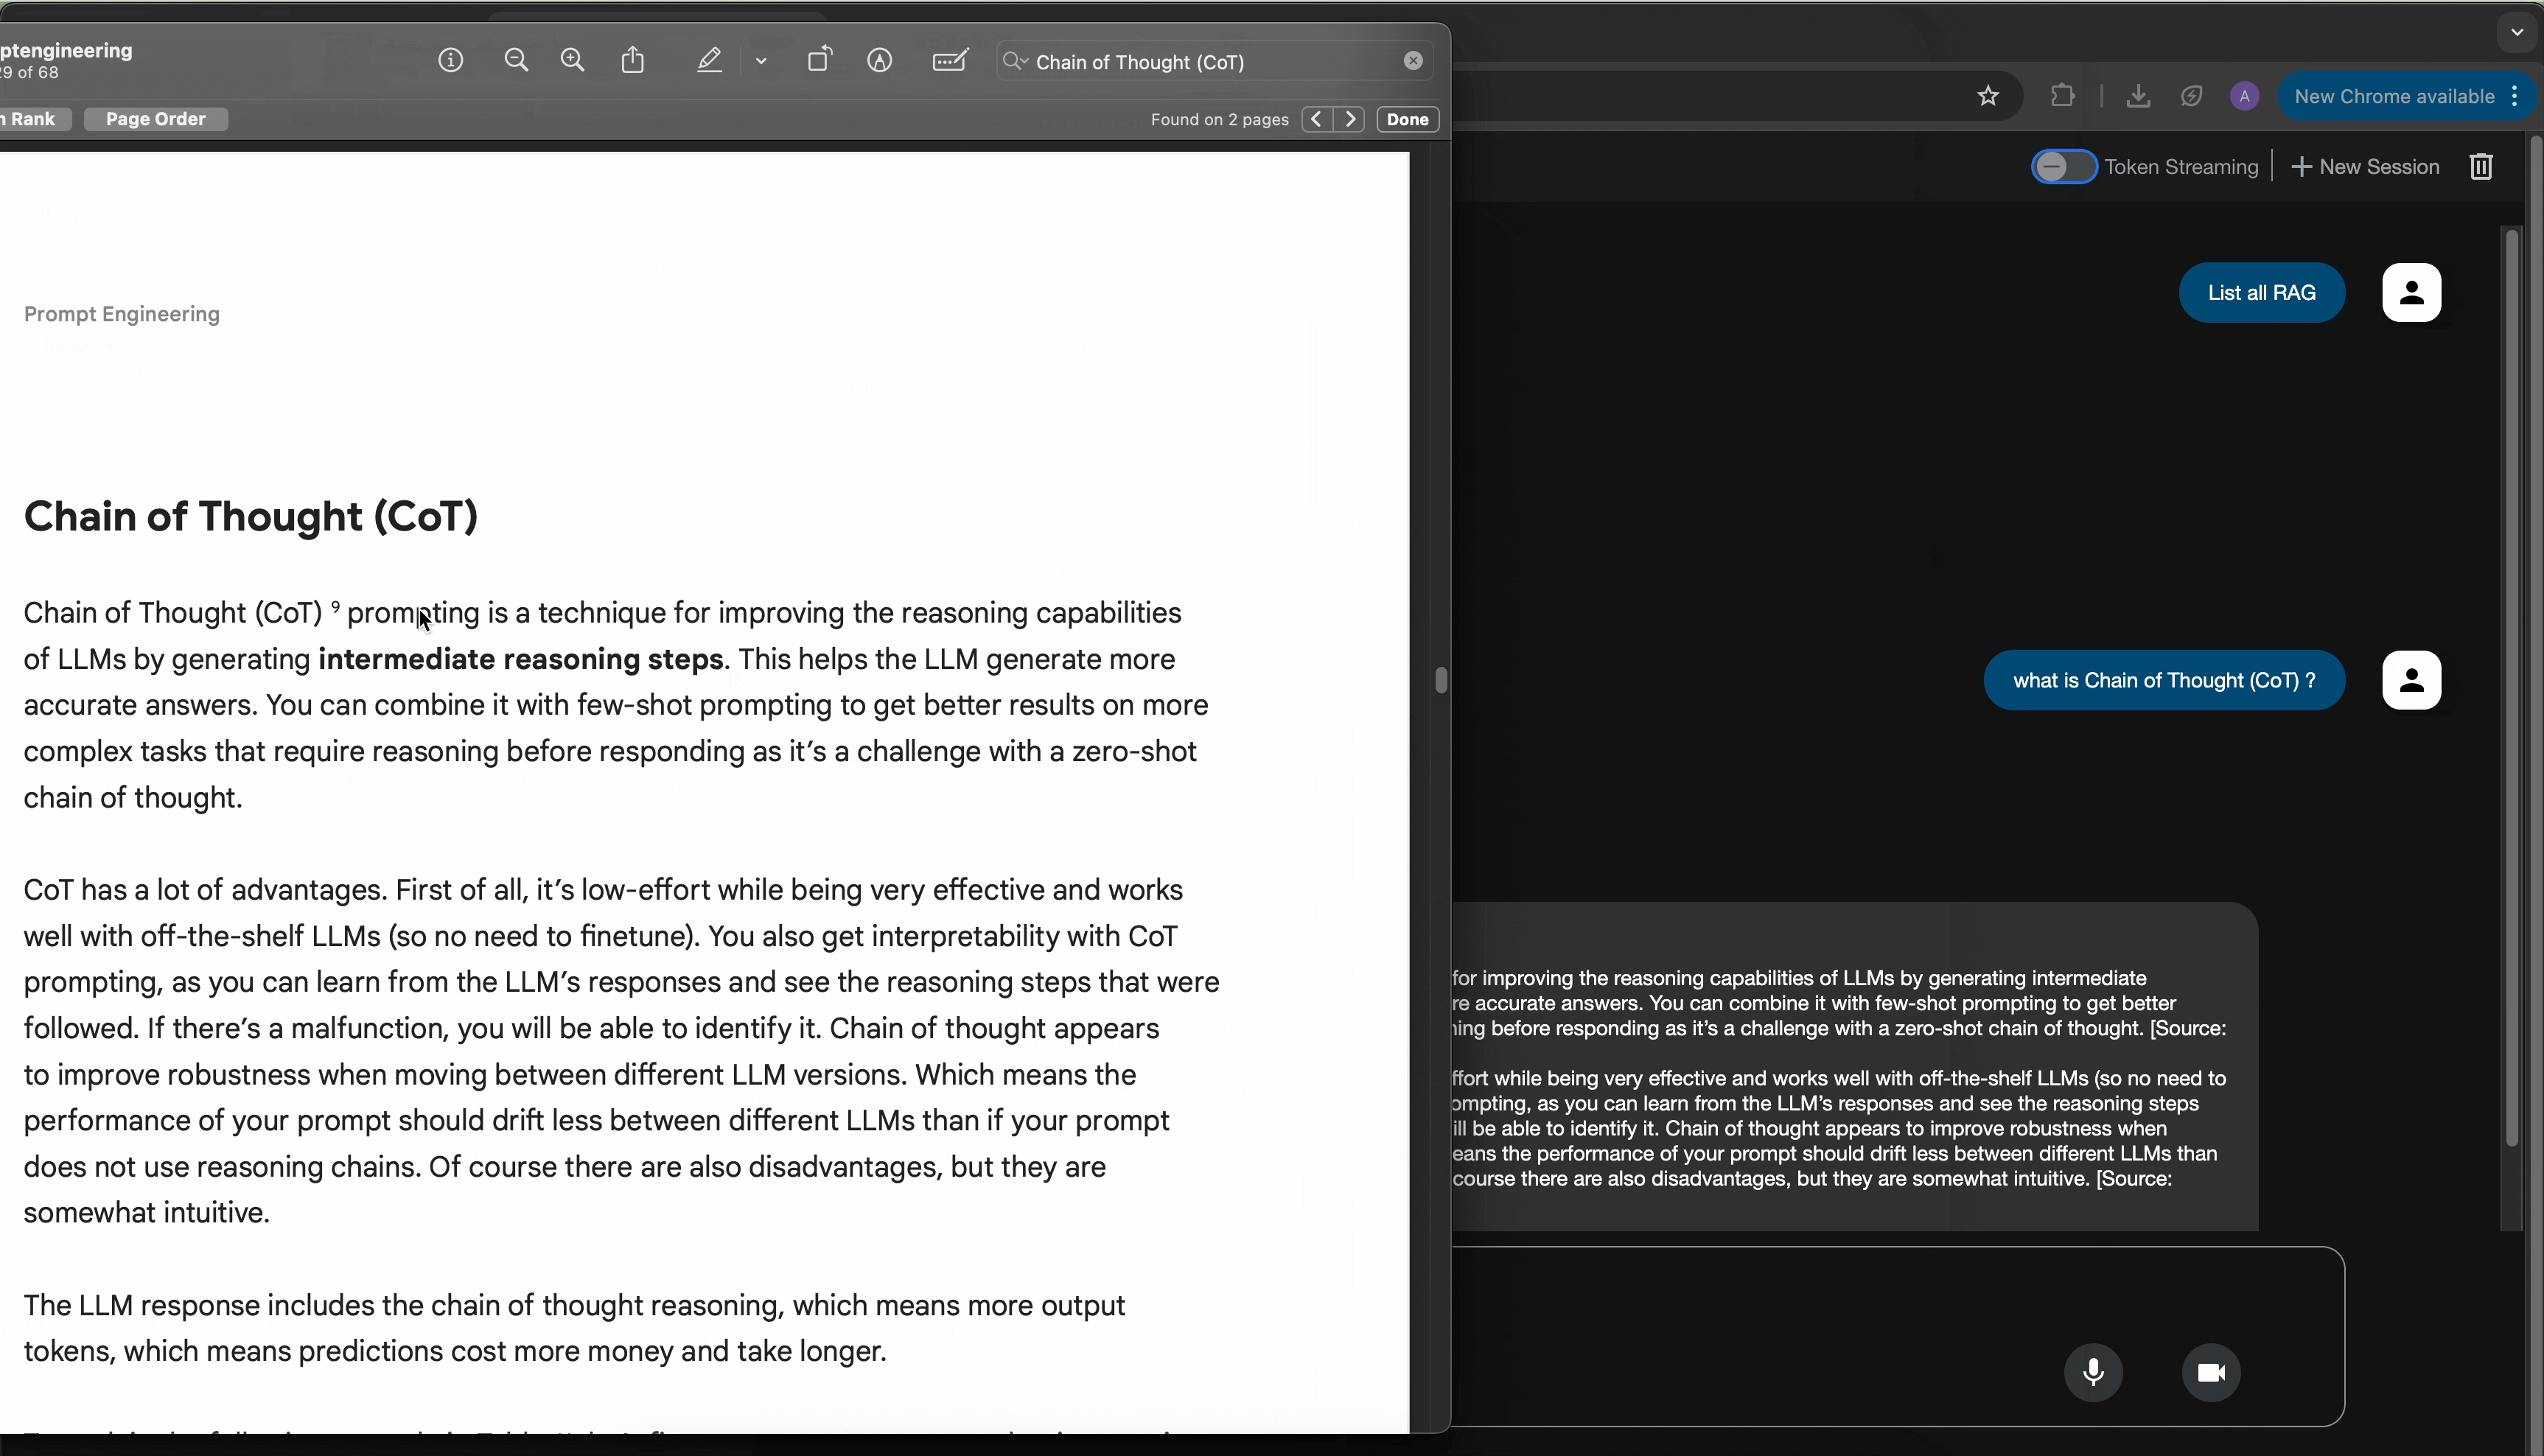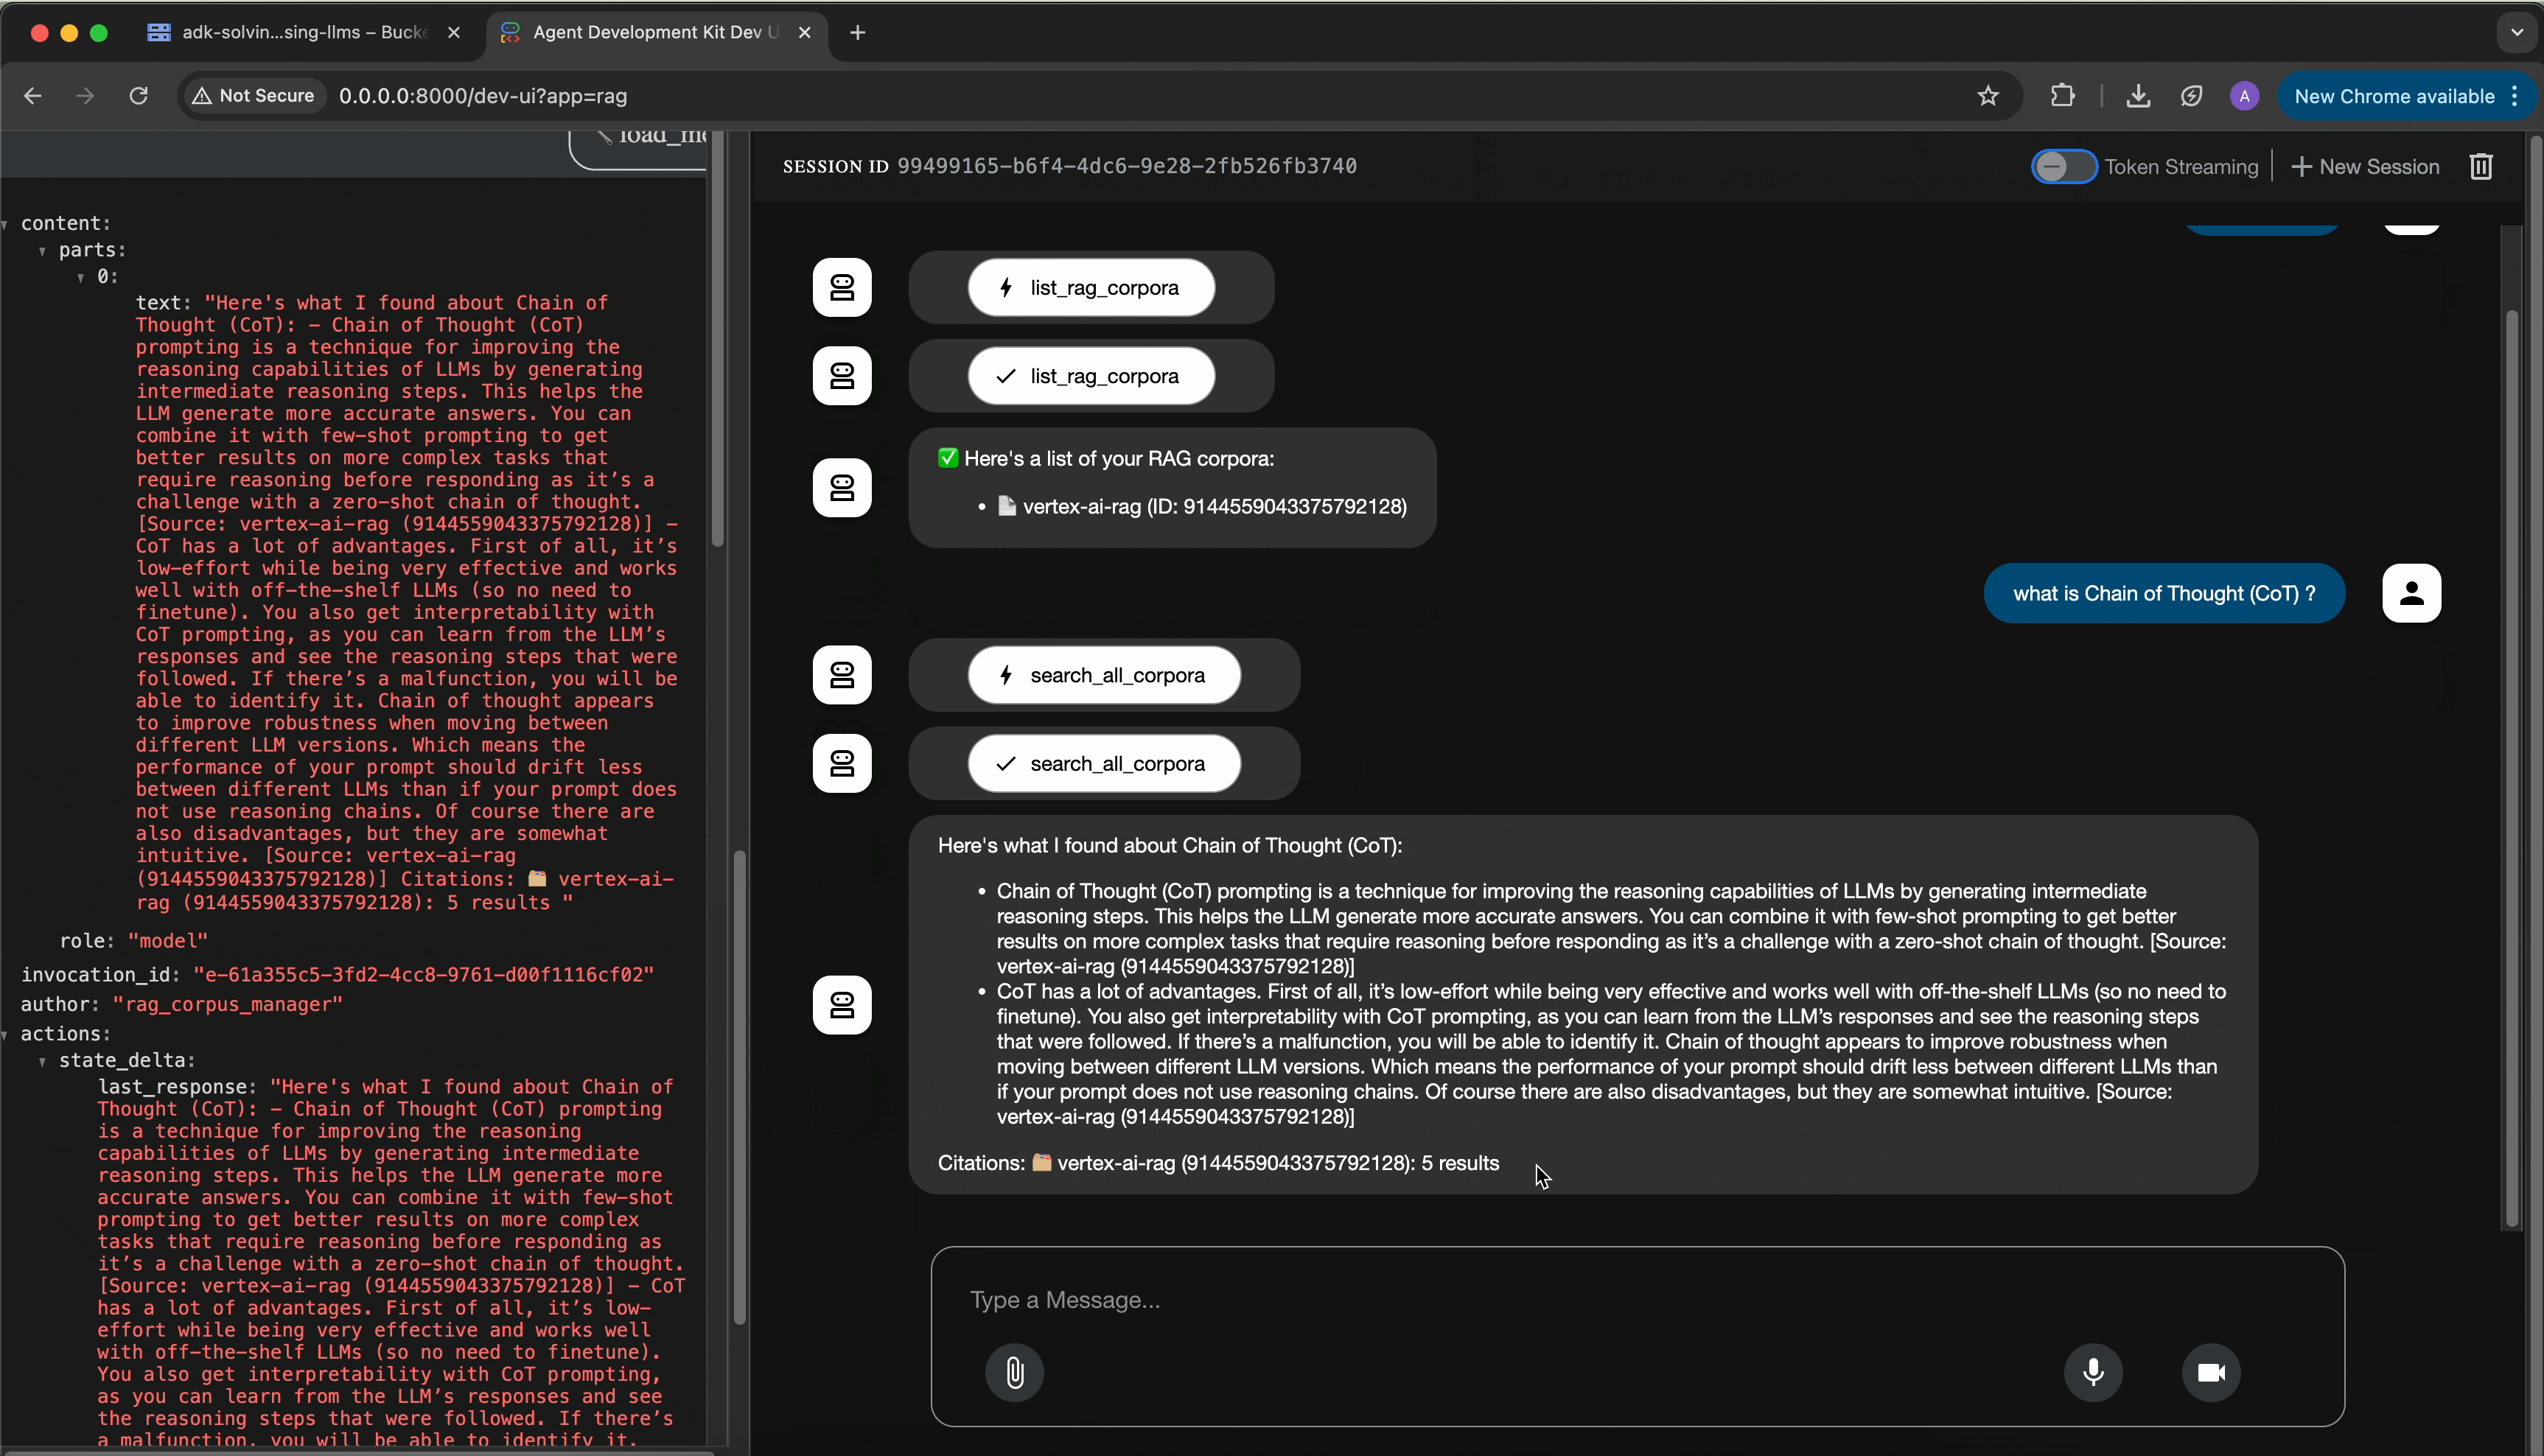
Web 界面中输入自然语言查询,系统实时返回带引用的答案
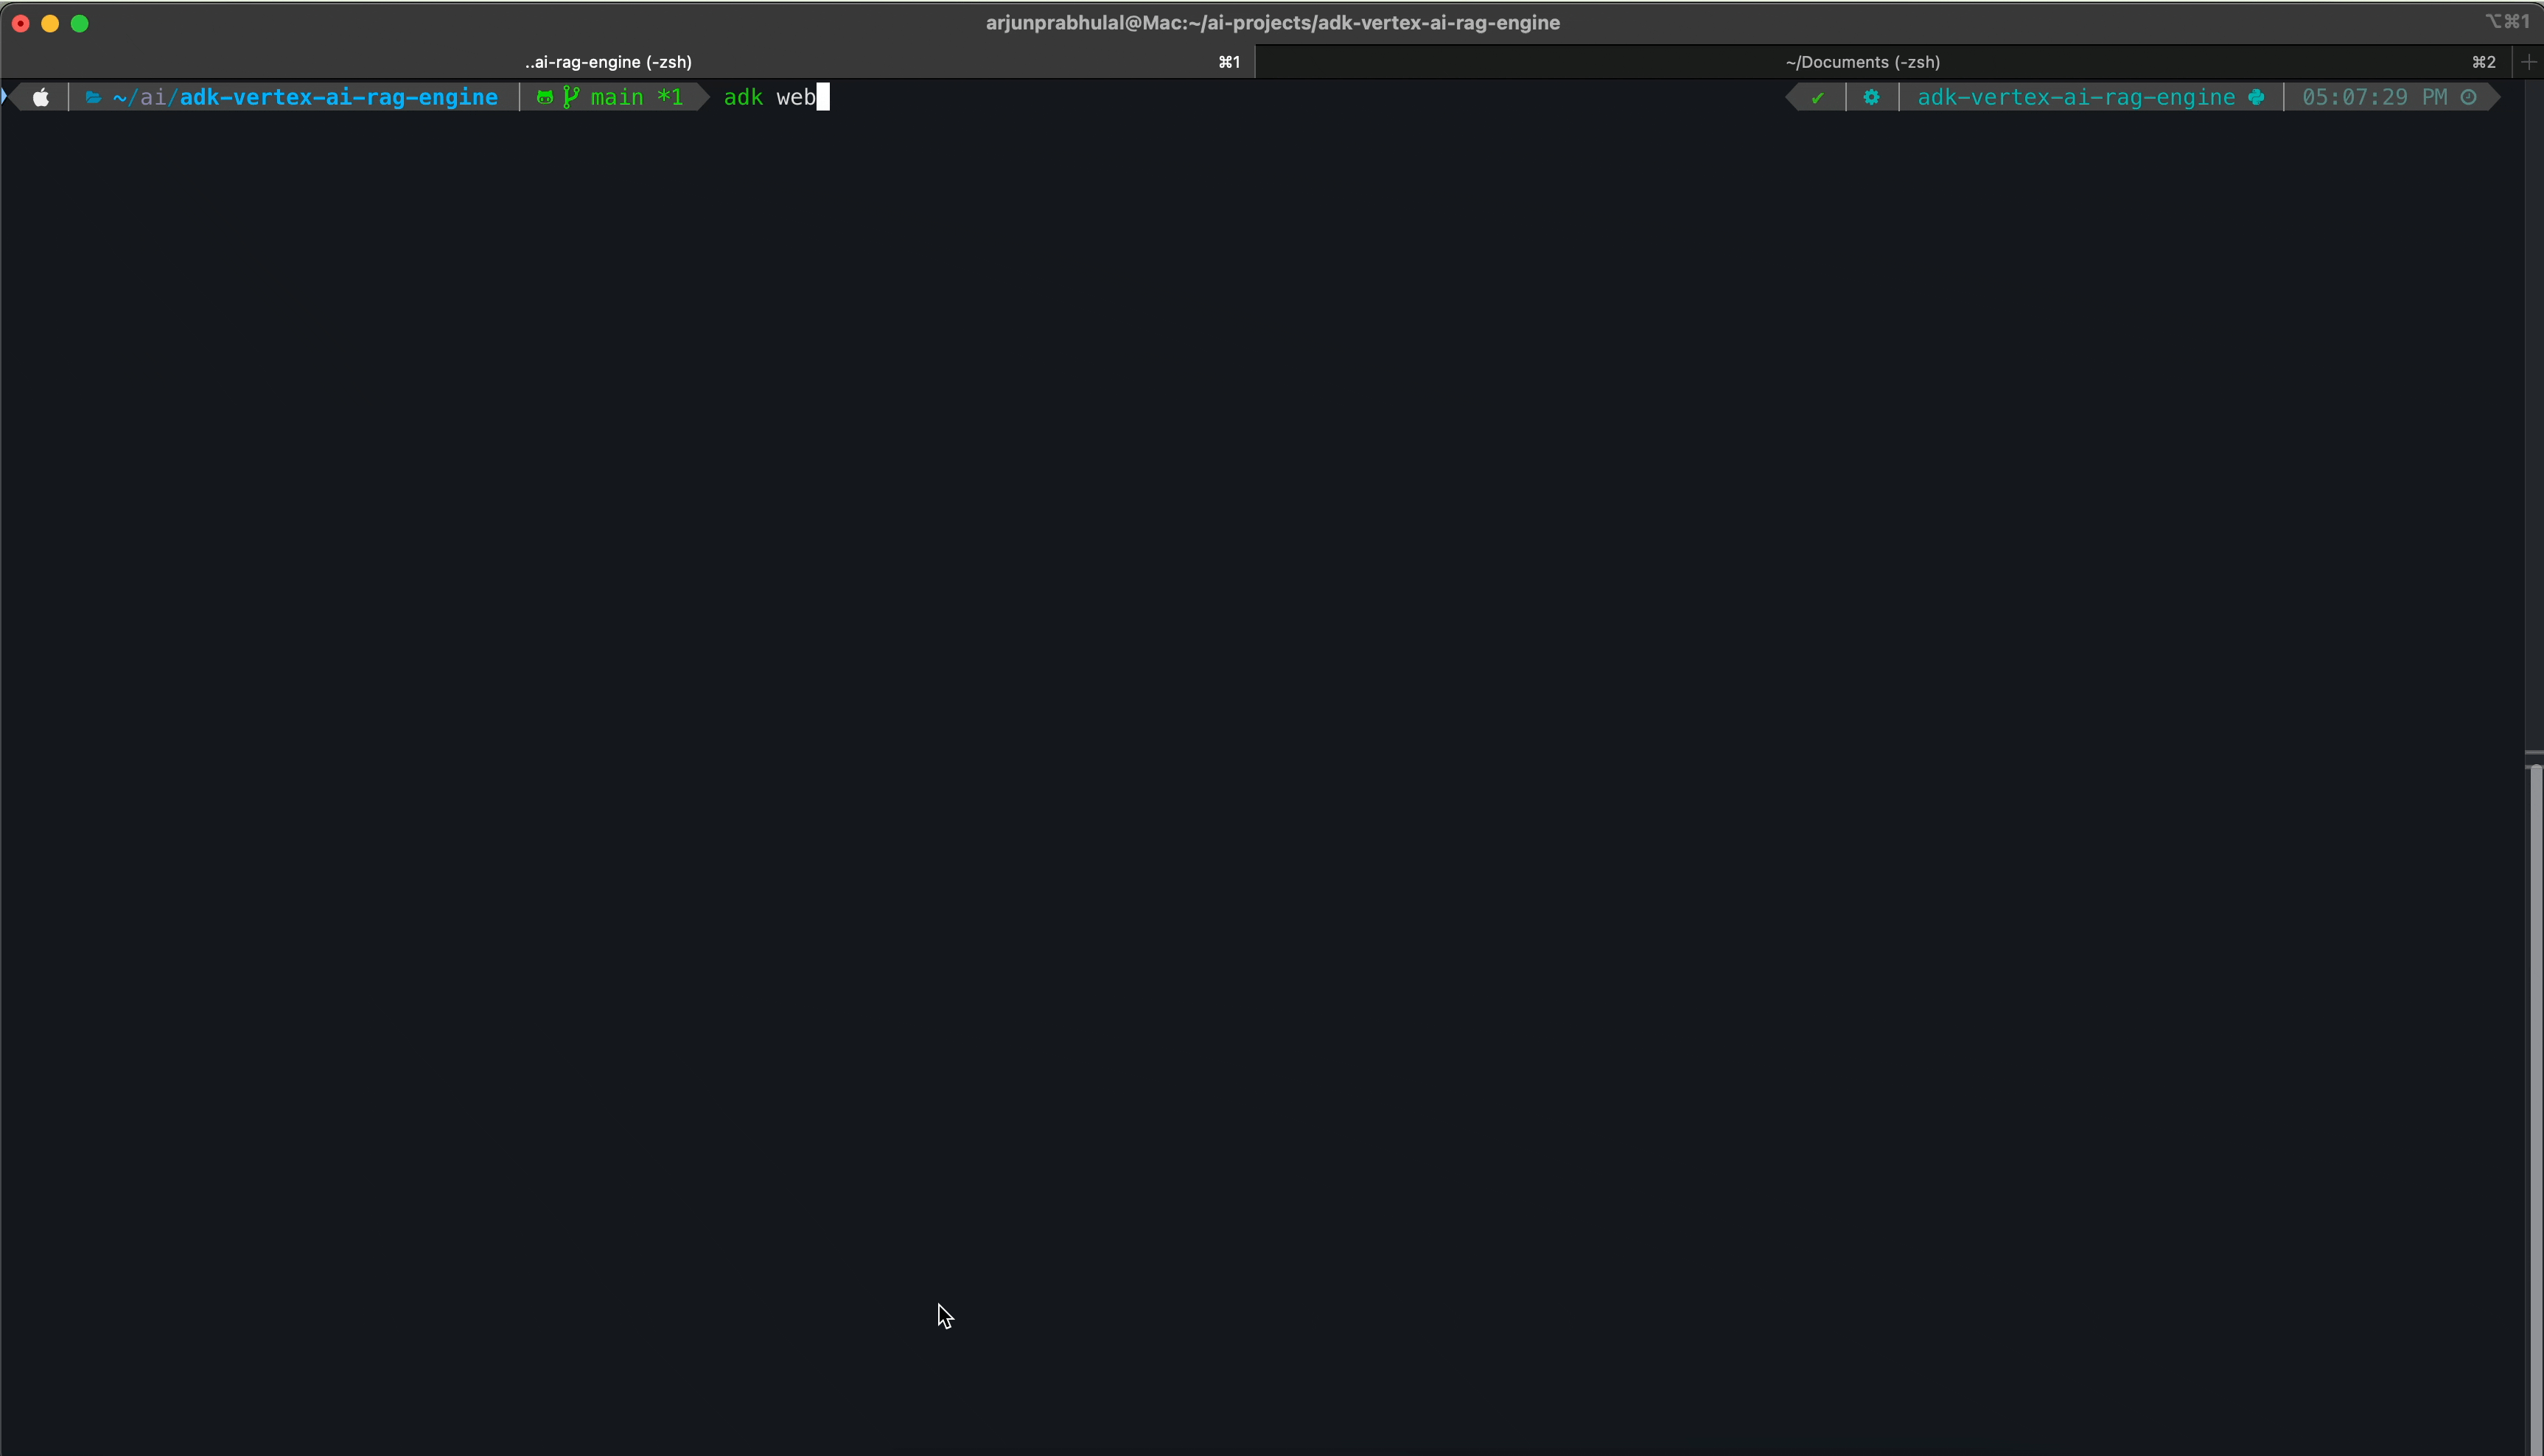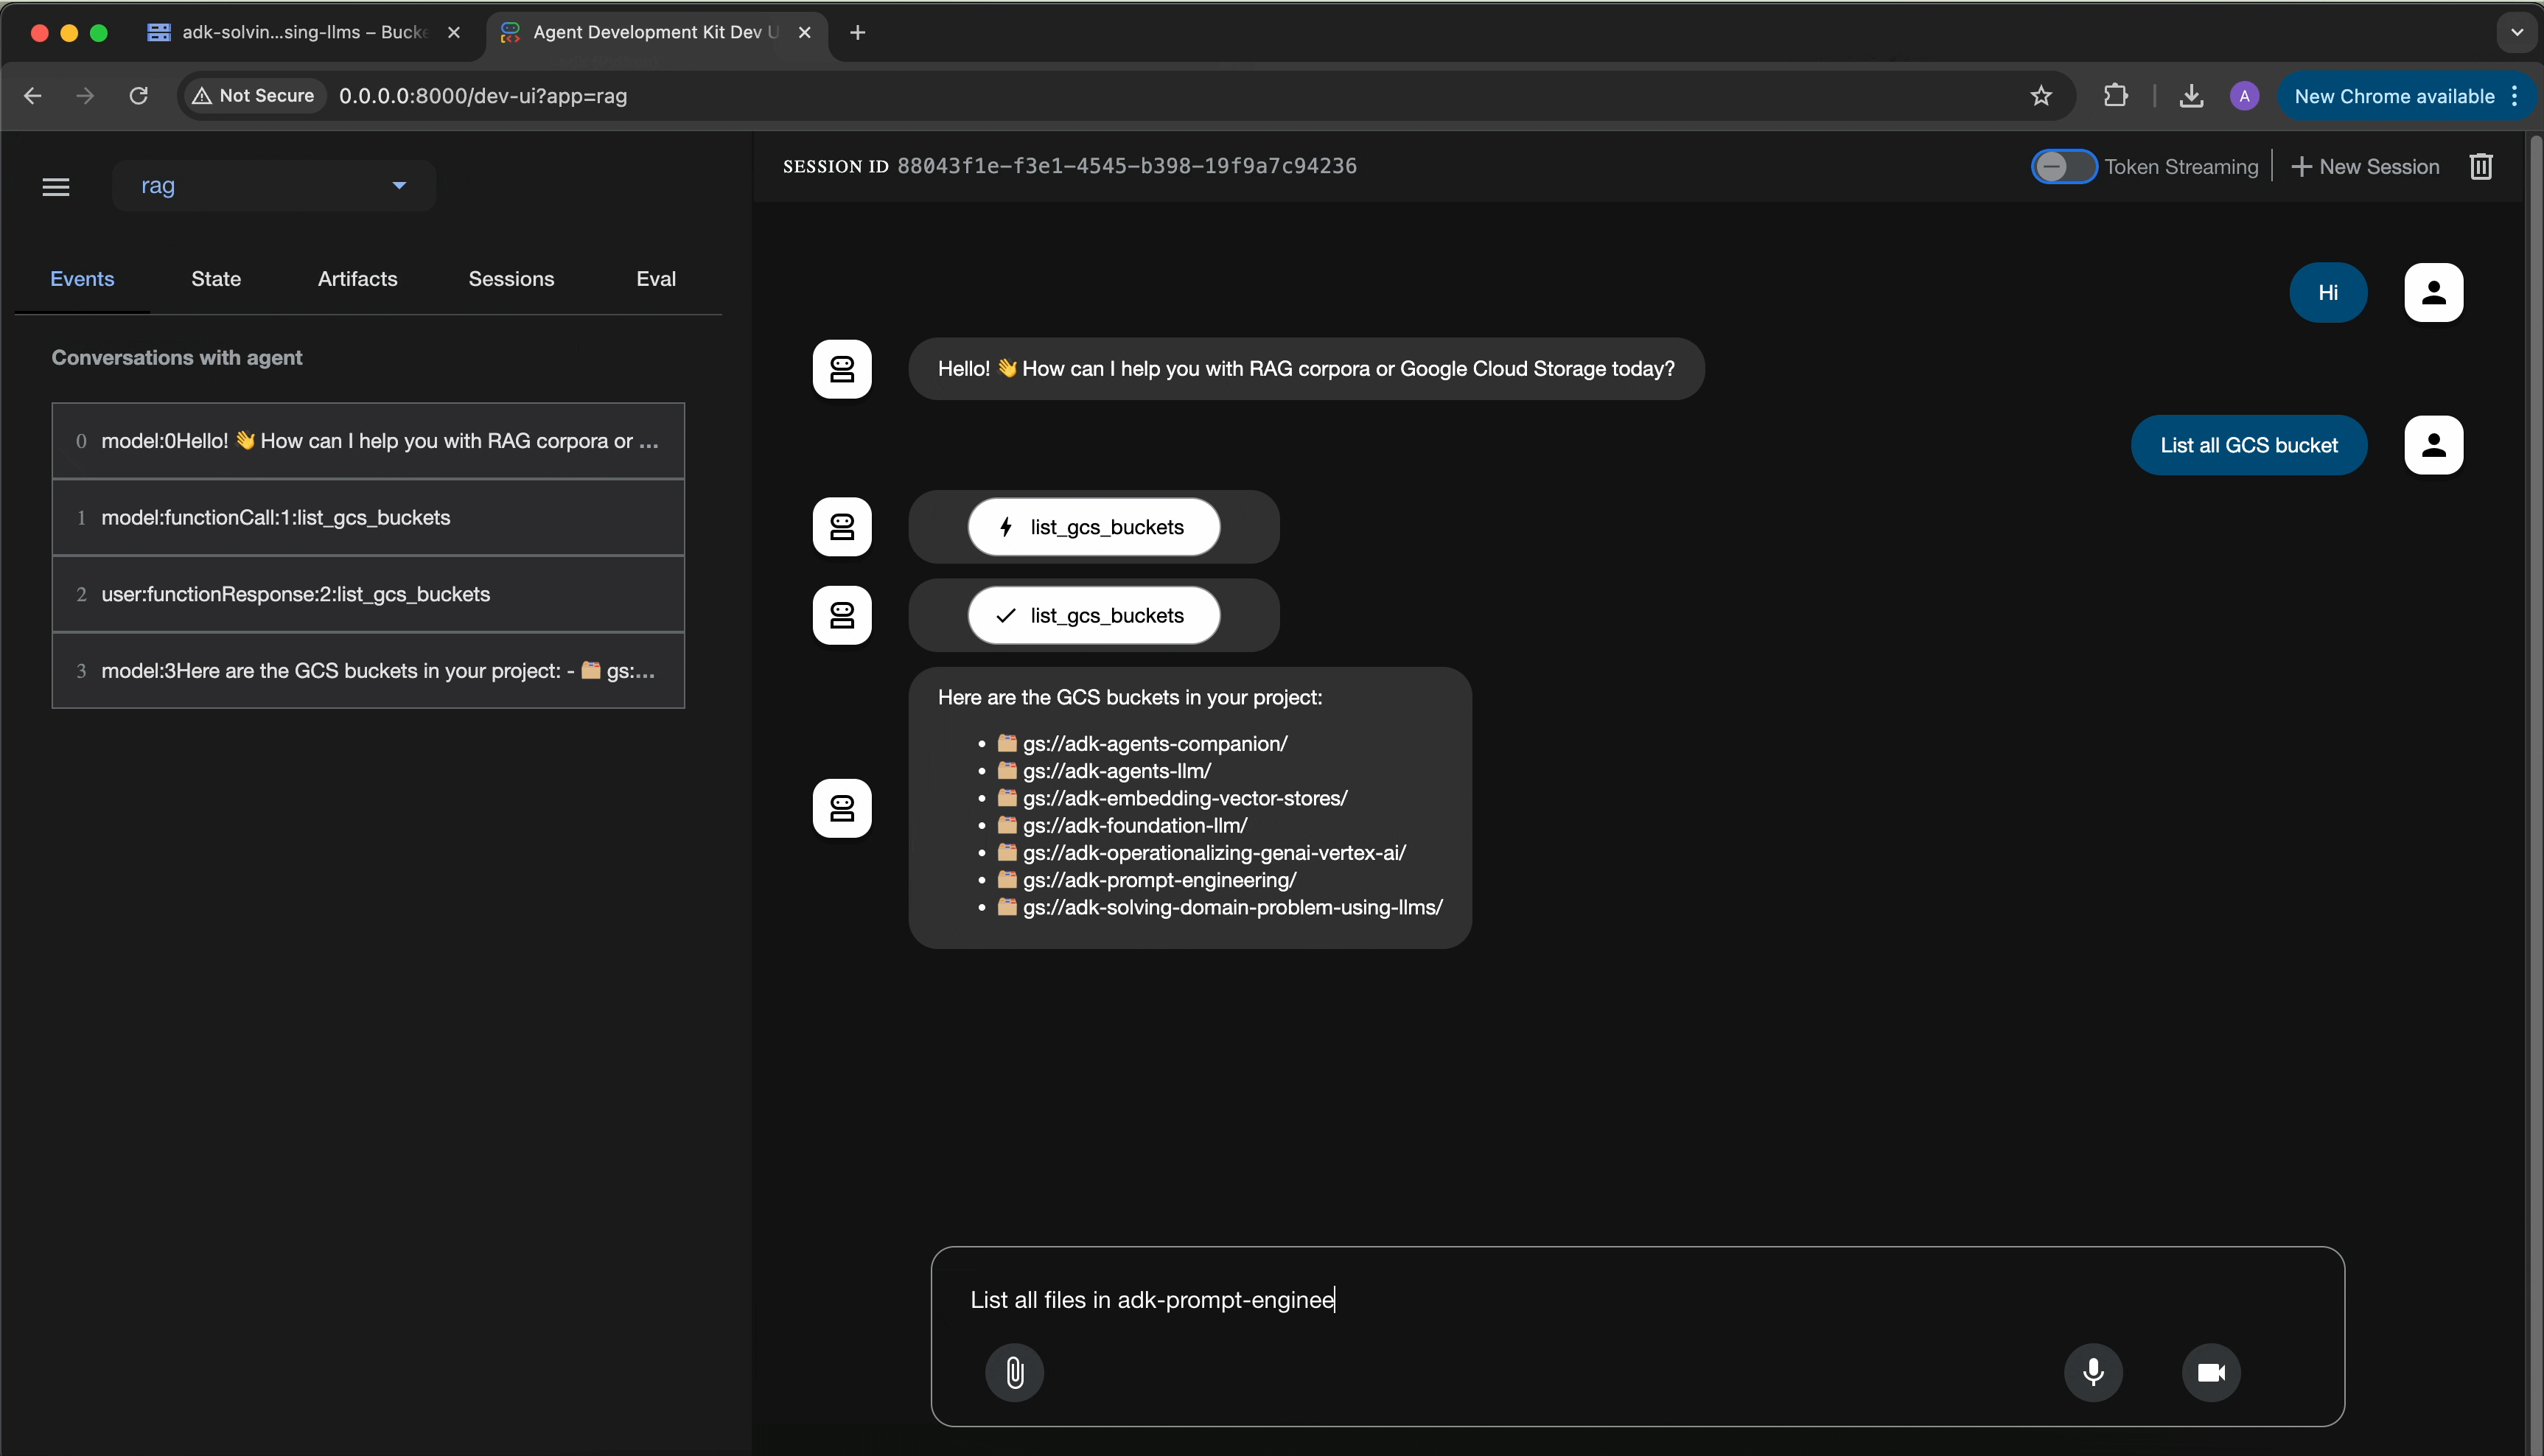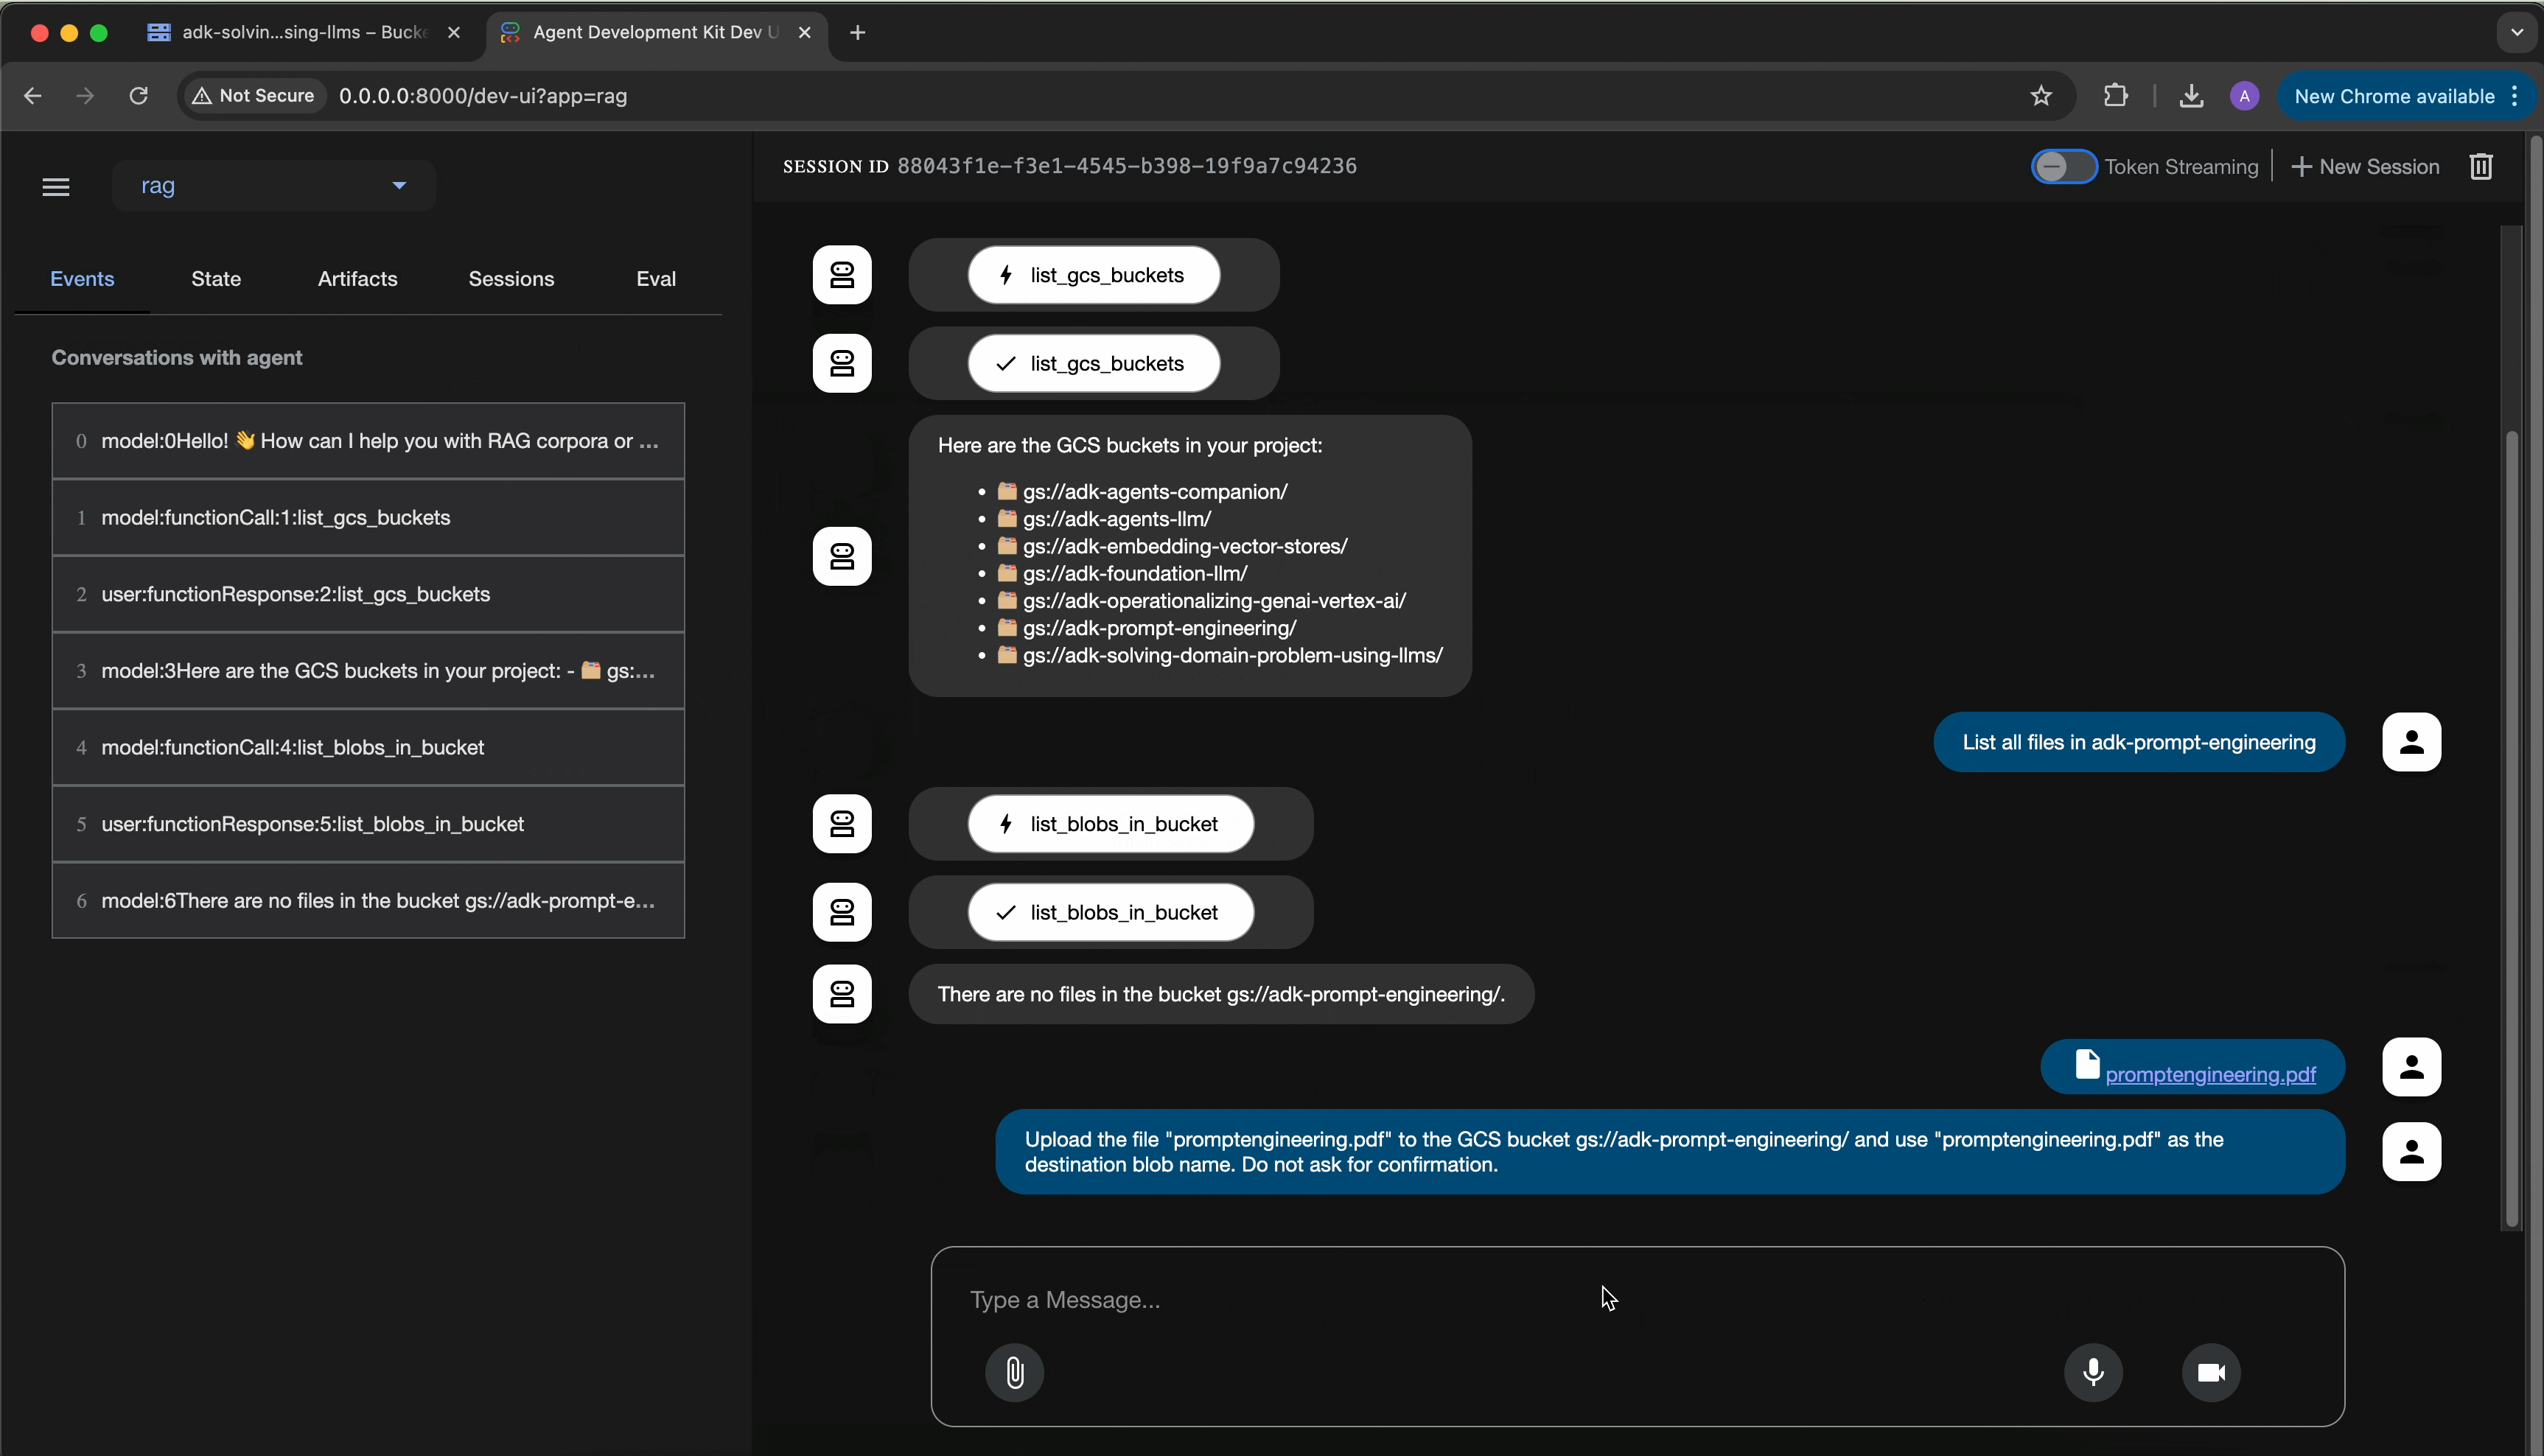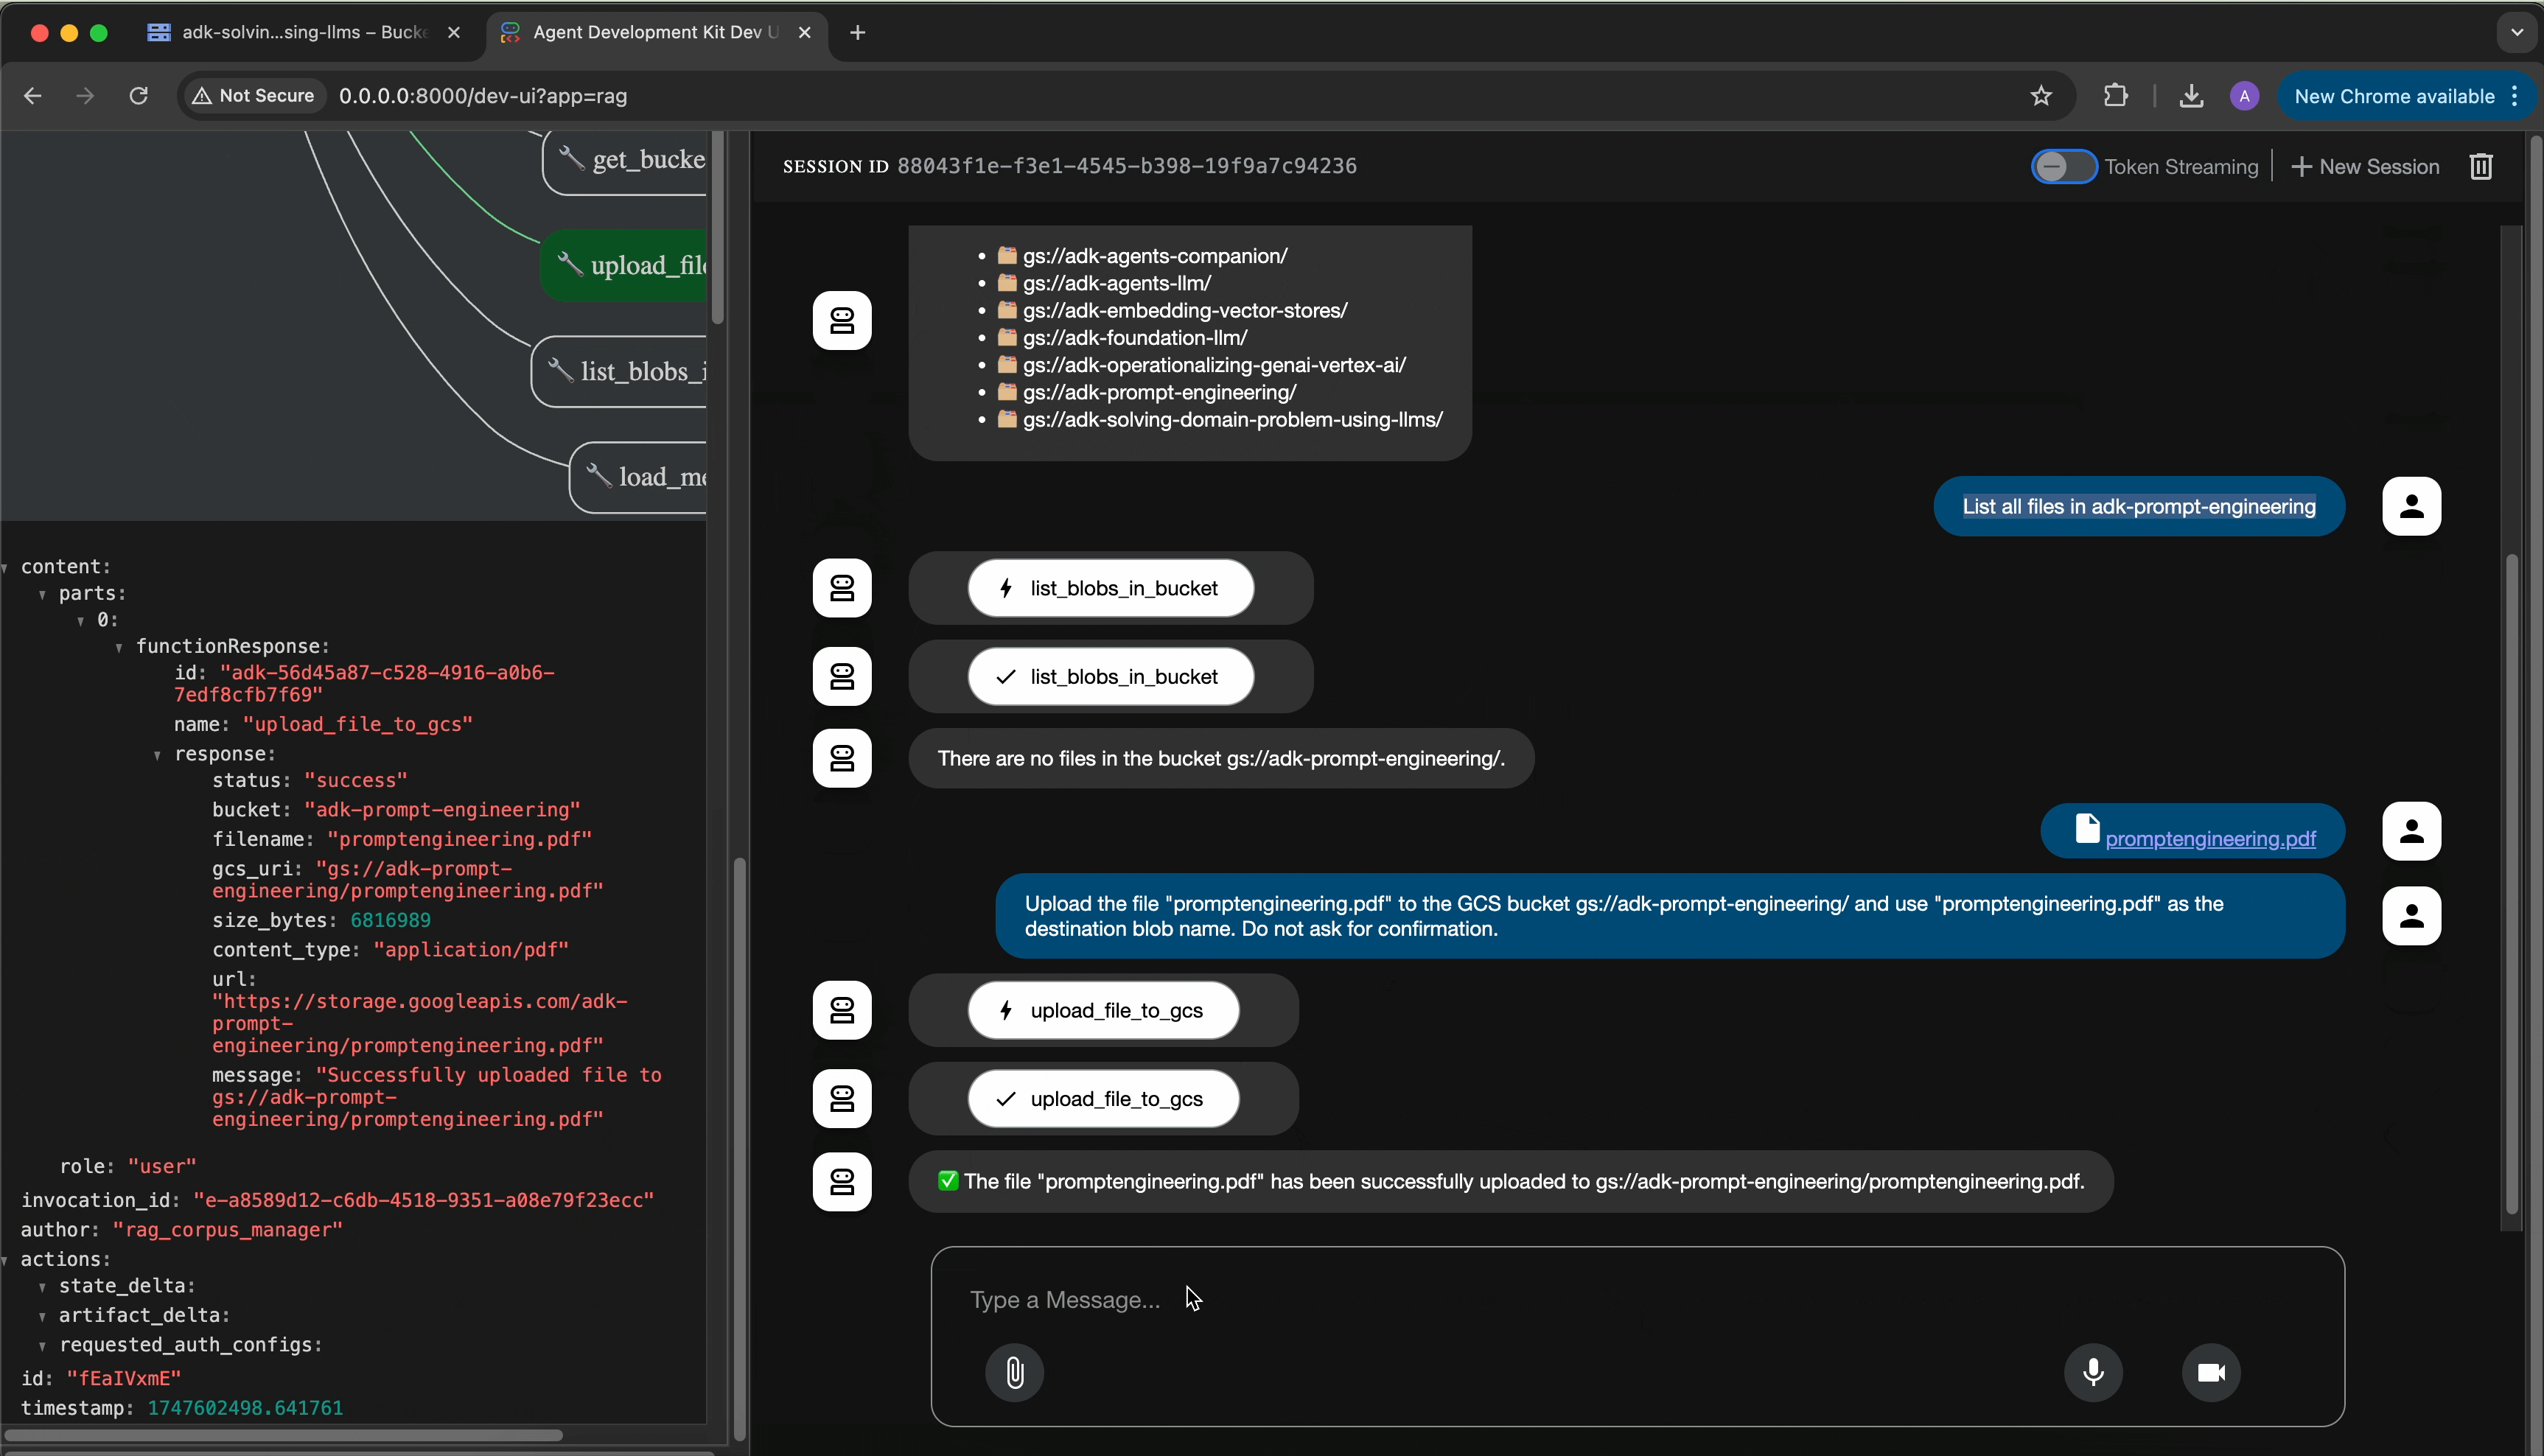
通过 Web 界面上传文件到 Google Cloud Storage
项目技术栈非常聚焦:
google-adk、google-cloud-aiplatform[adk,agent-engines] 和 google-cloud-storage代码结构清晰,rag/ 目录下分 tools/(功能工具)、config/(配置)和 agent.py(Agent 定义)三个子模块。工具函数遵循 ADK 的 FunctionTool 模式,每个函数有完整的类型注解和 docstring,返回值统一为包含 status 字段的字典,便于 Agent 解析和展示。
不过,项目也存在一些值得注意的问题:
tests/ 目录,无法判断单元测试覆盖率rag/config.py 中的 PROJECT_ID = "your-project-id" 需要用户手动替换,缺乏环境变量注入机制部署这个项目需要满足以下前提条件:
gcloud auth application-default loginpip install google-adkGOOGLE_APPLICATION_CREDENTIALS 指向服务账号 JSON 文件完成以上步骤后,运行 adk web 即可启动。但必须指出:这是典型的 Cloud-First 架构,所有计算和存储都发生在 Google Cloud 上,纯离线本地部署是不支持的。对于数据隐私要求极高(如金融、医疗行业)的企业,这可能是一个限制因素。
好在 ADK 本身提供了一定的灵活性——虽然核心的 Vertex AI RAG Engine 必须联网使用,但用户可以通过自定义工具模式,接入其他向量数据库(如 Pinecone、Weaviate)的 RAG 能力,只是这需要额外的代码改造。
从行业视角看,这个项目代表了一个明确的趋势:企业级 AI 应用正在加速向云服务商整合。Google 通过 Vertex AI RAG Engine 提供了一站式方案:Embedding 模型、向量存储、检索排序、上下文管理全部由 Google 托管,企业只需关注业务逻辑和数据。
ADK 的出现则进一步降低了 Agent 开发门槛。与 LangChain 等通用框架相比,ADK 更专注于 Google 生态,对已经使用 Google Cloud 的企业来说,学习成本更低、集成成本更小。
当然,这条路也有其挑战:供应商锁定(Vendor Lock-in)是绕不开的话题。一旦选择了 Vertex AI RAG Engine,迁移到其他平台的数据和配置成本不可忽视。在做技术选型时,这是值得权衡的关键因素。
一句话总结:如果你已经在使用 Google Cloud,想要快速搭建一个支持多文档、多语料库的 RAG 问答系统,这是一个值得参考的开源实现。它用 ADK Agent 的思路重新包装了 Vertex AI RAG API,代码质量良好,但在测试覆盖和配置灵活性上还有提升空间。
