
multimodal-ai
anyscale/multimodal-ai加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
某天晚上,某 AI 团队的算法工程师小林遇到了一个头疼的问题:公司需要为一个新的狗品种分类项目生成 10 万张图片的向量 embedding——用本地单卡 GPU 跑,预计需要 72 小时。更让他焦虑的是,下周还有一场模型训练和在线推理服务的交付,时间窗口被压缩得极紧。
他不想写三套完全不同的代码来分别处理"批量推理""分布式训练""在线服务"这三个场景。有没有一种方法,能用同一套代码架构,无缝切换这三种部署模式?
anyscale/multimodal-ai 就是答案。这是一个由 Ray 核心团队(Anyscale)开源的官方教程仓库,通过一个完整的狗品种图片分类项目,演示了如何利用 Ray 生态优雅地处理多模态 AI 的三大工业级任务:批量推理、分布式训练和在线服务。代码逻辑高度复用,场景一键切换,堪称 AI 工程化的教科书级范例。
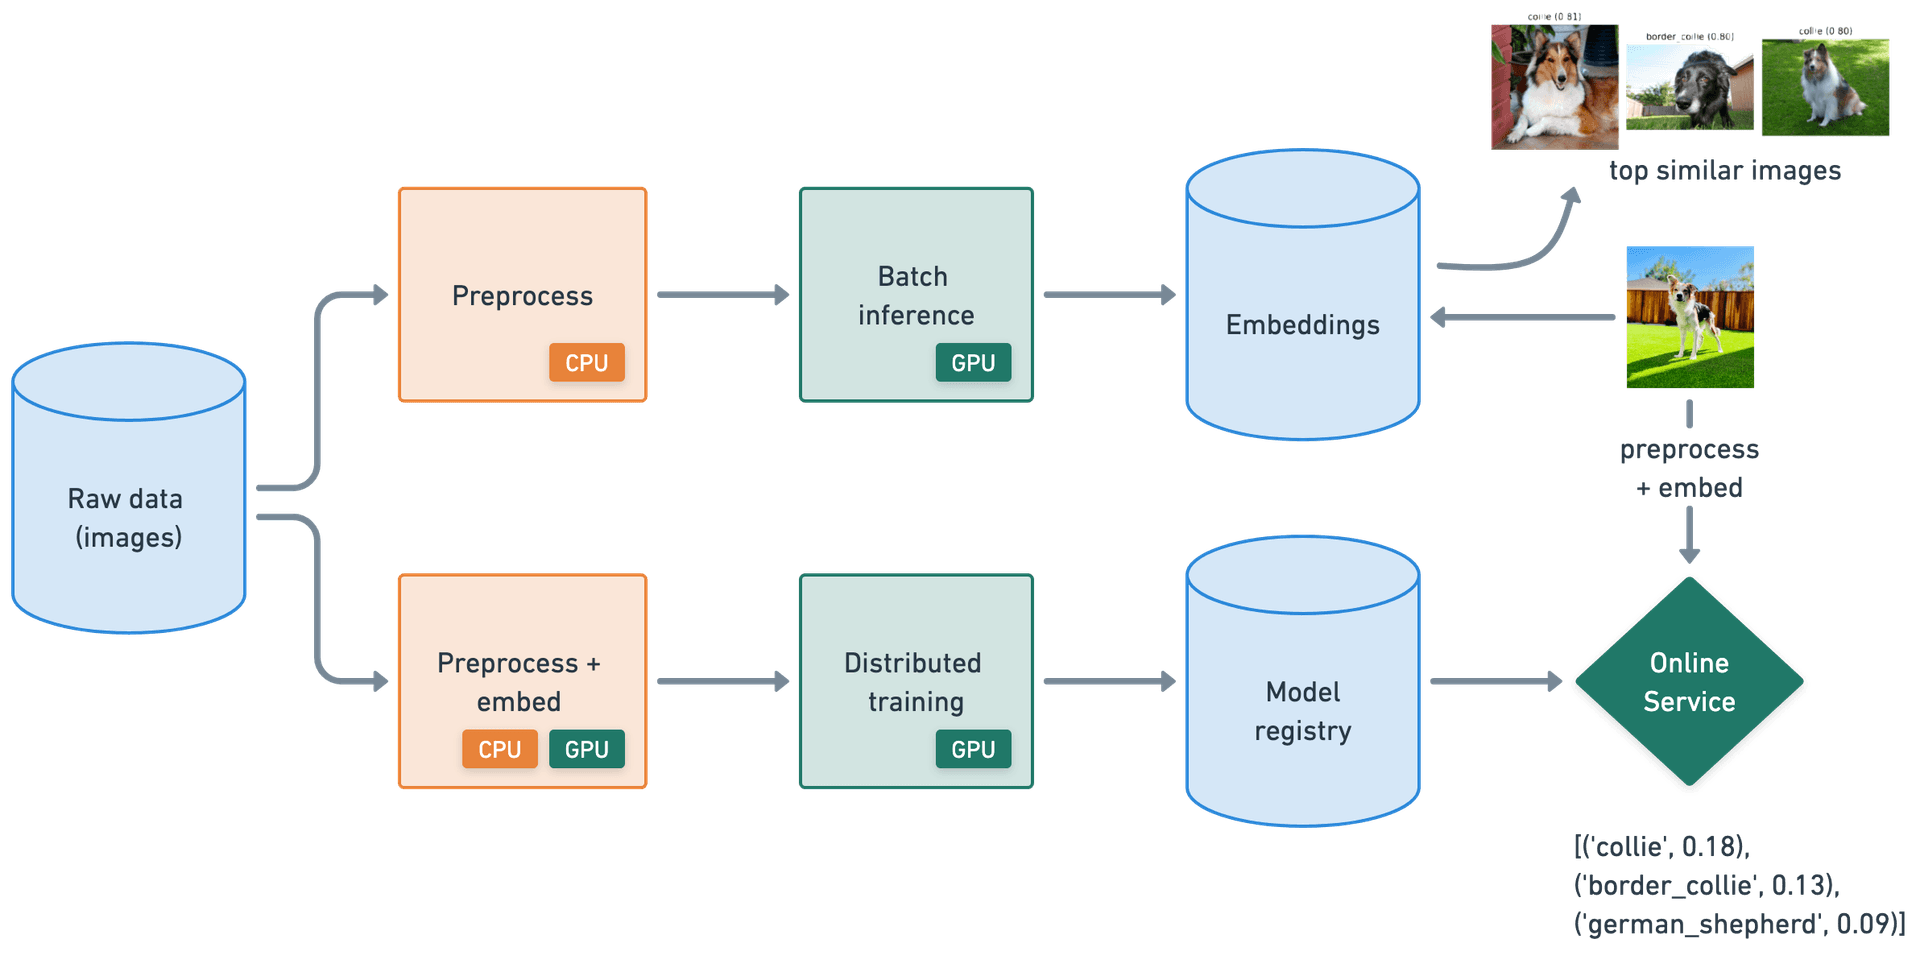
multimodal-ai 是 Anyscale 公司(Ray 开源框架的创始团队和商业支持方)官方维护的教程项目,定位为 Ray 官方文档中 e2e-multimodal-ai-workloads 的 GitHub 独立版本。项目基于 Ray 2.48.0,覆盖了从数据处理、模型训练到生产部署的完整 AI 工作流。
Anyscale 同时提供同名云平台(console.anyscale.com),允许用户直接在云端一键运行这些 Notebook,无需配置本地 GPU 环境。
项目选择狗品种图片分类作为演示场景并非随意——这是一个典型的多模态任务:既涉及图片视觉特征提取(CLIP 视觉编码器),也涉及文本标签映射,同时需要 Ray Data 处理大规模数据管道、Ray Train 管理分布式训练生命周期、Ray Serve 提供低延迟在线推理服务。
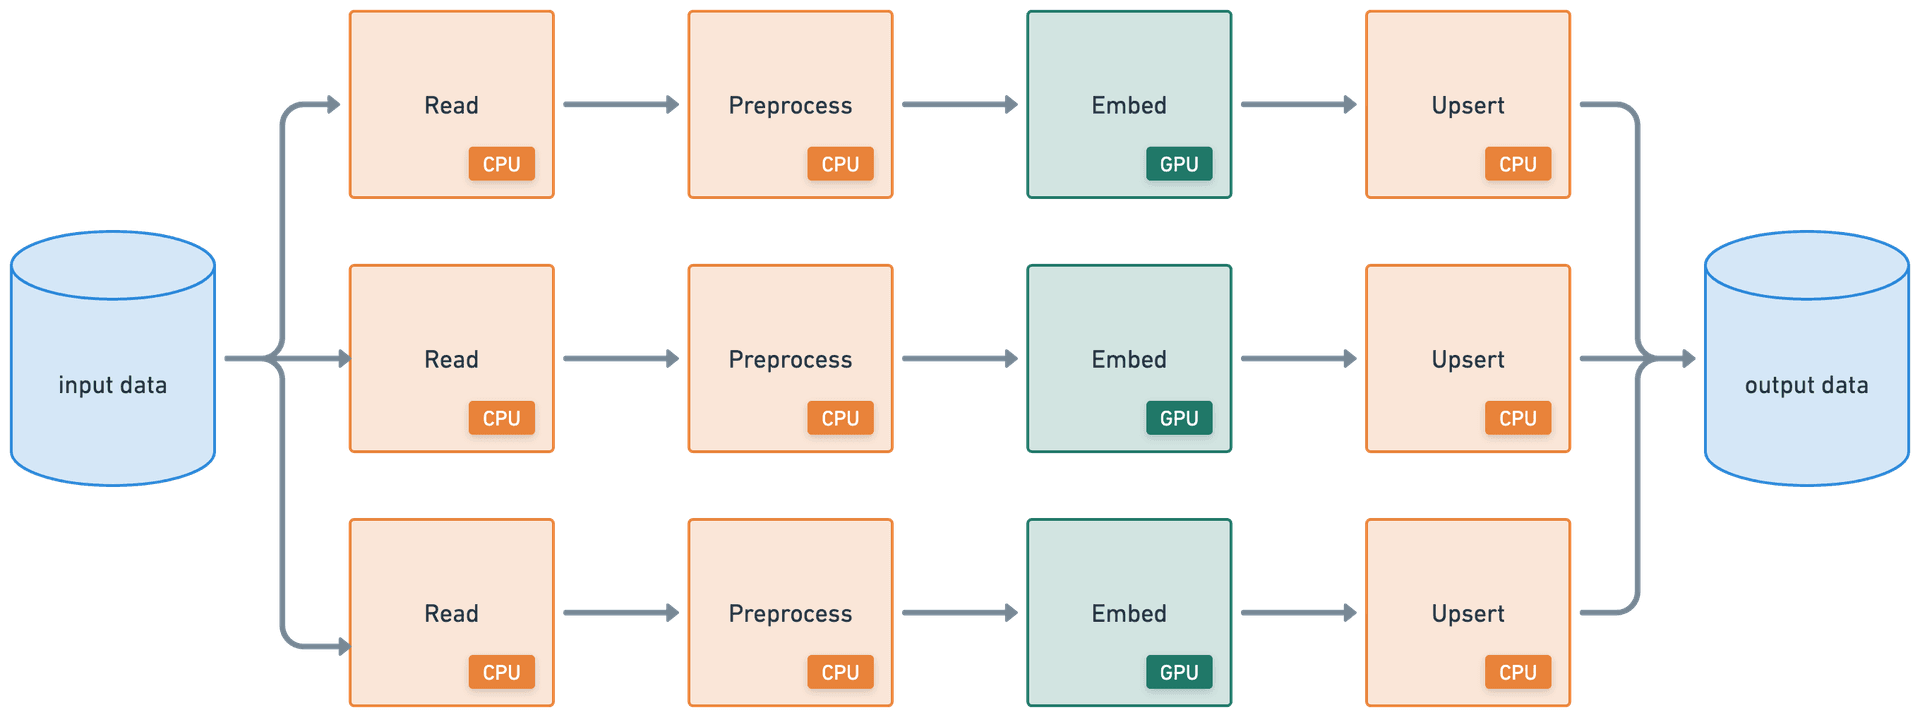
第一个 Notebook(01-Batch-Inference.ipynb)演示了如何使用 Ray Data 对 10 万张狗品种图片进行批量 CLIP 特征提取,并将 embedding 结果持久化存储。
技术细节:
CLIPModel + CLIPProcessor(HuggingFace Transformers)作为视觉编码器map_batches() API 实现批处理并行——无需手动管理批处理大小、CUDA 内存分配BATCH_SIZE 可通过配置文件(configs/generate_embeddings.yaml)远程调整,Job 重跑无需修改代码关键代码片段展示了 Ray 的核心优势——声明式数据管道:
# 用 Ray Data 读取本地图片目录
ds = ray.data.from_items([...])  # 或 from_images()
ds = ds.map_batches(
    EmbedImages,  # 自定义 Actor 类,封装 CLIP 编码逻辑
    compute=ActorPoolStrategy(),
    batch_size=32,
    num_gpus=1
)
这个模式的优势在于:数据流、并行策略和计算逻辑完全解耦,开发者只需关注业务逻辑本身,Ray 自动处理分布式调度。
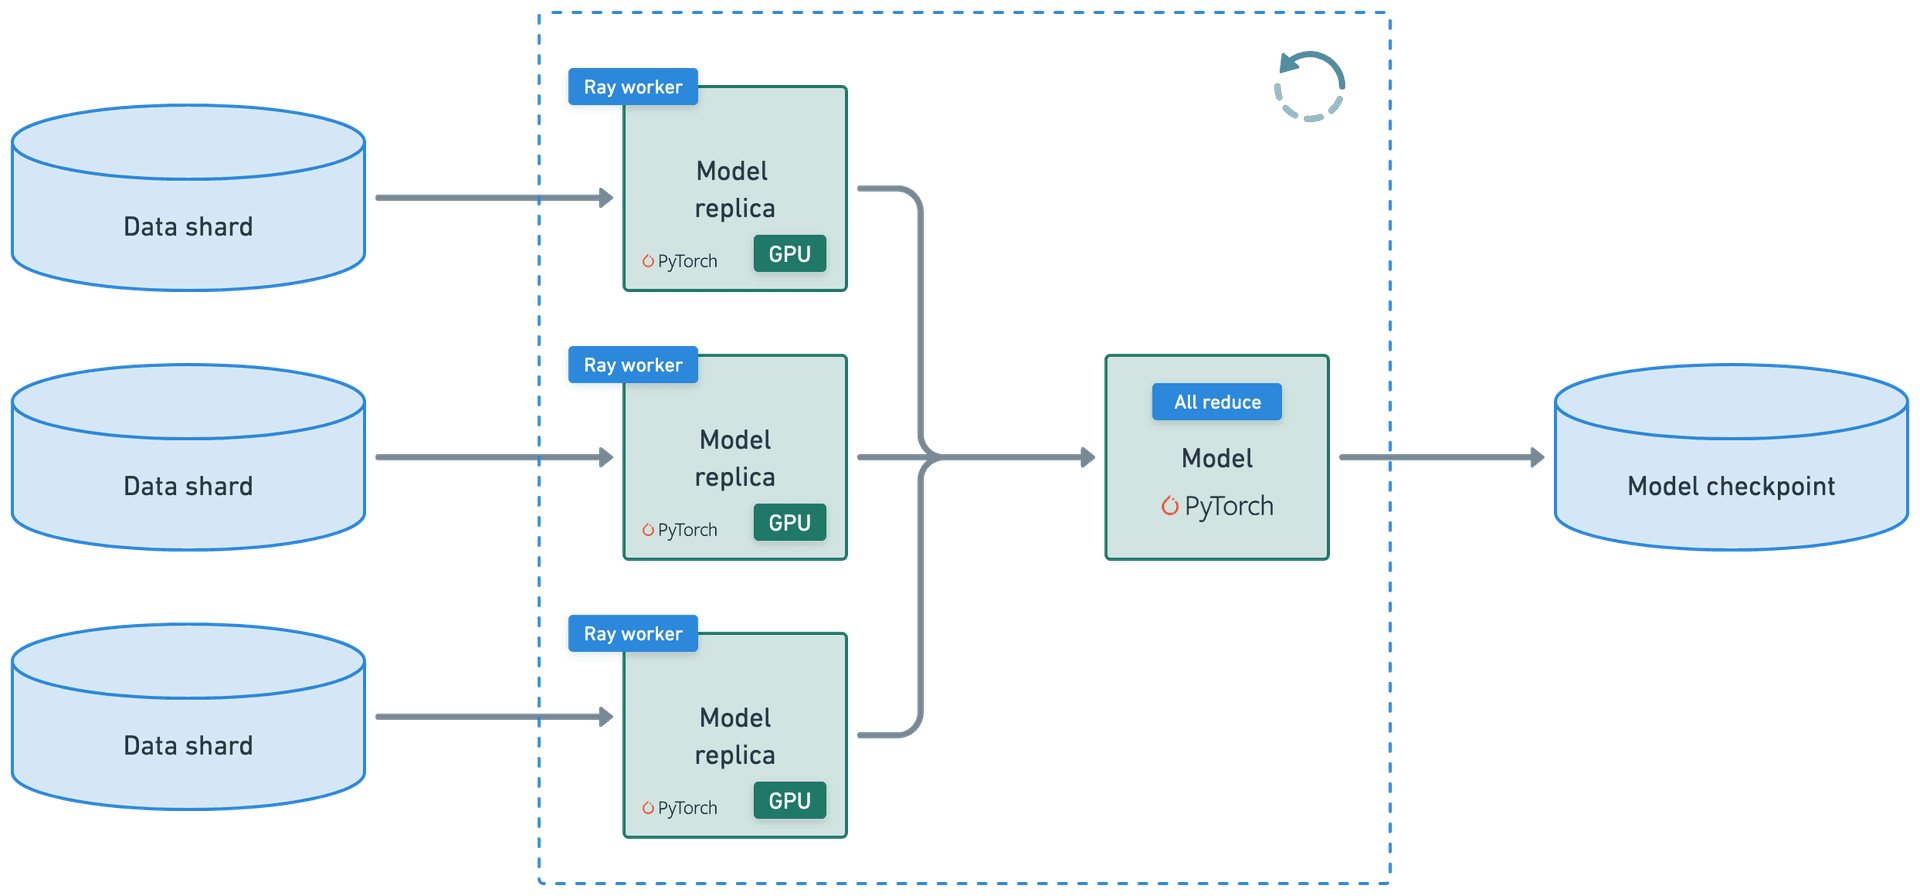
第二个 Notebook(02-Distributed-Training.ipynb)展示了如何使用 Ray Train 训练一个基于 CLIP 视觉特征的图片分类模型。
技术细节:
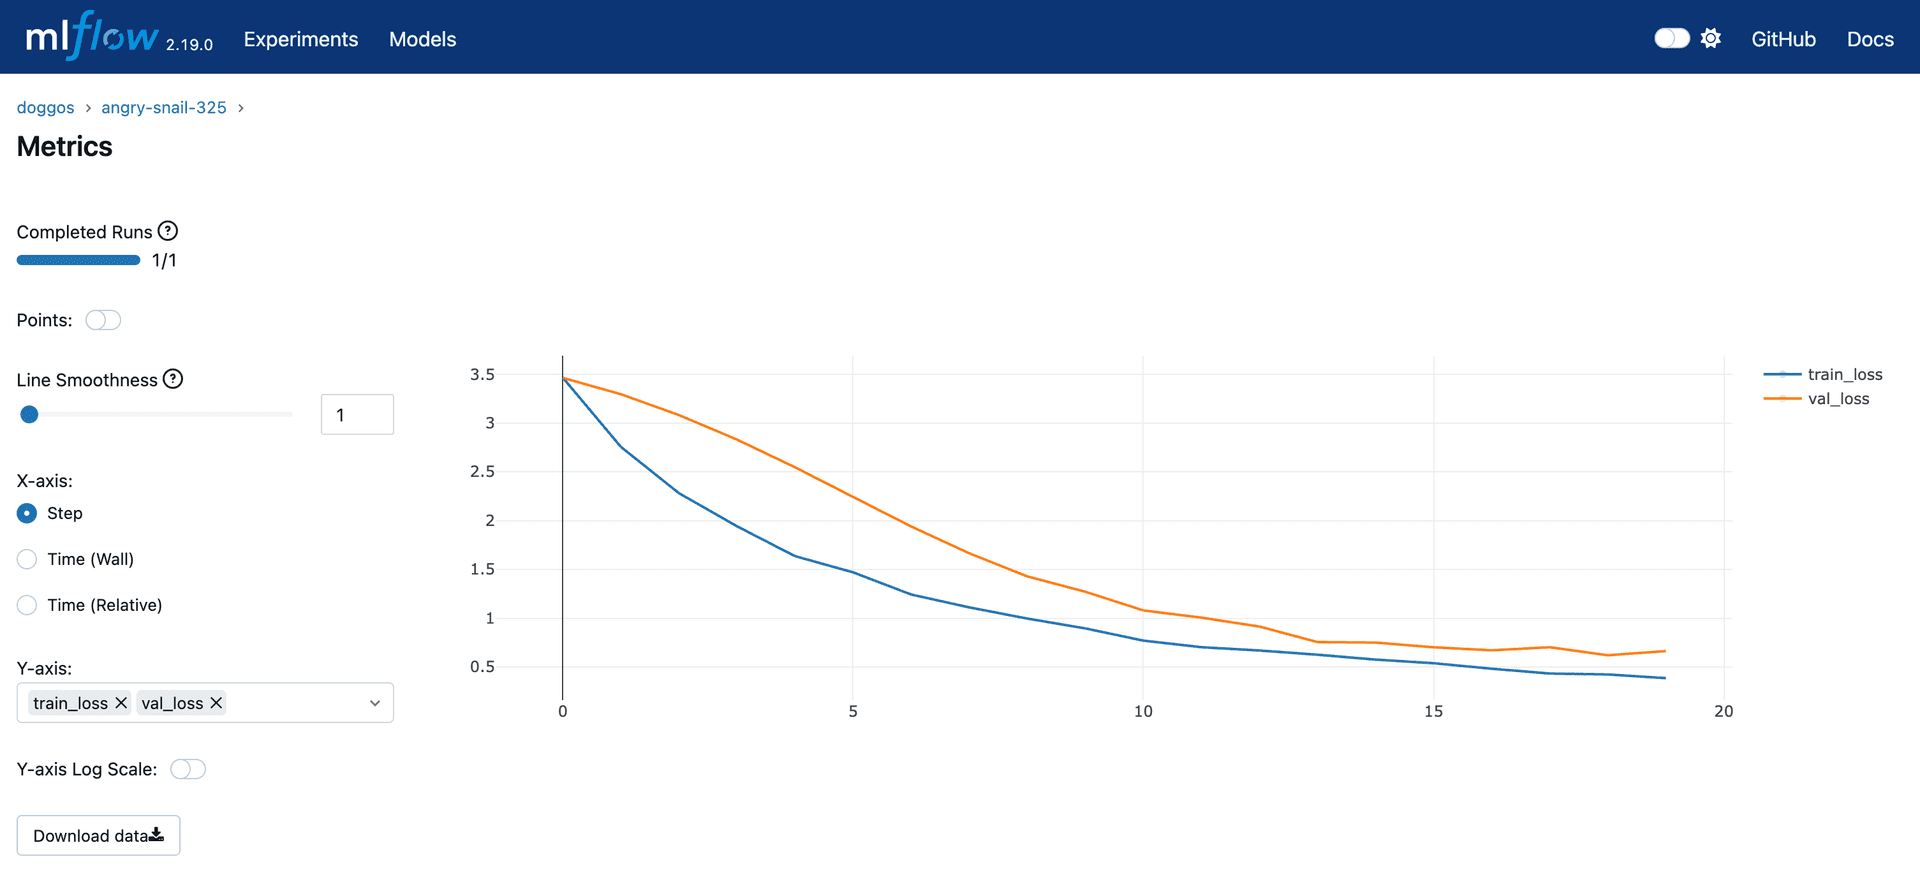
Preprocessor 类实现数据预处理(图片→CLIP embedding→分类标签)TorchPredictor 封装训练逻辑,自动处理 GPU 分配和梯度同步configs/train_model.yaml)定义在 YAML 中,通过 Anyscale Job API 提交,dev-prod 一致训练流程与 MLflow 的深度集成是本项目的一大亮点:
mlflow.autolog()  # 自动记录超参数、指标、模型工件
with TrainContext() as train_context:
    trainer.fit()  # Ray Train 自动管理分布式训练
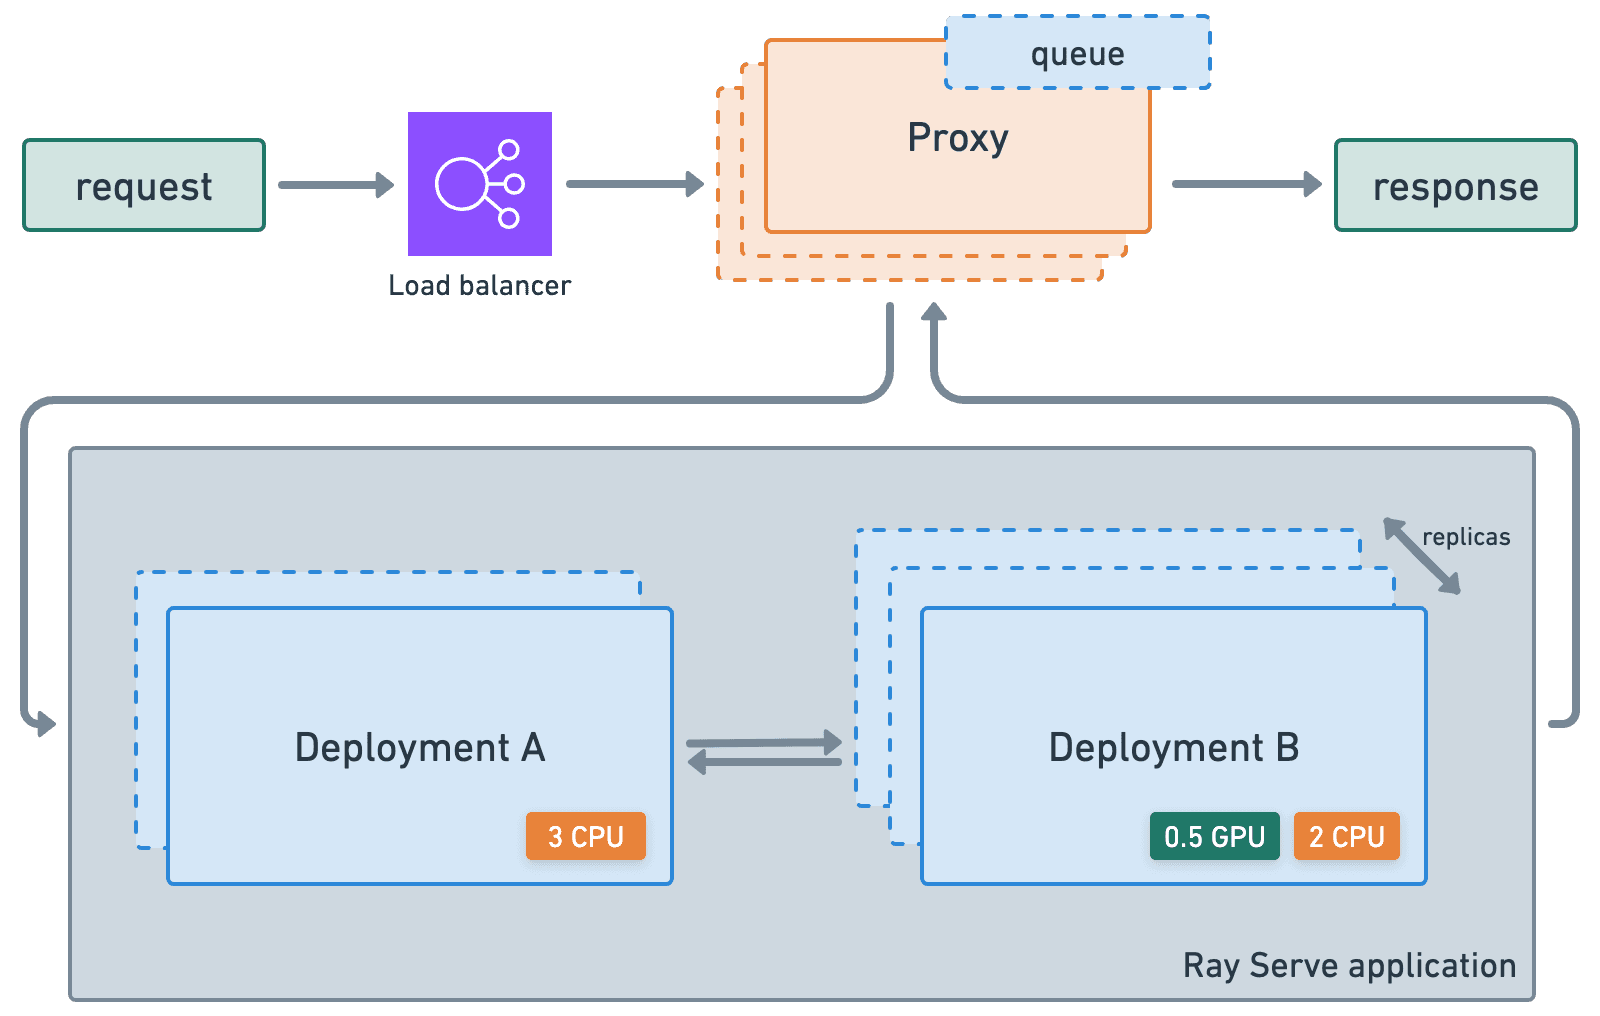
第三个 Notebook(03-Online-Serving.ipynb)演示了如何将训练好的模型通过 Ray Serve 部署为低延迟 REST API。
技术细节:
fastapi:app + starlette 构建 HTTP 接口,接收 base64 编码的图片请求configs/service.yaml)定义服务副本数、GPU 分配策略关键代码:
# Ray Serve 部署类
@serve.deployment(num_replicas=1, ray_actor_options=dict(num_gpus=1, accelerator_type="T4"))
class ClassPredictor:
    def __init__(self, model_id, artifacts_dir, device="cuda"):
        # 加载 MLflow 注册的模型
        self.predictor = mlflow.pyfunc.load_model(
            model_uri=f"models:/{model_id}/Production"
        )

    async def __call__(self, request: Request):
        image = Image.open(BytesIO(await request.body()))
        return self.predictor.predict(image)
项目将所有共享代码封装在 doggos/ 子模块中:
| 模块 | 职责 |
|---|---|
doggos/data.py | 数据预处理(图片加载、CLIP embedding、标签映射) |
doggos/model.py | PyTorch 模型定义、collate_fn(动态padding) |
doggos/embed.py | 图片 embedding 工具类 EmbedImages |
doggos/infer.py | TorchPredictor 推理封装 |
doggos/train.py | 训练相关逻辑 |
doggos/serve.py | Ray Serve 部署类(含 ClassPredictor) |
doggos/utils.py | 图片 URL → numpy array 工具函数 |
这种设计使三个 Notebook 的核心逻辑保持简洁,业务开发者无需关心底层实现细节,只需调用 doggos 提供的高级 API。
本项目的最大局限是它与 Anyscale 平台的高度绑定:
anyscale/ray:2.48.0-slim-py312-cu128 镜像,依赖 Anyscale 定制版 Rayconfigs/*.yaml)中的 image_uri 均指向 anyscale/ray:* 前缀镜像pyproject.toml 中 Ray 的来源指向 localhost:9478(Anyscale 内部 PyPI 镜像)三个工作负载均需要 GPU——即使是最轻量的批量推理,也需要 T4 以上显卡才能运行。对于没有 GPU 资源的小团队,这个项目的上手门槛不低。
项目以 Jupyter Notebook 形式交付,虽然便于学习,但 Notebooks 的代码复用性差、测试困难,不适合直接用于生产 CI/CD 流水线。
项目未声明开源 License,使用前需注意法律风险。
anyscale/multimodal-ai 的核心价值不在于代码本身,而在于它展示了一种正确的 AI 工程化思维方式:
对于正在从"Jupyter 实验"向"生产 AI 系统"过渡的团队,这个项目是绝佳的参考模板——它展示了如何用 Ray 把一个 Notebook 实验变成可以在数千 GPU 上稳定运行的生产级工作流。
访问 console.anyscale.com,选择对应模板,即可获得预配置好的 GPU 集群和运行时环境,全程浏览器操作,无需本地配置。
# 克隆仓库
git clone https://github.com/anyscale/multimodal-ai.git
cd multimodal-ai

# 安装依赖(需 Python 3.12+ 和 CUDA 12.8+)
pip install -e .  # 安装 doggos 子模块
pip install torch==2.7.1 transformers==4.52.3 ray[data,serve,train,tune]

# 运行单个 Notebook
jupyter notebook notebooks/01-Batch-Inference.ipynb
| 场景 | 最低配置 | 推荐配置 |
|---|---|---|
| 批量推理(单卡) | NVIDIA T4 (8GB) | RTX 3090 / A10G |
| 分布式训练(多卡) | 2× T4 | 4× A100 40GB |
| 在线服务(低延迟) | T4 | A10G |
本报告基于 GitHub 仓库 v111 ⭐ 分析生成,参考默认分支 main(最后更新:2026年)。
