
serving-pytorch-models
alvarobartt/serving-pytorch-models加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:深夜加班,外卖软件给你推送了一张汉堡照片——它是怎么在零点几秒内就判断出"这货是汉堡"的呢?
答案很可能就是 TorchServe。这是 PyTorch 官方出品的模型推理框架,能把训练好的 PyTorch 模型快速部署成 REST API,让任何能发 HTTP 请求的系统都能调用 AI 能力。
而 serving-pytorch-models 这个项目,就是一个完整的"手把手教学"——从训练一个图像分类模型,到用 TorchServe 把模型变成 HTTP 接口,全流程跑通。
做过 AI 项目的同学都知道,训练模型只是第一步。把模型变成产品,让它真正发挥作用,才是更大的挑战。
一个常见的坑是:数据科学家用 Jupyter Notebook 训练了一个准确率 95% 的模型,但工程团队却不知道该怎么把它接入线上系统。Python 脚本直接跑?太慢了。改成微服务?又得重写一堆代码。
TorchServe 就是来解决这个问题的——它把模型推理封装成标准 REST API,数据科学家不需要懂 Docker 和微服务架构,也能让模型上线。
这个项目的作者 alvarobartt(Alvaro Bartolome)是个西班牙的 ML 工程师,他把自己用迁移学习训练美食分类模型并部署的全过程开源出来,写成了教程,帮助更多 ML 从业者少走弯路。
整个项目拆成四步,每一步都有完整代码:
项目用的是 Food101 数据集的"精简版"——从 101 类美食中选了 10 类(Hamburger、Sushi、Pizza、Steak……),共 750 张训练图和 2500 张测试图。数据已经过预处理,最大边长统一缩放到 512 像素。
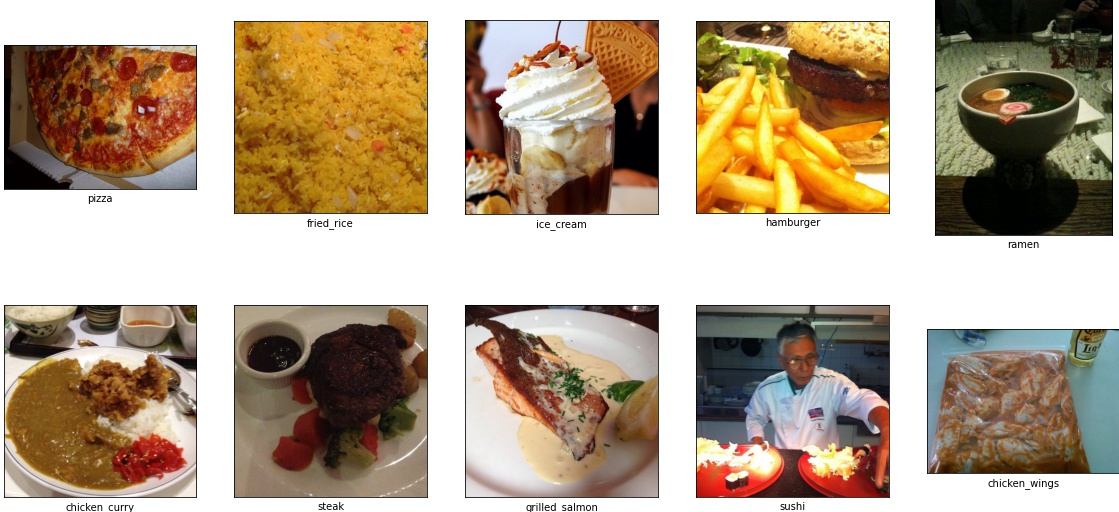
图:数据集示例(10 类美食图像)
模型骨架用的是 PyTorch 内置的 ResNet18,在 ImageNet 上预训练的权重直接拿来用——这叫"迁移学习"。只替换最后一层全连接层(fc),把输出从 1000 类改成 10 类,然后用自己的美食数据集微调。
训练代码在 notebooks/transfer-learning.ipynb,核心逻辑简洁清晰:
param.requires_grad = False),只训练最后一层Linear(512→128) → ReLU → Dropout(0.2) → Linear(128→10) → LogSoftmaxTorchServe 有自己的模型格式——.mar 文件(Model Archive)。用 torch-model-archiver 工具,把模型架构、权重、推理处理器、类别映射文件打包成一个包:
torch-model-archiver --model-name foodnet_resnet18 \
    --version 1.0 \
    --model-file model/model.py \
    --serialized-file model/foodnet_resnet18.pth \
    --handler model/handler.py \
    --extra-files model/index_to_name.json
推理处理器(handler)只有 5 行代码——直接继承 TorchServe 内置的 ImageClassifier,设置 topk=10 返回置信度最高的 10 个分类结果。
项目提供了 deployment/Dockerfile,基于 Ubuntu 镜像,一键构建 TorchServe 运行环境:
docker build -t ubuntu-torchserve:latest deployment/
docker run --rm --name torchserve_docker \
    -p8080:8080 -p8081:8081 -p8082:8082 \
    ubuntu-torchserve:latest \
    torchserve --model-store /home/model-server/model-store/ \
               --models foodnet=foodnet_resnet18.mar
启动后自动暴露三个 REST API 端口:
推理调用示例:
curl -X POST http://localhost:8080/predictions/foodnet -T sample.jpg
# 返回:
# {"hamburger": 0.691, "grilled_salmon": 0.110, "pizza": 0.039, ...}
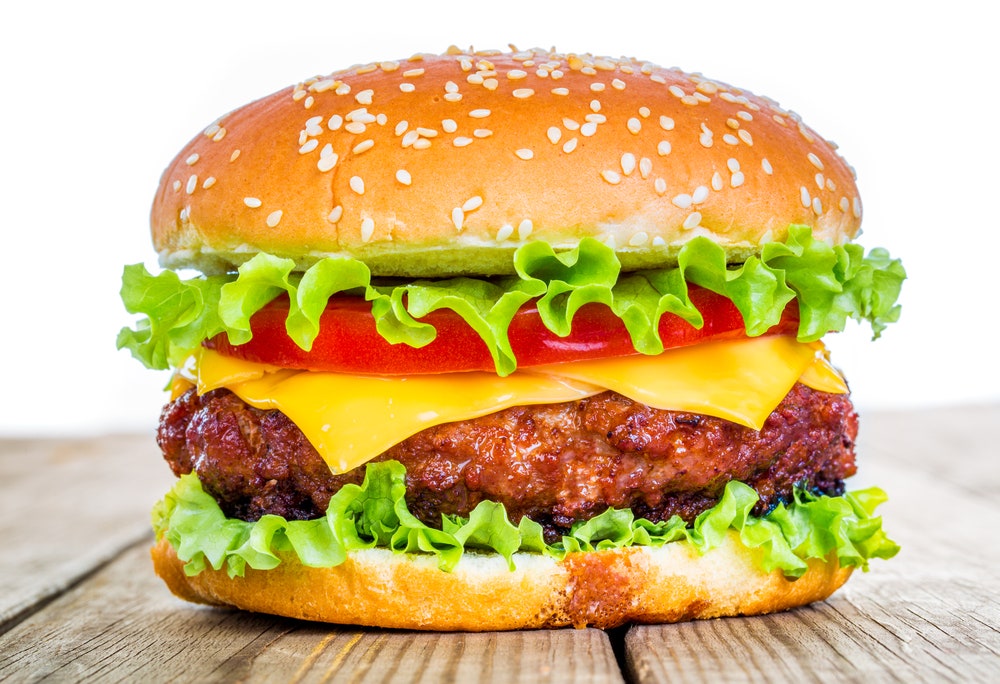
图:示例图片及推理输出(识别为汉堡,置信度 69.1%)
这是一套经典的 MLOps 部署架构——模型作为独立服务运行,通过 HTTP 接口与业务系统解耦。
| 层级 | 技术选型 |
|---|---|
| 深度学习框架 | PyTorch 1.7.0 |
| 模型服务框架 | TorchServe 0.2.0 |
| 预训练模型 | ResNet18 (ImageNet 权重) |
| 训练数据 | Food101 (10-class slice) |
| 容器化 | Docker (Ubuntu base) |
| 运行时依赖 | Java JDK 11 (TorchServe 必需) |
| 文档/实验 | Jupyter Notebook, README |
项目代码量不大,但结构清晰。model/ 目录存放模型相关文件,deployment/ 存放部署配置,职责划分明确。README 文档覆盖完整流程,有配套 Medium 博客文章延伸阅读。
不足之处:
项目 README 开头就写了 WARNING:"TorchServe is experimental and subject to change." 实际上 TorchServe 在 2022 年才从 PyTorch 孵化项目毕业正式发布。在此之前,生产环境用 TorchServe 还是 BentoML、Ray Serve、Triton Inference Server 等替代方案,是需要认真评估的。
torchserve==0.2.0 搭配 torch==1.7.0 是 2020 年的版本组合。如果用新版本的 PyTorch 模型(2.0+ 的 torch.compile、新的模型格式),存在兼容性问题。项目长期未更新维护,依赖安全漏洞也是隐患。
项目只演示了单机单模型部署。在实际生产中,你可能需要多模型共享 GPU 资源、A/B 测试不同模型版本、自动扩缩容——这些高级功能在当前项目中都没有涉及。
| 维度 | 评估 |
|---|---|
| 编程基础 | 需要 Python 基础,了解 PyTorch 基本用法 |
| ML 知识 | 理解迁移学习、ResNet 架构 |
| DevOps 能力 | 熟悉 Docker 基本操作(build / run) |
| 硬件要求 | 训练推荐 GPU,推理 CPU 即可 |
docker build + docker run,2 分钟体验 TorchServe 推理pip install torchservenotebooks/transfer-learning.ipynb,替换成自己的数据集这个项目是 MLOps 工具链的一个切面——展示了 TorchServe 这一环的用法。如果你在构建完整的 ML 平台,它可以和 MLflow、Weights & Biases、DVC、Kubeflow 等工具组合使用。
作为学习资料,它的价值在于够小、够完整——用最少的代码展示了端到端流程,值得初学者跑一遍体验模型服务的全貌。
项目 GitHub:https://github.com/alvarobartt/serving-pytorch-models | License: MIT | Stars: 102
