
x-deeplearning
alibaba/x-deeplearning加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
假设你要为电商做点击率预测:用户有几千个行为特征,商品有几千个属性特征,广告上下文还有上百个统计特征。把这些特征全部 One-Hot 展开后,模型参数量轻松冲到千亿级别,训练样本动辄万亿条。
这时候 PyTorch 和 TensorFlow 都会遇到同一个问题——稠密计算没问题,稀疏计算全是浪费。稀疏参数中绝大多数取值只出现在极少数样本里,若按稠密方式存储,99% 的显存和算力都在乘以零。更糟的是参数服务器架构下,稀疏参数的"拉取-聚合-回传"三段式通信会成为绝对的瓶颈:GPU 算力空转,等参数。
2018 年底,阿里妈妈把这个场景连同解决方案一起开源了,这就是 X-DeepLearning(简称 XDL)——号称阿里开源的第一个深度学习框架,也是全球最早公开的、面向稀疏场景全栈优化的工业级 DL 框架之一。
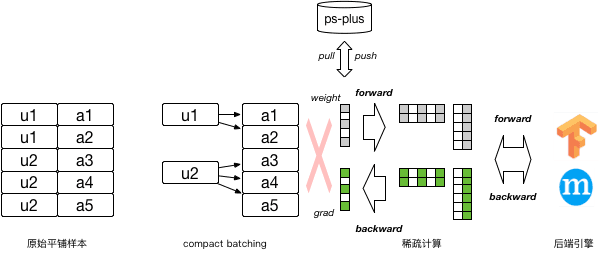
XDL 不是一个"类 PyTorch 的训练库",而是一套横跨训练到在线服务的完整方案。仓库根目录的结构直接映射了它的四层定位:
| 模块 | 作用 |
|---|---|
xdl/ | XDL 训练引擎:C++/CUDA 核心 + Python 绑定层 |
xdl-algorithm-solution/ | 算法解决方案:DIN、DIEN、ESMM、TDM 等模型实现 |
blaze/ | Blaze 高性能推理引擎(ULF 模型格式 + 在线服务) |
xdl/ps-plus/ | PS-Plus 参数服务器(自研 PS 组件) |
技术上,XDL 的核心是混合计算架构:把模型计算显式拆成稀疏部分与稠密部分,稀疏部分由自研参数服务器托管,配合 GPU 加速与参数合并通信优化;稠密部分走常规 DNN 计算路径。
xdl/xdl/core/ops/ 目录下 50 多个算子实现,稀疏相关的味道非常浓:merge_sparse_op、add_sparse_gradient、emb_take、take_grad、feature_mask_op、simple_unique_op——这是行业里少见的、专门为稀疏 embedding 生命周期设计的算子集合。
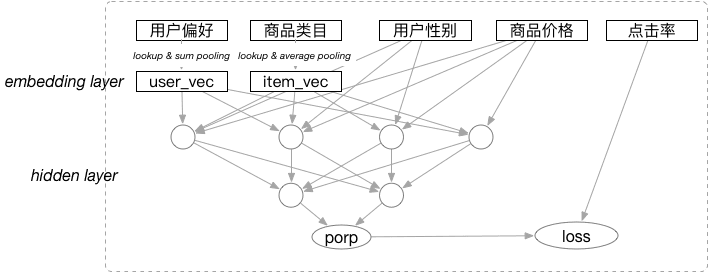
这是 XDL 最有工业含量、也最容易被忽略的部分。稀疏特征模型真正难的地方不是算得快,而是参数表不能无限膨胀——几亿个特征 ID 的 embedding 总有一天会把集群撑爆。
XDL 1.2 版本提供完整的流式训练能力:
python/training/feature_expire.py、hash_filter.pycounting 相关算子支撑实时热门度统计Python API 层的设计也能看出这一点:training/ 目录下有 train_session.py、increaser.py、optimizer_impls.py、export.py、saver.py、trace.py——这是典型的在线/流式训练控制面,而非常见的"fit() + evaluate()"静态 API。
从代码看,XDL 还通过 xdl/core/backend/ 下的 mxnet 与 tf 两个后端适配层,与 MXNet 和 TensorFlow 生态打通;xdl/python/model_server/ 提供模型服务封装。这意味着它当时更像一个"稀疏场景加速层",可以挂在主流框架之上,也可以用自带的 framework/session.py + variable.py 全原生方式使用。
这里必须诚实——XDL 是 2018-2019 年代的工业级 C++/CUDA 项目,上手难度显著偏高:
编译环节
_GLIBCXX_USE_CXX11_ABI=0(老 ABI,编译告警多)环境陷阱
xdl/docker/Dockerfile 基于 ubuntu:16.04 单阶段构建,需从 SourceForge 下载 Boost 源码、从 NVIDIA 源安装 CUDA 9.0,属于"重量级重镜像"而非开箱即用镜像文档与社区
综合评估:部署难度"困难"(4/5),预计 2-6 小时,且需要具备 C++ 编译与 CUDA 环境配置经验的算法工程师。
XDL 的技术设计并不落后,但生态竞争失利:
EmbeddingBag + HashTable、Frugal、TensorRec)就能吃掉 80% 的需求但它的设计思想依然被广泛继承:稀疏 embedding 分片、参数合并通信、特征准入淘汰、流式增量训练,这些今天在 Meta 的 TorchRec、字节的 BytePS、腾讯的 Angel 都能看到相似的影子。
XDL 的真正价值在于它是一个历史标本——它完整记录了 2018-2019 年中国互联网大厂在推荐系统深度学习基础设施上的自主突破路径。
| 维度 | 评价 |
|---|---|
| 技术价值 | 高:稀疏场景全栈方案的完整度在当年业界罕见 |
| 教学价值 | 高:中文文档完备,是学习稀疏训练与 PS 架构的优质源码 |
| 直接生产可用性 | 低:依赖版本老旧、社区停更 |
| 推荐使用方式 | 源码研读 + 局部移植(PS-Plus、稀疏算子、准入淘汰逻辑) |
给开发者的建议:如果你的目标是构建新的稀疏推荐训练系统,优先看 TorchRec / BytePS / Angel;如果目标是理解"工业级稀疏训练框架到底要写多少代码",XDL 是极好的教材——它把那些通常被隐藏在框架黑盒里的通信优化、特征生命周期管理、模型增量导出全部摊开给你看。
xdl/LICENSE 双许可声明)