ai-memory
akitaonrails/ai-memory加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
图:ai-memory 项目 Logo(GitHub 仓库 docs/logo.png)
设想这样一个再普通不过的工作日。你用 Claude Code 花了两个小时重构支付服务的鉴权模块,中途它试了三种方案、两种失败了,你也在对话里反复纠正了它的文件命名偏好。下午你换到 Codex 继续写——然后你发现,之前的一切归零。Codex 不知道你的项目用 snake_case,不知道 staging 先行,不知道刚才那两种方案为什么被否掉。你只好再讲一遍。
这不是某个产品的缺陷,而是当前 AI 编程工具的结构性问题:每个智能体都自带一块"记忆",但那块记忆被锁死在单机、锁死在单个工具里。 Claude Code 有自己的 notes,Cursor 记一些零散的事故,各家都在加记忆功能,但它们互不相通,也带不出你的团队。
akitaonrails/ai-memory 要做的,就是把这块记忆从智能体内部抽出来,做成一个共享层。
ai-memory 是 Fabio Akita(AkitaOnRails)于 2026 年 5 月创建的开源项目,截至当前已积累 12,300+ Star、870+ Fork,采用 MIT 协议,主语言是 Rust,版本号已迭代到 3.2.0。
它是一个单一自包含二进制,跑起来后同时扮演三个角色:
http://<host>:49374/mcp 暴露标准 MCP 接口,任意 MCP 客户端都能接入数据流是 capture → consolidate → recall → handoff 四段式:钩子静默观察 → 会话结束整合为 Wiki 页面 → 下次会话检索(全文、实体、链接、可选向量融合排序)→ 交接给下一个智能体。
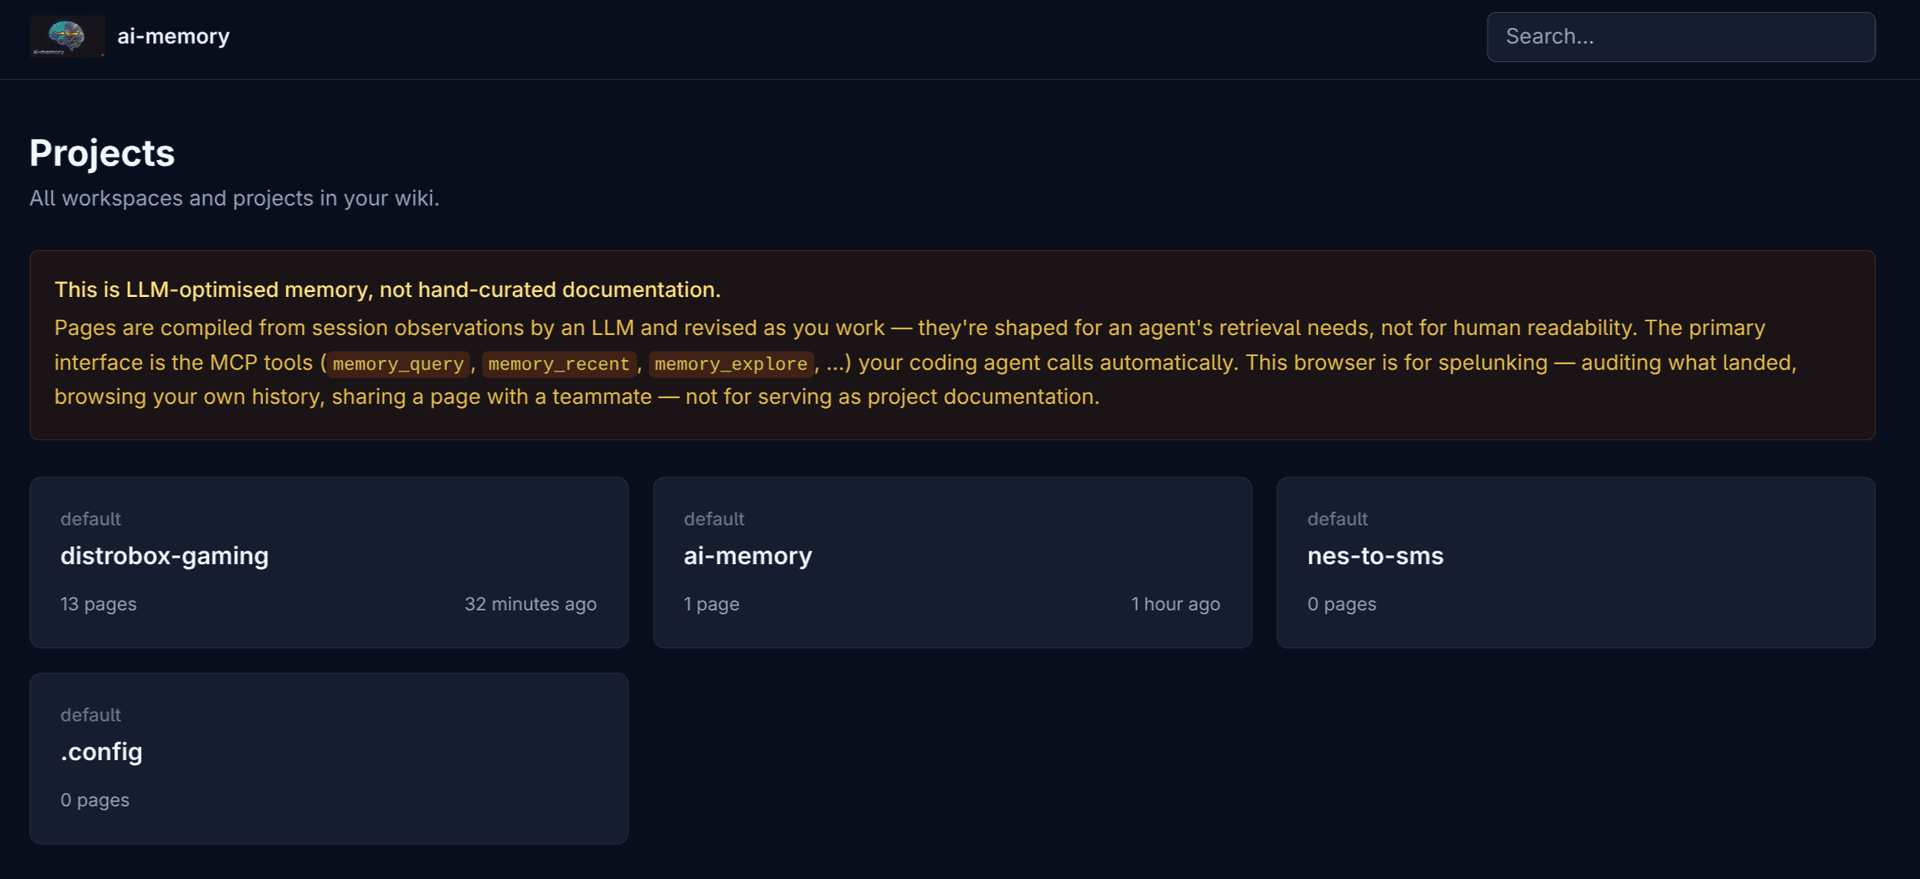
图:ai-memory 服务端渲染的管理控制台首页(GitHub 仓库 docs/web-projects-home.png)
这是整个项目最值得借鉴的取舍。绝大多数"AI 记忆"项目会把记忆塞进向量库或 SQLite 的事实行里,你只能用工具接口去读。而 ai-memory 的真相源是一棵 Git 版本管理的 Markdown 目录:
grep 它、用 Obsidian 打开它、手工编辑它、用 rsync 同步它而 SQLite 那一侧依然很扎实:FTS5 全文检索、词法实体抽取、链接邻居扩散、可选的本地向量,四路信号融合成一个排序结果。
跨智能体、跨项目、跨机器、跨团队是它反复强调的四个"follow you":
零 LLM 依赖是默认路径。 捕获、检索、交接三件事在没有 API Key 的情况下全部可用——页面整合用抽取式压缩、近重复折叠(DBSCAN 冷簇去重)、矛盾标记等纯算法手段完成,零 API 调用。分层的记忆衰减曲线按 tier 独立配置,且"被用过的记忆衰减更慢"——打开、检索、点链接近似都算使用。只有当你自己配了 LLM,才可以开启那个叫 "dream" 的后台整合:把冷簇笔记重写成连贯页面,源文件永不删除,合并前版本仍可回溯。
其他值得一提的能力:可选的 management-ui 特性(Askama + Tailwind)提供服务端渲染的管理控制台,支持用户管理、会话查看与删除、个人 MCP API Key;跨智能体的 run 启动器支持 workstream 租约(lease)与断点续接,甚至能在配额耗尽等突发退出场景下,用一份本地临时投影把上一个 harness 的可见历史交给下一个智能体。
门槛分两档,取决于你走哪条路。
原生安装(Linux / macOS),两条命令:
curl -fsSL https://github.com/akitaonrails/ai-memory/releases/latest/download/install.sh | sh
ai-memory setup
install.sh 会下载对应系统与 CPU 的 release,校验 SHA-256 后才安装(不匹配直接拒绝),并链接到 ~/.local/bin/ai-memory。setup 会建数据目录、生成 owner-only 权限的 bearer token、注册 per-user 服务(systemd --user 或 launchd LaunchAgent),然后扫描本机已装的 agent 并为每个写入 MCP 与 hook 配置。它会先打印计划再动手:--plan 只看不改,--web 在浏览器里勾选,--yes 跳过询问。
Docker,一条 docker run 即可,镜像已发布 linux/amd64 与 linux/arm64 双架构,Apple Silicon 不用模拟:
docker run -d --name ai-memory --restart unless-stopped \
  -p 127.0.0.1:49374:49374 -v ai-memory-data:/data \
  docker.io/akitaonrails/ai-memory:latest
此外还提供:Windows PowerShell 脚本(install.ps1)、WSL2、Arch AUR(预编译与源码两个包)、Fedora RPM、NixOS 模块(带 ProtectSystem=strict 的强化 systemd 沙箱)、macOS 菜单栏 App(需自备 Rust 工具链与 Xcode/Swift 6 构建)。
真正上手后的关键命令其实只有几个:ai-memory run claude(推荐的启动方式,首次会自动装好该 harness 的 hook 与 MCP)、ai-memory continue(续接最新的 managed checkout)、ai-memory resume --search auth(按名检索 workstream)、ai-memory uninstall --apply(干净卸载,只删自己装的东西)。
从源码构建需要 Rust 1.95+,仓库用 Cargo workspace 分了 11 个 crate:core、store、wiki、mcp、hooks、llm、consolidate、web、cli、workstream 加一个测试辅助 crate。
不回避问题的部分:
SECURITY.md 写得很直白:它支持多用户归属,但所有已认证用户属于同一信任域,可以读取同一项目的记忆。跨团队共享在受信团队内没问题,但不能当成严格的租户隔离平台用。embedding_provider 从默认的 local 改成云端,会触发对既有全量语料的回填——也就是说,几个月前只在本地存过的内容会被retroactively 发到云 API。审阅时这点必须提前确认。AI_MEMORY_AUTH_TOKEN、防火墙或 TLS 反代兜住。ai-memory 的 star 曲线本身就是一个信号。2026 年 8 月下旬的 24 小时内,它从 3,220 star 涨到 3,556(约 +10.4%),到 10 月已突破 12,000。这种增速说明**"Agent Memory"正在成为独立的一层基础设施**,而不只是某个 IDE 插件里的附属功能。
从技术选型看,它代表了一条与主流不同的路线:不用向量库当真相源,而是用 Git 管理的 Markdown 当真相源、数据库只做派生索引;默认零 LLM 调用,把 LLM 能力做成可选项而非依赖项。 相比 Mem0 那种事实行抽取、Zep/Graphiti 的时序知识图谱、basic-memory 的纯文件优先,ai-memory 的差异是"跨 agent 的 claim-once 交接协议 + 团队级共享 + 零 LLM 默认"。
它的作者公开承认站在 Karpathy 的 LLM Wiki、basic-memory、cognee、A-MEM 等项目的肩膀上,并且项目 README 里把 Hermes Agent 也列为借鉴来源之一——这本身说明这个赛道正在快速互相借鉴、互相融合。
值得立刻试:每天在两个以上 AI 编程工具间切换的人;带小团队且希望知识沉淀在团队而非个人笔记本的人;担心"记忆内容进云 API"的合规敏感团队(默认全本地、零遥测、无 LLM 依赖)。
建议先观望:需要跨租户强隔离的企业场景;无法接受"Markdown 即真相"这种可被随手编辑的信任模型;团队已有统一向量库基础设施的团队。
对大多数开发者而言,最短验证路径是:先在单机用 install.sh 装好,跑 ai-memory setup --plan 看看它识别到了哪些 agent,选一两个接上,然后在 Claude Code 里问一句 "What do you remember about this project?",看它答得准不准。这个成本极低,但足以判断它是否值得进入你的工具链。
仓库信息速览
| 项目 | 值 |
|---|---|
| 仓库 | akitaonrails/ai-memory |
| Star / Fork | 12,300+ / 870+ |
| 贡献者 | 160 |
| 主语言 | Rust(20.2 MB) |
| 协议 | MIT |
| 当前版本 | 3.2.0 |
| 首次提交 | 2026-05-21 |
| 最近更新 | 2026-10-21 |
| 官网 | aimemory.sh |
