
browserytools
aghyad97/browserytools加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你手里有一份需要脱敏的会议录音、一张要抠出人像的产品图、一段要翻译的合同条款。你把它们拖进一个网页,然后——什么都没发生。因为没有弹窗问你"是否上传",没有进度条跑到某个陌生服务器,也没有转圈等待。文件就在你自己的电脑里被处理完了。
这就是 aghyad97/browserytools 的全部卖点。它不是一个工具,而是一个工具箱:152 个纯浏览器端运行的在线工具,覆盖图像处理、PDF 与 Office 文档、音视频转码、文本处理、开发者工具和端侧 AI 六大类。官网 browserytools.com 已经上线并提供 17 种语言界面(含阿拉伯语、波斯语两种从右到左布局)。
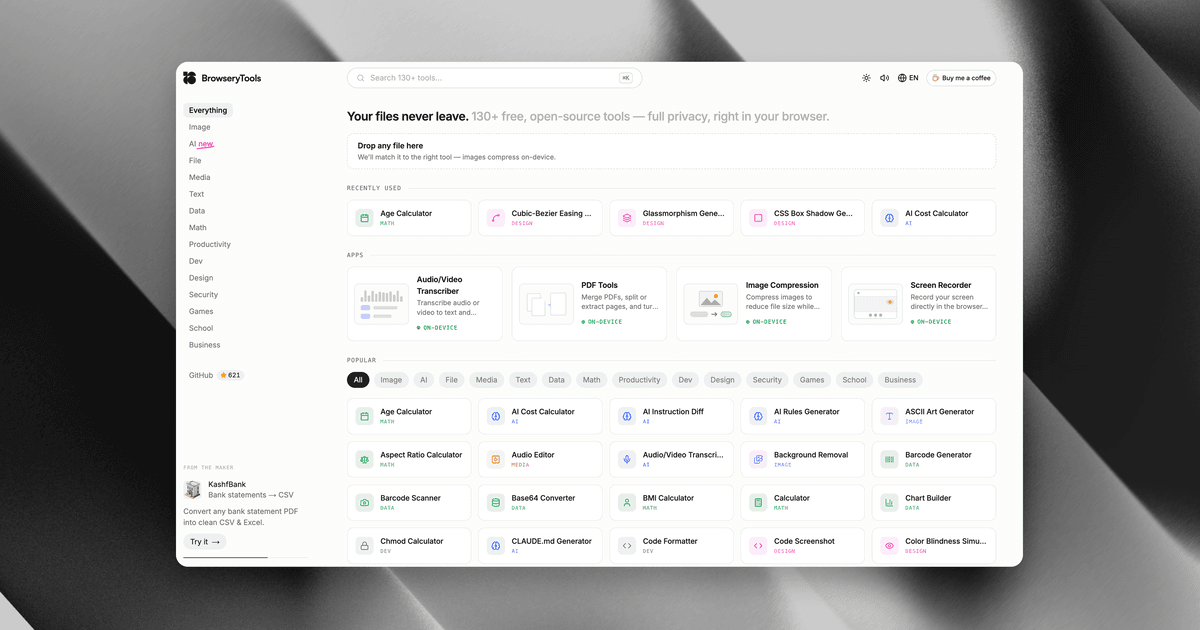
这不是营销话术,而是有明确技术路径的选择。项目的技术栈是 Next.js 16 App Router + TypeScript + Tailwind CSS + Shadcn/Radix UI,2177 个仓库文件中有 1999 个在 src/ 下,核心结构是「一个工具注册表(src/lib/tools-config.ts)+ 一个工具页面(src/app/[locale]/tools/[slug]/page.tsx)+ 一个工具组件(`src/components/[ToolName].tsx)」的三段式。
真正撑起"本地处理"的是几条独立的第三方链路:
pdf-lib 负责合并拆分与生成,pdfjs-dist 负责解析,mammoth 做 PDF→Word 的结构还原,docx 负责 Word→PDF,文件全程不离开浏览器。@ffmpeg/ffmpeg + @ffmpeg/core(ffmpeg.wasm)完成转码与压缩,jassub 负责把字幕烧录进视频画面。@jsquash/avif 负责现代格式编码,html2canvas 负责截图美化,@svgdotjs/svg.js 负责矢量编辑,@diffusionstudio/vits-web 提供神经声码器做语音合成。tesseract.js 编译到 WebAssembly,语言数据包首次从 Tesseract CDN 拉取。@huggingface/transformers v4(Transformers.js)+ onnxruntime-web 1.21,把 Hugging Face 上的模型直接跑在浏览器里。
src/lib/hf-pipeline.ts 是全部 AI 工具的公共入口,它做了三件关键的事:用动态 import() 加载 Transformers.js,保证几十 MB 的 onnxruntime-web 不进主包;按 task::model::device::dtype 缓存 pipeline 实例避免重复加载;通过 progress_callback 汇总各文件下载进度,向用户暴露真实的下载百分比。
更有价值的是 src/lib/on-device-models.ts —— 它把 11 个模型的真实字节数逐个记录下来(数据来自 HuggingFace Hub 的 ?blobs=true API,每条都注明了来源 URL),并在下载前就告知用户"这个模型要拉 82 MB"。更妙的是它解释了同一个模型在 WebGPU 和 WASM 下体积为何不同:未固定 dtype 时,Transformers.js 在 WebGPU 上默认取 fp32 全精度权重,在 WASM 上取 q8 量化权重,体积差好几倍;而显式固定 dtype(如翻译器固定 q8、SAM 固定 fp16)的工具则两种环境下载同一份文件。
覆盖的模型包括 Whisper(语音转写、SRT/VTT 字幕)、M2M100-418M(16 语言互译)、BERT-base-NER(PII 检测脱敏)、DistilBERT-SST2(情感分析)、DeBERTa-v3-xsmall(零样本分类)、DistilBART-cnn-6-6(摘要)、Swin2SR(2 倍超分)、ViT-GPT2(图像描述)、Depth-Anything-v2-Small(深度图)、SlimSAM-77(物体抠图)、ISNet(背景移除)。
项目还专门写了 docs/ 里的说明文档解释"模型从哪来、跑在哪",并坦白列出代价:浏览器里的模型比 API 小得多也慢得多,一小时音频转写要跑真实时间,没有 WebGPU 的机器会更慢,量化必然带来精度损失,标签页内存上限决定了长文档和长音视频会先撞墙。
部署本身很轻:Node.js 20+ 与 Bun(或 npm/yarn/pnpm),bun install && bun dev 即可跑起来,构建产物是标准 Next.js 服务,vercel.json 已就绪,官方生产环境就跑在 Vercel 上。仓库里没有 Dockerfile、docker-compose 或 k8s 清单,容器化需要自己补。
AI 工具对硬件有隐性要求:浏览器需支持 WebGPU(Chrome/Edge 及较新的 Safari)才能走 GPU 路径,否则回落到 CPU/WASM,性能差距明显。首次使用任一 AI 工具会触发数十到数百 MB 的模型下载。
作者也在 README 里主动交代了两个"不本地"的例外:实时听写走浏览器 Web Speech API,Chrome/Edge 会把音频送到浏览器厂商的服务器做识别,敏感内容别用;货币换算调用外部汇率 API。
值得肯定的:CI 相当扎实——validate-tools 配置校验、ESLint、Vitest 单测、Next 构建、Playwright 全工具冒烟测试五步串联,仓库内有 184 个测试文件(含 9 个 e2e spec);国际化采用单一 LOCALES 注册表驱动,语言切换、<html lang/dir>、hreflang、sitemap、OpenGraph 全部从注册表派生,且有测试保证注册语言不会出现"半接线"状态;AGPL-3.0 许可清晰,README 用一小段白话解释了"改造成网络服务必须开放源码"的具体含义。
需要保留意见的:项目高度集中在一位作者身上(aghyad97 贡献了 179 次提交中的 173 次,contributors 列表只有 3 人),Bus factor 接近 1;package.json 里同时引入了 @imgly/background-removal-node 这个服务端变体,与"全客户端"的定位不符,无论是有意为之还是遗留依赖,都值得追问;AGPL-3.0 对二次开发者的约束比 MIT/Apache 严格得多,企业内网自建场景需要评估合规影响;端侧模型的下载体积在移动网络下对用户是实打实的成本,虽然项目已做透明披露,但体验上仍是"第一次很慢"。
BrowseryTools 属于 2024 年以来清晰可见的一条趋势线:浏览器正在成为 AI 的运行时。WebAssembly SIMD 负责 CPU 推理,WebGPU 把笔记本里闲置的 GPU 交给 Web 页面,配合模型蒸馏与量化让"能在标签页里跑的模型"从荒诞变成日常。项目的收藏页把这件事讲得很直白——过去几年模型变小了、浏览器变强了,两件事叠加才有了这一整类工具。
它给行业的启示是双重的:一方面,隐私敏感场景(医疗录音、法务记录、客户访谈、内部截图)第一次有了零 API Key、零计费、无限流的可行路径;另一方面,它也划出了边界——数据中心的 GPU 在几乎所有质量指标上仍然碾压浏览器里的量化模型,需要最强质量、长上下文、低延迟时,仍然得走托管 API。两者是互补关系:先在本地脱敏、��在本地转写,再把处理过的内容送去云端总结;本地分类分流,把难例升级。
从产品角度看,它还做对了一件容易被忽略的事:把"上传你的文件"这个动作本身消灭掉。对绝大多数人而言,拖文件进网页 = 数据泄露风险,无论网站声称多安全。当处理发生在本地,这个心理门槛直接归零。这大概才是 705 个 star、81 个 fork 的真正来源。
项目信息速览
| 项目 | BrowseryTools |
|---|---|
| 仓库 | aghyad97/browserytools |
| Star / Fork | 705 / 81 |
| 许可证 | AGPL-3.0 |
| 主语言 | TypeScript |
| 工具数量 | 152 个,覆盖 17 种语言界面 |
| 提交数 / 贡献者 | 179 次提交 / 3 位贡献者 |
| 测试 | 184 个测试文件(Vitest 单测 + Playwright e2e) |
| 官网 | https://browserytools.com |
