
Zonos
Zyphra/Zonos加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
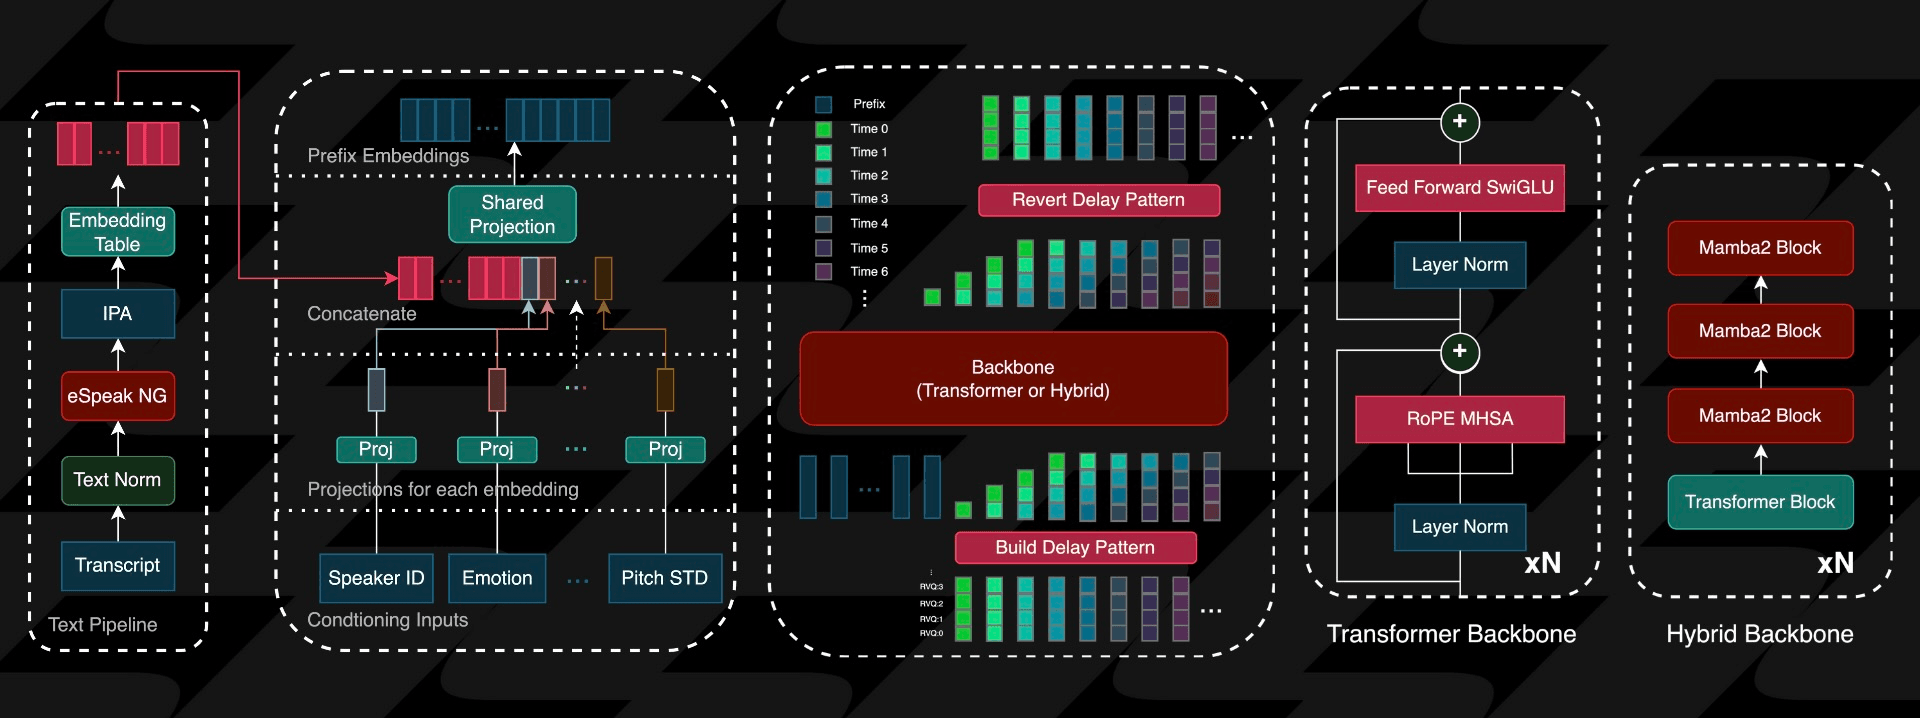 Zonos 模型推理流程:文本经 eSpeak 标准化和音素化后,由 Transformer/Hybrid 主干预测 DAC 音频 tokens,最后由 DAC 自编码器解码为 44kHz 高保真语音
你是一个独立开发者,想为自己的播客应用配上 AI 配音。现有方案要么声音机械得像「新闻联播」,要么月费贵到离谱,还有的根本不支持中文。更要命的是——你想克隆自己或朋友的音色,让 AI 说出一口带感情的方言,目前开源社区几乎找不到开箱即用的方案。
2025年2月,Zyphra 团队发布了 Zonos-v0.1,用超过 20 万小时多语言语音数据训练的 1.6B 参数 TTS 模型,让上述痛点有了答案。
Zyphra 是一家专注于生成式 AI 的研究型公司,此前在开源社区已有一定知名度。Zonos-v0.1 是其正式进军语音生成领域的开山之作,Apache 2.0 开源许可意味着任何人——包括商业项目——都可以自由使用、修改和分发。
这不是一家盲目跟风的公司。Zyphra 团队选择了「双轨并行」的策略:同时发布 Transformer 版本 和 Hybrid(SSM)版本,将自然语言处理领域的两种主流架构同时引入 TTS 领域,这在开源 TTS 项目中尚属首次。
只需提供一段 5-30 秒的参考音频,Zonos 就能提取说话人的声音特征(speaker embedding),用这个音色朗读任意文本。这不是简单的「变声」,而是真正的声纹克隆——韵律、口音、语调全部保留。
更进一步,Zonos 还支持 音频前缀(audio prefix) 输入:你可以给模型一小段参考音频,加上你想让 AI 模仿的说话风格(比如轻声细语或慷慨激昂),模型会将两者融合,生成既有对应音色又符合指定风格的语音。
Zonos 支持对生成音频的多个维度进行精细调节:
| 控制维度 | 说明 |
|---|---|
| 语速(speaking rate) | 从极慢到极快,共 8 档 |
| 音高变化(pitch std) | 控制语调起伏幅度 |
| 最高频率(fmax) | 限制输出音频上限频率 |
| 音频质量(DNSMOS) | 调节整体音质清晰度 |
| 情绪(Happiness/Anger/Sadness/Fear) | 四种情感方向独立控制强度 |
当前版本支持 英语、日语、中文、法语、德语 五种语言,未来计划扩展更多语言支持。
原生输出 44kHz 高保真音频,远超 CD 音质的 44.1kHz 标准。相比业界常用的 16kHz 或 24kHz 输出,Zonos 的音质天花板明显更高。
在 RTX 4090 上,Zonos 实现约 2 倍实时因子(real-time factor ~2x),即生成 2 秒音频只需 1 秒计算时间。首音频延迟(TTFA)约 200-300ms,交互体验在可接受范围内。
Zonos 的架构清晰,分为三个阶段:
第一步:文本标准化与音素化 通过 eSpeak 将输入文本转换为音素序列。这一步处理了大小写、标点、数字等文本规范化问题。
第二步:音频 token 预测 Transformer 主干(或 Hybrid SSM 主干)接收音素序列和说话人 embedding,预测 DAC(Descript Audio Codec)音频 token 序列。模型输出 9 个 codebook 的 token,对应每秒 86 帧音频——即生成 1 秒音频需要预测 774 个 token。这是高精度带来的代价。
第三步:DAC 解码 9 组 token 经独立语言模型头解码,再由 DAC 自编码器还原为 44kHz 原始波形。
| 特性 | Transformer 版本 | Hybrid 版本 |
|---|---|---|
| 架构 | 标准 Transformer | Mamba2 SSM + Transformer 混合 |
| GPU 兼容性 | 任意 NVIDIA GPU(6GB+) | 需要 3000 系列或更新 |
| 推理速度 | 基准 | 更低延迟、更低显存 |
| 内存占用 | 较高 | 较低 |
uv run gradio_interface.py
一行命令启动浏览器界面,上传参考音频 → 输入文本 → 选择情感参数 → 下载生成的 wav 文件。所有参数可视化调节,无需写代码。
import torch, torchaudio
from zonos.model import Zonos
from zonos.conditioning import make_cond_dict

model = Zonos.from_pretrained("Zyphra/Zonos-v0.1-transformer", device="cuda")
wav, sr = torchaudio.load("reference.mp3")
speaker = model.make_speaker_embedding(wav, sr)

cond = make_cond_dict(text="你好世界", speaker=speaker, language="zh-cn")
codes = model.generate(model.prepare_conditioning(cond))
audio = model.autoencoder.decode(codes).cpu()
torchaudio.save("output.wav", audio[0], model.autoencoder.sampling_rate)
docker compose up
容器内已包含所有依赖(PyTorch、espeak-ng、CUDA 环境),开箱即用。
1. 首尾音频伪影 作者团队坦承,Zonos 在音频生成的首尾部分更容易出现咳嗽声、点击声、笑声、喘息声等伪影。这是自回归生成架构的固有问题,当前版本尚未彻底解决。
2. 文本对齐偶发错误 在分布外(out-of-distribution)句子中,模型偶尔会跳过某些词或重复朗读某些词,尤其在专业术语或罕见人名上表现不稳定。
3. 推理速度的代价 DAC 高保真编码每秒需生成 774 个 token,虽然有延迟模式和多 token 预测优化,但相比低码率方案(如 16kHz 输出)仍有显著速度差距。官方计划在后续版本中重点优化。
4. 容器内无法直接用 Hybrid 模型 docker-compose.yml 默认运行的是标准推理模式,Hybrid 模型(含 Mamba2 依赖)需要单独编译环境,在标准容器中无法直接启用。
Zonos-v0.1 的出现,填补了开源 + 高保真 + 情感可控 + 零样本克隆四个特性同时满足的空白。2025年2月发布后迅速获得数千 Stars,随后 Zyphra 在 2026 年 6 月推出更强大的 Zonos2(8B MoE 参数,支持 20+ 语言),进一步巩固了其在开源 TTS 领域的领先地位。
对于开发者而言,Zonos 提供了难得的「研究级」质量加上「产品级」易用性;对于 AI 爱好者,它让零成本克隆任意声音成为现实——无论是为个人视频配音,还是构建多语言有声书平台,Zonos 都是目前最值得一试的开源选择。
# 1. 克隆仓库
git clone https://github.com/Zyphra/Zonos.git
cd Zonos

# 2. 安装系统依赖(Linux)
apt install -y espeak-ng

# 3. Python 依赖
pip install -U uv
uv sync

# 4. 启动 Gradio WebUI
uv run gradio_interface.py

# 或 Docker 部署
docker compose up
