
VLM-MMA
ZjjConan/VLM-MMA加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有过这样的困惑:CLIP 这样的预训练大模型,能力很强,但用在自己任务上时,总是"手生"——要么把原本学到的通用知识给冲淡了,要么新任务怎么也学不精。这个问题在少样本学习场景下尤为突出:数据少、泛化难,两头不讨好。
CVPR 2024 论文 MMA(Multi-Modal Adapter) 就直击这个痛点。它由中山大学杨凌霄等人提出,设计了一种"多模态适配器",让视觉-语言模型(VLM)在微调时,既能保留通用知识,又能学到新任务的专有知识。这不是简单地加个 Adapter 层那么简单——MMA 深入分析了视觉分支和语言分支的特征分布差异,得出一个关键洞察:高层的 Transformer 块存储的是任务相关知识,低层存储的是可泛化知识;语言分支的特征比视觉分支更具判别性,且两模态在低层的语义差距最大。
基于这个发现,MMA 只在最顶部几层 Transformer 中插入适配器,用三个精心设计的投影层分别处理:文本适配器、视觉适配器,以及跨模态共享适配器。共享适配器负责把两边的特征对齐到一个共同空间,让梯度能够跨模态流动。整个架构轻量——默认只用 8 层(从第 4 到第 12 层),适配器维度 32,推理时几乎零额外开销。
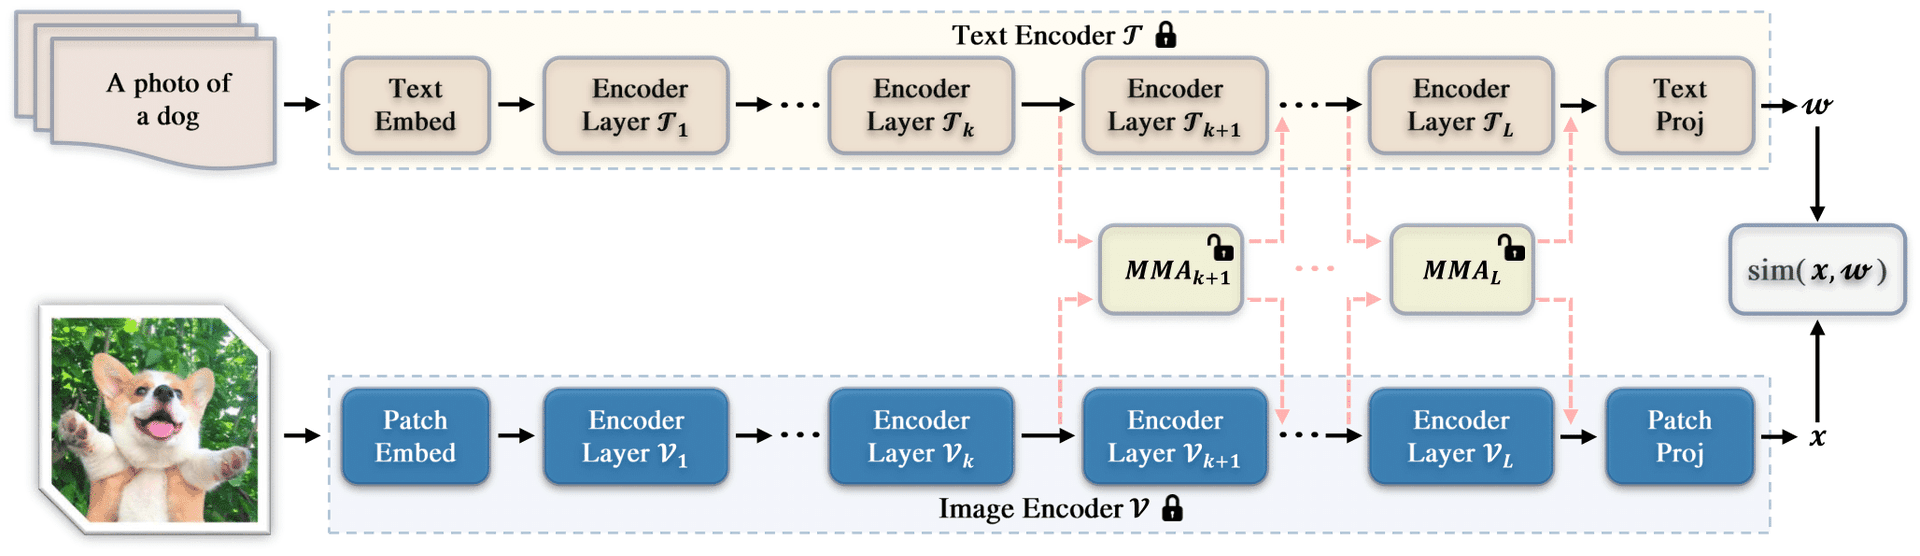
图:MMA 框架结构。图中可见 MMA 在 CLIP 的文本编码器和视觉编码器的高层同时插入适配器,通过共享投影层实现跨模态特征对齐。
在三大任务上的实验数据印证了 MMA 的价值:
| 任务类型 | 代表方法 | 调和平均准确率 | MMA 表现 |
|---|---|---|---|
| 基础→新类别泛化(11 数据集平均) | MaPLe | 78.55 | 82.59 |
| 跨数据集泛化 | CoOp | 71.66 | 82.40 |
| 领域泛化(ImageNet→变体) | CLIP | 71.70 | 79.83 |
相比最强的竞品方法 MMA 均取得 3-4 个百分点的提升。这说明 MMA 的"选择性适配"策略确实有效:只在高层插入适配器,避免破坏低层已经学好的通用知识。
上手门槛分析: 这个项目面向研究者和有一定深度学习基础的开发者。没有 Web UI,没有 Docker,需要手动配置 Dassl 框架、下载预训练 CLIP 权重(如 ViT-B/16),以及准备 ImageNet、Caltech-101 等数据集目录。代码结构清晰,基于 PyTorch + Dassl 训练框架,提供了完整的训练脚本(train.py)和数据集定义,支持 11 个标准少样本学习数据集。配置文件采用 YAML,训练命令示例在 run_examples.sh 中。适合有科研背景、熟悉 PyTorch 训练流程的团队二次开发或对比实验。
值得注意的是,MMA 团队后续还发表了 MMA++(T-PAMI 2026),进一步扩展到多模态大模型场景,有相关研究需求可以一并关注。
