
Decoding-Tree-Sketching
ZichengXu/Decoding-Tree-Sketching加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
Decoding Tree Sketching——让大语言模型在推理时"多路思考",自动选出最优答案路径。
想象你在做一道复杂的数学证明题,脑子里的正确思路其实有多条分支,但你只能顺着一条路走到底。如果这条路上有个小陷阱,你就整道题全错了——这正是当前主流 LLM 推理方式的真实写照。
Standard Decoding(标准解码):模型每步只生成一个 token,像单车道依次通过,无法回头。
当前的大语言模型(LLM)在推理任务上表现惊艳,但在处理复杂、多步骤推理(Chain-of-Thought)时,单条生成路径的局限尤为突出:一旦某个推理步骤出错,后面的所有推导都会连锁崩塌,正确答案被埋没在无数错误分支里。
训练成本高昂且不灵活:要提升模型推理能力,传统做法是海量的强化学习训练(RL)和对抗样本清洗——这对于资源有限的团队来说几乎不可能。
Decoding Tree Sketching(DTS) 的出现,正是为了解决这个困境。它不需要任何训练,不需要修改模型权重,只需要改变解码策略,就能让模型在推理时"同时走多条路",最终选择最优轨迹。
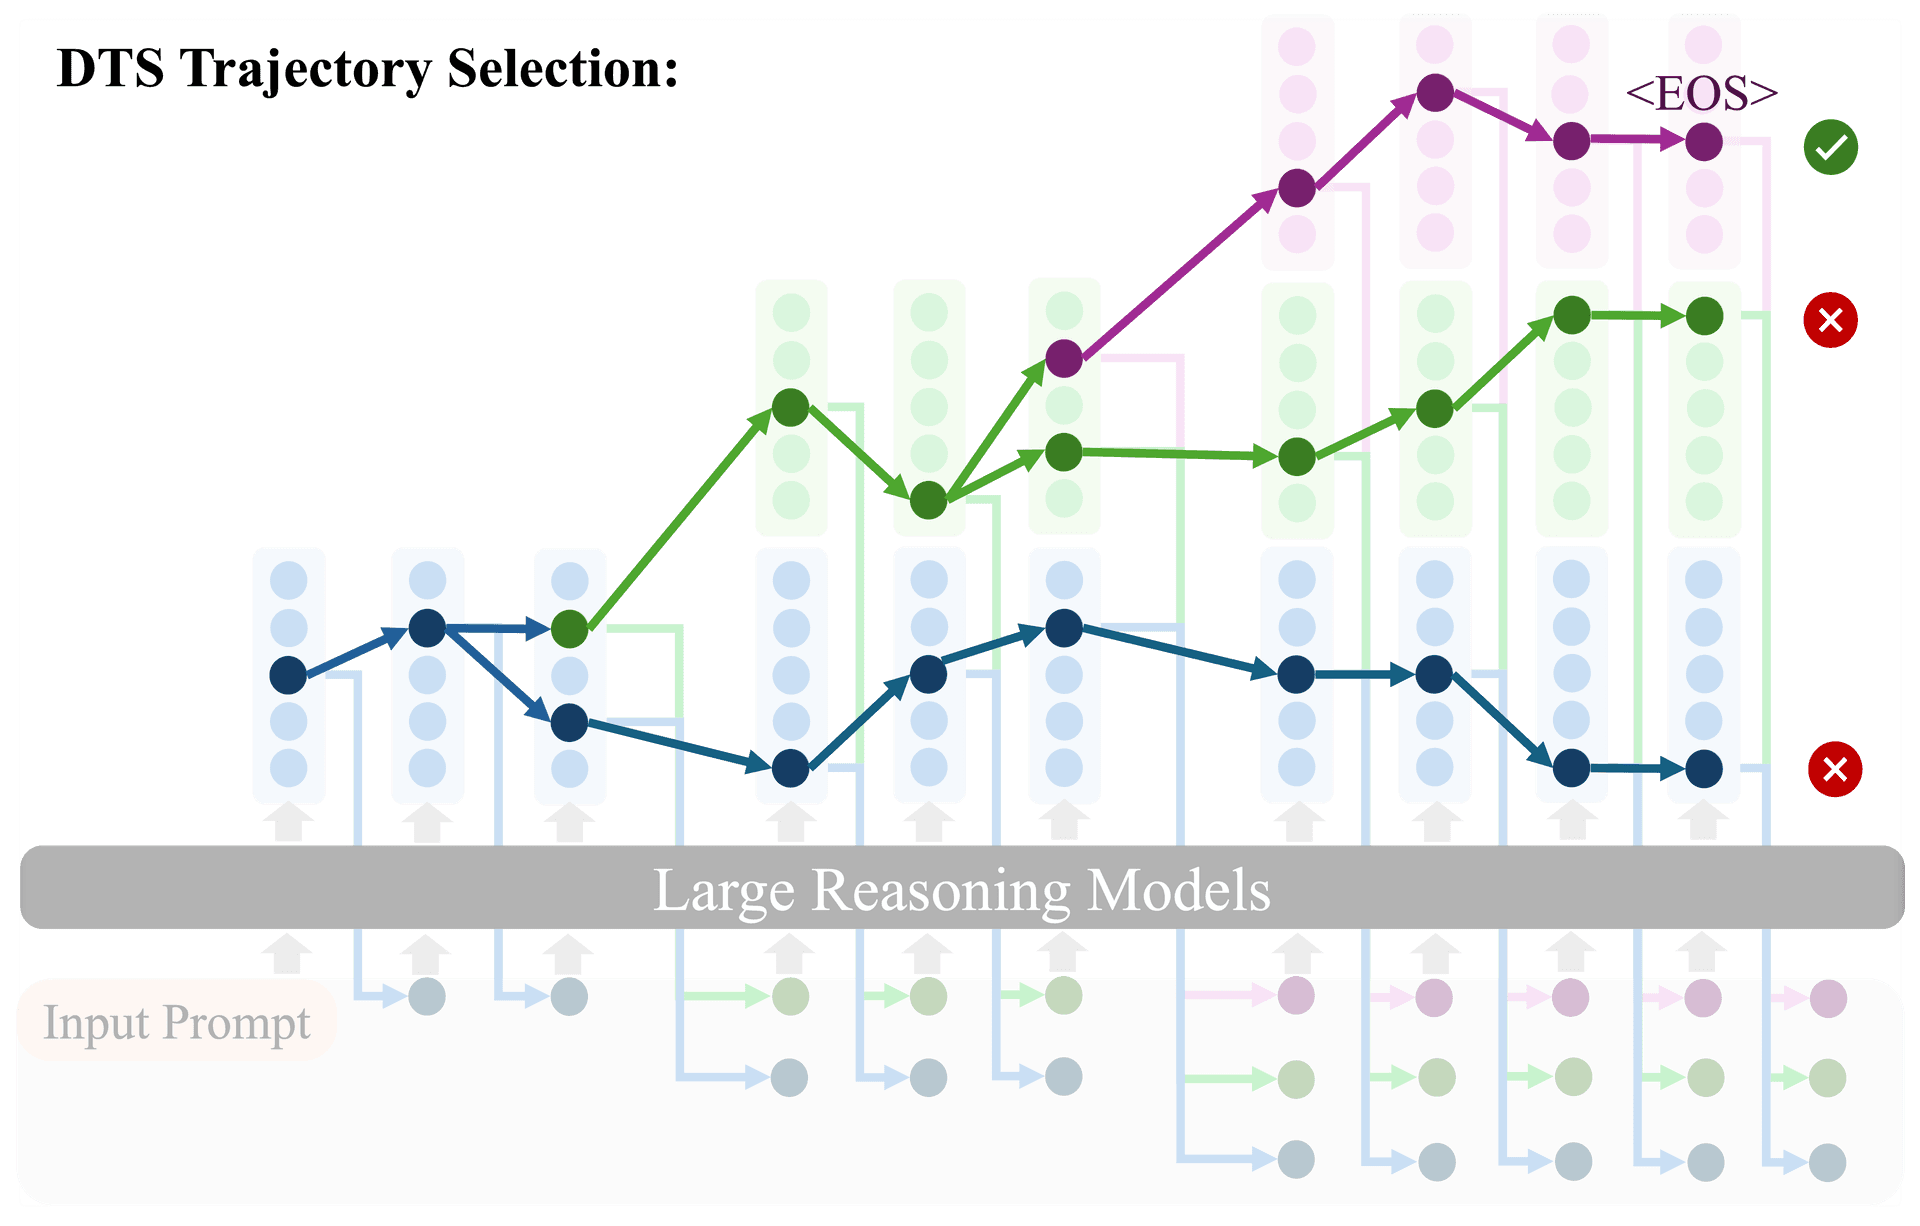
Decoding Tree Sketching 由 ZichengXu 等研究者开发,发表在 ICML 2026 会议。这是一项关于 Test-Time Scaling(推理时扩展) 的研究,聚焦于如何在不重新训练模型的前提下,通过改进推理时的解码算法来提升推理质量。
核心技术关键词:
项目支持的模型涵盖主流的开源推理模型,包括 DeepSeek-R1-Distill-Qwen 系列、Qwen2.5、Phi 系列等,覆盖 1.5B 到 72B 参数规模。
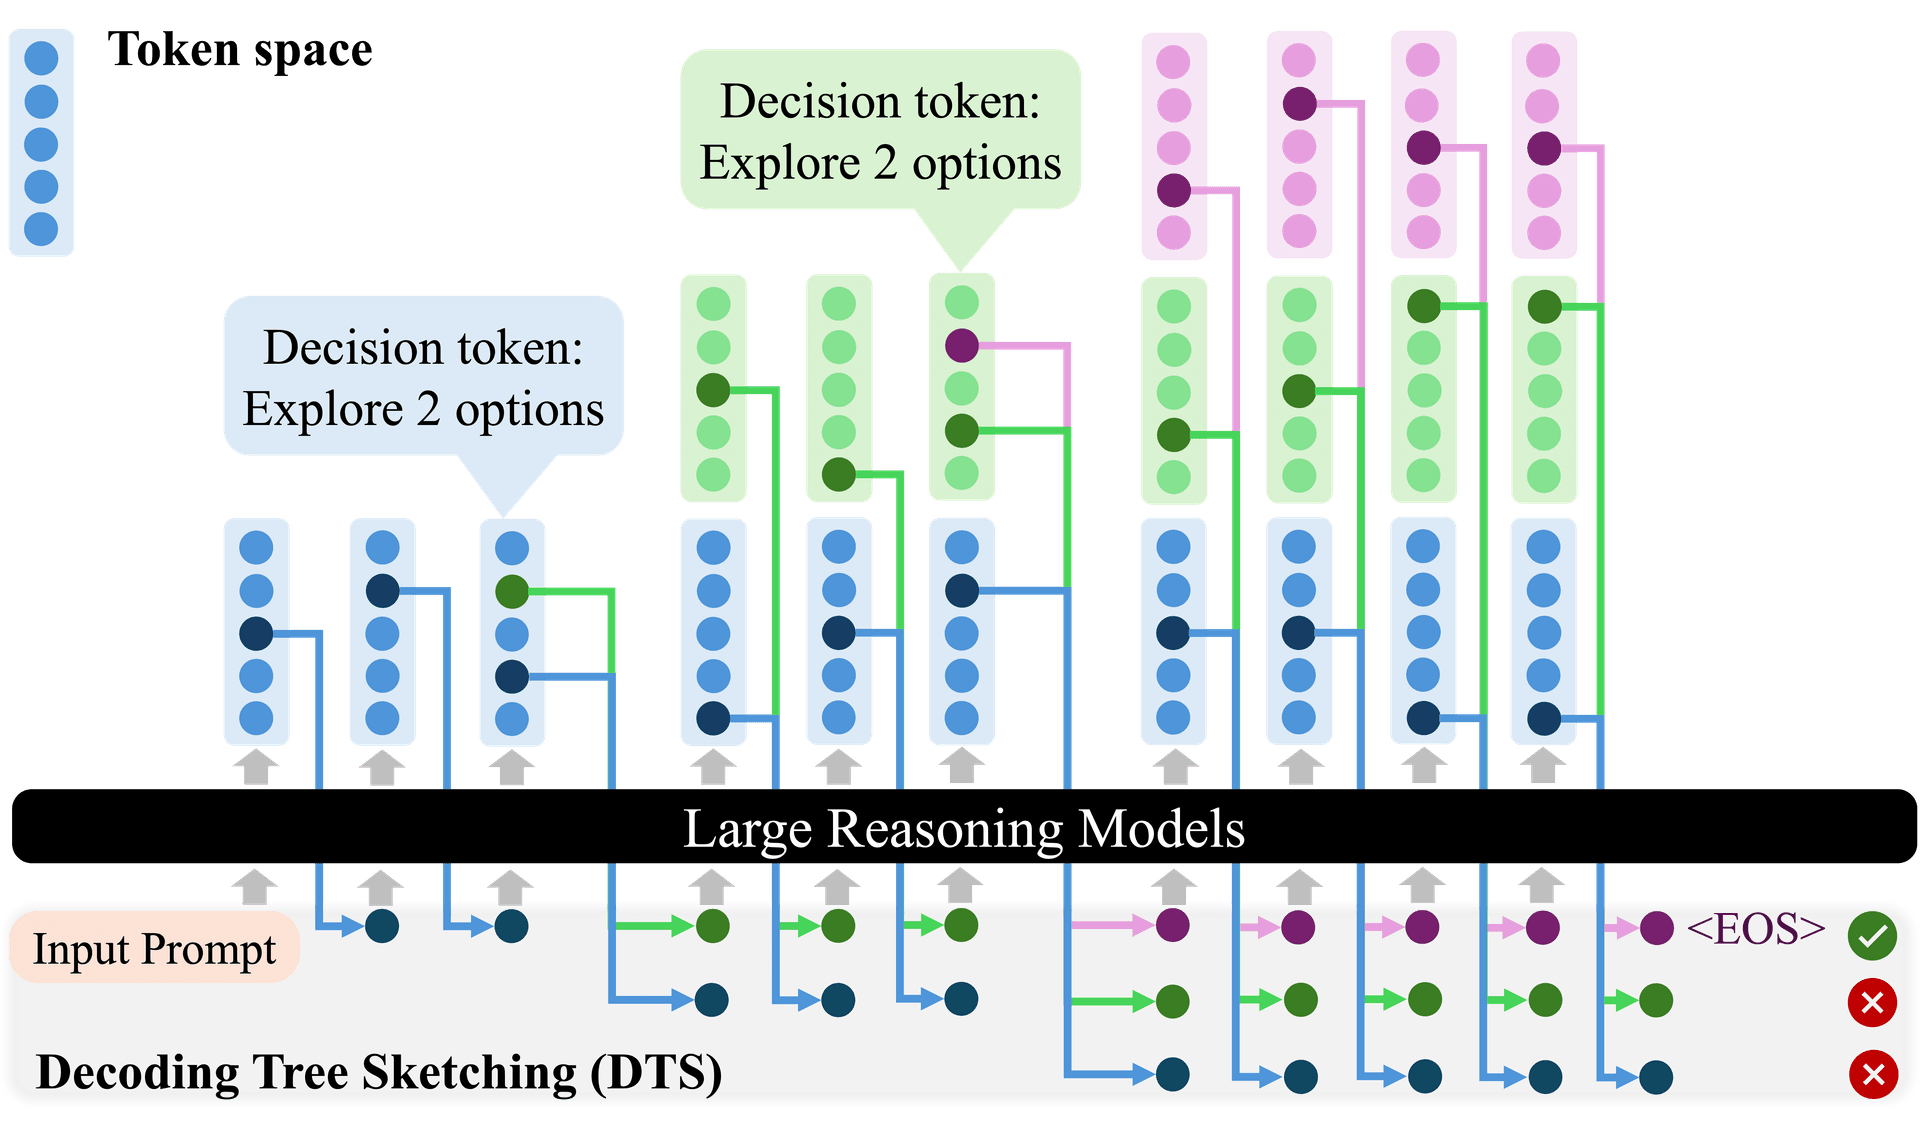
DTS 的工作流程分为三个核心阶段:
模型在生成每个 token 时,输出的是整个词表的概率分布。当模型"犹豫不决"时,这个分布的熵(Entropy)会显著升高。DTS 巧妙地利用这一特性:计算相邻 token 之间的熵变化(VarEntropy),当 VarEntropy 超过阈值时,判定模型进入了"不确定区",需要启动并行搜索。
# 核心参数
entropy_threshold = 2.5    # VarEntropy 阈值
branch_top_k = 3           # 每个分支最多保留 top-k 个候选
max_active_hyps = 12      # 同时维护最多 12 条推理路径
temperature = 0.6         # 采样温度
DTS 引入 KV-Batch 策略,将多条候选推理路径打包为 batch 进行并行解码。与传统的自回归单条生成不同,KV-Batch 通过共享 Key-Value 缓存,复用已计算的隐状态,大幅减少重复计算开销,同时维持了多条路径的协同推进。
在实现上,核心类 KVBatchEGDT(EGDT = Entropy-Guided Decoding Tree)封装了整个并行推理流程:
from decoding_tree_sketching.kvbatch_decoder import KVBatchEGDT

kvegdt = KVBatchEGDT(model, tokenizer, seed=seed)
dts_out = kvegdt.generate(
    text,
    entropy_threshold=2.5,
    branch_top_k=3,
    max_active_hyps=12,
    max_new_tokens=5000,
    temperature=0.6,
)
推理结束后,DTS 从所有生成的候选轨迹中,通过多个评估指标(长度加权分数、答案一致性、推理逻辑连贯性等)综合评估,输出最优路径作为最终答案。这一步相当于"裁判打分",确保最终输出不是随机选中的分支,而是经过质量评估的优质答案。
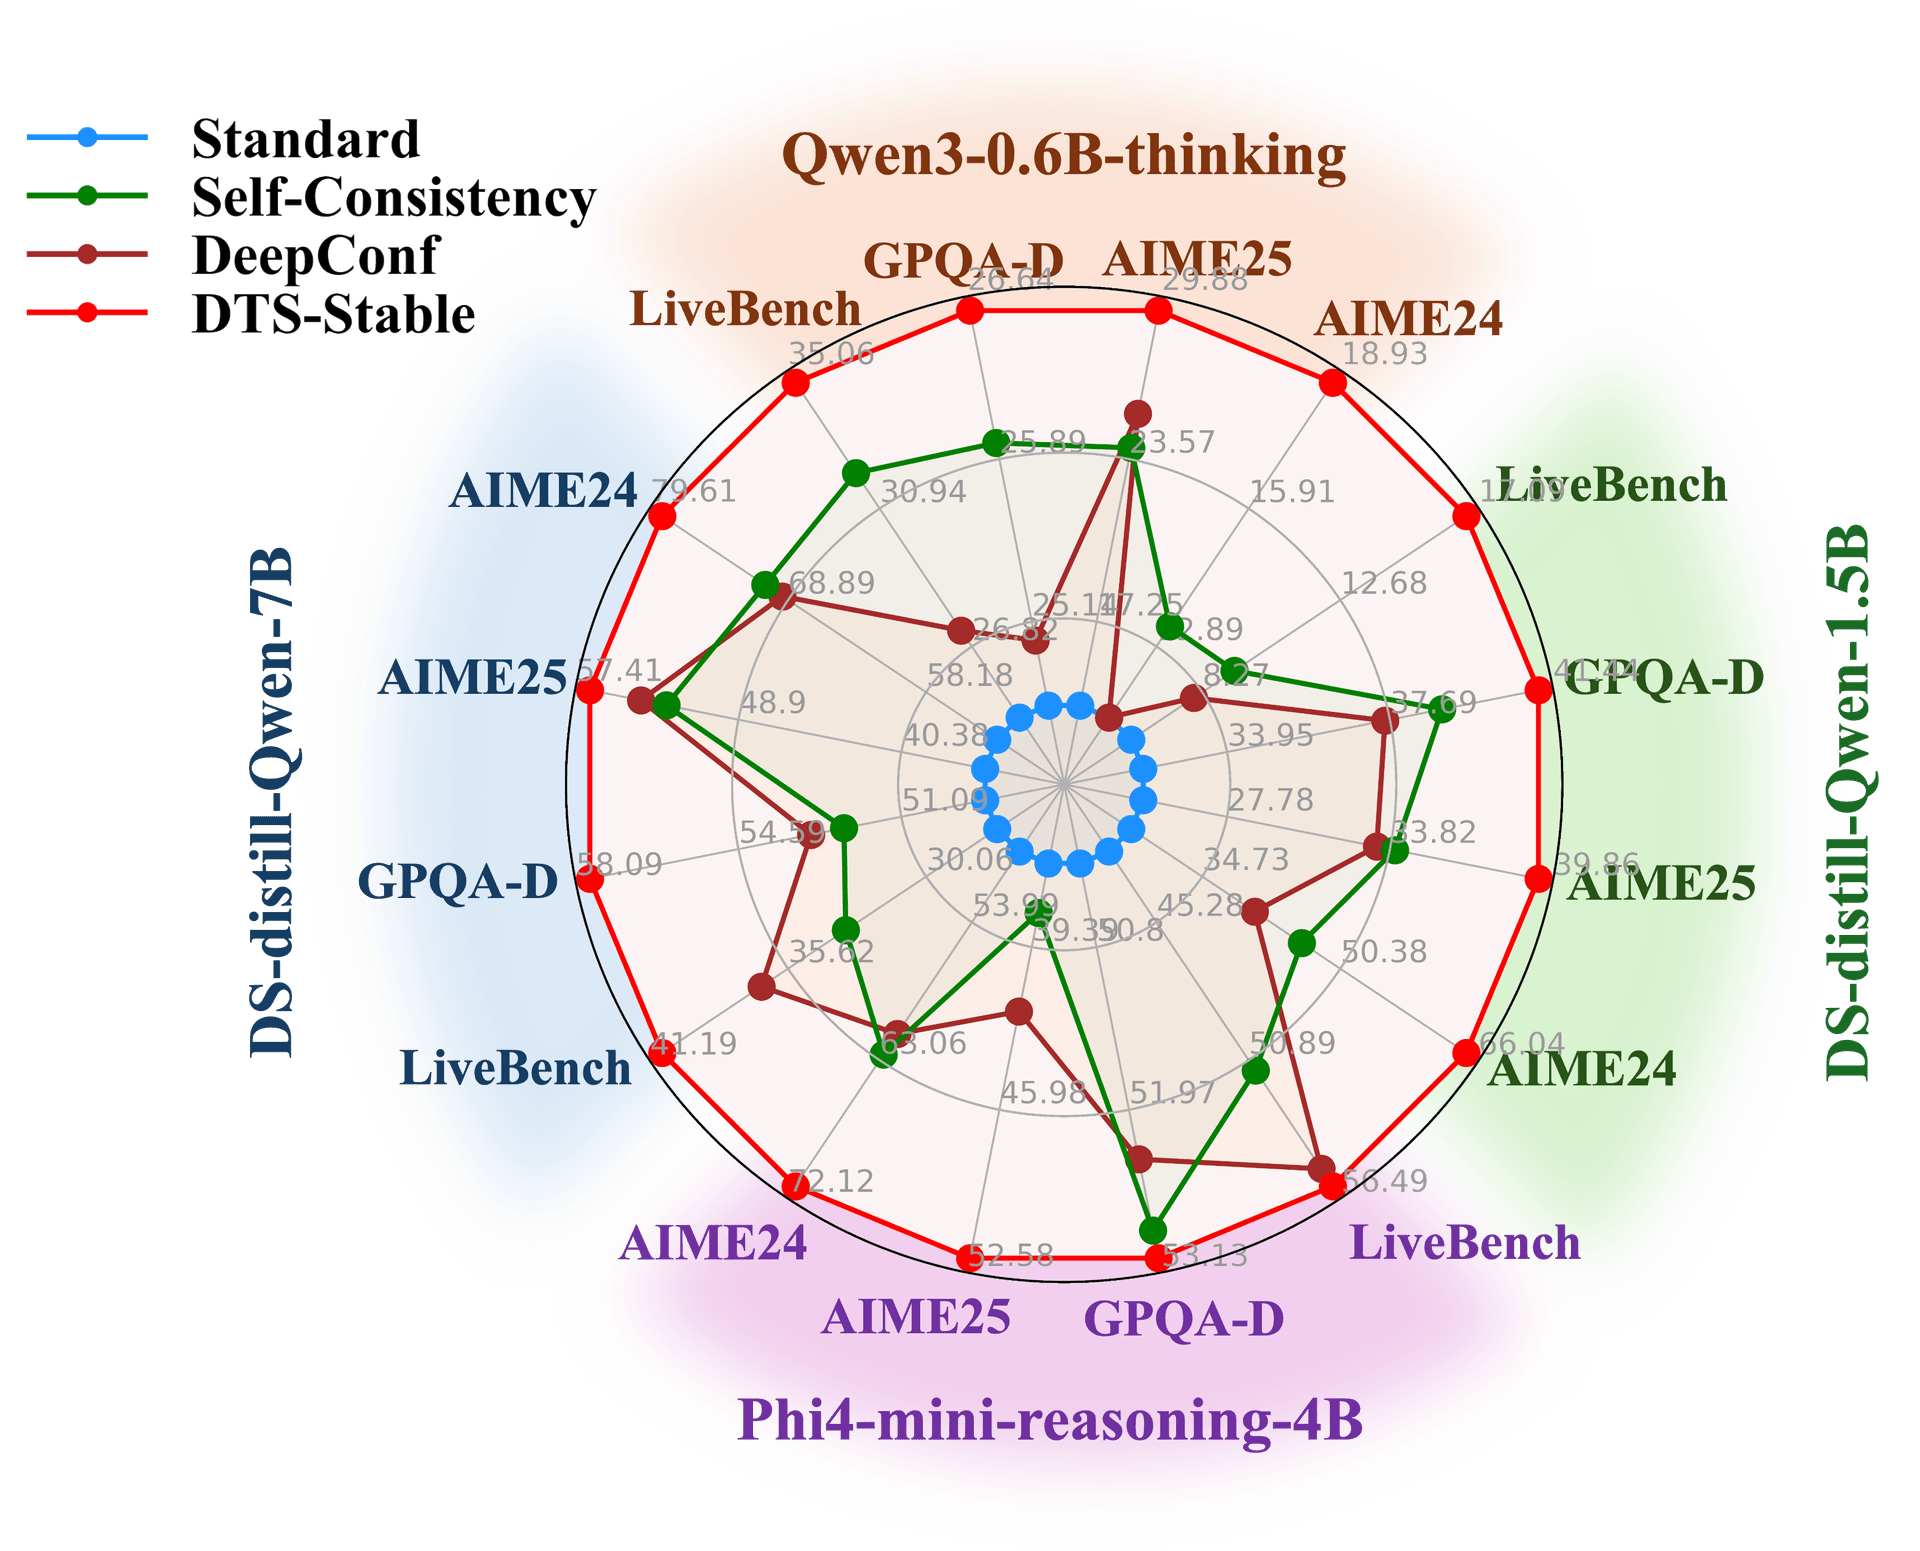
根据项目 README 中的实验数据,DTS 在多个推理基准上取得了明显改进:
| 指标 | 提升幅度 |
|---|---|
| MATH-500 准确率 | 相比 Standard Decoding 显著提升 |
| GPQA Diamond | 大幅超越基线模型 |
| 推理时计算扩展 | 在 1.5B~72B 规模均有效果 |
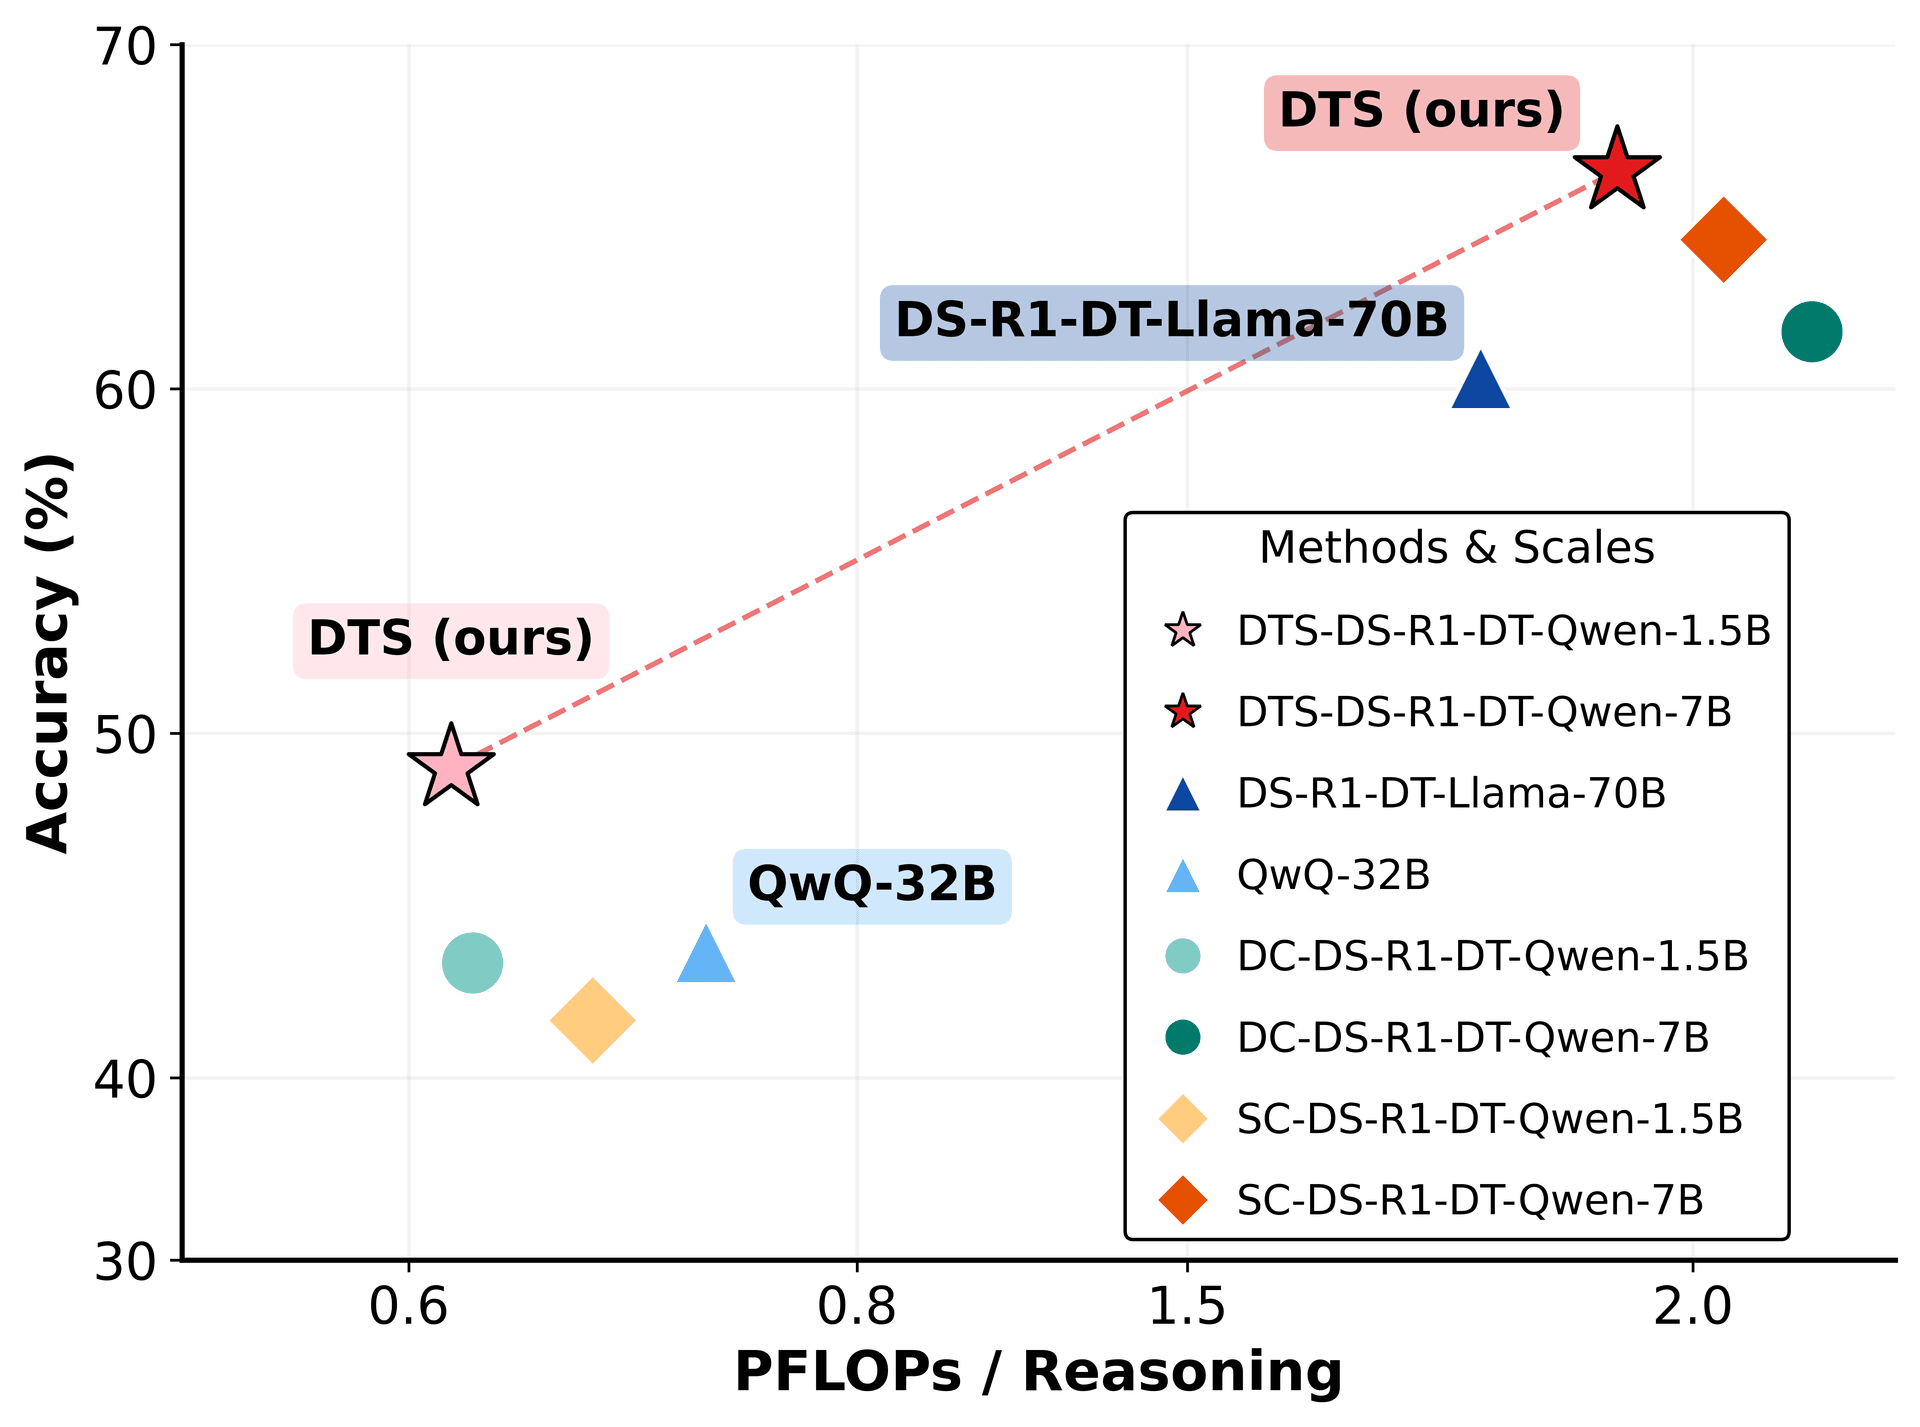
尤其值得注意的是,DTS 对模型的提升具有跨规模一致性——从 1.5B 参数的小模型到 72B 的大模型,均能从树搜索解码策略中受益。这意味着资源受限的团队可以用较小的模型+DTS 方案,达到接近大模型的推理效果。
项目代码结构清晰,主要模块:
decoding_tree_sketching/
├── kvbatch_decoder.py      # 核心 KV-Batch 并行解码器(KVBatchEGDT)
├── run_experiments.py      # 实验脚本入口
└── utils/
    └── eval_utils.py       # 评估工具(含 extract_answer_llm 答案提取)
依赖环境:
DTS 目前没有提供 Docker 一键部署方案,部署需要以下步骤:
pip install -e .(项目根目录)或 pip install dtstransformers 自动从 HuggingFace 下载(需网络访问)inference_example.py 或参考脚本对于企业场景,建议封装为 Python API 服务,并通过 vLLM 接入以获得更高吞吐量。
entropy_threshold 不同,当前硬编码的 2.5 未必适合所有模型max_active_hyps 设置较高时,KV-Batch 的显存占用会线性增长DTS 代表了当前 LLM 推理优化的一个重要方向——在推理阶段而非训练阶段投入更多计算资源,换取推理质量的提升。这与 OpenAI o1/o3、DeepSeek-R1 等推理模型的思路一脉相承,但 DTS 的独特之处在于它完全不依赖训练数据清洗和 RLHF,部署门槛更低。
随着 Test-Time Scaling 研究持续升温,DTS 这类训练无关的解码策略将具有广阔的应用空间——尤其是在医疗、法律、金融等需要高可靠性推理的垂直领域。
项目地址:https://github.com/ZichengXu/Decoding-Tree-Sketching | 许可协议:MIT License
