
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你有没有想过,AI 是如何学会"推理"的?当你问"刘德华的妻子是谁的父亲?"时,AI 需要理解"妻子"和"父亲"这些关系背后的逻辑链条——这正是知识图谱推理要解决的问题。RulE(Rule Embedding)是一个将逻辑规则与深度学习嵌入统一建模的神经符号推理框架,它来自论文 Reasoning Through Memorization: Nearest Neighbor Knowledge Graph Embeddings,被 ACL 2022 / NAACL 2022 接收。
知识图谱(如 FreeBase、WordNet)以三元组 (头实体, 关系, 尾实体) 的形式存储世界知识,例如 (刘德华, 妻子, 朱丽倩)。然而,现有的知识图谱嵌入模型(KGE)虽然能预测缺失的链接,但存在两个核心痛点:
RulE 的核心思想是:将逻辑规则本身也编码成向量,纳入与实体、关系相同的嵌入空间。这样,规则的置信度可以直接通过向量距离计算,推理过程变得可解释、可干预。## 核心架构:三位一体的嵌入空间
RulE 的整体架构分为三个阶段:预训练(Pre-training)→ Grounding(规则绑定)→ 推理(Inference)。
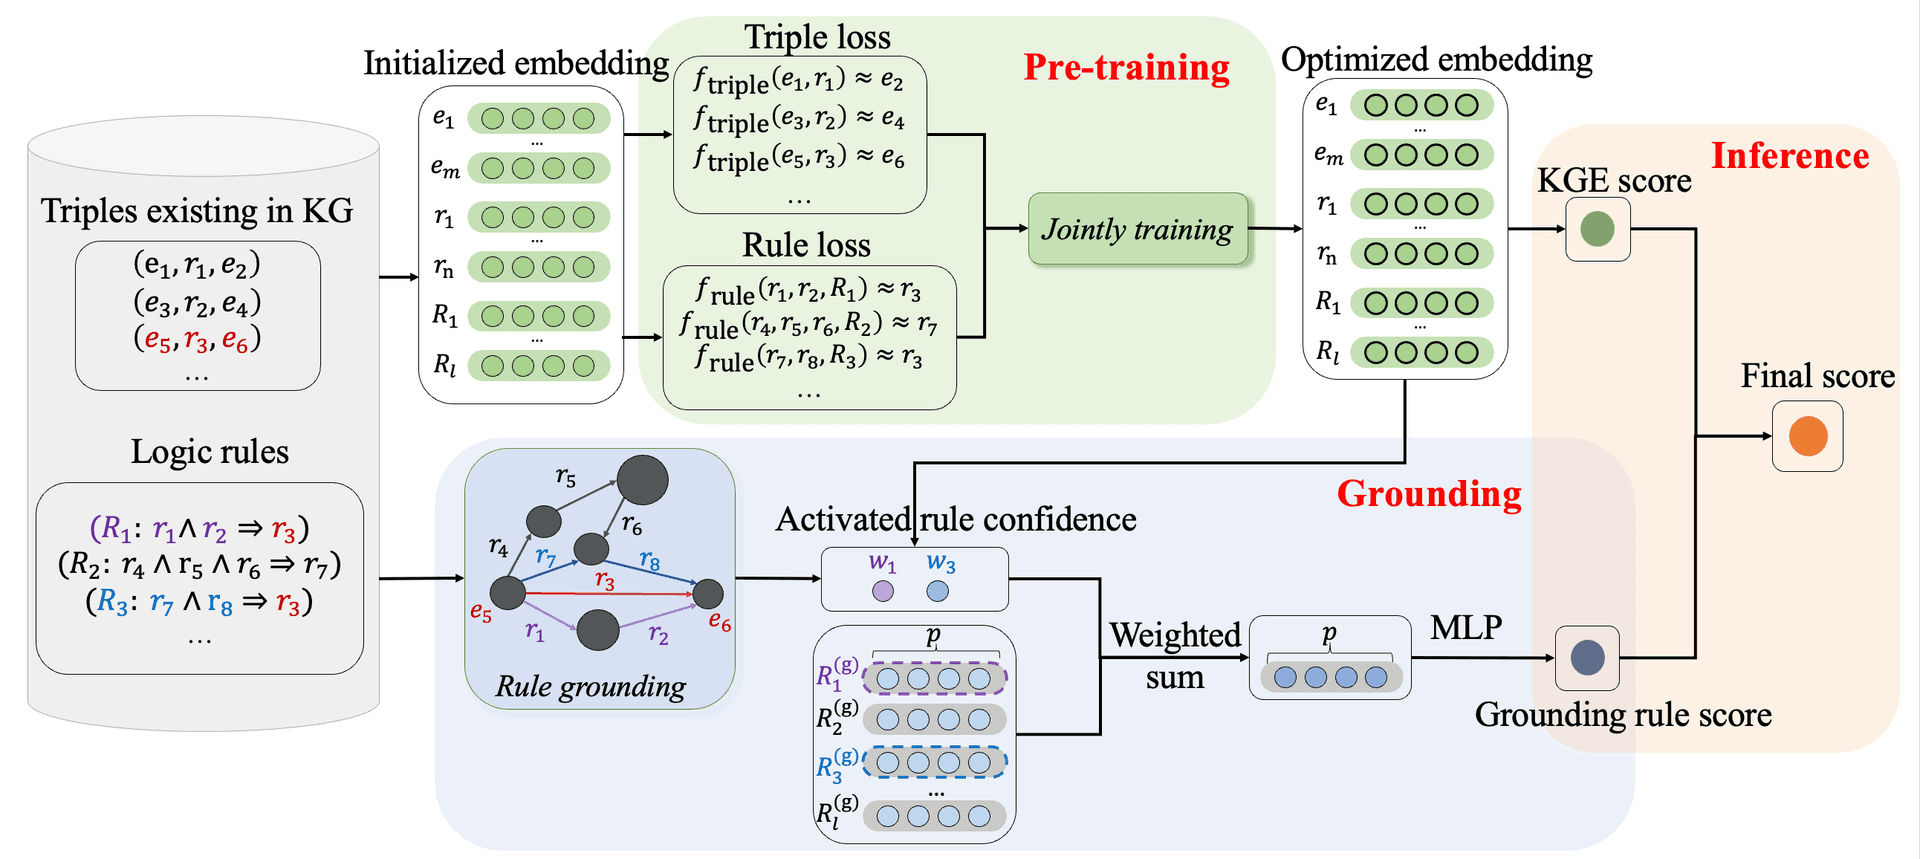 图1:RulE 整体架构图,展示了预训练、Grounding 和推理三个阶段的协作关系。
预训练阶段先对实体和关系进行标准 KGE 嵌入学习,使用均匀初始化(Uniform Initialization),通过负采样和对抗训练提升嵌入质量。实体嵌入维度为 hidden_dim * 2,关系嵌入维度为 hidden_dim,padding 索引固定在最大关系 ID 处。
Grounding 阶段是 RulE 的精髓所在。它将外部挖掘的逻辑规则(如 RNNLogic 挖掘出的规则 r1 ∧ r2 → r3)与知识图谱中的具体实体绑定。具体而言,规则头部的关系嵌入与规则体中各关系的嵌入通过 RNN/LSTM 编码器聚合,再映射到与实体相同的嵌入空间。FuncToNodeSum 层负责将关系序列转换为统一的规则向量表示。
推理阶段利用已学习的规则嵌入和实体嵌入,通过 MLP 评分网络计算给定三元组的置信度。最终得分结合了传统 KGE 评分和规则评分两部分,通过 gamma_fact 和 gamma_rule 两个超参数平衡两者的权重——事实记忆强则重 KGE,规则推理强则重神经符号。## 技术实现细节
项目在 src/model.py 中定义了核心模型类 RulE(nn.Module),其关键组件:
实体与关系嵌入:使用 PyTorch nn.Embedding 层,对实体和关系分别初始化。嵌入值的范围由 gamma_fact / hidden_dim 控制,确保数值稳定性。p_norm 参数控制评分函数的范数类型(通常为 L1 或 L2)。
MLP 评分网络:根据数据集不同,使用不同的 MLP 结构。大型数据集(FB15k-237、WN18RR、YAGO3-10)使用 [128, 1] 两层 MLP;小型数据集使用单层输出。MLP 对规则嵌入和头尾实体嵌入的组合进行评分。
损失函数:src/trainer.py 中实现了 PreTrainer 类,采用负采样策略——对每个正样本随机采样多个负样本(头实体替换或尾实体替换),用二元交叉熵损失训练。对抗采样(adversarial sampling)温度参数控制负样本的硬度。
torch==1.11.0
torch-scatter==2.0.9
numpy==1.21.5
PyYAML==6.0, easydict==1.9
torch-scatter 是 PyTorch 的稀疏张量扩展库,用于高效处理知识图谱中实体-关系的大规模邻接运算。这是项目中最难安装的依赖——它需要与特定版本的 PyTorch 和 CUDA 编译匹配,官方 only 发布到 torch 1.11.0(CUDA 11.x),这也是项目难以升级的根本原因。
不同数据集的最优超参差异显著:
| 数据集 | Hidden Dim | Batch Size | 学习率 | gamma_fact | gamma_rule |
|---|---|---|---|---|---|
| FB15k-237 | 1000 | 1024 | 5e-05 | 9.0 | 9.0 |
| WN18RR | 500 | 512 | 5e-05 | 6.0 | 2.0 |
| YAGO3-10 | 500 | 1024 | 0.0001 | 24.0 | 24.0 |
| UMLS | 2000 | 256 | 0.0001 | 6.0 | 8.0 |
关键发现:YAGO3-10 数据集的 gamma 值高达 24.0,这是因为该数据集关系类型丰富、推理链较长,需要更大的嵌入空间来容纳多样化规则。## 使用方式与上手体验
conda create -n RulE python=3.8.0
pip install -r requirement.txt
# torch-scatter 需要单独编译安装
pip install torch-scatter==2.0.9 -f https://data.pyg.org/whl/torch-1.11.0+cu113.html
在 config/ 目录下有 5 个预置配置文件,覆盖了主流知识图谱基准数据集。运行方式极为简洁:
python src/main.py --init ../config/umls_config.json
配置文件中需要提供三个核心文件:train.txt(训练三元组)、valid.txt(验证集)、test.txt(测试集),格式均为 (h, r, t) 每行一个三元组。另外 mined_rules.txt 提供由 RNNLogic 挖掘的逻辑规则。
致命问题:torch-scatter 停止维护。PyG(PyTorch Geometric)官方早已停止对 torch 1.x 的支持,torch-scatter 的最新版本停留在此。依赖此包意味着无法使用最新的 PyTorch 特性(flash attention、torch.compile 等),模型训练效率与现代框架相比差距明显。
规则依赖外部挖掘:RulE 本身不生成规则,需要依赖 RNNLogic 等外部规则挖掘工具。这意味着端到端使用需要两阶段流程,增加了工程复杂度。
仅支持推理,不支持知识图谱构建:RulE 是一个纯推理工具,不提供知识图谱的构建、存储或更新能力。如果需要动态更新知识图谱,需要配合额外的图数据库(如 Neo4j、RDFox)。## 学术价值与行业意义
RulE 的核心贡献在于首次将逻辑规则的语义嵌入到与实体相同的向量空间中,实现了神经与符号的真正融合。这条技术路线被后续工作(如 Neural LP、DRUM、RuLE-KGE)广泛借鉴,成为知识图谱推理领域的经典范式。
从工程角度看,RulE 的设计理念对 Agent 系统也有重要启示:Agent 的工具调用本质上也是一种"规则推理"——给定目标(查询),从可用工具(规则)中选择序列,组合执行得到最终结果。RulE 的嵌入评分机制可以迁移到 Agent 的 Tool Selection 场景。
目前该项目 star 数较少(58),主要原因是:1)项目偏向学术研究而非产品级应用;2)PyTorch 版本过旧;3)缺乏可视化界面和文档。但其核心思想对知识图谱推理、神经符号 AI、Rule-based Agent 等方向仍有较高参考价值。
