
MiniGPT-4
Vision-CAIR/MiniGPT-4加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你拍了一张汽车仪表盘的照片,想知道故障灯是什么意思;或者看到一张海报,想让它帮你翻译成英文——这类"看图说话"的能力,传统大模型做不到,因为它只能处理文字。而 MiniGPT-4 的出现,让这件事变得前所未有的简单。
2023年3月,OpenAI 在 GPT-4 发布会上演示了令人惊叹的多模态能力:上传一张手绘草图,GPT-4 就能生成完整网站代码;看一张搞笑图片,它能精准理解笑点。这些能力让整个 AI 圈沸腾了。然而,OpenAI 并没有开源 GPT-4 的视觉能力。
就在同一个月,来自卡内基梅隆大学(CMU)和南京大学的研究团队宣布:他们复现了 GPT-4 的视觉-语言理解能力,并且代码全部开源——这就是 MiniGPT-4。项目在 GitHub 发布后迅速爆火,短短数月获得超过 25,000 颗 Stars,成为开源多模态领域的里程碑事件。
MiniGPT-4 的核心创新在于视觉-语言对齐(Vision-Language Alignment)。它没有从头训练一个多模态模型,而是巧妙地将现成的视觉编码器和大语言模型"嫁接"在一起。
整个架构分为三层:
第一层:视觉编码器(Visual Encoder)
团队选择了 BLIP-2 中的 ViT-G/14 视觉编码器,这是 Salesforce 在 2023 年初开源的图像理解模型,拥有 3.8 亿参数的视觉主干网络,能从图像中提取丰富的语义特征。
第二层:Q-Former 对齐模块
从图像提取的特征向量与文字的语义空间完全不同,直接拼接会导致"语言混乱"。MiniGPT-4 使用 BLIP-2 预训练的 Q-Former 模块,将视觉特征映射到与大语言模型兼容的空间。这一步是整个系统的核心,也是论文标题中"Aligning"的意义所在。
第三层:大型语言模型(LLM)
对齐后的视觉特征被注入到开源大模型 Vicuna(基于 LLaMA 微调)或 Llama2 中,由语言模型完成理解和推理输出。Vicuna 7B/13B 版本均可使用,普通研究者用消费级 GPU 就能运行。
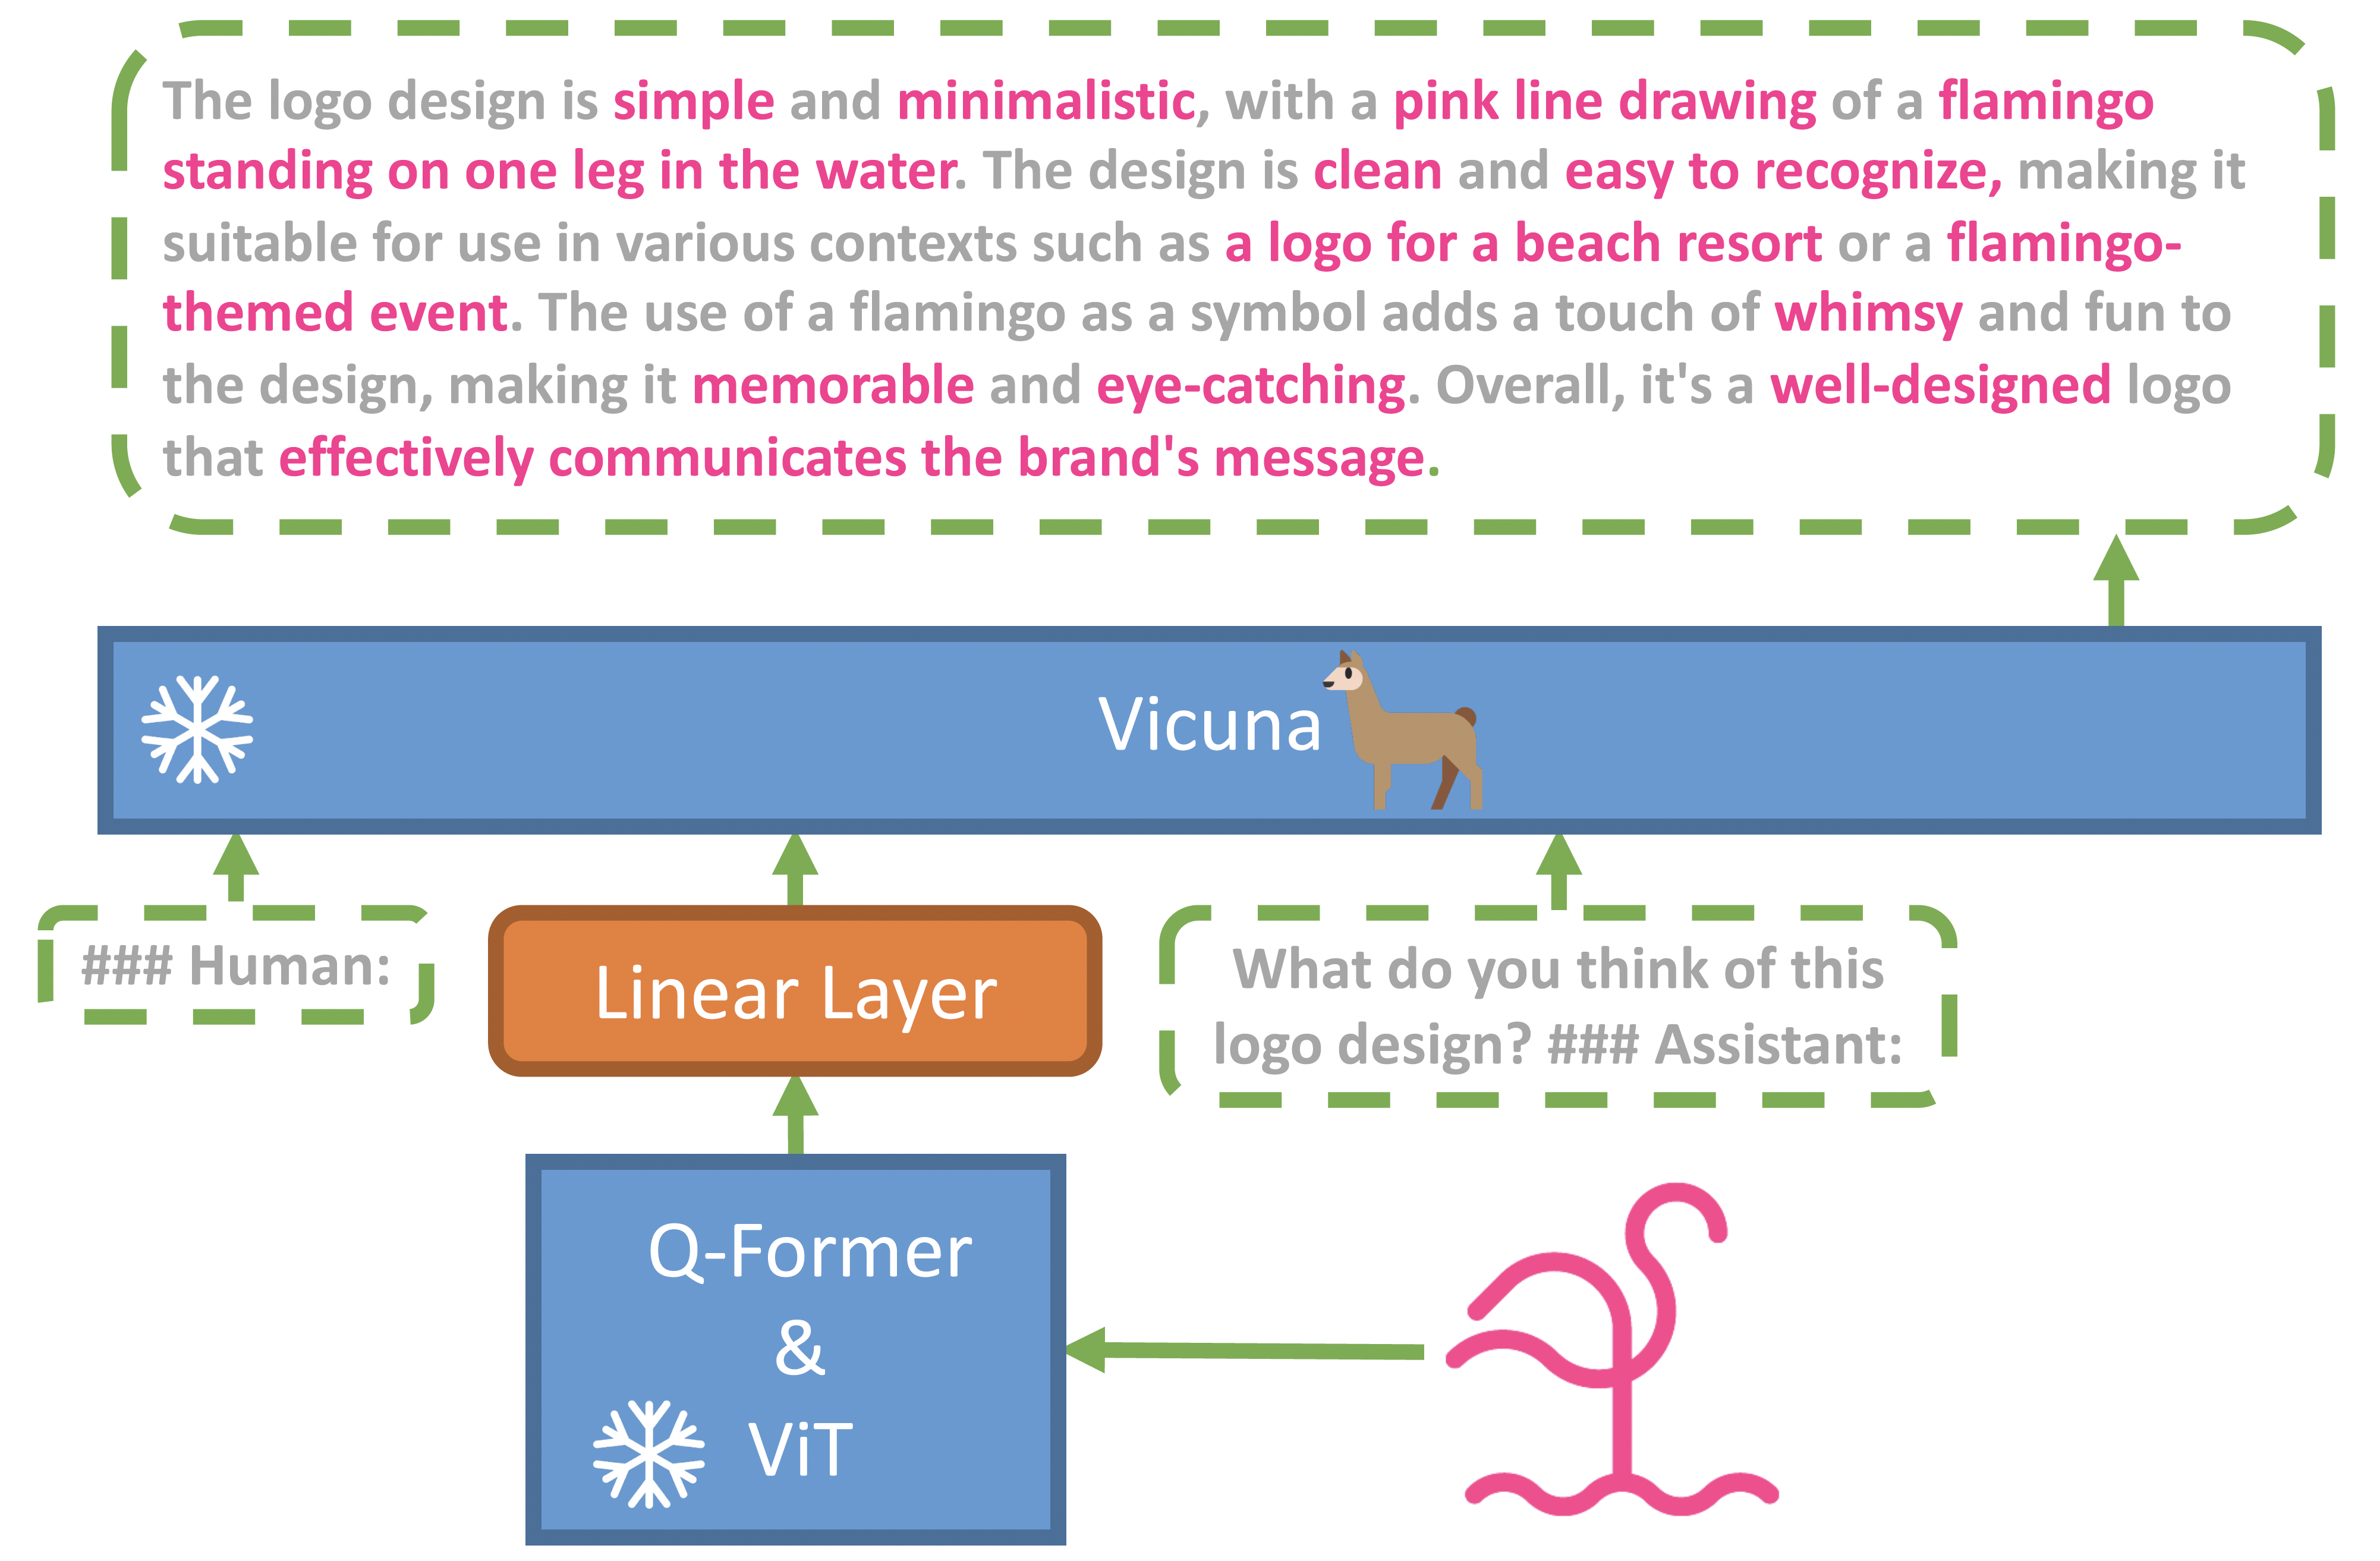
这种"嫁接"策略的成本有多低?团队在论文中透露,整个对齐训练仅用了一块 A100 GPU(80GB),耗时约 10 小时——相比从头训练一个多模态模型的动辄数百万美元成本,这个数字几乎可以忽略不计。
MiniGPT-4 的训练分为两个阶段:
第一阶段:大规模预训练对齐
使用 Laion 和 Conceptual Caption 数据集(约 500 万图像-文本对),训练 Q-Former 和 LLM 连接层,使视觉特征能"被语言模型理解"。这一阶段让模型获得了基础的图像描述能力。
第二阶段:精细调优
第一阶段的输出存在"语言混乱"问题:生成的描述不够自然、存在语法错误。团队用 ChatGPT 辅助生成了 3,500 个高质量对齐数据集,对模型进行精细调优。这个小数据集却显著提升了生成质量——MiniGPT-4 因此能够创作诗歌、解释图表、甚至帮你写代码。
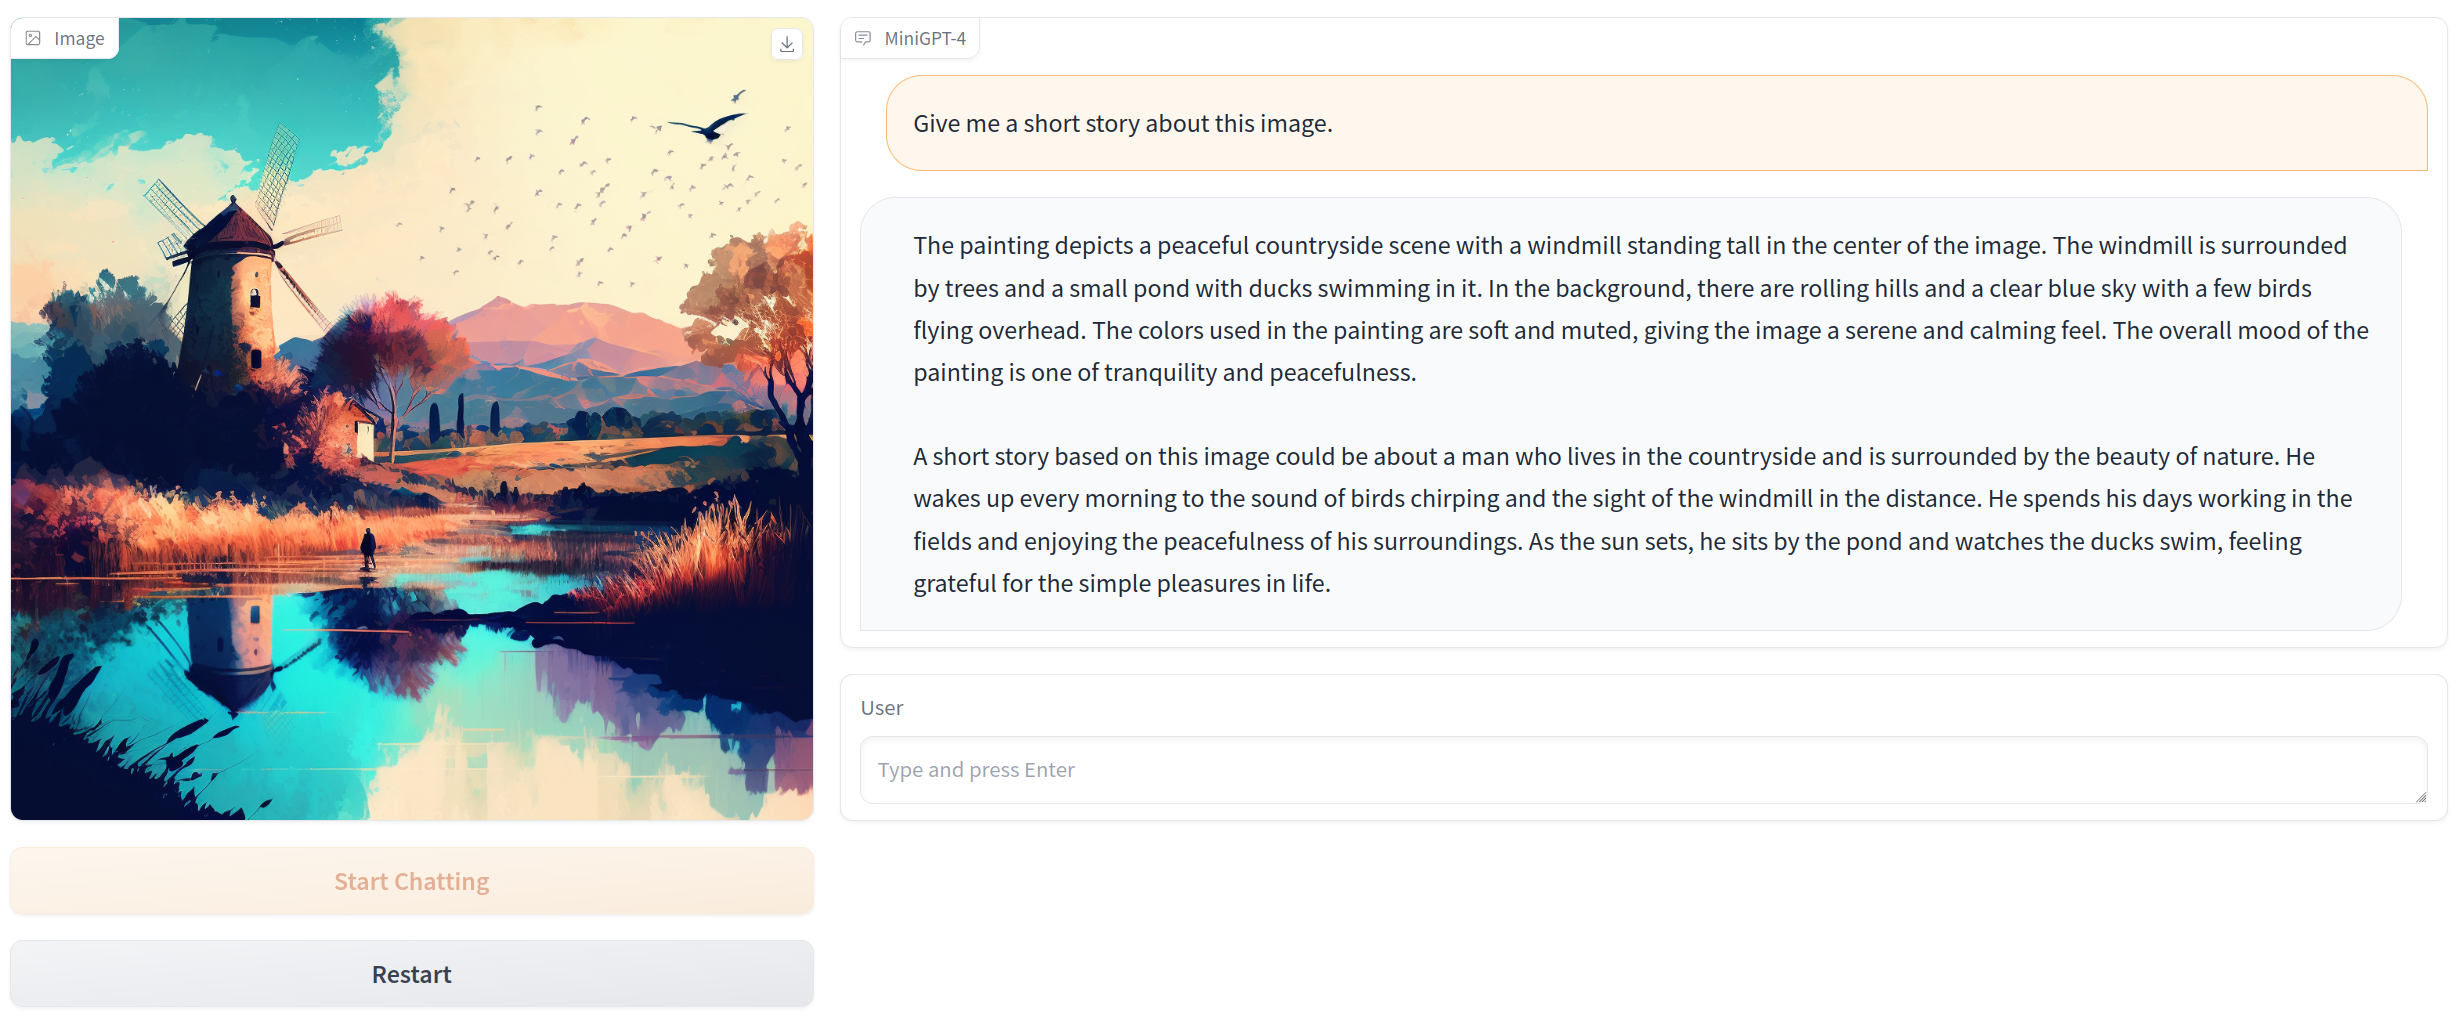
MiniGPT-4 提供了基于 Gradio 的 Web 界面,即使不懂代码也能体验。安装步骤非常直接:
# 克隆代码
git clone https://github.com/Vision-CAIR/MiniGPT-4.git
cd MiniGPT-4
# 创建 conda 环境
conda env create -f environment.yml
conda activate minigptv
# 下载预训练权重(按 README 说明操作)
# 启动 Gradio 界面
python demo.py --cfg-path eval_configs/minigpt4_eval.yaml --options
启动后,浏览器打开 http://localhost:7860,上传任意图片,直接用文字提问即可。GitHub 仓库的 examples/ 目录下提供了丰富的示例:广告创意生成、菜谱解读、图像描述、故障诊断、故事创作、诗歌生成等,覆盖了日常生活和专业场景。
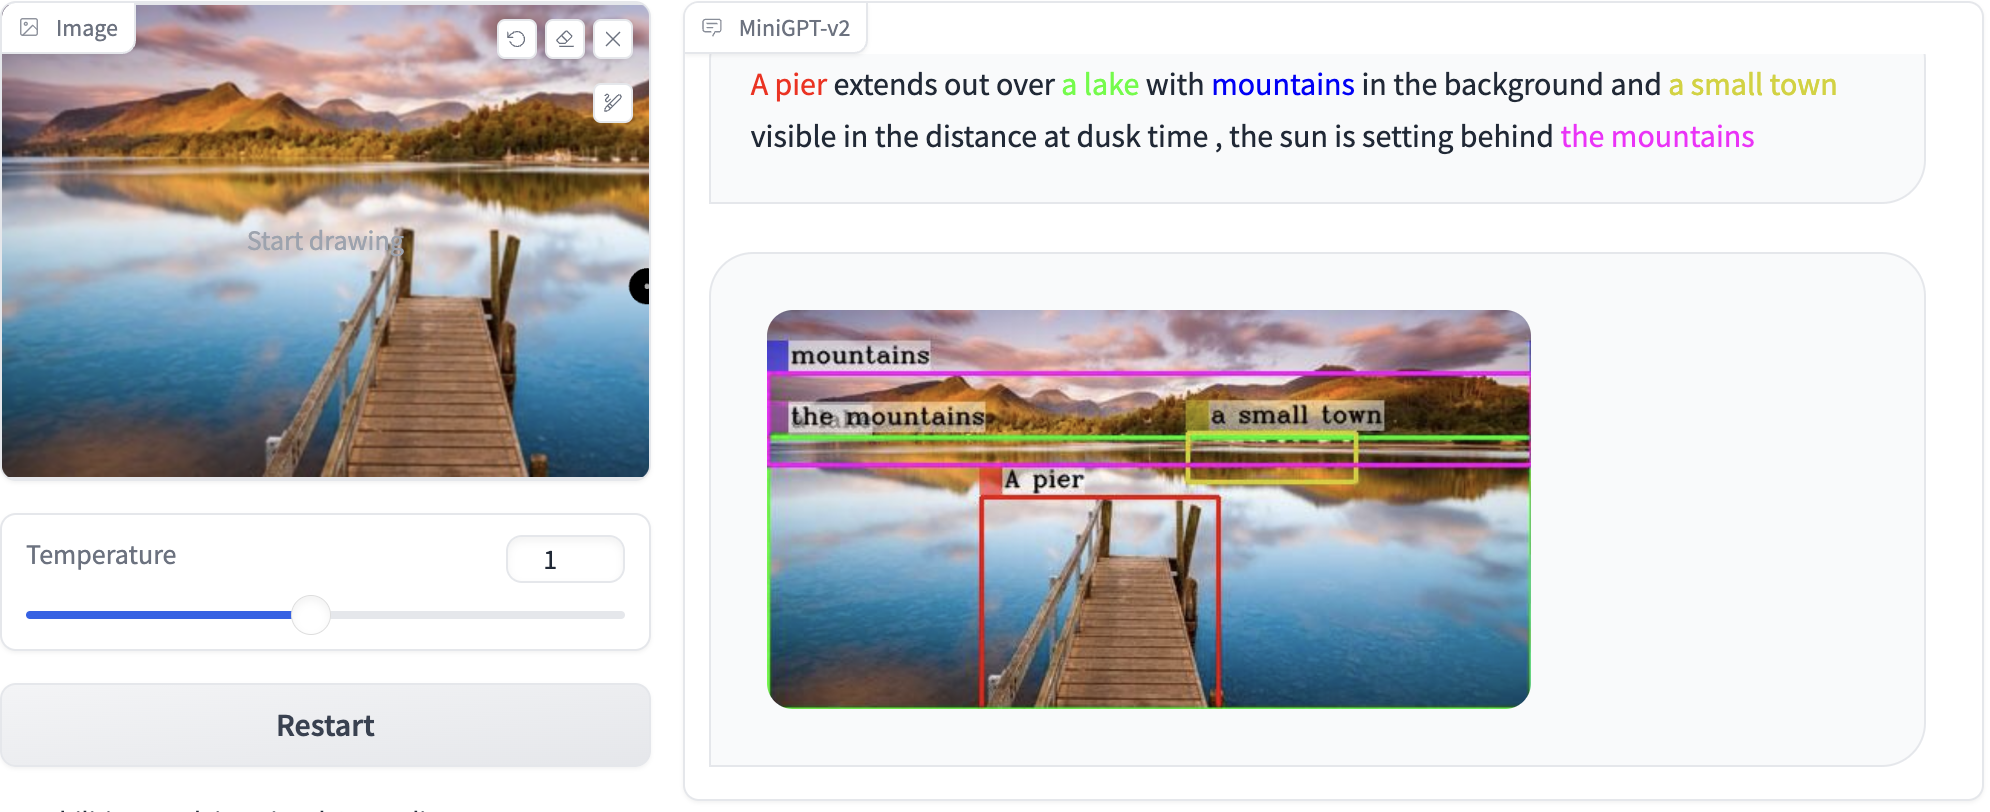
MiniGPT-4 并不是完美的 GPT-4 平替。首先,由于 Vicuna/LLaMA2 本身的限制,它无法理解复杂的空间关系(比如"图中的两个物体哪个在左边"),多轮对话的记忆能力也有限。其次,每次对话都需要上传图片到本地运行的模型,隐私安全但对网络不稳定环境不友好。
此外,项目缺少标准的 Docker 容器化部署方案,也未提供 docker-compose 一键启动脚本,对于希望快速容器化部署的团队来说,需要自行编写 Dockerfile。团队后续推出的 MiniGPT-v2 在架构上进行了升级(去掉了 Q-Former,直接用线性层对齐),性能有所提升,但仍在快速迭代中。
MiniGPT-4 的意义远不止一个开源项目本身。它证明了三个重要结论:
从 MiniGPT-4 开始,开源社区在多模态方向快速跟进。LLaVA(2023年4月)、InstructBLIP(2023年5月)、 Otter(2023年6月)相继出现,形成了一个以视觉-语言对齐为核心的繁荣生态。如今,这些项目又成为 GPT-4V、Claude Vision 等商业方案的参照基准——开源社区又一次追上了闭源前沿。
一句话总结:MiniGPT-4 用 BLIP-2 视觉编码器 + Vicuna/LLaMA2 的嫁接策略,以极低成本让开源大模型获得"读图说话"能力,是开源多模态时代的启蒙之作。
