
multiagent-debugger
VishApp/multiagent-debugger加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
凌晨两点,你的线上服务突然报警——用户反馈 API 请求大量失败。你 SSH 登上服务器,打开日志文件,满屏的错误堆栈扑面而来。HTTP 500、数据库连接超时、某行代码抛出了空指针异常……单个人肉排查,可能要花上几个小时才能定位到真正的问题根源。
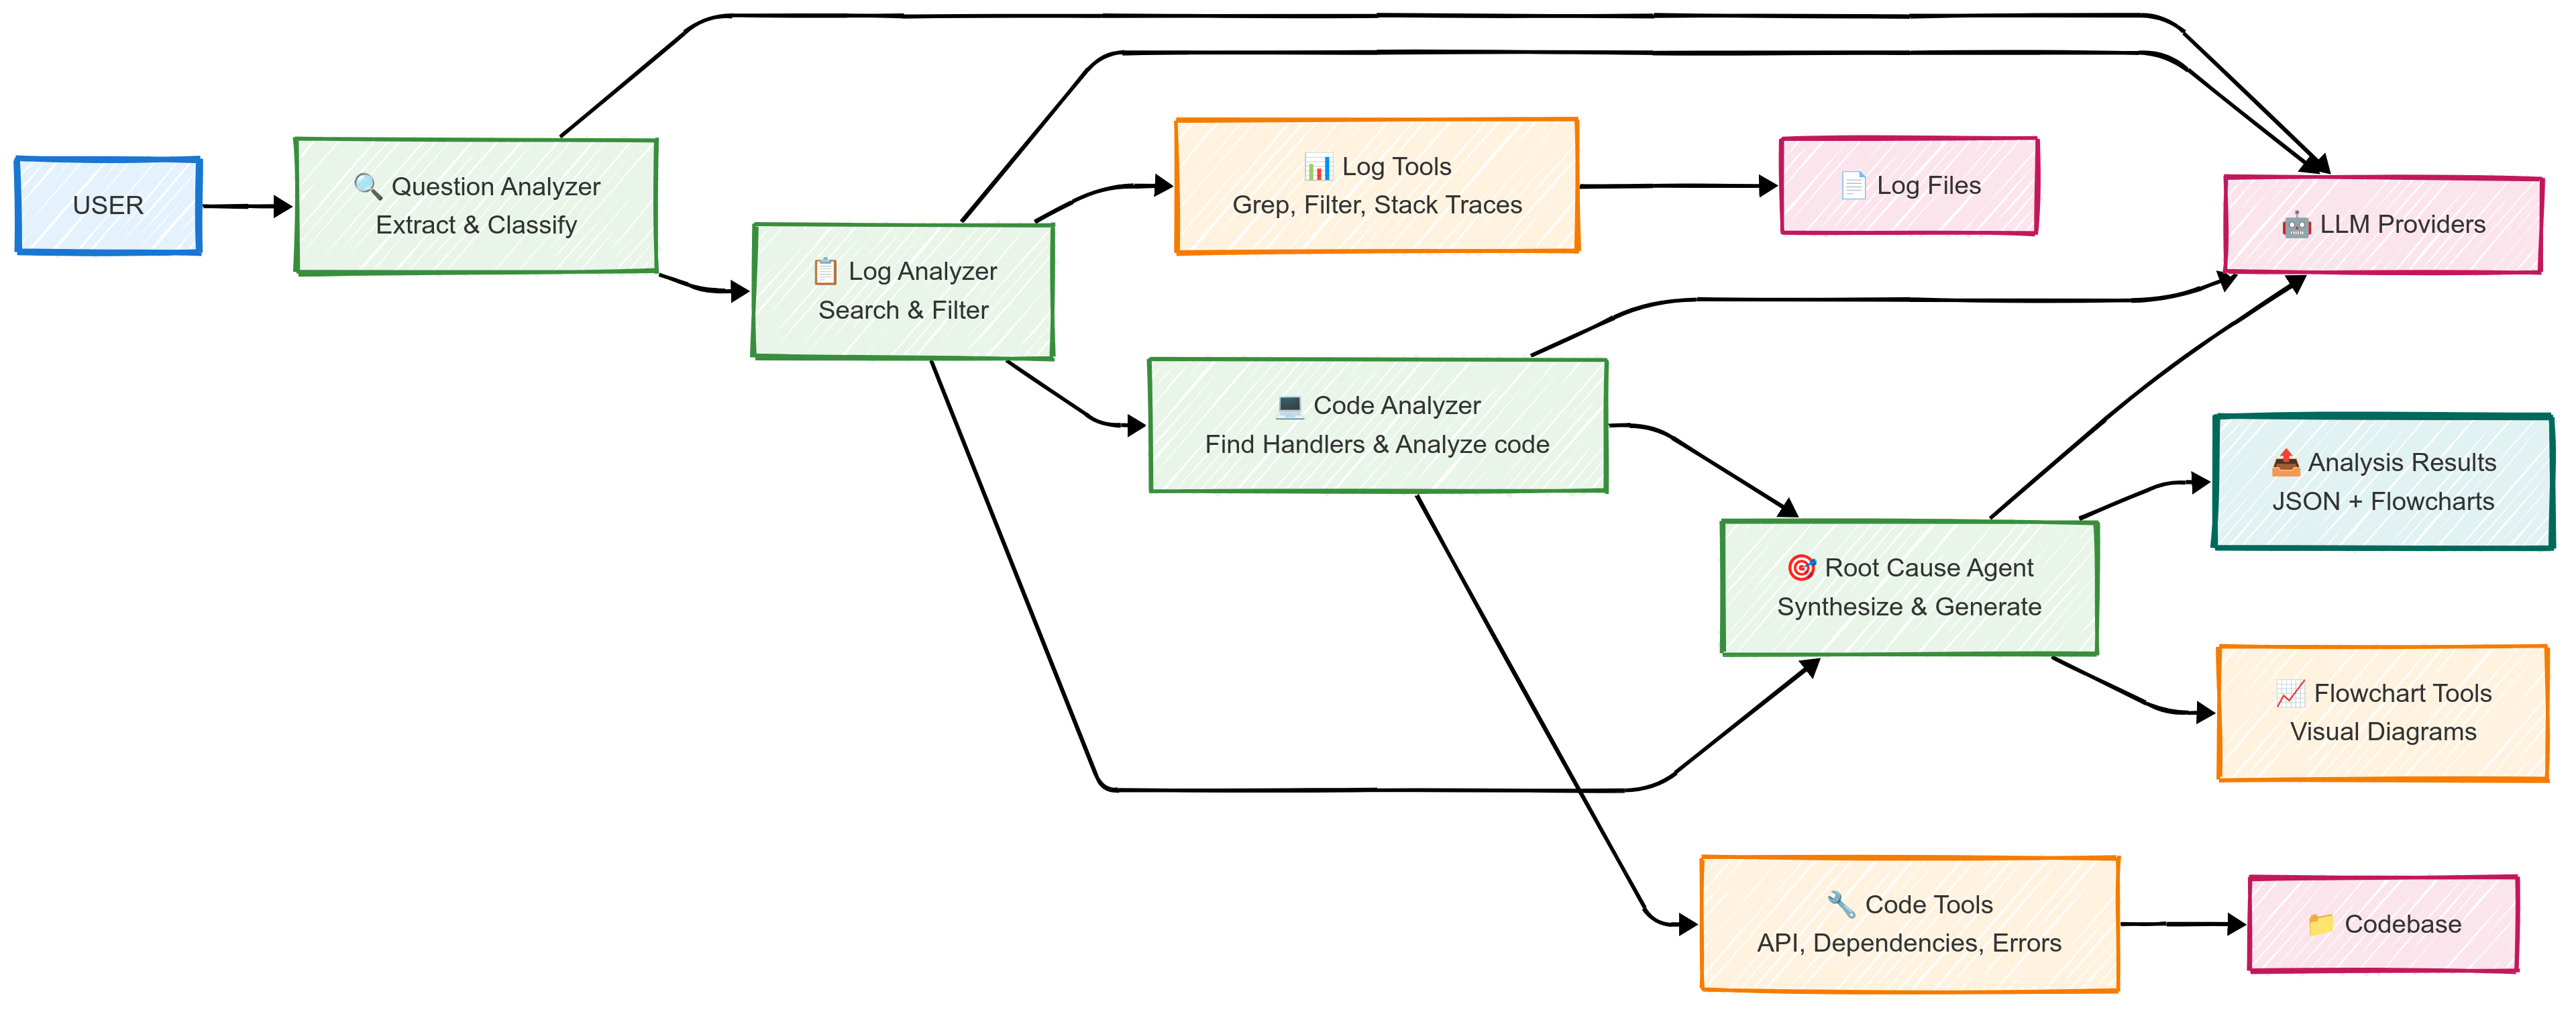
Multi-Agent Debugger(以下简称 MAD)试图把这个过程彻底自动化。它由 5 个专业的 AI Agent 组成,像一个「分布式侦察小队」,各自负责不同的分析维度,最后由一个「指挥官 Agent」汇总所有线索,直接给出根因分析报告和可视化流程图。
传统的 AI 辅助调试工具,通常是"单兵作战"——你问一个问题,AI 给出一个答案。但真实的调试场景远比这复杂:日志文件可能有几万行,同一个错误背后可能涉及 API 调用链、数据库连接、网络超时等多个层面。用一个 Agent 回答所有问题,容易出现上下文稀释(Context Dilution)——关键信息被淹没在大量无关内容中。
CrewAI 框架的多 Agent 协作思路给了 MAD 启发:让专业 Agent 做专业的事。Log Analyzer 专门负责从海量日志中捞出关键信息,Code Analyzer 专门分析代码路径和依赖关系,Question Analyzer 把自然语言问题解析成结构化查询,Root Cause Agent 负责综合所有分析结果,形成最终诊断。整个过程就像一个高效的临床诊断会议,每个专家汇报自己的发现,最终由主诊医生汇总病历。
MAD 的使用体验非常简洁。你只需要用自然语言描述问题:
multiagent-debugger debug "Why did my /api/users endpoint fail yesterday?"
系统会自动完成以下流程:
第一步:问题解析(Question Analyzer Agent) — 将自然语言问题转换为结构化查询,识别出涉及的 API 端点、时间窗口、错误类型等关键实体。这一步相当于"翻译",把模糊的人类问题翻译成机器可执行的分析指令。
第二步:日志分析(Log Analyzer Agent) — 在配置的日志路径中搜索相关条目,支持正则匹配、时间窗口过滤、堆栈跟踪提取、错误模式聚类(找出最频繁的错误类型)。支持 .log、.txt、.access 等常见日志格式,以及通配符批量匹配。
第三步:代码路径追踪(Code Path Analyzer Agent) — 根据日志中出现的文件路径和行号,验证代码执行路径,分析函数调用链和条件分支,识别可能导致错误的代码段。
第四步:代码分析(Code Analyzer Agent) — 搜索 API 处理器(handler)代码、依赖关系图、错误处理逻辑,支持 Python、JavaScript、Java、Go、Rust 等多种编程语言。这是一个重要的安全设计:该 Agent 只会分析 config.yaml 中 code_path 配置限定范围内的代码,不会扫描整个系统。
第五步:根因汇总(Root Cause Agent) — 综合四个 Agent 的发现,判断错误类型和严重程度,生成 Mermaid 格式的可视化流程图,展示错误传播路径和因果链条。同时输出结构化 JSON 报告和本地文本文件。

MAD 的另一个亮点是广泛的多 Provider 支持。项目文档称支持 50+ LLM Provider,涵盖 OpenAI(GPT-4 系列)、Anthropic(Claude 系列)、Google(Gemini)、Ollama(本地模型)、Azure OpenAI、AWS Bedrock 等主流商业和开源方案。配置方式极为简单,只需在 config.yaml 中指定 provider 和 model_name,API Key 可通过环境变量注入,无需硬编码。
这一设计在企业场景中尤为重要:不同团队可能使用不同的 LLM 服务,有些数据敏感的内部项目更倾向使用 Ollama 本地部署的模型,MAD 的多后端支持让这些需求都能得到满足。
除了本地日志分析,MAD 还集成了 Arize Phoenix 的可观测性能力。通过 OpenTelemetry 协议,可以对 Agent 的推理过程进行追踪(Trace),可视化 Agent 的思考链路和工具调用。这对于调试 Agent 行为本身(而非业务代码)非常有价值——你可以看到 Log Analyzer 调了哪些 grep 规则,Code Analyzer 扫描了哪些文件,哪些 LLM 调用返回了意外结果。
MAD 本质上是一个 Python 包,没有 Web 界面或 API 服务,直接通过命令行交互。这既是优势(轻量、无额外服务依赖),也是局限(无法远程调用、不适合集成到现有 DevOps 流水线之外)。
安装方式:
pip install multiagent-debugger
# 或从源码
pip install -e .
初始化配置:
multiagent-debugger setup
# 生成 config.yaml,可手动编辑
使用前提:
log_paths 需要指向有效的日志文件或目录,且日志格式应尽量结构化(包含时间戳、错误级别、堆栈跟踪等)code_path 是安全限制项,必须指向待分析的源代码目录,不能留空容器化方面:该项目不提供 Dockerfile 或 docker-compose,不支持一键容器部署。对于有 Docker 化需求的团队,需要自行编写 Dockerfile,基于 Python 3.8+ 镜像安装依赖后运行。
LLM 幻觉风险:Agent 在分析代码路径时可能产生不准确的推断,特别是对复杂异步调用链的分析。建议将 Agent 输出作为辅助参考,而非直接采纳为最终结论。
日志质量依赖:MAD 的分析效果高度依赖日志质量——如果日志缺少足够上下文(无堆栈跟踪、无请求 ID、无时间戳),Agent 能提取的有效信息会大打折扣。
安全边界:虽然 code_path 配置提供了目录级别的安全限制,但 Agent 仍可能在分析过程中读取敏感代码内容(如硬编码的密钥路径、内部接口逻辑)。对高安全要求的场景,建议在隔离环境中使用。
中文日志支持:项目主要面向英语日志格式设计,对中文日志、特殊编码日志的处理能力未经充分验证。
MAD 代表了一个值得关注的方向:用多 Agent 协作解决工程实践问题,而非单纯追求刷 Benchmark 分数。在 AI + DevOps 这个交叉领域,类似的多 Agent 调试工具(如 Root Cause Analysis 相关的学术研究)已经持续多年,但真正开源、可本地运行、集成 CrewAI 框架的工程级实现并不多见。
该项目目前 Star 数较低(37),属于早期探索阶段,但其架构设计和技术选型(CrewAI 编排、多 LLM 支持、OpenTelemetry 集成)都体现了对真实生产环境的考量。随着 Agent 协作框架的成熟,这类工具在可维护性和分析准确性上还有很大提升空间。
