ai-goofish-monitor
Usagi-org/ai-goofish-monitor加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
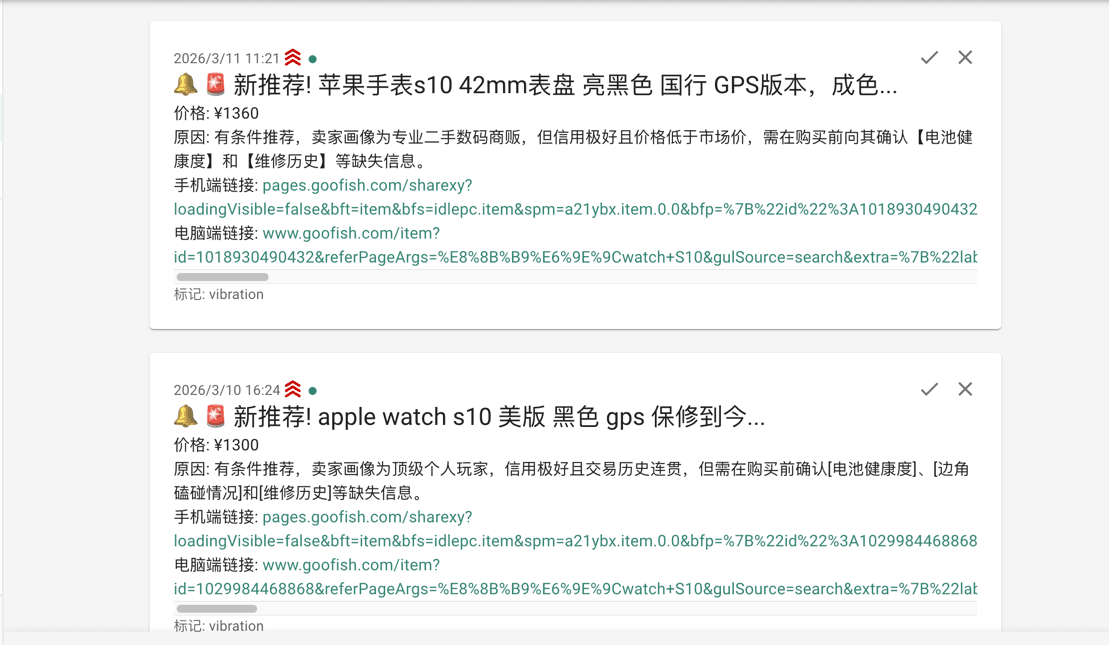
凌晨两点十七分,你在床上翻了个身,手机屏幕亮了一下——"找到一台符合要求的 ThinkPad X1 Carbon,¥4280,包邮,卖家信用极好"。这是你三天前在闲鱼设下的监控任务发出的通知。
这套系统不是"帮你搜闲鱼"的玩具,而是一个用 AI 把"刷闲鱼"这件事从体力活变成规则引擎的完整系统。截至 2026 年 11 月,它在 GitHub 上收获了 17.1k Star、2.9k Fork,成为中文 AI 自动化工具赛道增长最快的项目之一。
闲鱼是典型的反爬严、变动快、买家占劣势的二手交易平台。传统的搜索有三个致命痛点:
这个项目的解法是把它拆成三层:定时/实时爬取 → 结构化筛选 → 多模态 AI 判定 → 多渠道推送。中间的"AI 判定"是关键一步——它不是简单的关键词匹配,而是把商品标题、描述、卖家画像和商品图片一起交给多模态大模型,用自然语言写出的"详细需求"作为判断标准。
项目起源上,作者公开致敬了 superboyyy/xianyu_spider 和 LinuxDo 社区的脚本贡献者,README 里也坦率说明项目由 Claude Code / Gemini / Codex 等工具辅助开发(作者称之为 "Vibe Coding")。
把它想象成你雇了一个金牌代购:
而你只需要在早上醒来时看一条推送。
src/scraper.py 是全项目最大的单文件(约 6 万字符),承担搜索、翻页、详情页解析、卖家信息抓取、图片下载四大职责。项目使用真实 Chromium 内核而非 requests 伪造请求——这保证了能绕过绝大多数静态风控,但也意味着容器镜像里必须内置浏览器(Dockerfile 里执行 playwright install --with-deps --no-shell chromium)。
登录态通过一个开源 Chrome 扩展导出为 JSON 并粘贴进"账号管理"页,保存到 state/ 目录。这是全项目体验上最"重"的一步,也是大多数用户第一次部署会卡住的地方。
这个双模式设计很务实——对预算敏感或只关心明确关键词的用户,不强制走大模型。
项目正处在从 JSON 文件到 SQLite 的架构迁移中。当前在线主存储为 data/app.sqlite3,启动时自动建库建表,并自动从旧的 config.json / jsonl/ / price_history/ 导入一次历史数据。同时 spider_v2.py 默认从 SQLite 读任务,只有显式传 --config <path> 才走旧 JSON 兼容模式。这种"渐进式迁移 + 双轨兼容"的做法在开源小工具里不多见,工程完成度相当高。
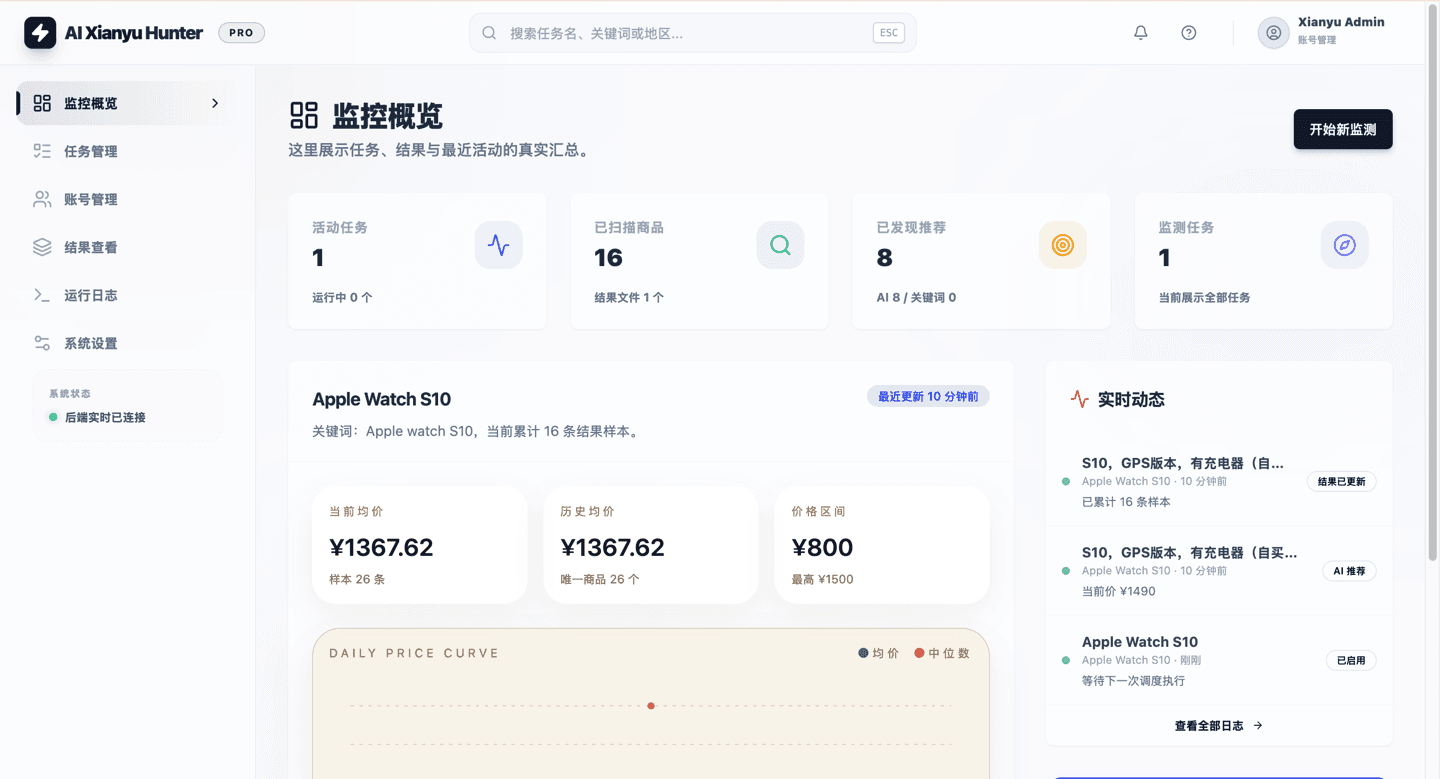
此外还内置了价格历史追踪(price_history_service.py)和结果页的价格趋势图表(前端 PriceTrendChart.vue),可以直观看到某个关键词下行情价格的走势。
支持 ntfy.sh、Gotify、Bark、企业微信机器人、Telegram Bot、Webhook 等多渠道推送。更值得注意的是容错设计:
PROXY_ROTATION_ENABLED / PROXY_POOL / PROXY_ROTATION_RETRY_LIMIT / PROXY_BLACKLIST_TTL:代理池轮换与黑名单;TASK_FAILURE_THRESHOLD / TASK_FAILURE_PAUSE_SECONDS / TASK_FAILURE_GUARD_PATH:任务连续失败自动熔断暂停(src/failure_guard.py)。对一个需要长期挂机跑的工具来说,"不崩、不乱推、失败会自愈"比功能多更重要,这一点它做到了。
web-ui/ 使用 Vue 3 + Vite 7 + TypeScript + Tailwind CSS + shadcn-vue(reka-ui)+ vue-i18n(国际化)+ lucide-vue-next 图标。后端用 FastAPI 提供 REST 与 WebSocket(/api、/auth、/ws),Vite 开发服务器代理到 127.0.0.1:8000。
| 维度 | Web UI 路径 | CLI 路径 |
|---|---|---|
| 启动成本 | docker compose up -d,镜像内置 Chromium | 需装 Python 3.10+、Node 20、Playwright + Chromium |
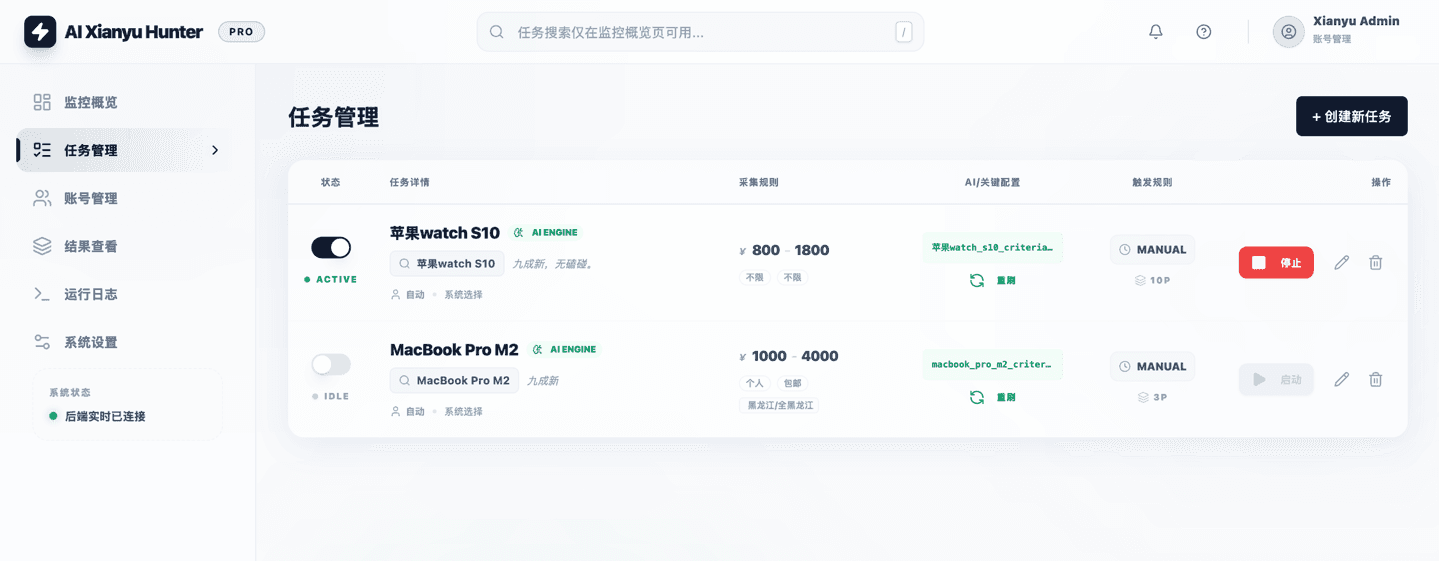
| 任务配置 | 图形化表单,含三级区域筛选器 | 编辑 JSON/SQLite |
| 结果查看 | SQLite 查询 + 导出 + 价格趋势图 | 终端输出 |
| 定时调度 | Web UI 配置 Cron | 靠外部 cron 调度 |
| 适合 | 普通用户、长期挂机 | 开发者、调试、CI 集成 |
关键前置条件:OPENAI_API_KEY、OPENAI_BASE_URL、OPENAI_MODEL_NAME 三项必填,且模型必须支持图片输入(多模态)——这是最容易踩的坑。Web UI 默认账号密码 admin/admin123,生产环境必须改。
src/scraper.py 承担了太多职责,长期演进会成为维护瓶颈。/auth/status 校验,没有多因素认证,也没有细粒度权限。这个项目真正有价值的,不是代码本身,而是它演示了 "LLM + 垂直场景 + 自动化运维" 的完整落地范式:
定时任务 → 浏览器自动化采集 → 多模态 LLM 判定 → 结构化存储 → 多渠道推送
这套范式可以直接迁移到任何"信息差套利"型场景:二手数码、球鞋囤货、租房、演唱会票、二手车报价、学术会议抢座。17.1k Star 本身就是最好的验证——它证明了垂直、具体、闭环的 AI 工具,比通用 Agent 更容易获得用户认可。
从 2025 年 7 月创建到累计 469 次提交、21 位贡献者,这个项目的迭代节奏说明它仍在活跃维护。开源多模态模型与廉价推理 API 的普及,让"每个小众场景配一个 AI 筛选器"从奢侈变成了可能。
data/(SQLite)、state/(登录态)、prompts/、logs/、images/、config.json、jsonl/、price_history/;ghcr.io/usagi-org/ai-goofish:latest(国内可用 ghcr.nju.edu.cn 加速);pytest 测试套件(unit/integration/live 三层),PYTEST_DISABLE_PLUGIN_AUTOLOAD=1 pytest 可跑。