
LLM-judge-reporting
UW-Madison-Lee-Lab/LLM-judge-reporting加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
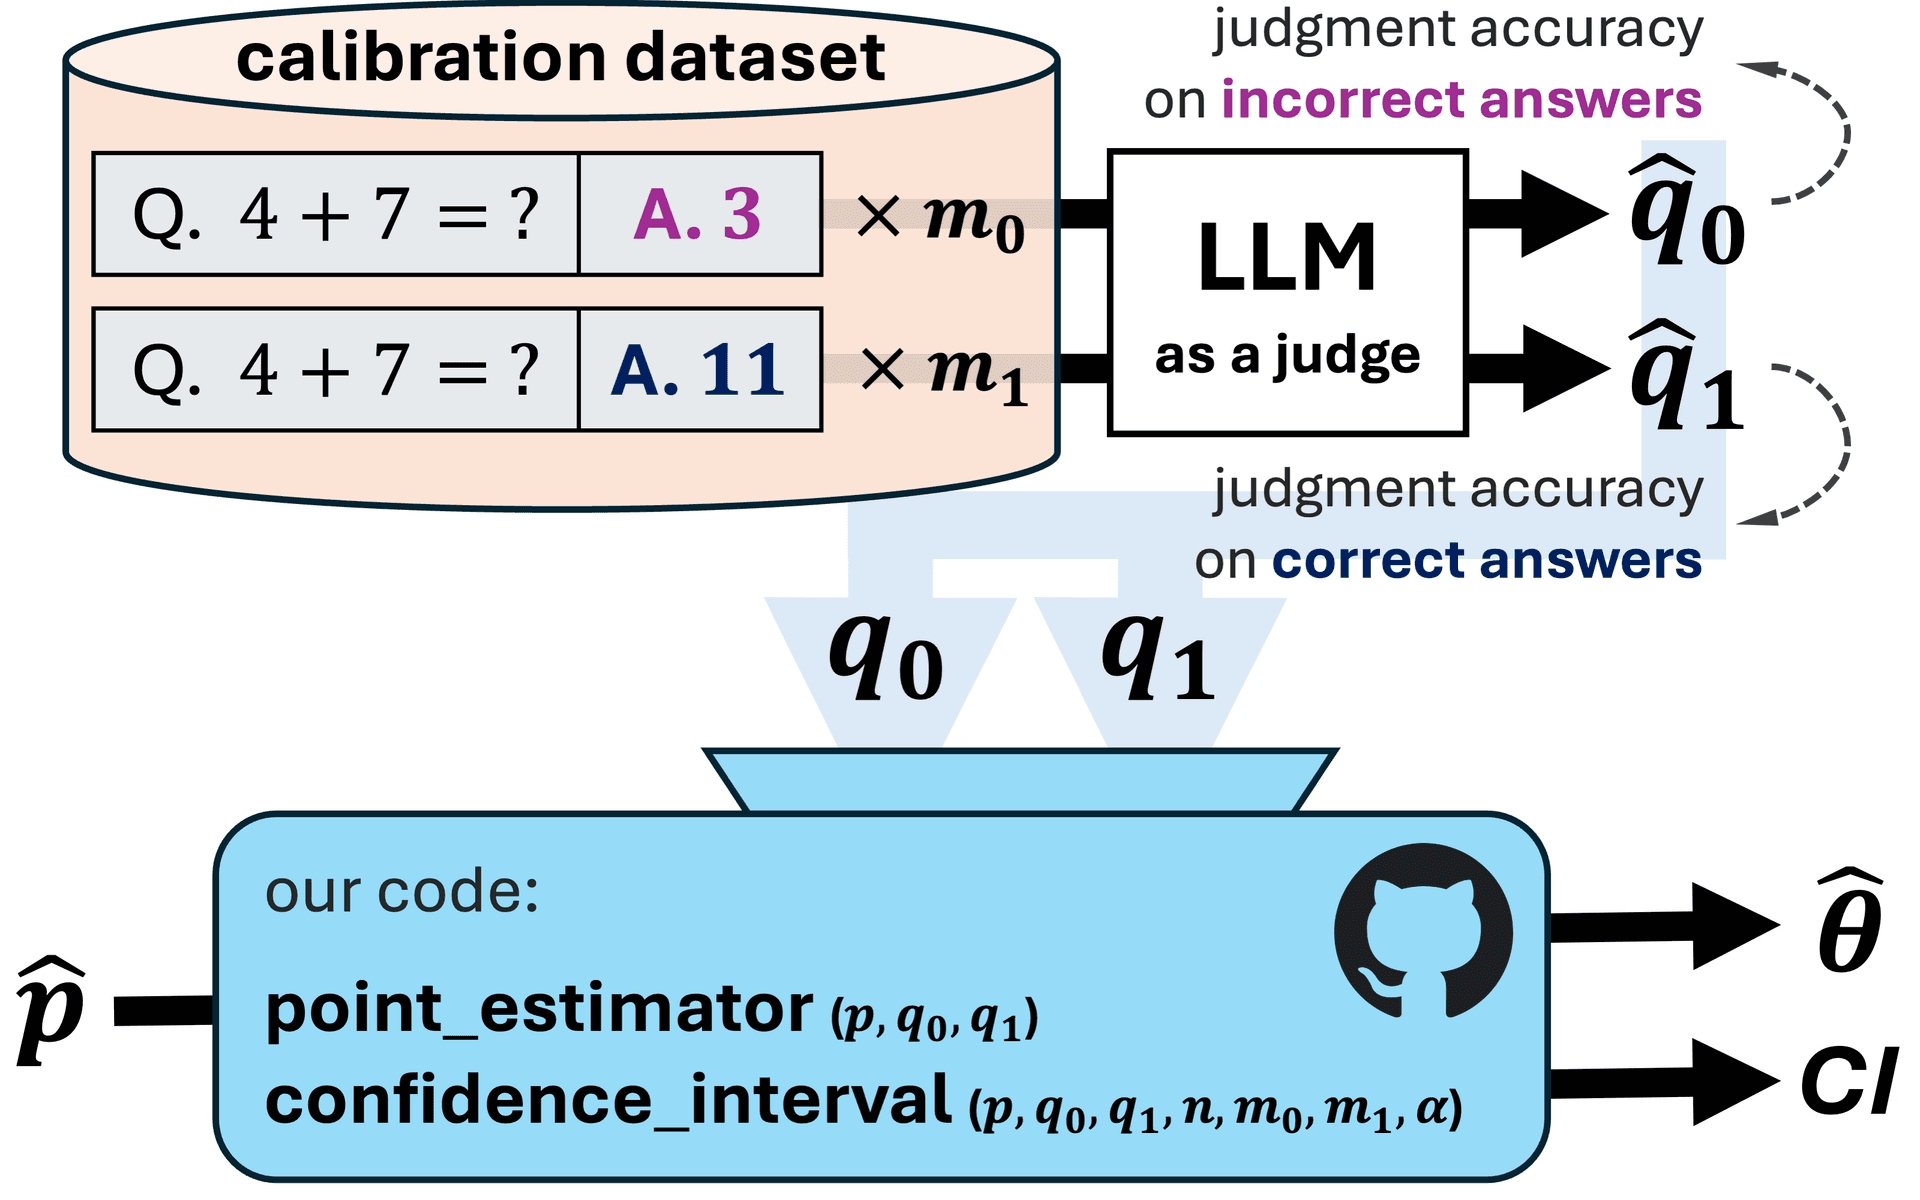 学术引用:Lee, C. et al. (2025). How to Correctly Report LLM-as-a-Judge Evaluations. arXiv:2511.21140
传统的做法是直接用 LLM 的判定结果作为准确率估计,但这种估计是有偏的。项目提供的 point_estimator 函数基于以下公式进行校正:
θ = (p + q₀ - 1) / (q₀ + q₁ - 1) 其中:
p:LLM 在测试集上判定"正确"的比例q₀:特异度,即 LLM 对"已知错误"样本判定为"错误"的概率q₁:灵敏度,即 LLM 对"已知正确"样本判定为"正确"的概率
这个公式的本质是:先算出 LLM 的"乱猜概率",然后从观测值中剔除这部分噪音。传统的学术报告通常只报一个点估计值,比如"准确率 78.3%"。但研究团队认为,区间比点更重要,因为置信区间同时反映了测试集和校准集两个数据源的随机性。
confidence_interval 函数输出的 95% 置信区间:
from llm_judge_reporting import point_estimator, confidence_interval

p = 0.4; n = 1000
q0 = 0.7; q1 = 0.9; m0 = 200; m1 = 200

th_hat = point_estimator(p, q0, q1)
ci = confidence_interval(p, q0, q1, n, m0, m1, alpha=0.05)
print(f"theta_hat = {th_hat:.4f}")
print(f"95% CI = ({ci[0]:.4f}, {ci[1]:.4f})")
输出结果:theta_hat = 0.3750,95% CI = (0.3456, 0.4044)。可见区间宽度约 6 个百分点,反映了估计的不确定性。
allocate_calibration_sample 函数使用自适应算法来优化这个分配,使得最终准确率估计的方差最小。项目采用标准的 Python 库架构,核心代码位于 llm_judge_reporting/ 包:
| 文件 | 功能 |
|---|---|
calibration.py | 偏差校正与置信区间计算 |
allocation.py | 校准样本自适应分配算法 |
__init__.py | 模块导出 |
run/ 目录下),方便无 Notebook 环境的用户使用。安装方式符合标准 Python 包规范:
# 从 GitHub 安装
pip install "git+https://github.com/UW-Madison-Lee-Lab/LLM-judge-reporting.git"

# 或开发模式
git clone https://github.com/UW-Madison-Lee-Lab/LLM-judge-reporting.git
cd LLM-judge-reporting
pip install -e .
项目也坦诚说明了使用前提:
q₀ + q₁ > 1,即 LLM 的判断能力要好过"瞎猜"。如果 LLM 的判断还不如随机,这个校正框架就不适用了(因为分母为零)。LLM-as-a-Judge 已经成为 RLHF(人类反馈强化学习)和模型对比研究的核心手段,但这套方法论在统计层面的严谨性长期被忽视。这篇论文(以及配套工具)的价值在于:
仓库地址:UW-Madison-Lee-Lab/LLM-judge-reporting
论文:arXiv:2511.21140
作者:Chungpa Lee, Thomas Zeng (UW-Madison) · Jy-yong Sohn (Yonsei) · Kangwook Lee (KRAFTON)
