
edge-lm
TheStageAI/edge-lm加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你坐在咖啡馆里,用一台没有风扇声的 MacBook,写完一段 prompt,几秒钟后屏幕上流式输出了一段质量不错的文本——没有云端 API 延迟,没有数据外传的隐私担忧,整个推理过程发生在你的本地。这不是设想,而是 edge-lm 正在实现的事情。
edge-lm 是 TheStageAI 开源的大语言模型本地推理运行时,专为 Apple Silicon 优化。它的核心目标是:把原本需要昂贵 GPU 服务器才能跑的大模型,压缩到可以直接在一台 Mac 上高效运行。
大语言模型的推理成本一直是 AI 落地的主要障碍。GPT-4、Claude 3.5 等主流模型需要 H100/A100 等高端 GPU,单卡成本动辄数万美元。即便是开源模型如 Llama 3 70B,也需要多卡并行才能流畅推理。
然而 Apple Silicon 的出现改变了游戏规则。M3 Max 拥有 16 核 CPU、40 核 GPU 和高达 192GB 的统一内存架构(Unified Memory),内存带宽高达 800GB/s——这意味着 GPU 和 CPU 实际上在共享同一块超高速内存,避免了传统架构中 PCIe 带宽瓶颈。
edge-lm 正是在这一硬件基础上,针对性地解决了两个核心问题:模型太大放不下 和 推理太慢没法用。
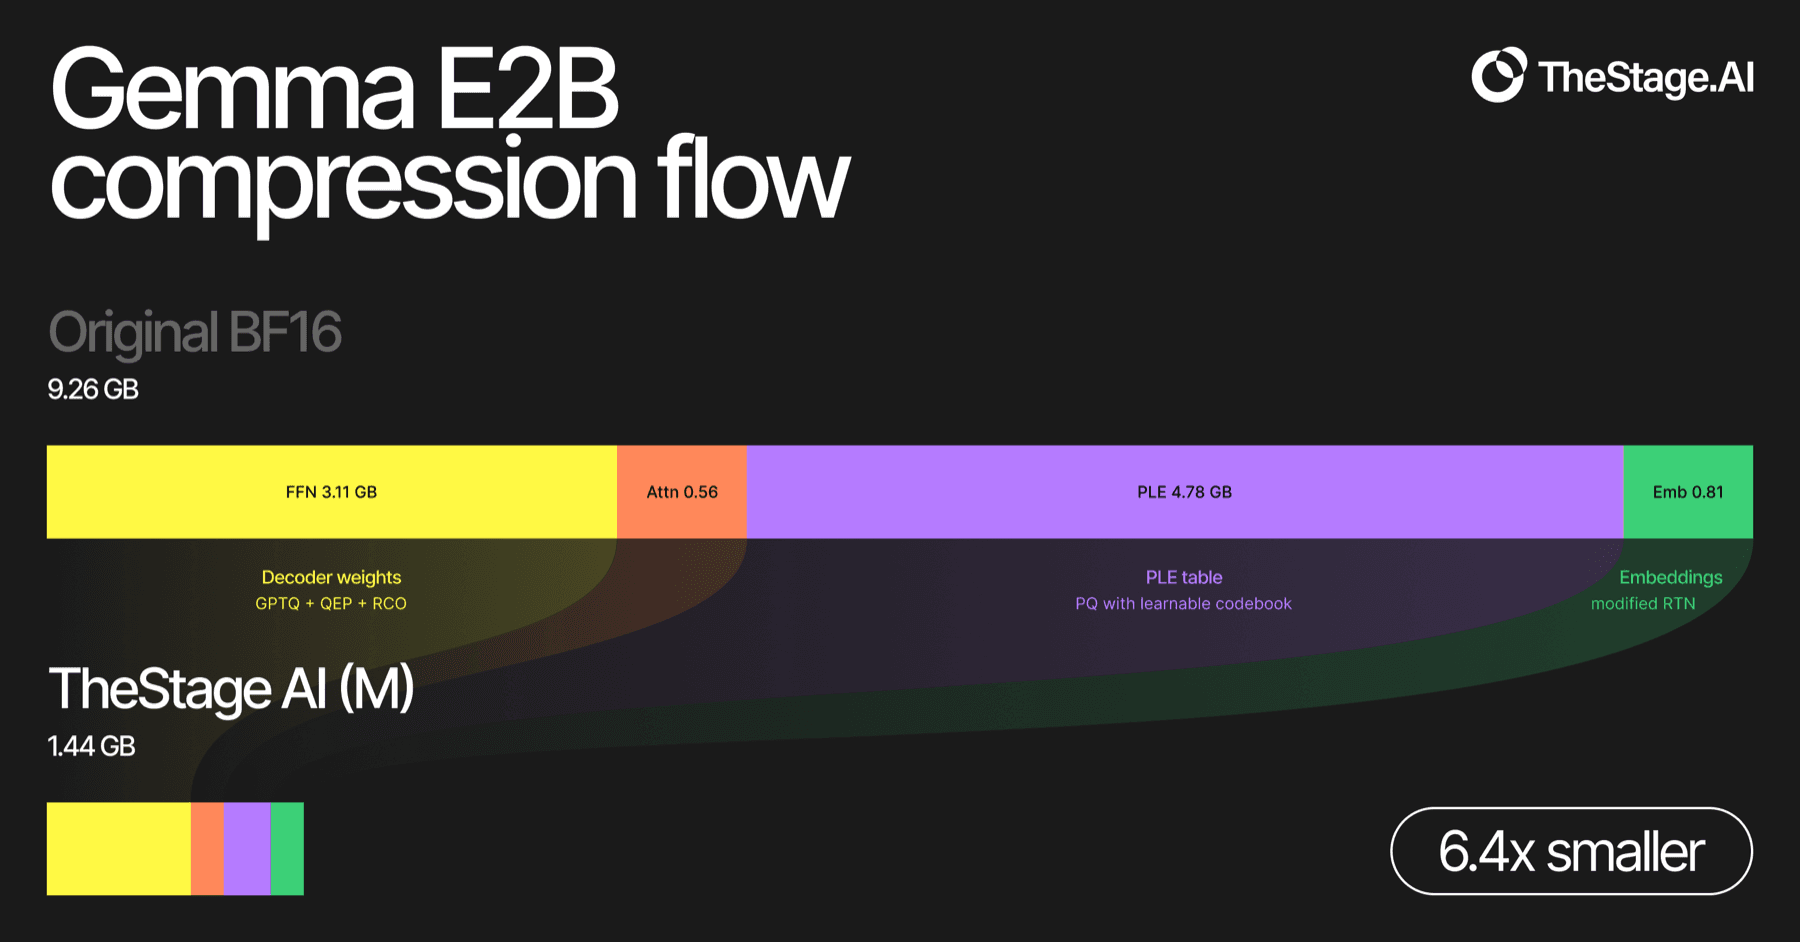
Gemma 4 E2B 原始模型为 9.26GB(BF16 精度),edge-lm 的 M 量化版本仅 1.44GB,压缩比达到 6.4 倍。同等精度下,E4B 模型从 15.88GB 压缩到 2.72GB(压缩比 5.8 倍)。这种压缩并非简单截断,而是通过量化(Quantization)+ Per-Layer Embedding(PLE)压缩的组合策略实现。
关键创新在于 PLE(Per-Layer Embedding)压缩。Gemma 4 模型中,每个 token 对应的 embedding 表体积巨大,传统的量化方法难以有效压缩。edge-lm 的方案是:将 PLE 保留为独立文件,运行时动态加载,而不是全部展开到内存中。这一设计使得内存占用从预估的 8GB+ 降到了 2.1GB。
MLX 是 Apple 开源的机器学习加速框架,针对 Apple Silicon 的统一内存架构进行了深度优化。相比 PyTorch 的 Metal 插件,MLX 能够更高效地利用统一内存,减少 CPU-GPU 数据搬运开销。
edge-lm 加载模型后,返回的是标准的 mlx_vlm 对象,开发者可以使用熟悉的 stream_generate 接口进行流式推理。这意味着已有 MLX 经验的开发者几乎零学习成本即可上手。
在 M3 Max(69GB 统一内存)上,Gemma 4 E2B 量化版本的推理速度达到 115 tokens/s,是 BF16 原版的 2 倍。E4B 版本为 73.7 tokens/s,是原版的 2.4 倍。
质量方面,M 量化版本在 IFEval 指令遵循基准上与 BF16 原版几乎持平(E2B: 75.23% vs 75.23%),但 MMLU-Pro 知识基准有所下降(49.85% vs 61.85%)。L 量化版本通过保留更多精度信息,在质量和体积间取得更好平衡(E2B L: 54.48%,接近 BF16 的 61.85%)。
load() 函数会分别下载 decoder(核心模型权重)、compact PLE(压缩嵌入表)和 tokenizer,按需组装。视觉/音频模块默认不加载,只有在用户主动传入 include_vision=True 或 include_audio=True 时才下载对应权重。
默认加载 E2B M 版本(1.44GB):model, tokenizer = load()
切换 E4B L 版本,开启视觉模块:model, tokenizer = load("TheStageAI/gemma-4-E4B-it", size="l", include_vision=True)
stream_generate 返回的是一个生成器,每次 yield 一个 token chunk,支持流式输出。相比一次性返回全部结果,用户可以更早看到首个 token(TTFT 指标:E2B 仅 434ms),体验接近 ChatGPT 的实时响应。
通过 examples/test_vision.py 和 examples/test_audio.py,开发者可以为模型添加图像理解和语音转录能力。Gemma 4 的视觉塔(Vision Tower)和音频塔(Audio Tower)以独立 safetensors 文件形式提供,按需下载。
examples/chat.py --tools 模式可以为模型赋予执行本地 Python 和 Shell 命令的能力,实现类似 GPT-4 的工具调用功能。项目明确提示:使用前请审查工具定义,以防止恶意代码执行。
纯 pip 安装,无 Dockerfile,无 Docker 依赖。首次运行会自动从 Hugging Face 下载模型权重(E2B M 版本约 1.44GB)。
硬件门槛:最低配置为一台 M1/M2/M3/M4 系列 Mac,Python 3.10+。推荐 16GB+ 统一内存(E2B M 版本实测峰值内存 2.1GB,E4B M 版本 3.5GB)。无 NVIDIA GPU 要求,无 CUDA 环境依赖。
适用场景:移动办公(离线推理)、隐私敏感场景(医疗/法律/金融数据不上云)、开发调试(快速迭代 prompt)、个人 AI 助手(本地知识库 + RAG)。
平台唯一:仅 Apple Silicon,不支持 Intel Mac 和 Linux/Windows。非 Apple 平台用户建议使用该项目的 GGUF 版本(Qwen3.5 / Gemma 4 系列),通过 llama.cpp 运行。
量化精度损失:M 版本在知识密集型任务(MMLU-Pro)上相比 BF16 原版有明显下降,L 版本有所改善但仍需权衡。
模型规模受限:目前仅支持 Gemma 4 E2B 和 E4B 两个规模,无法运行 70B+ 级别的大模型。
edge-lm 的出现反映了 2025-2026 年 AI 领域的一个重要趋势:从大模型必须上云到小模型可以本地跑的认知转变。
Apple Silicon 的统一内存架构为这一转变提供了硬件基础。128GB 内存的 M3 Max 可以轻松容纳 7B 量化模型,加上 edge-lm 的 PLE 压缩技术,连 12B 级别的模型也有望在本地运行。
另一方面,edge-lm 的 GGUF 分支(Qwen3.5 / Gemma 4 系列)则面向更广泛的用户群体——无论你用 Linux 服务器、Windows 工作站还是树莓派,都可以通过 llama.cpp 运行这些量化模型。这体现了 TheStageAI 的双轨策略:原生 Apple 平台用 MLX,通用平台用 GGUF。
从技术演进看,量化和架构优化(如 MoE、PLE)正在成为端侧 AI 的两条主线。随着 Apple Silicon 继续迭代(M4 Ultra 传闻统一内存可达 512GB),本地运行的模型规模上限会持续上移。
克隆项目后,依次执行: git clone https://github.com/TheStageAI/edge-lm.git cd edge-lm python -m venv .venv && source .venv/bin/activate pip install -e . python examples/chat.py
也可以通过 Python API 调用: from edge_lm import load from mlx_vlm import stream_generate
model, tokenizer = load() messages = [{"role": "user", "content": "Write a haiku about the moon."}] prompt = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True) for chunk in stream_generate(model, tokenizer, prompt, max_tokens=128): print(chunk.text, end="", flush=True)
数据来源:GitHub 仓库 README 及其 benchmarks 目录,评测环境为 Apple M3 Max 69GB 统一内存。
