
semiont
The-AI-Alliance/semiont加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个这样的场景:你的团队用 AI 处理了上千份法律合同,每次 AI 的回答都言之凿凿,但当你追问"这个结论是从哪份合同的哪一条款得出的"——AI 沉默了。这种"黑箱输出"正是当前 AI 应用最大的信任危机。
Semiont 正是为了解决这个问题而生的。它是一个开源、源码可溯的语义知识平台,为人与 AI 提供共享的"知识工作空间"——人类可以精确标注每一条知识的来源,AI 可以基于这些可信的知识图谱给出可溯源的答案,而不是凭空编造。
项目的核心理念:知识必须"source-grounded",即每一条 AI 生成的知识都必须能追溯到原始文档中的具体位置。
Semiont 由 The AI Alliance 开发维护——这是一个涵盖 IBM、Meta、Intel、NASA、NASA FDL 等机构的非营利组织,目标是推动开源 AI 的安全与负责任发展。Semiont 承担着 Alliance 对"可信 AI 知识基础设施"的探索使命,是联盟在知识管理领域的旗舰开源项目。
从技术演进角度看,Semiont 处于 RAG(检索增强生成)与成熟知识图谱之间的地带:它不像传统 RAG 那样做粗粒度的向量检索,而是引入了细粒度的语义标注层——用户可以对文本中的任意片段打标签、建立关系、添加解释,AI 的每一步推理都能精确对应到这些标注。
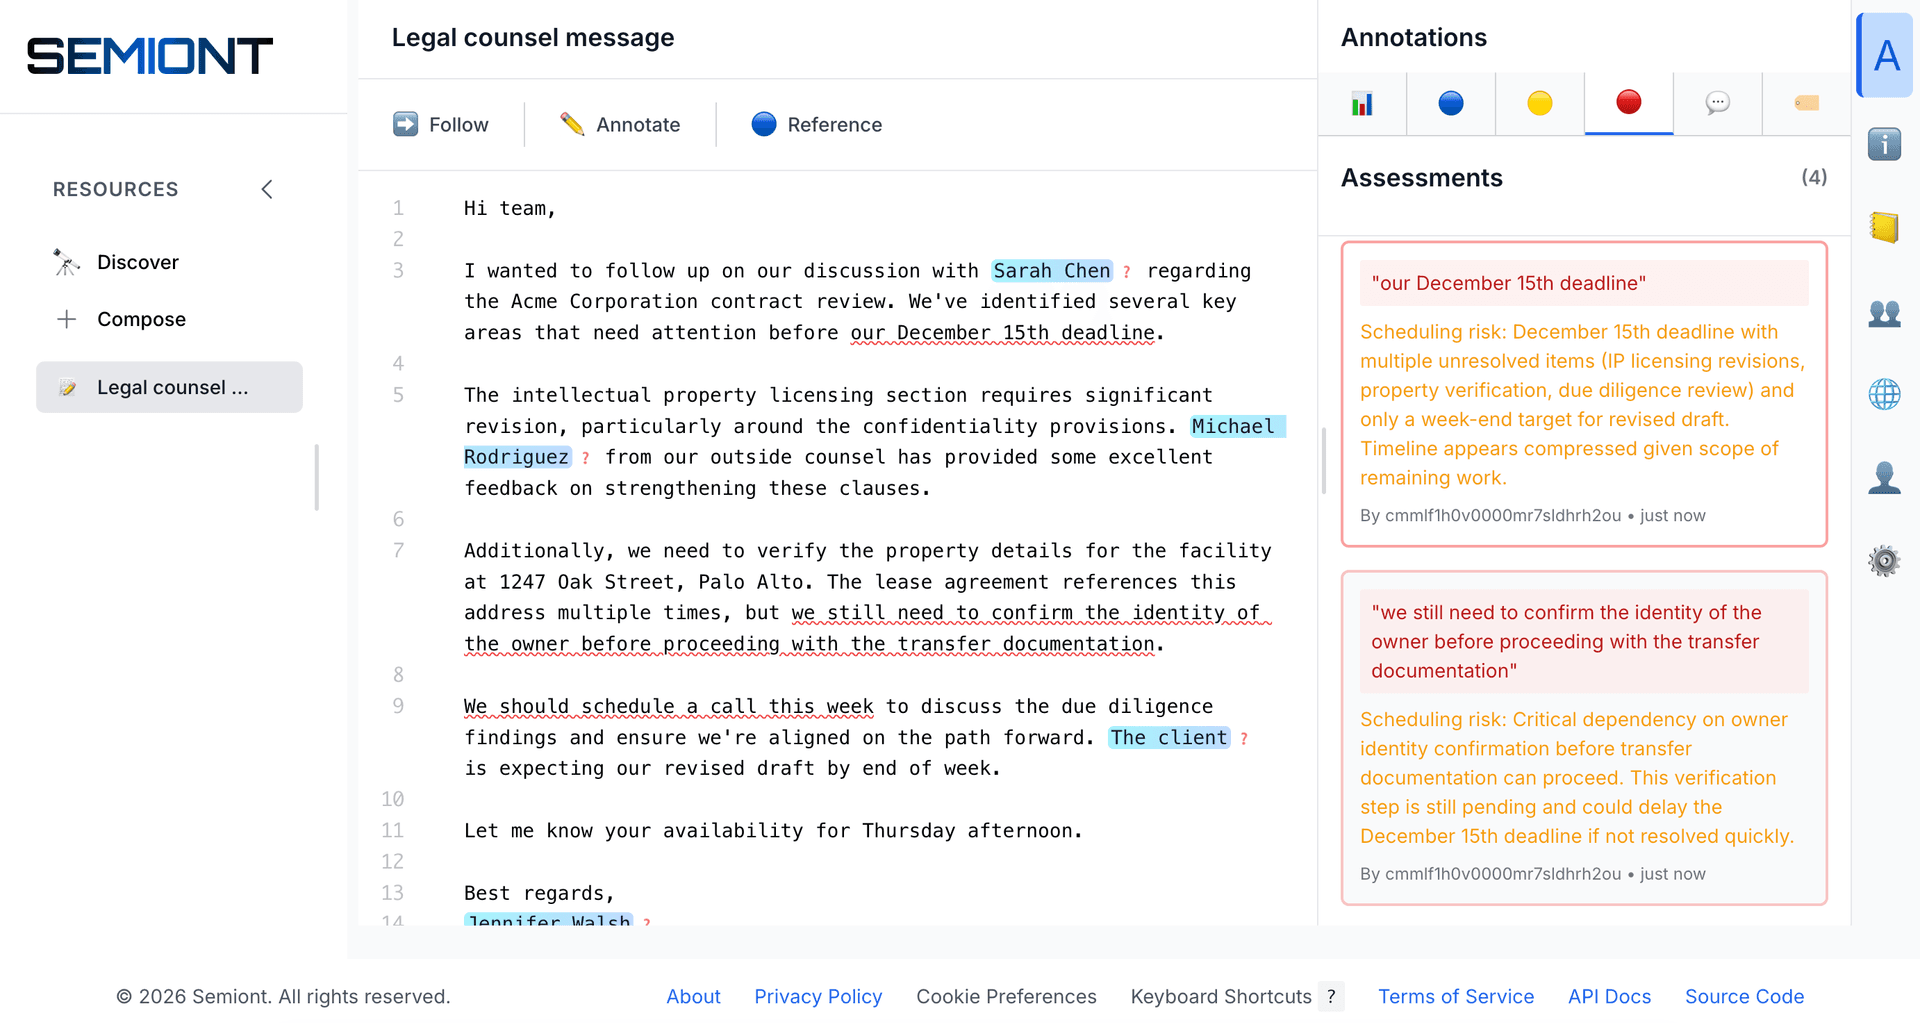 Semiont 的知识浏览界面,支持多语言国际化
Semiont 不把自己定义为单一的"工具",而是支持五种灵活的使用范式,用户可以根据场景切换:
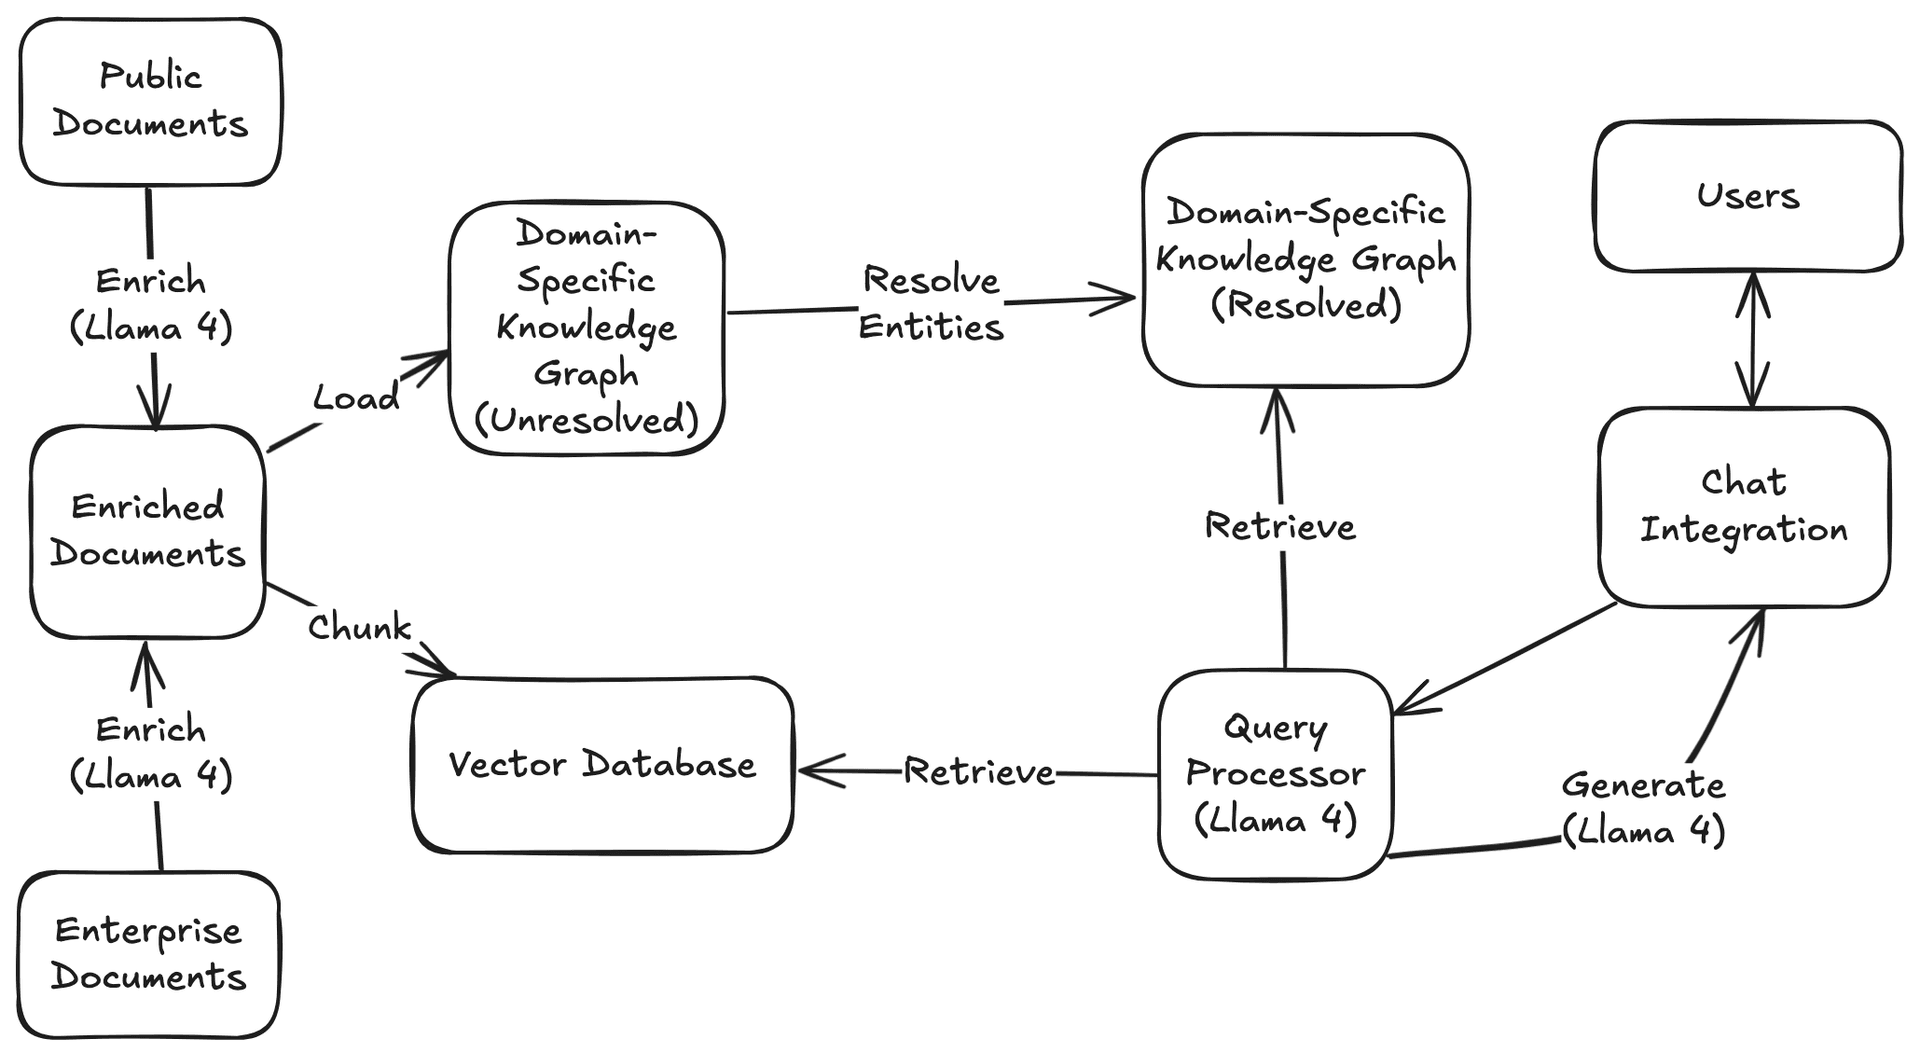 Semiont 的知识图谱架构,支持多源知识融合与关系建模
Semiont 采用 pnpm monorepo 架构,主仓库包含 17 个内部包和 4 个应用,设计清晰:
基础设施层:
@semiont/core:核心域模型与业务逻辑@semiont/event-sourcing:事件溯源引擎,保证所有操作的不可变性@semiont/observability:可观测性(日志、追踪、指标)知识处理层:
@semiont/content:内容解析与管理@semiont/ontology:本体论模型(定义知识结构的"语法")@semiont/graph:图引擎(基于 Neo4j),负责节点/边的 CRUD 与图遍历@semiont/vectors:向量存储(基于 Qdrant),支持语义检索@semiont/make-meaning:语义注解引擎——这是 Semiont 最有特色的模块,实现了从原文到结构化知识的映射传输与集成层:
@semiont/http-transport:HTTP API 层@semiont/inference:推理引擎抽象层,支持 Anthropic (Claude) 和 Ollama@semiont/mcp-server:Model Context Protocol 服务器,使 Semiont 可被 AI Agent 调用@semiont/sdk / @semiont/sdk-go:多语言 SDK(TypeScript + Go)应用层:
apps/backend:后端 API(Hono + Prisma + PostgreSQL + Neo4j + Qdrant)apps/frontend:Web 浏览器(React 19)apps/desktop:原生桌面客户端apps/launcher:跨平台启动器(Go 二进制),封装了 Docker/Podman 容器管理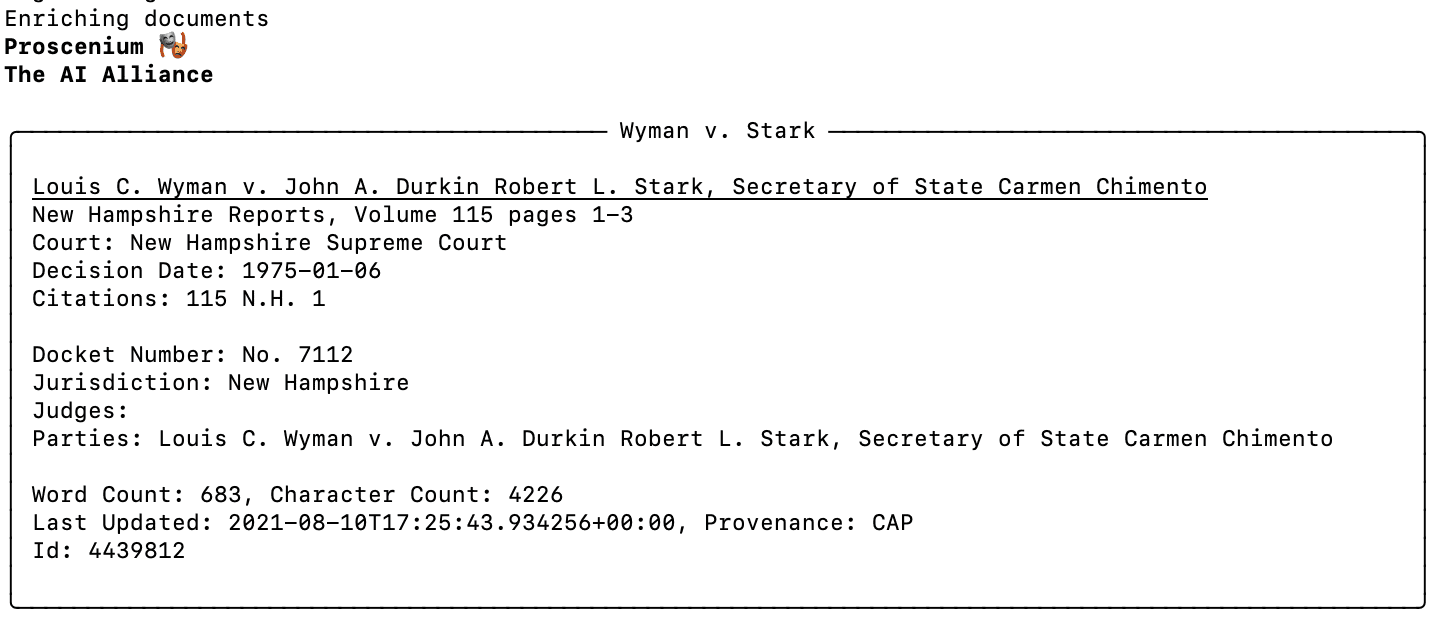 Semiont 的语义注解界面,用户可以为任意文本建立知识关联
Semiont 的安装体验经过精心设计,普通人也能完成:
# 1. 安装 launcher(Go 二进制,无 Node.js 依赖)
brew install the-ai-alliance/semiont/semiont

# 2. 克隆一个现成的知识库演示
git clone https://github.com/The-AI-Alliance/semiont-gutenberg-kb.git
cd semiont-gutenberg-kb

# 3. 启动(自动检测 Docker/Podman,自动拉取镜像)
semiont start

# 4. 创建管理员账户
semiont useradd --email admin@example.com --admin

# 5. 打开浏览器 http://localhost:3000 开始使用
整个过程约 5-10 分钟(首次拉取镜像需要一些时间)。如果选择本地推理模式(Ollama),则完全不依赖外部云服务,数据完全私有。
1. 复杂度较高:Semiont 的设计面向中大型团队的知识管理场景,对于个人用户或小型项目而言,架构偏重,学习曲线较陡。
2. 仍在 Alpha 阶段:官方明确声明 0.x 版本 API 不稳定,破坏性变更预期会发生,生产环境使用存在风险。
3. 知识质量依赖人工标注:虽然 AI 可以辅助生成标注,但高价值的知识图谱仍需大量人工参与——这是一个"garbage in, garbage out"的领域,Semiont 并不能替代知识工程本身的工作。
4. 多 Agent 协作尚未成熟:Agentic Memory 模式是一个有前景的方向,但目前 SDK 和协议仍在演进中,多 Agent 并发访问同一知识库的一致性问题还需要更多验证。
在 AI 应用爆发式增长的当下,"AI 幻觉"和"不可解释输出"是阻碍 AI 在企业场景落地的核心障碍。Semiont 代表了一种**"知识优先"的技术路线**:不是让 AI 自己记忆,而是为 AI 构建一个结构化的、可信的、人类可审计的知识环境。
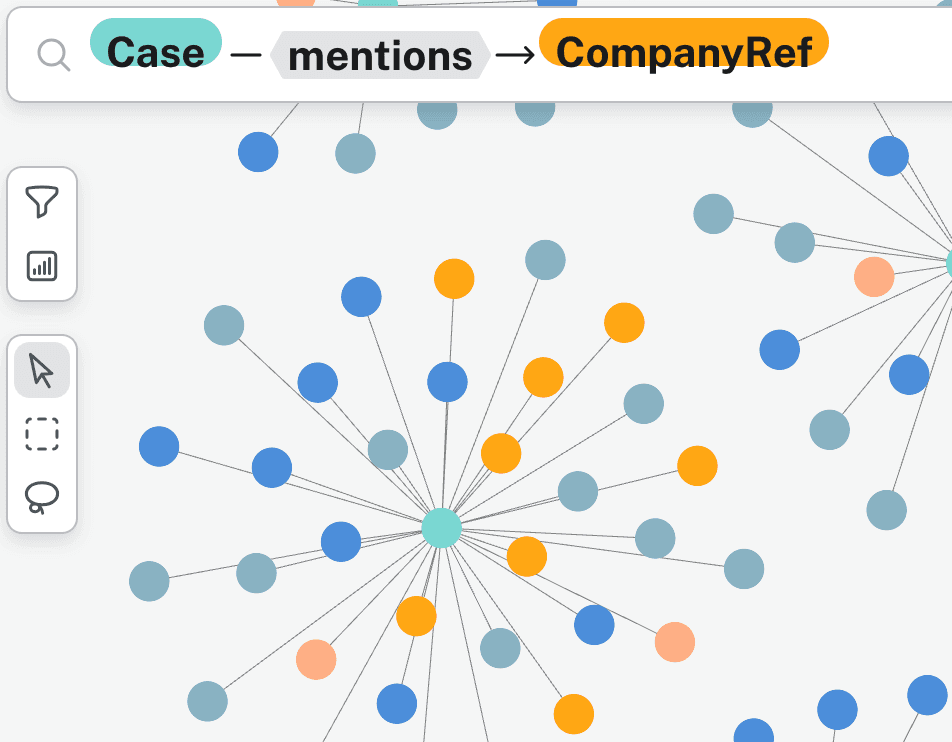 法律领域的知识图谱示例,节点代表法律概念,边代表语义关系
从增长曲线看,The AI Alliance 作为背书方为项目带来了较高的可信度,monorepo 中 17 个包的高内聚设计也显示出成熟的工程实践。虽然目前 stars 数(88)尚处于早期,但项目背后的理念和技术深度,值得持续关注。
一句话总结:Semiont 是 AI 时代知识管理的基础设施级项目,通过细粒度语义标注和可溯源推理,让 AI 的每一步判断都有据可查——是解决 RAG"幻觉"问题的一条有深度的技术路径。
