
Hunyuan3D-1
Tencent-Hunyuan/Hunyuan3D-1加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。

图:Hunyuan3D-1.0 的文生 3D / 图生 3D 效果演示(来源:官方仓库 assets/teaser.png)
做游戏美术的人大概都熟悉这种场景:需求来了一个"废弃空间站里的机械守卫",美术同学要先画概念图,再做高模、贴图、绑定,一轮下来一周。而 2024 年底前后,AI 3D 生成工具开始挤进这条流水线——输入一张图或者一句话,几十秒内吐出一个带贴图的三角网格模型(mesh)。但当时的工具大多有个通病:慢,而且糊。生成一个模型动辄几十分钟,出来的几何细节还经不起近景镜头检验。
腾讯混元团队在 2024 年 11 月 5 日开源的 Hunyuan3D-1.0,试图同时解决这两件事。它的核心主张写在技术报告里:两阶段、约 11 秒——多视角扩散约 4 秒生成 6 张不同角度的 RGB 视图,前馈重建模型约 7 秒把多视图重建成 3D 网格。
理解这个框架的关键,是搞懂它要解决的建模难题。
传统 3D 生成(比如早期基于 NeRF 或 3D 扩散的方法)常常是"给一张正面图,猜出侧面和背面"。问题是侧面信息根本不在输入里,模型只能靠先验脑补,结果就是背面结构崩坏、细节不可信。
Hunyuan3D-1.0 的思路是把它拆成两步走:第一步用多视角扩散模型(MVD) 围绕输入图生成 6 个固定相机位姿的 RGB 图像(方位角 +0°、+60°、+120°、+180°、+240°、+300°,仰角 15°,共 60 个视图),相当于拿相机绕着物体"拍了一圈照片";第二步用**前馈重建模型(svrm / MV23D)**把这组多视图一次性重建成高保真网格。
这样重建任务的难度从"单视图补全"降级成"多视图融合",几何一致性自然好很多。而前馈式(feed-forward)重建取代了传统的 NeRF 逐场景优化,是速度能压到 7 秒的根本原因——不训练、不迭代优化,开箱即用。
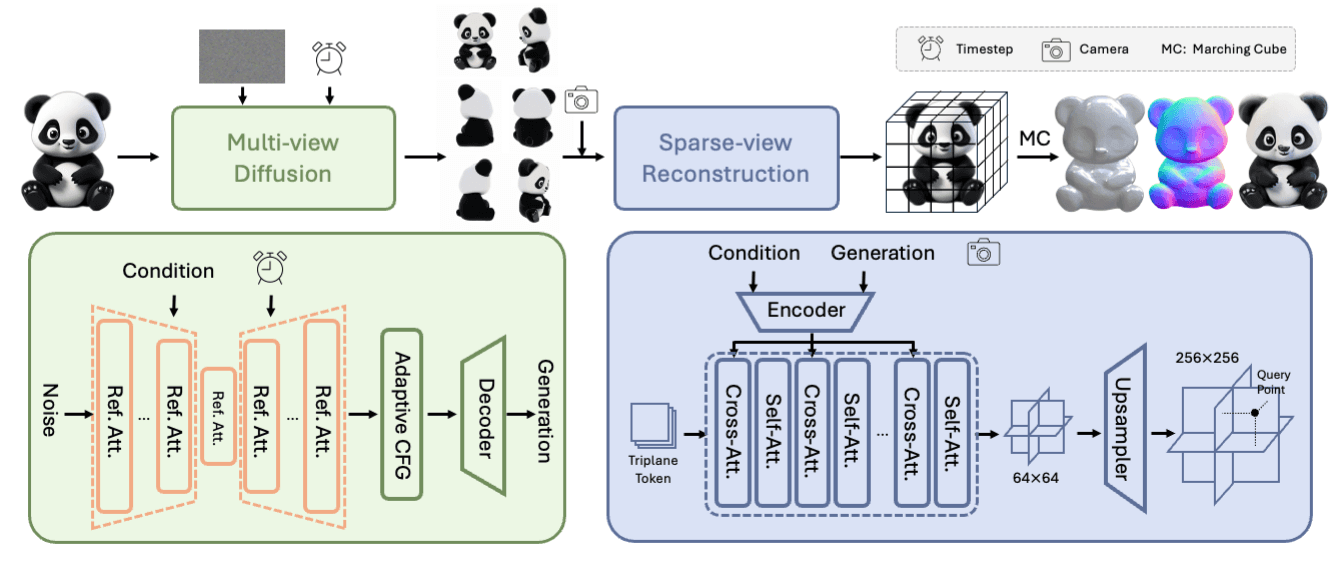
图:Hunyuan3D-1.0 两阶段架构——多视图扩散生成 + 前馈网格重建(来源:官方 assets/overview_3.png)
一个容易被忽略但很实用的细节:文本和图像走同一条管线。文生 3D 并不是独立模型,而是先用 Hunyuan-DiT 文生图模型把 prompt 变成一张图,再送进同一条 MVD + 重建链路。这就是 README 里说的"统一框架",也解释了为什么 infer/text_to_image.py 里直接 import 的是 HunyuanDiTPipeline。
如果把整个流程比作现实中的雕塑流程:
关键在于雕塑师不是"边雕边看边改",而是一次成型——这就是 feed-forward 的意思。
仓库的代码组织清晰地对应了两阶段架构:
| 目录 | 职责 |
|---|---|
infer/ | 推理封装层:text_to_image.py(Hunyuan-DiT 文生图)、image_to_views.py(MVD 多视图)、views_to_mesh.py(svrm 重建)、removebg.py(抠图)、gif_render.py(动画渲染) |
mvd/ | 多视角扩散管线实现:hunyuan3d_mvd_std_pipeline.py(标准版)、hunyuan3d_mvd_lite_pipeline.py(轻量版) |
svrm/ | 前馈重建网络:predictor.py(MV23DPredictor)+ ldm/(Latent Diffusion 重建骨干)+ configs/svrm.yaml |
third_party/ | 纹理烘焙模块:mesh_baker.py、gen_baking.py、dust3r_utils.py,依赖 naver/dust3r |
app.py | Gradio Web 界面,监听 8080 端口 |
main.py | 命令行入口,支持 --text_prompt / --image_prompt / --do_texture_mapping / --do_bake / --do_render |
模型权重分四个放在 HuggingFace:Hunyuan3D-1/lite、Hunyuan3D-1/std、Hunyuan3D-1/svrm,以及文本生成用的 Tencent-Hunyuan/HunyuanDiT-v1.1-Diffusers-Distilled。
两个版本:Lite 版参数量约为标准版的 1/3,速度更快、显存更低(22GB),适合快速预览和批量出草稿;标准版(std)参数量是 Lite 的 3 倍,也是"和其他现有模型"相比的量级(README 原话:"Our standard version has 3x more parameters than our lite and other existing model"),质量更好但要 30GB 显存。
命令行(main.py)适合批处理和 CI 集成:
python3 main.py --image_prompt "./demos/example_000.png" \
    --save_folder ./outputs/test/ --max_faces_num 90000 \
    --do_texture_mapping --do_render
常用参数:--max_faces_num 控制网格面数上限(默认 9 万)、--save_memory 把模块自动搬到 CPU 换取显存(但推理变慢)、--do_texture_mapping 切换顶点着色到纹理着色、--do_bake 启用纹理烘焙、--bake_align_times 控制图像与网格的对齐次数(默认 3)。
Web UI(app.py)适合交互式试错:
python3 app.py                 # 标准版
python3 app.py --use_lite      # 轻量版
python3 app.py --save_memory   # 省显存模式
启动后访问 http://服务器IP:8080。
显存不足时的分段执行方案(这是很贴心的一处设计):仓库提供了 8 个脚本,其中 *_separately.sh 系列把 MVD 和重建拆开跑,中间落盘传参。实测门槛降到:Lite 段化执行 10GB,Std 段化执行 16GB——这让 16GB 显卡的机器也有机会跑起来。
1. 许可证不是 Apache 2.0,商用受限。 这是最容易踩坑的地方。GitHub API 返回的 spdx_id 是 NOASSERTION,实际 LICENSE.txt 是 TENCENT HUNYUAN NON-COMMERCIAL LICENSE AGREEMENT,明确限定"Non-Commercial"指学术、研究和教育用途。虽然源码头部注释写着 "Open Source Model Licensed under the Apache License Version 2.0",但那指的是第三方组件;混元模型本身、权重、训练代码、推理代码都归非商用协议管。另外烘焙模块依赖的 naver/dust3r 是 CC BY-NC-SA 4.0,同样非商用,README 里专门加粗提示了这一点。做商业项目必须先过一遍法务。
2. 训练代码没有开源。 README 的 Open-source Plan 里明确打勾的是:Inference、Checkpoints、Baking;未完成的是:ComfyUI、Training、Distillation Version、TensorRT Version。也就是说想微调、想蒸馏小模型、想上 TensorRT 加速,全部得自己从零来。
3. 仓库已实质停更,且被 2.0/2.1 取代。 最后一次 push 是 2025-11-19,但 README 里主推的已经是 Hunyuan3D 2.0(2025-01-21)、2.1(2025-06-13)和 HunyuanWorld-1.0(2025-07-26)。1.0 属于"历史版本",新项目建议直接看 2.1。
4. 安装是最难的部分。 README 自己都承认:"Most environment errors are caused by a mismatch between machine and packages"。pytorch3d 和 nvdiffrast 必须源码编译,要求 gcc > 9 且 GPU 驱动不能太旧;torch 版本还给出了具体成功案例(python3.9 配 torch 2.0.1 + cu118)。第三方社区倒是迅速补上了 ComfyUI 封装(jtydhr88、MrForExample、TTPlanetPig 等三个 wrapper),但那是社区维护,不是官方承诺。
5. 无 Dockerfile。 仓库里没有 Dockerfile、docker-compose.yml、任何 K8s manifest,也没有 CI 配置。容器化得完全靠用户自己写。
6. 版权与伦理来源不明。 模型权重放在 HuggingFace,但 README 没有交代训练数据来源。3D 生成模型的训练语料普遍涉及版权不明的 3D 资产,这是该领域尚未解决的系统性问题。
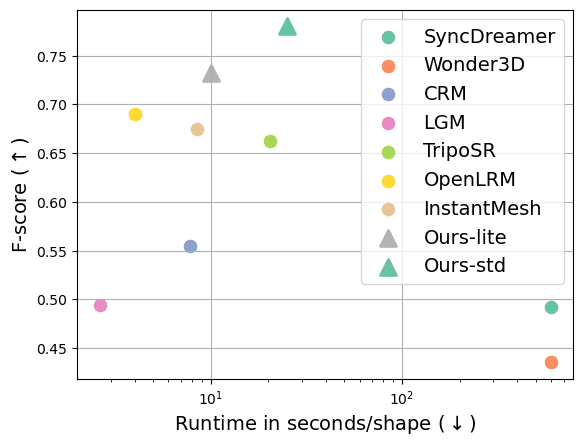
图:Hunyuan3D-1.0 与其他开源 3D 生成方法的速度-质量对比(来源:官方 assets/runtime.png)
官方评测称 Hunyuan3D-1.0 在 5 项用户偏好指标上均取得最高分,Lite 版约 10 秒产出一个网格、标准版约 25 秒。
放在当时的时间线里看,它的意义不在于单项指标第一,而在于把"可用"的门槛降低了:
这也解释了为什么 Hunyuan3D 系列会一路演进到 2.0 / 2.1 / World-1.0——团队显然把"生成即所得"这条路线跑通了。
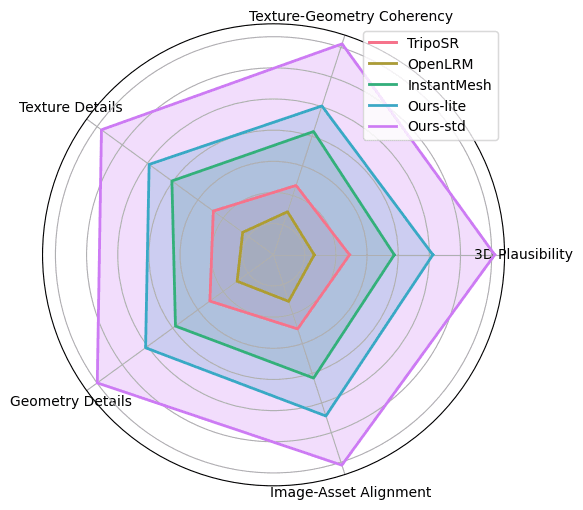
图:五项指标用户偏好对比,Hunyuan3D-1.0 全面领先(来源:官方 assets/radar.png)
Hunyuan3D-1.0 是一套工程完成度相当高的两阶段 3D 生成框架:技术选型清晰(前馈重建是关键取舍)、代码分层干净、显存适配考虑周到、脚本齐全。它的短板不在代码,而在许可证(严格非商用)、训练代码缺失、依赖安装地狱,以及已被自家 2.1 迭代超越。
给团队的落地建议:
env_install.sh 装环境,从 scripts/*_separately.sh 系列起步,成功率最高数据来源:GitHub API(Tencent-Hunyuan/Hunyuan3D-1,3500 stars / 280 forks / 31 open issues,最后提交 2025-11-19)、arXiv:2411.02293 技术报告(v5,2025-01-23)、仓库 README 与源码实读。
分析时间:2026-10-28
