
QuickVideo
TIGER-AI-Lab/QuickVideo加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一个场景:周一早上,产品经理甩给你一段两小时的会议录像,要求你整理出所有待办事项和决策结论。普通视频模型要么"读不完"(视频太长直接崩溃),要么"读太慢"(等一杯咖啡的功夫还没跑完开头)。这就是长视频理解长期面临的困境——视频解码慢 + Token 太多,让强大的视频大模型在真实场景中寸步难行。
长视频理解(TMLR 2025 收录)源于一个真实的痛点:视频大模型(VideoLLM)看似强大,实际处理小时级视频时却举步维艰。
滑铁卢大学 TIGER-AI Lab(SeaAI Lab)团队深入分析后,发现了两大瓶颈:
瓶颈一:视频解码龟速。原始视频是压缩的比特流,要先解码成 RGB 帧才能喂给模型。对于一部两小时的电影,用传统工具把视频全部解码出来,可能需要 50-60 秒。这还没开始"理解",光"看"完就让人等到不耐烦。
瓶颈二:Token 爆炸。视频本质上是大量图片的序列,而 LLM 处理 Token 有成本。一小时视频以 1 FPS 采样就是 3600 帧,每帧配合 Qwen2.5-VL 处理,Token 数量轻松破百万——GPU 显存直接爆表,推理延迟高到不可接受。
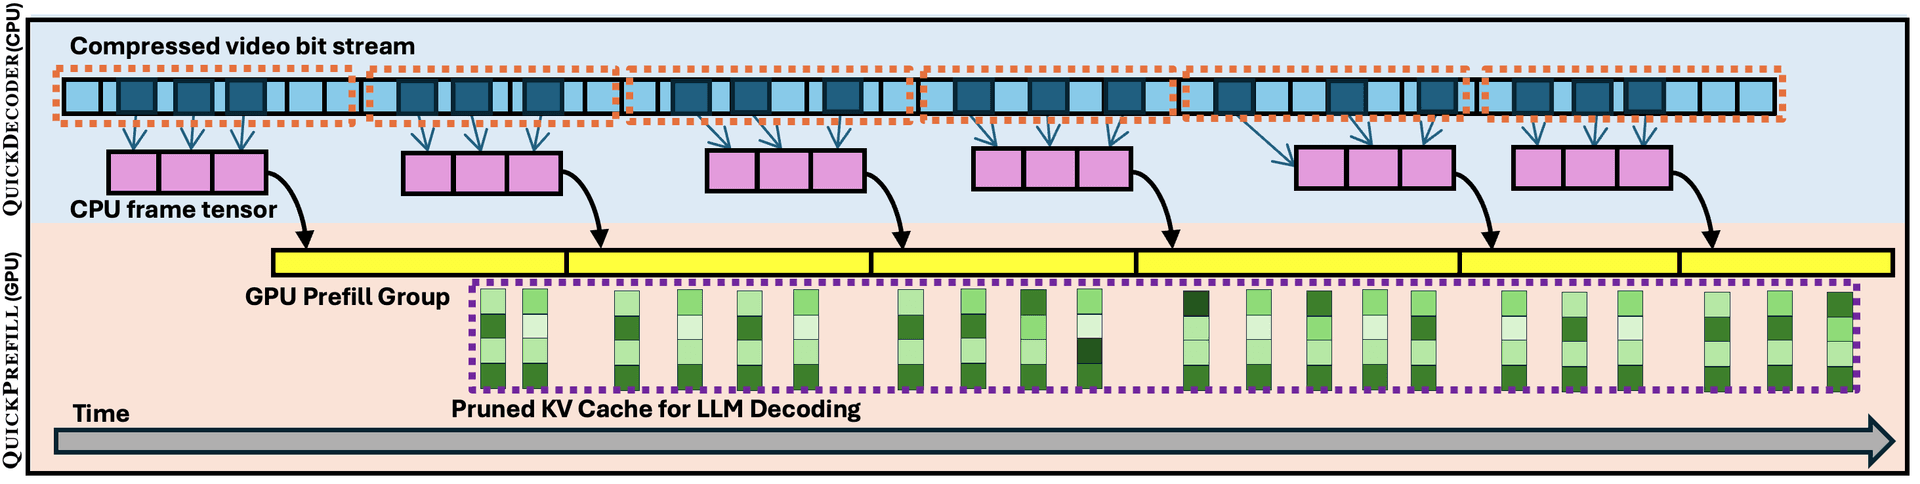
QuickVideo 没有选择"训练更大的模型"这条老路,而是从系统层面和算法层面双管齐下,用"更聪明的策略"减少不必要的工作。
QuickDecoder(系统加速):把视频解码从单线程串行改为 CPU 多核并行。视频被切分成多个区间,CPU 多核同时处理,整体解码速度提升 2-3 倍。
QuickPrefill(算法优化):不是所有 KV-Cache 都需要保留。团队设计了 KV-Cache 剪枝策略——按 Key Norm(L2 范数)挑选最重要的 Token,保留约 50% 的 KV 对,就能维持 97% 的原始性能。这背后的洞察是:视频帧之间存在大量信息冗余,不需要全部保留。
重叠流水线(Pipeline):CPU 解码和 GPU 推理不再是先后的"串联"关系,而是同时进行的"并联"——CPU 边解码后面的帧,GPU 边处理已解码好的帧。最终端到端延迟从 70 秒降到 20 秒,提速 3.5 倍。
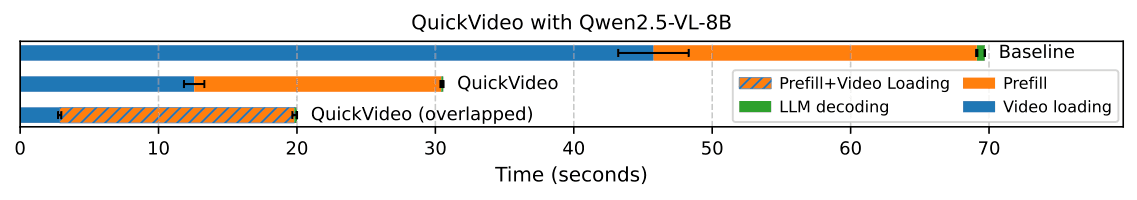
这是开发者最关心的部分。QuickVideo 的核心创新在于 Group-based Prefilling + KV-Cache 剪枝。
将视频帧分成多个组(Group),每组共享一个压缩表示。组内帧共享 KV-Cache,大幅减少 Token 总数。例如 Group Size=16 时,64 帧视频只需要处理更少的 Token。
L2 范数(Key Norm)是衡量每个 Key 向量"重要性"的指标。直觉上:某些 Key 对最终注意力分数的贡献更大,保留这些 Key 就够了。实验表明,保留 Top 50% 的 Key(ρ=0.5),性能损失极小。
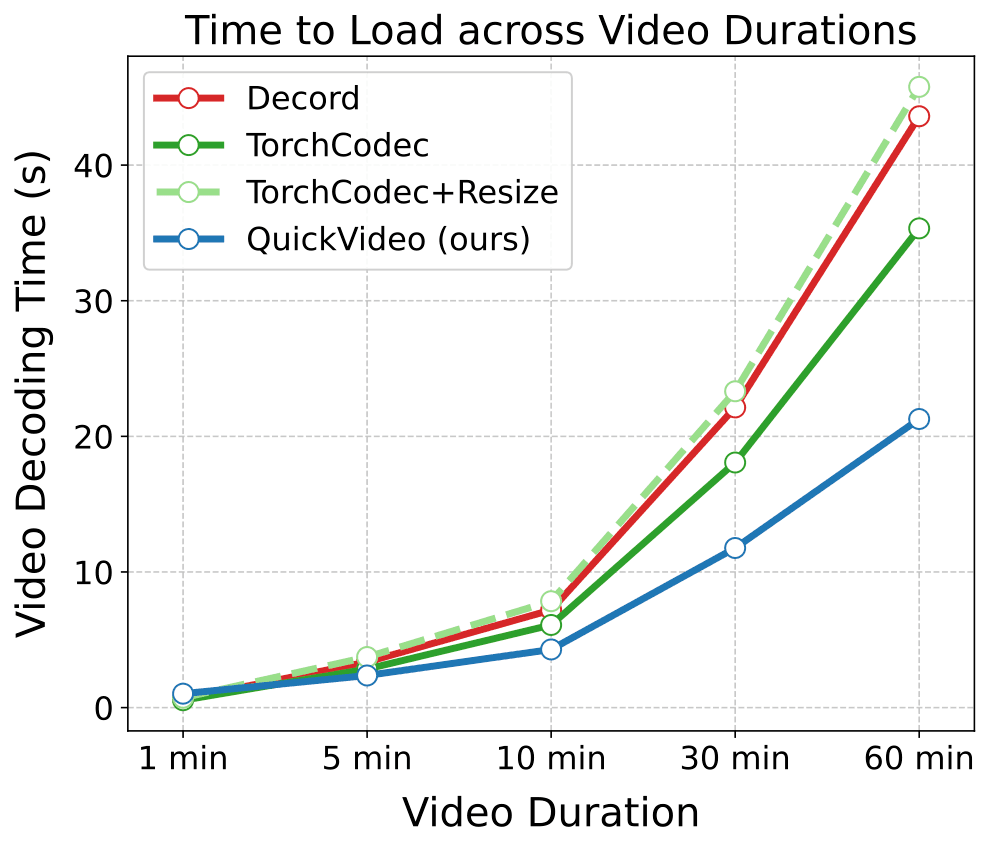
团队还开源了 QuickCodec,基于神经网络视频解码(DeepCodec),比传统解码器更快更智能,与 QuickVideo 形成完整加速闭环。
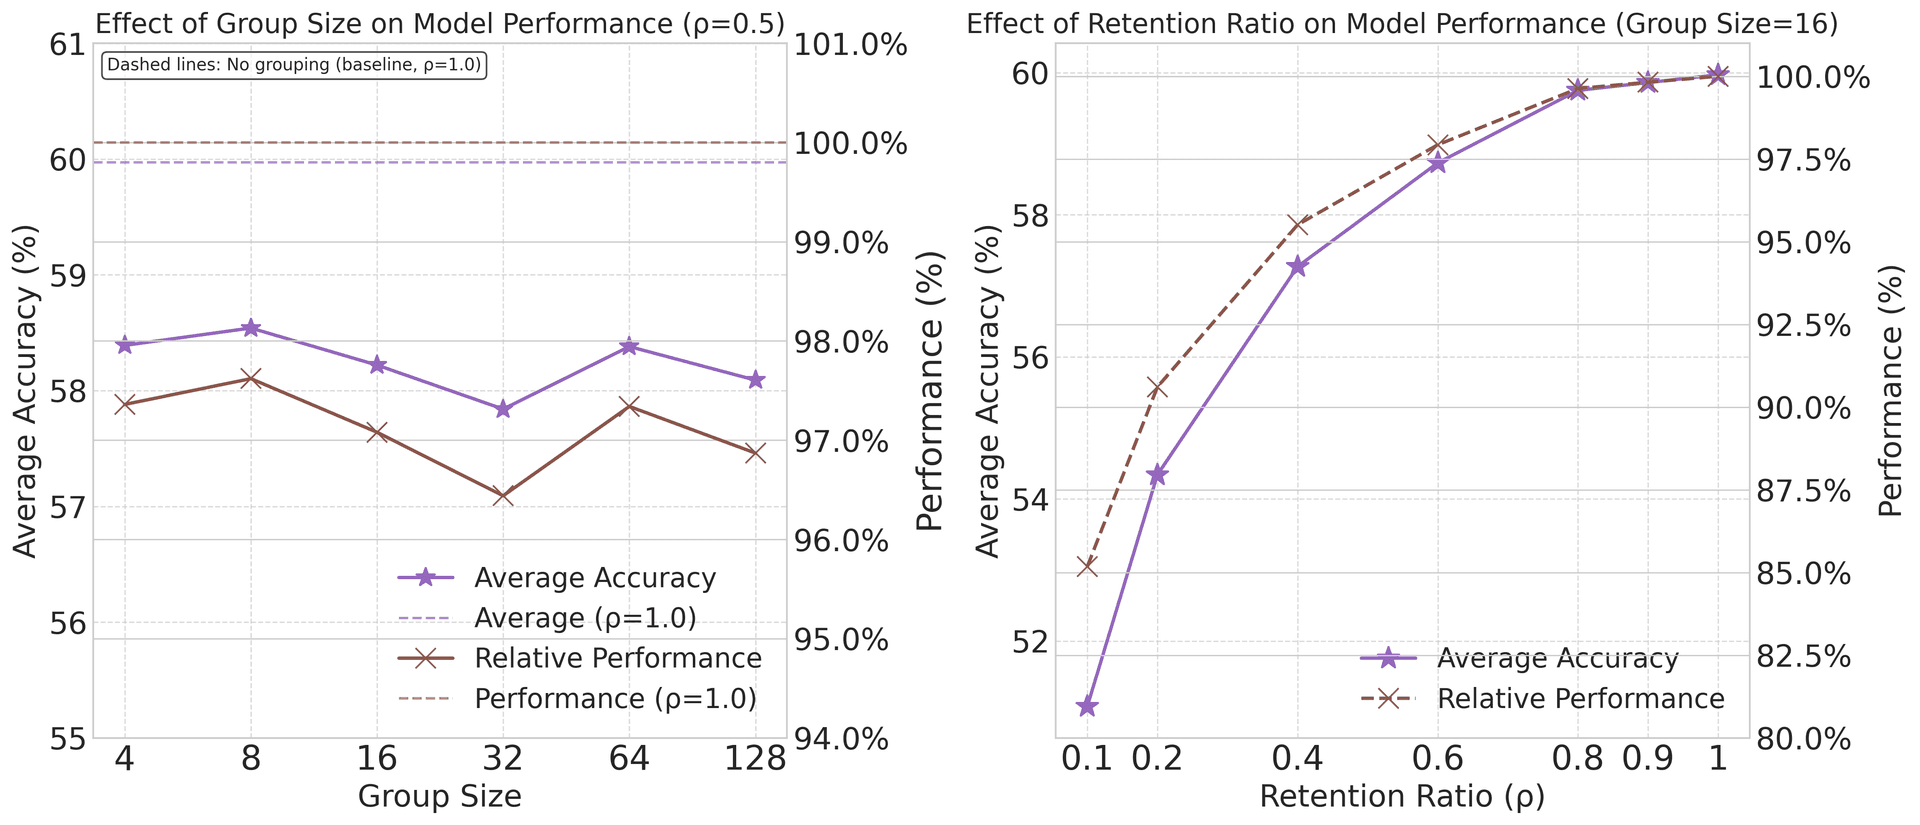
团队在 VideoMME、LongVideoBench、LVBench、MLVU 四个权威长视频理解基准上做了全面评估。原始基准(64帧,无剪枝)平均得分 56.51;使用 Key Norm 剪枝(ρ=0.5)后,平均得分保持在 55+ 水平,性能损失约 3%——而这换来的是 3.5 倍端到端加速 和 50% 显存节省。
QuickVideo 的代码结构清晰,核心是一个名为 LVU(Long Video Understanding)的 Python 包:
lvu/
  lvu.py          # 核心 LVU 类,封装 Qwen2.5-VL 模型调用
  lvu_config.py   # LVUConfig 配置类,支持 KV 剪枝、分组大小等参数
  lvu_cache.py    # KV-Cache 管理与缓存
  utils.py        # KV 剪枝算法实现(Value Norms / Key Norms / Salient Tokens)
  models/
    qwen25_vl.py          # Qwen2.5-VL Flash Attention 前向传播劫持
    qwen25_lvu.py         # LVU 完整实现(加载模型+处理视频)
    qwen25_lvu_interleaved.py  # 交错流水线版(CPU 解码 + GPU 推理并发)
核心依赖:transformers==4.50.0、torch>=2.6.0、decord(视频读取)、torchcodec(编解码)、qwen-vl-utils(Qwen 视觉工具)、deepcodec(神经视频解码)。
LVU 类通过 monkey-patch 替换了 Qwen2.5-VL 的 Flash Attention 前向传播函数,在注意力计算中动态注入 KV-Cache 剪枝逻辑。这是一种侵入式但可控的方案,对上层用户透明——调用方只需配置 LVUConfig,无需修改任何业务代码。
uv pip install -e . # 源码安装(通过 pyproject.toml)
from lvu.lvu import LVU
from lvu.lvu_config import LVUConfig

config = LVUConfig(
    model_name_or_path="Qwen/Qwen2.5-VL-7B-Instruct",
    model_type="qwen25_vl",
    top_k_predict_type="key_norms_small",
    num_frames=32,
)
lvu = LVU(config)
answer = lvu.generate(question="视频中讨论的主要议题是什么?", video_path="meeting.mp4")
门槛说明:虽然没有 Web UI,但 Python API 封装得比较友好,开发者友好度中等。最大门槛在于 GPU 显存需求(≥16GB),普通笔记本无法运行。
当前局限:无 Docker 支持,需手动配置 CUDA/Python 环境;仅支持 Qwen2.5-VL 系列;未集成量化推理;视频以均匀采样为主。
值得关注的方向:论文已发表于 TMLR 2025,团队还有 QuickCodec 配套工具可进一步加速视频解码,未来可能向更多 VideoLLM 扩展支持。
QuickVideo 代表了长视频理解领域的一个务实方向:与其训练更大的模型,不如让现有的模型更聪明地工作。通过系统-算法协同设计,它在不损失太多精度的情况下,将小时级视频的理解速度提升了 3.5 倍,显存占用减半。对于需要处理会议录像、监控视频、教育课程等长视频场景的 AI 应用开发者来说,这是一个值得关注的基础设施级工具。
关联项目推荐:同样来自 TIGER-AI Lab 的 QuickCodec,专注神经网络视频解码,与 QuickVideo 形成互补的端到端加速方案。
