
Neumann
Shadylukin/Neumann加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
做 AI 应用的开发者,常常面临一个令人头疼的现实:手里的数据分布在五六个不同的系统里——PostgreSQL 存用户表、Neo4j 存知识图谱、Pinecone 存向量、Redis 存缓存……每加一个功能,就得多维护一套数据库和它们之间的同步逻辑。ETL 脚本越写越长,数据一致性却越来越难保证。
Shadylukin(真名 Lukin Ackroyd)决定解决这个问题。他用 Rust 写了一个叫 Neumann 的数据库:一张表里同时容纳关系数据、图结构关系和向量嵌入,用一条查询语句跨三种数据源做语义搜索。75 颗 GitHub Stars,项目主页指向 scrunchee.ai。
 Neumann 数据库 Logo
传统架构中,关系型数据库擅长精确查询、图数据库擅长关系遍历、向量数据库擅长语义搜索——但把它们拼接在一起,数据必须跨系统流转,每次查询都要写三套逻辑。Neumann 的核心思路是:既然 AI 应用天然需要同时用到这三种能力,为什么不把它们存在同一个地方?
一张表,三种数据模型。 Neumann 的存储层基于"tensor-based storage"(张量存储层),关系数据、图节点/边、向量嵌入都映射到同一个底层存储结构中。写入时一次性写入,查询时由内部的 QueryRouter 自动路由到对应的引擎(relational_engine、graph_engine、vector_engine)。
Neumann 提供了一套自定义查询语言,可以同时操作关系、图和向量:
-- 找和 Alice 技能相似、且向 Bob 汇报的工程师
FIND NODE person
  WHERE role = 'engineer'
  SIMILAR TO 'user:alice'
  CONNECTED TO 'user:bob'
这条查询同时做了三件事:关系过滤(role='engineer')、向量相似度搜索(SIMILAR TO)和图遍历(CONNECTED TO)。传统方案需要三个系统、三套 SDK、三次网络往返;Neumann 一次查询搞定。
并发写入是分布式数据库的经典难题。Neumann 的共识层做了一个有趣的设计:不是所有并发写入都判定为冲突。如果两个人同时修改了同一个用户记录的不同字段,系统认为这是"正交变化",自动合并——只有写入相同字段才触发冲突解决。这比传统的"最后写入胜出"(Last-Write-Wins)更符合实际业务逻辑。
Neumann 面向 AI 场景做了几个针对性设计:
EMBED STORE 即可。Neumann 是一个典型的 Rust Workspace 项目,主仓库有 21 个内部 crate,各司其职:
| 组件 | 职责 |
|---|---|
tensor_store | 底层张量存储引擎 |
relational_engine | 关系型查询执行 |
graph_engine | 图结构遍历(节点/边操作) |
vector_engine | 向量相似度搜索 |
query_router | 查询路由,分配到对应引擎 |
neumann_parser | 自定义查询语言解析器 |
neumann_server | gRPC 服务端(基于 tonic),同时提供 Axum Web UI |
neumann_client | 客户端 SDK |
tensor_vault | 加密存储 |
tensor_cache | 语义缓存层 |
tensor_blob | 大对象存储 |
tensor_spatial | 空间数据支持 |
tensor_learn | 在线学习支持 |
技术栈方面:核心计算用 Rust 实现,异步运行时选 Tokio,gRPC 通信用 Tonic + Prost,Web UI 用 Axum + Maud(Rust 模板引擎),指标采集用 OpenTelemetry + OTLP。没有引入 JVM 依赖,内存占用低,启动快。
Docker 方式(推荐):
git clone https://github.com/Shadylukin/Neumann
cd Neumann
docker-compose up -d
# 访问 http://localhost:9200 打开 Web UI
无 Docker:
# 安装 Rust 工具链(需要 1.75+)
curl --proto '=https' --tlsv1.2 -sSf https://sh.rustup.rs | sh
cargo install neumann-db
neumann
Python SDK:
pip install neumann-db
from neumann import NeumannClient
client = NeumannClient.connect("localhost:9200")
result = client.execute("SELECT * FROM users WHERE role = 'engineer'")
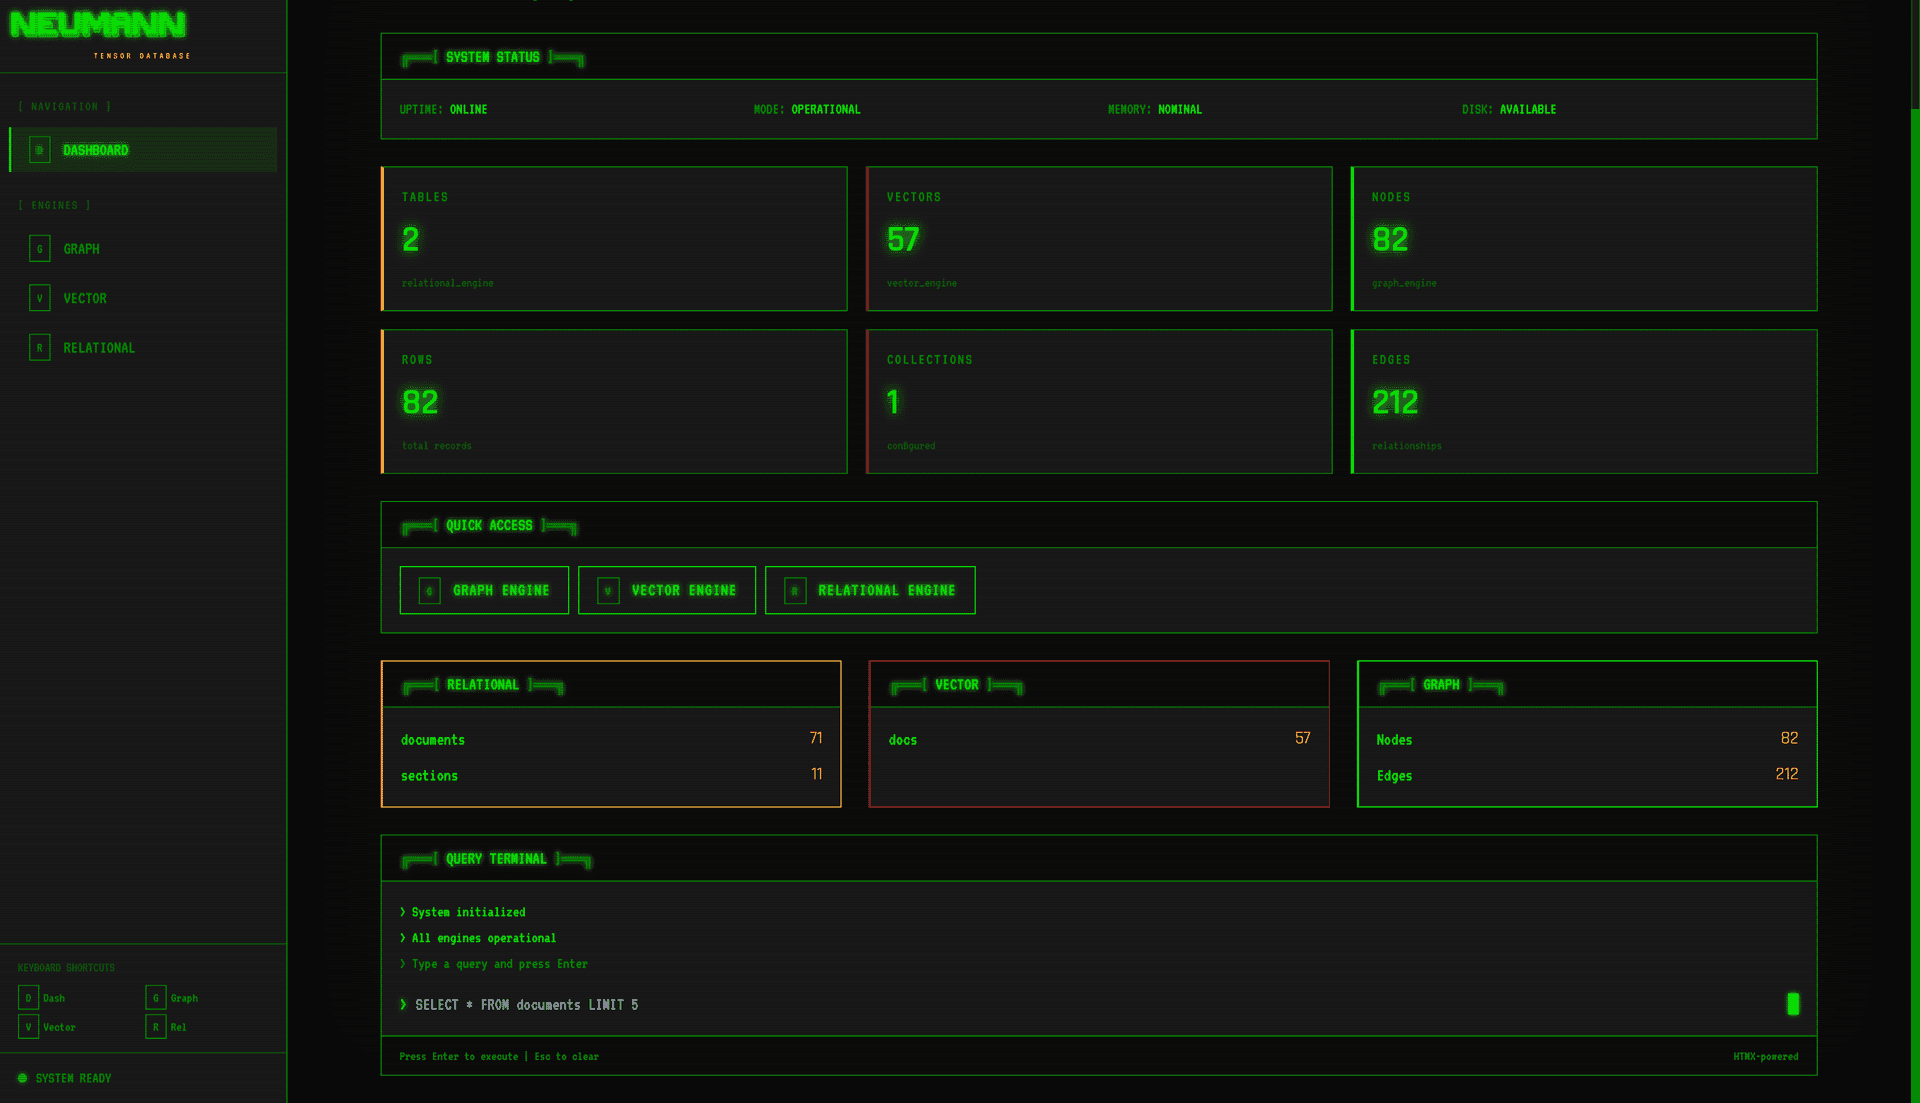 Web Dashboard:系统状态监控 + 查询终端
RAG(检索增强生成):文档存进来,自动建立 embedding 和文档之间的图关系。语义搜索找到相关文档后,沿着图关系自动扩展相关材料。
Agent Memory:跨会话的对话历史存储,向量召回相似问题,缓存 LLM 响应避免重复调用。多个 Agent 共享同一份记忆,图关系表达 Agent 间的依赖。
知识图谱:结合结构化数据和语义相似度,用"这个实体像什么"而不是"这个实体叫什么"来发现新关联。
Neumann 目前仍处于早期阶段(v0.4.0),有几个现实问题需要考虑:
Neumann 提出了一个很清晰的价值主张——不要再同时维护五套数据库了。在 AI 应用快速迭代的阶段,用一套系统承载关系、图、向量三种能力,可以大幅减少架构复杂度。
但"统一"也意味着在每一条赛道上都要和专用数据库竞争性能。对于数据量不大但需要快速验证 AI 想法的团队,Neumann 是一个值得关注的选项;如果是已经跑在生产环境、需要极致性能的场景,专用数据库仍然是更稳妥的选择。
GitHub: Shadylukin/Neumann | 文档:scrunchee.ai
