
SyGra
ServiceNow/SyGra加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你是一名 AI 教练,正在训练一支篮球队,但手里只有 10 张球员照片——远远不够。你需要的是合成球员数据:不同姿势、不同光照、不同战术场景的照片。SyGra 正是这样一个"数据教练",专门为训练 LLM 生成高质量合成数据。
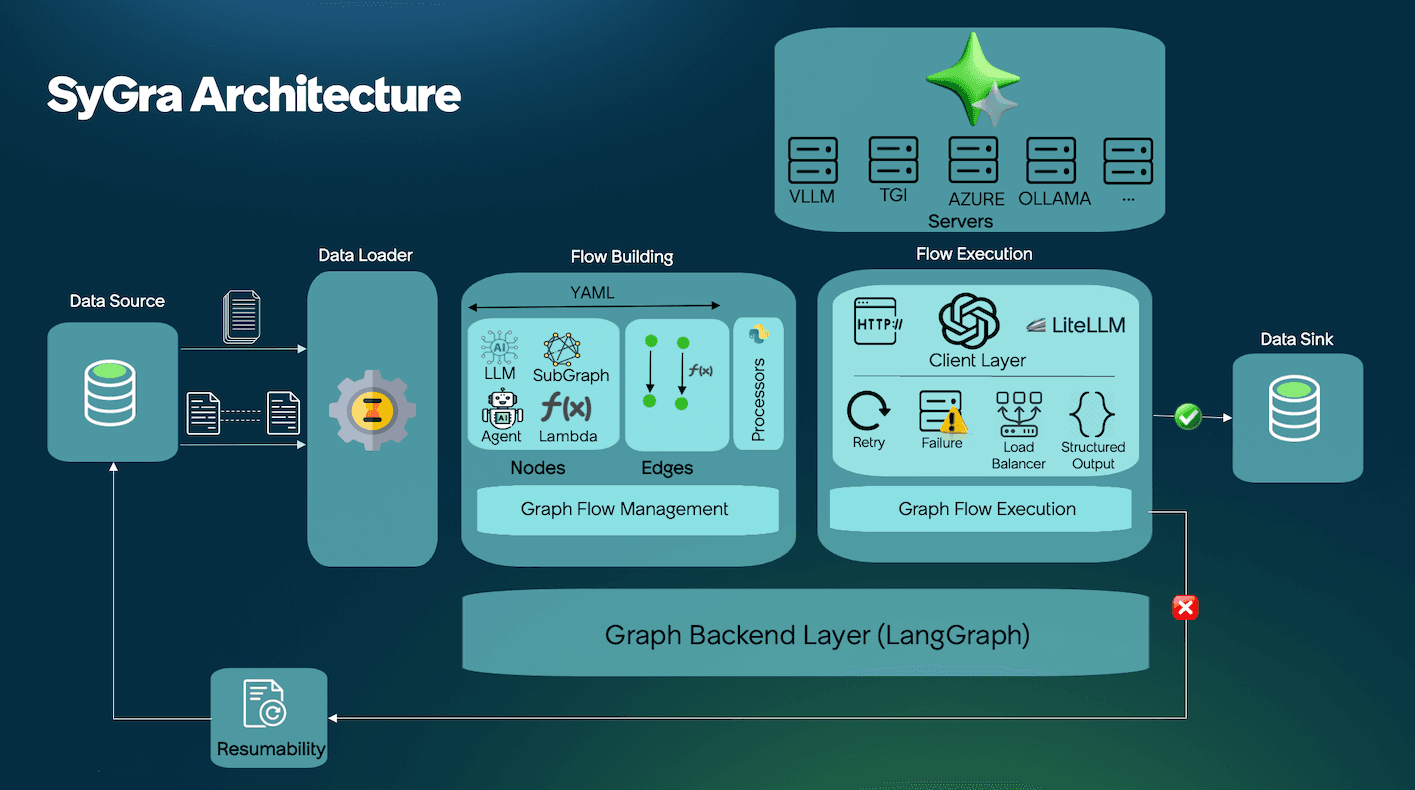
2025 年 8 月,ServiceNow(全球领先的数字化工作流公司)开源了 SyGra——一个基于计算图(Computational Graph)的合成数据生成框架。与传统的脚本式数据生成不同,SyGra 将整个数据生成流程建模为有向图结构,每个节点代表一个处理步骤(LLM 调用、数据转换、采样),节点之间通过边(Edge)定义数据流向和条件分支。
ServiceNow 的 AI 团队在训练内部大模型时,面临一个核心挑战——高质量训练数据稀缺,尤其是垂直领域的指令微调数据(SFT)和偏好数据(DPO)。团队在调研中发现,LangGraph 提供了灵活的图执行引擎,但缺乏面向合成数据场景的高级抽象。
于是,SyGra 诞生了:底层基于 LangGraph,上层构建了数据源(Source)、节点(Node)、边(Edge)和输出(Sink)四层抽象。开发者不需要写复杂的控制流代码,只需声明式地配置 YAML 文件,即可定义复杂的多阶段数据生成流水线。
作者团队在 arXiv 发表了论文(arXiv:2508.15432),系统阐述了图导向数据生成的理念,并开源了完整实现。
SyGra 的设计哲学是配置即代码——用 YAML 声明图结构,用 Python 实现自定义处理器,两者结合实现最大灵活性。
图由三要素组成:
节点(Node):数据处理的基本单元。SyGra 支持多种节点类型:
边(Edge):连接节点的通道,支持条件分支和并行流。例如:模型生成答案 → 批评模型打分 → 分数低于阈值则返回重新生成 → 分数达标则进入下一阶段。这是 SyGra 最强大的特性之一。
状态(State):图执行过程中的共享数据上下文,每条记录在图中流转时会累积状态。
以下是一个完整的 self-critique 流程配置(来自 glaive_code_assistant 示例):
# 定义两个 LLM 节点
generate_answer:
  node_type: llm
  prompt:
    - system: "You are an assistant tasked with solving coding problems."
    - user: "{question}"
  model:
    name: gpt-4o-mini
    parameters:
      temperature: 0.1

# 批评节点:检查答案质量
critique_answer:
  node_type: llm
  prompt:
    - system: "You are a teacher grading a solution to a coding problem..."
  model:
    name: gpt-4o-mini

# 条件边:如果批评反馈为"NO MORE FEEDBACK"则结束,否则回到生成节点
edges:
  - from: critique_answer
    condition: ShouldContinueCondition
    path_map:
      END: END
      generate_answer: generate_answer
这种条件循环机制允许 SyGra 实现自我改进:让模型生成答案 → 让批评模型打分 → 分数不达标则回到生成器重新来过,直到质量合格。
对于不熟悉 YAML 的用户,SyGra Studio 提供了一个功能完整的拖拽式图形编辑器,大幅降低了使用门槛。
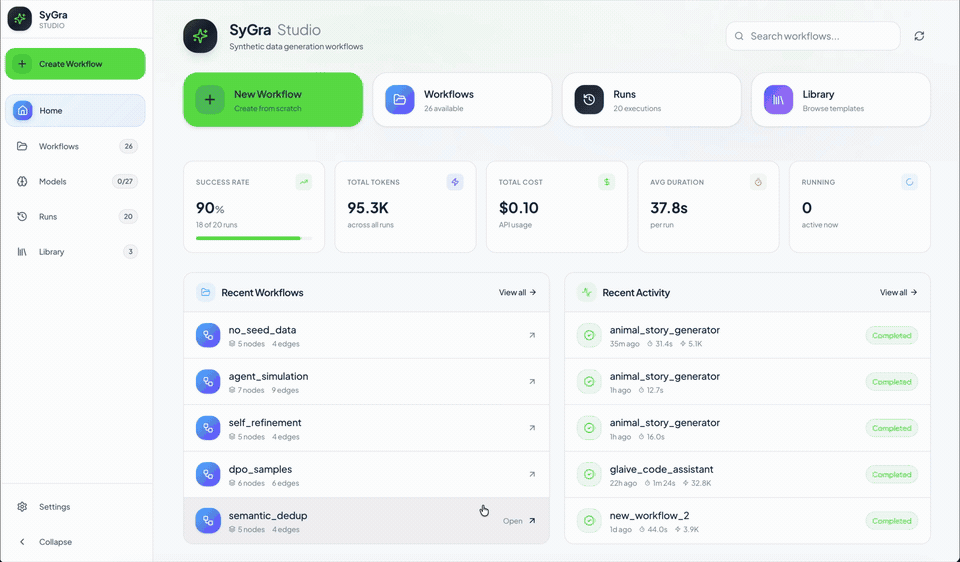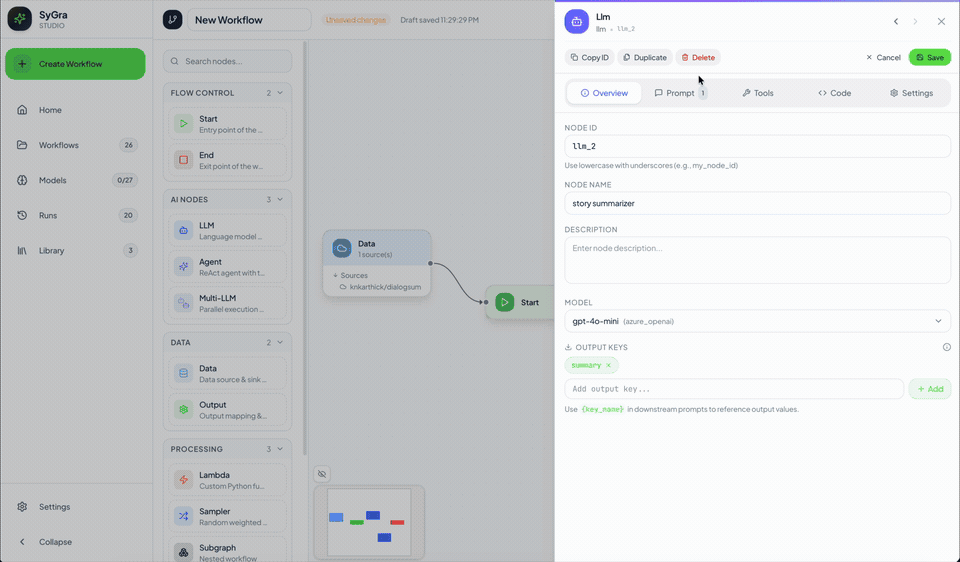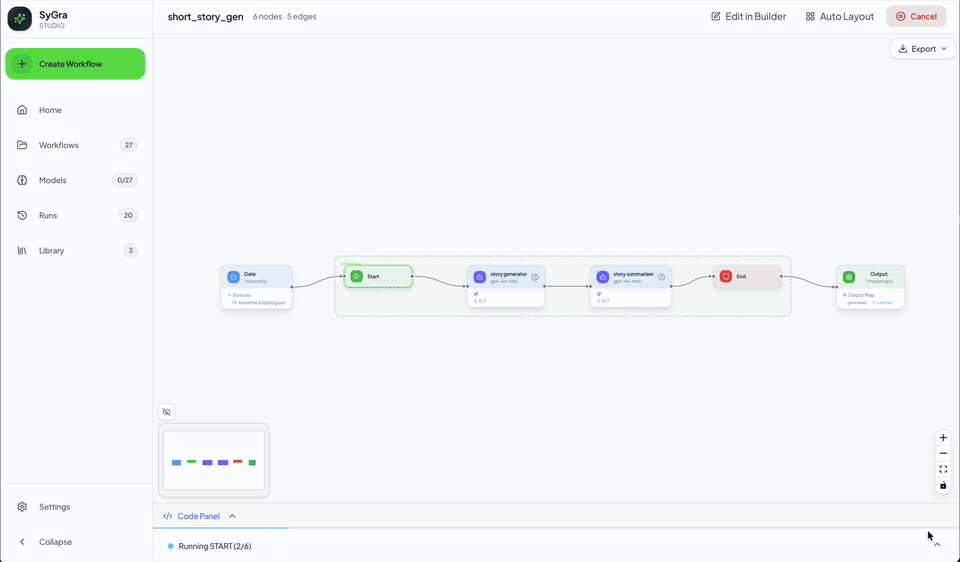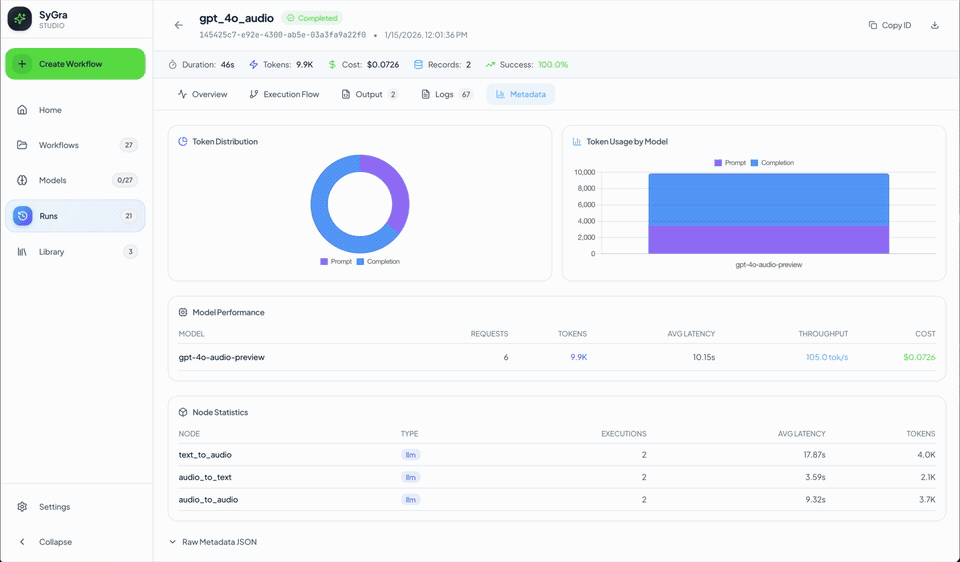
Studio 基于 Svelte + Tailwind CSS 前端框架构建,后端使用 FastAPI,通过 WebSocket 实时推送执行日志。用户可以:
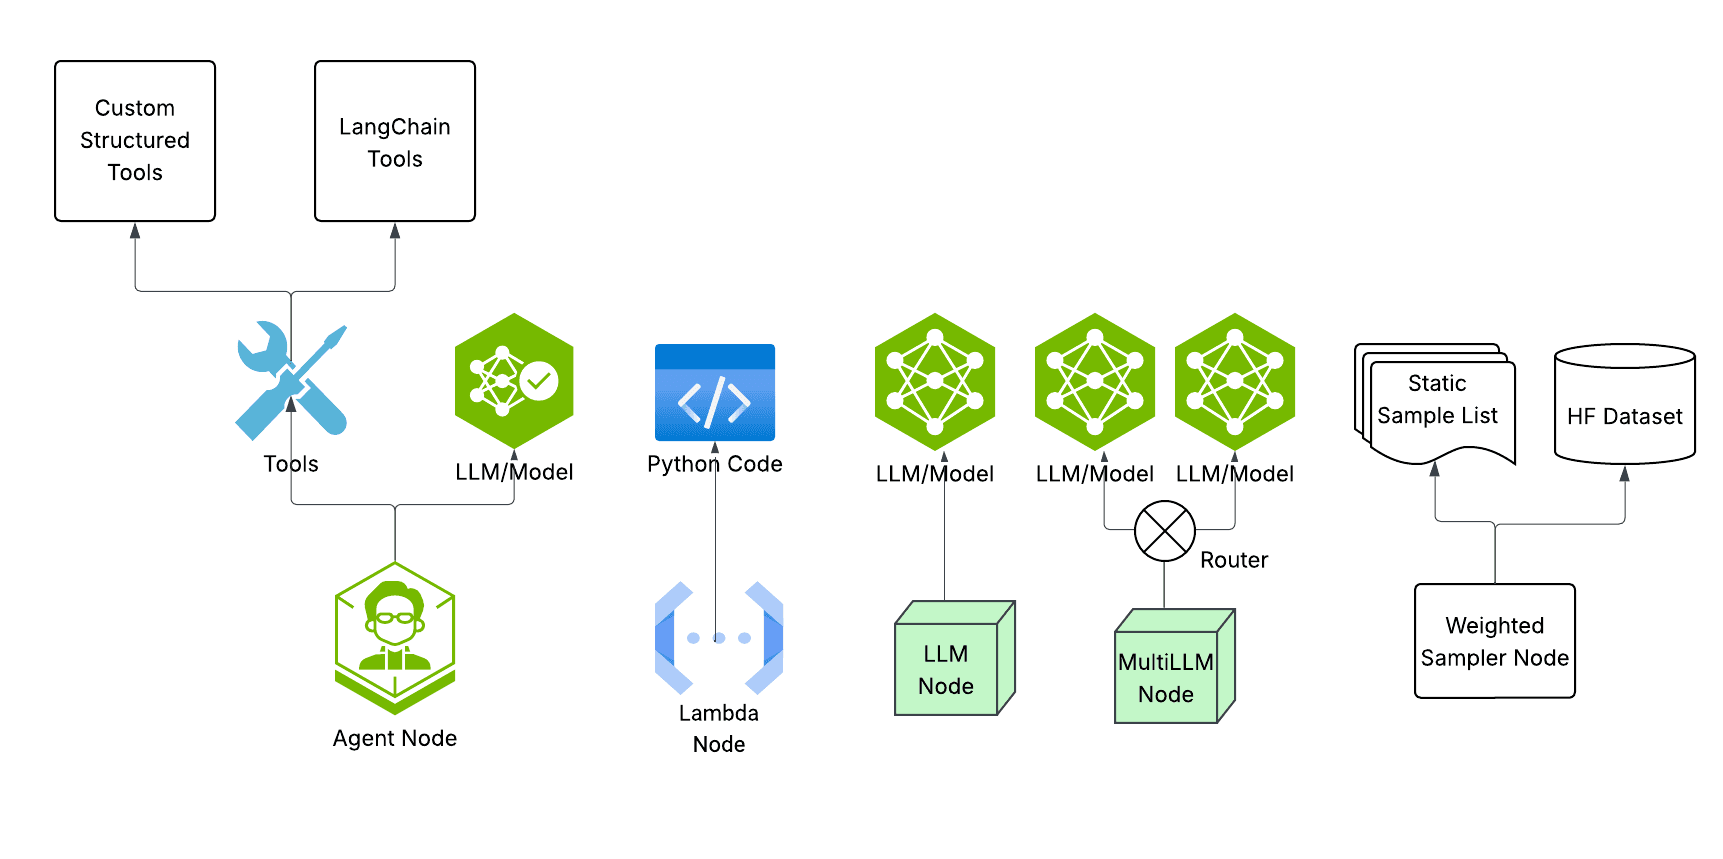
SyGra 的代码组织遵循分层架构:
sygra/
├── core/          # 图执行引擎(基于 LangGraph)
│   ├── base_task_executor.py   # 任务入口
│   ├── graph/                  # 图状态管理
│   └── execution_callbacks.py  # 执行回调
├── nodes/         # 节点类型定义
├── models/        # LLM 模型客户端工厂
├── processors/    # 数据预/后处理器
├── data/          # 数据源/宿(HF、文件系统、ServiceNow 实例)
├── metadata/      # 元数据管理(标签、分类)
├── recipes/       # 内置数据生成配方
├── config/        # 模型配置(models.yaml)
└── workflow/      # 工作流抽象

studio/            # SyGra Studio(独立 FastAPI 服务)
├── api.py         # REST API
├── graph_builder.py # 图构建器
├── execution_manager.py # 执行管理器
├── frontend/      # Svelte + Tailwind UI
└── server.py      # uvicorn 服务入口
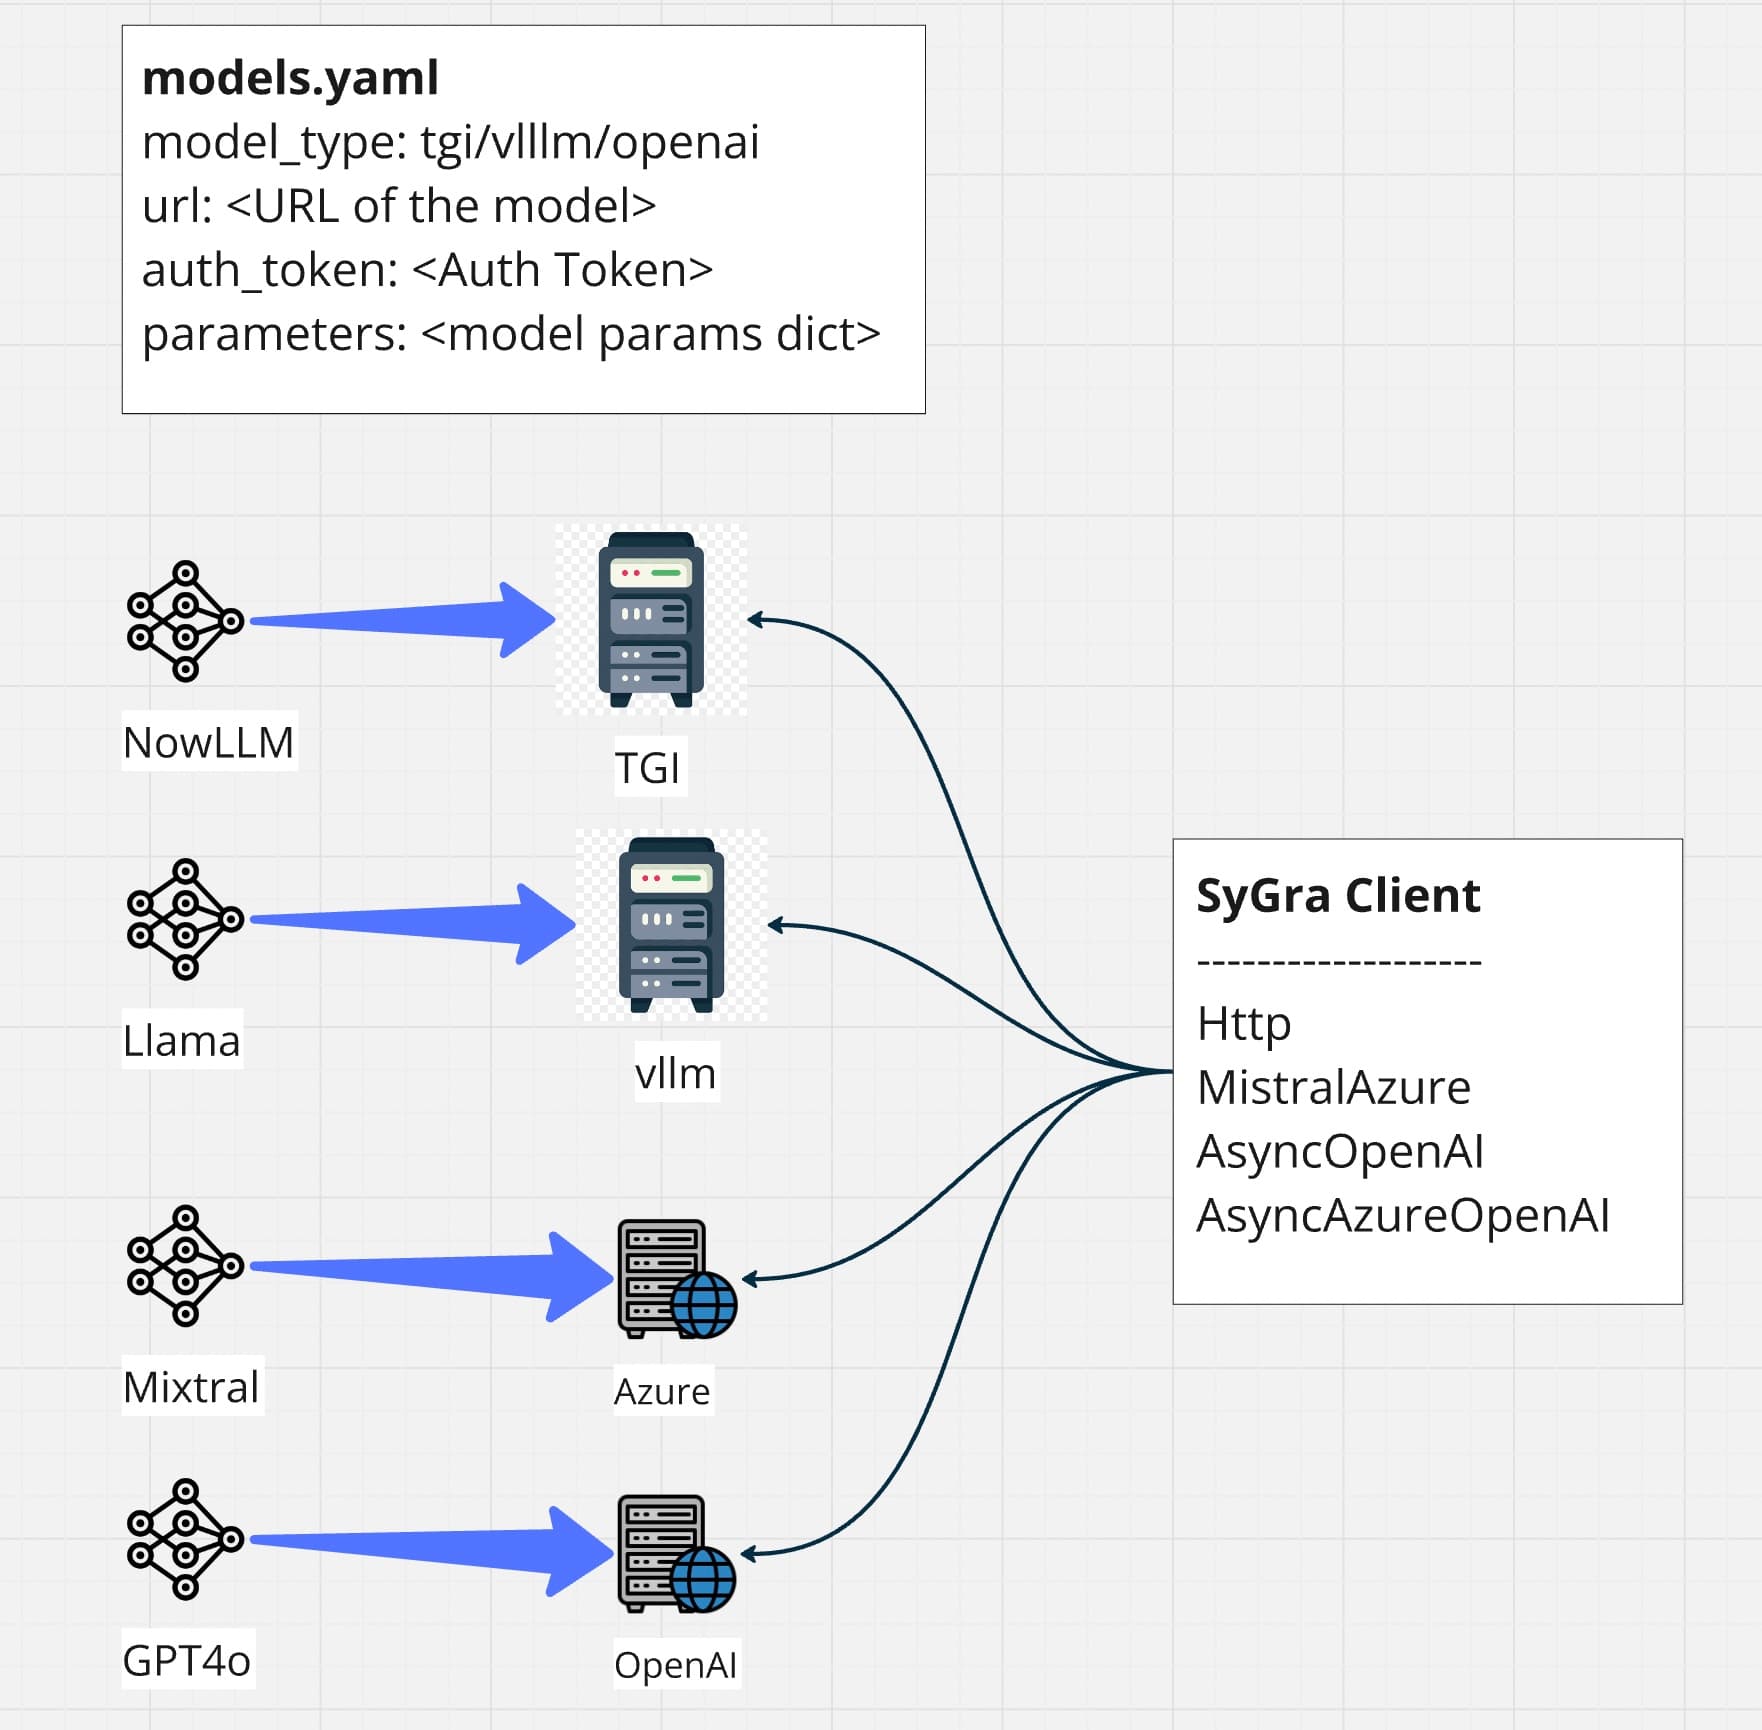
依赖栈极具深度:PyTorch、Transformers、LangChain/LangGraph、HuggingFace Datasets、Sentence-Transformers、FastAPI、litellm(统一 LLM 调用层)。还集成了 FastText(文本质量评估)、Jinja2(模板渲染)、pandarallel(并行处理)等工具库。
路径一:命令行快速体验(推荐尝鲜)
git clone https://github.com/ServiceNow/SyGra.git && cd SyGra
pip install sygra

# 设置 LLM 凭证
export SYGRA_GPT_4O_MINI_URL="https://api.openai.com/v1"
export SYGRA_GPT_4O_MINI_TOKEN="sk-..."

# 运行内置示例
uv run python main.py -t examples.glaive_code_assistant -n 2
路径二:SyGra Studio 可视化操作
make setup       # 安装依赖
make studio      # 启动 Studio(http://localhost:8000)
Python API 编程方式:
import sygra

workflow = sygra.Workflow("my_workflow")
results = (
    workflow
    .source([{"topic": "AI"}, {"topic": "space"}])
    .llm(model="gpt-4o-mini", prompt="Write a story about {topic}", output="story")
    .sink("output/stories.json")
    .run()
)
SyGra 的数据源层支持多种输入:
内置的 20 个示例任务覆盖了丰富场景:
| 任务类型 | 说明 |
|---|---|
glaive_code_assistant | 代码生成 + self-critique 自改进 |
evol_instruct | 指令演化(让模型生成更难的问题) |
self_refinement | 答案自我优化 |
image_to_qna | 图片生成问答对 |
text_to_image | 文本生成图片 |
text_to_speech | 文本生成语音 |
audio_to_text | 语音转文本 |
structured_output | 结构化输出生成 |
semantic_dedup | 语义去重 |
依赖外部 LLM API:SyGra 本身不包含模型推理,所有 LLM 调用都依赖外部服务(OpenAI/Azure/Ollama/vLLM)。这意味着生成数据的成本完全取决于第三方 API 定价,私有化部署需要额外搭建 LLM 服务。
YAML 学习曲线:尽管 Studio 提供了可视化编辑器,但高级用法(自定义处理器、条件边、多数据源合并)仍需要编写 YAML 配置文件,对 YAML 不熟悉的用户有一定门槛。
不支持 Docker 一键部署:项目未提供 Dockerfile 或 docker-compose.yml,本地部署需要手动配置 Python 环境(3.9-3.11)和依赖管理工具(uv)。
Python 版本限制:仅支持 Python 3.9-3.11,排除了 3.12+ 用户,需要在虚拟环境中运行。
SyGra 代表了合成数据生成领域的一个重要趋势——从脚本式到图导向。传统的合成数据脚本往往是硬编码的 if-else 控制流,难以扩展和复用。将数据生成流程抽象为计算图后,节点和边可以跨任务复用,复杂的多阶段流水线也能清晰地可视化和管理。
从数据生成方式来看,SyGra 支持多种 LLM 后端的统一接入,加上 self-critique 条件循环机制,使其在生成高质量 SFT 数据和偏好数据(DPO)方面具有实际工程价值。Apache-2.0 开源许可也为商业使用扫清了障碍。
截至 2026 年 8 月,SyGra 已获得 90 颗 GitHub Stars、18 个 Fork,项目维护活跃(最近更新于 2026 年 6 月),提供了完整的 MkDocs 文档和 SyGra Studio 在线文档。对于需要批量生成 LLM 训练数据的研究团队和 AI 公司,SyGra 是一个值得关注的技术选型。
