
OpenArc
SearchSavior/OpenArc加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2024 年开始,大语言模型(LLM)的本地部署成为开发者和 AI 爱好者的热门话题。然而,想要流畅运行一个 7B 参数的模型,至少需要一块 RTX 3060 以上的显卡——这张卡的售价足够买两部中端手机。对于没有 NVIDIA 显卡、只有一台 Intel 轻薄本的用户来说,要么忍受 CPU 推理的龟速,要么掏钱买新硬件。
OpenArc 正是为解决这个问题而生。这是一个专门针对 Intel 硬件优化的推理引擎,支持 Intel CPU、集成显卡、独立显卡(Arc 系列)以及 NPU,让这些"被忽视"的硬件也能本地跑起大模型。更难得的是,它完全兼容 OpenAI API 协议——你现有的 AI 应用无需修改代码,换个地址就能用上本地模型。
OpenArc 项目 Logo,在经典 Doom 环境中展示 AI 推理能力,致敬开源游戏 mod 文化
OpenVINO(Open Visual Inference & Neural Network Optimization)是 Intel 开源的高性能推理工具包。相比 PyTorch 原生推理,OpenVINO 通过算子融合、动态量化、硬件加速等手段,可以在 Intel 硬件上实现 2-10 倍的推理加速。OpenArc 在此基础上封装了完整的模型服务层,把底层的复杂性全部隐藏,用户只需关注 API 调用。
OpenVINO 的另一个优势是广泛的硬件覆盖:从第 10 代 Intel 处理器内置的集成显卡,到 Arc B570/B580 独立显卡,再到 Lunar Lake 的 NPU,全部纳入统一优化体系。这意味着无论你手上是什么价位的 Intel 设备,OpenArc 都能找到合适的运行方式。
OpenArc 不只是一个"文本生成模型"的运行器,它的设计目标是在同一台服务器上同时托管多种 AI 模型:
LLM/VLM 推理:通过 /v1/chat/completions 端点加载 Qwen、Llama 等模型,支持 Function Calling、ReAct 推理、思维链输出。视觉语言模型(VLM)同样支持,图片理解任务可以直接调用。
语音识别:集成 Whisper 和 Qwen-ASR,通过 /v1/audio/transcriptions 端点提供流式语音转文字,支持多语言。
语音合成:基于 Kokoro-TTS 和 Qwen-TTS,通过 /v1/audio/speech 端点将文字转为自然语音,支持声音风格混合(如"80% Sarah 音色 + 20% Nicole 音色")。
Embedding 和 Reranker:提供 /v1/embeddings 和 /v1/rerank 端点,用于 RAG(检索增强生成)场景的向量化和重排序。
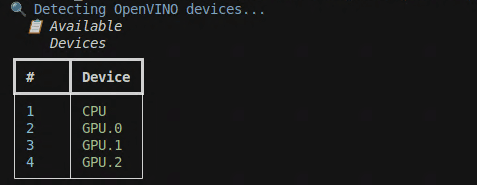
OpenArc CLI 工具的 device-detect 功能,自动识别系统中的 Intel 硬件并显示性能指标
OpenArc 的代码架构分为三个核心层次,每层职责清晰:
Engine 层(src/engine/):负责模型加载和推理执行,包含三个引擎后端:
openvino/:基于 Optimum-Intel 的 OpenVINO 优化推理ov_genai/:基于 OpenVINO GenAI 的原生流水线推理(更新、更快)optimum/:直接使用 HuggingFace Optimum 加载模型Server 层(src/server/):基于 FastAPI 构建的 REST API 服务器,提供完整的 OpenAI 兼容接口。包含模型注册中心(model_registry.py)、工作器注册(worker_registry.py)、请求路由(routes/)和请求/响应数据模型(schemas/)。
CLI 层(src/cli/):命令行工具,支持 openarc serve(启动服务)、openarc load(加载模型)、openarc device-detect(硬件检测)、openarc bench(性能基准测试)等命令。
架构设计支持多引擎并发——同一进程内可同时运行多个不同的推理引擎,每个引擎独立加载不同模型,彼此不干扰。
OpenArc 提供三种安装方式:
Docker 方式(最简):一条命令启动完整服务:
docker-compose up -d
服务自动在 8000 端口启动,API 端点与 OpenAI 完全兼容。docker-compose 中已配置 Intel GPU 访问(/dev/dri 设备映射)和环境变量。
本地安装(Linux):
./setup.sh
source .venv/bin/activate
openarc serve
setup 脚本会自动安装 uv 包管理器、Python 依赖,并检测 Intel oneAPI 环境。
本地安装(Windows):运行 setup.bat 即可,OpenArc 明确支持 Windows 环境。
启动后,通过 /v1/models 查看已加载模型,通过 curl 或任何 OpenAI SDK 发送请求:
curl http://localhost:8000/v1/chat/completions \
  -H "Authorization: Bearer openarc-default-key" \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen35-08b", "messages": [{"role": "user", "content": "解释什么是检索增强生成"}]}'
投机解码(Speculative Decoding):用一个小模型(draft model)预测多个 token,再由大模型验证,可以显著降低推理延迟。OpenArc 支持 Qwen 系列 draft model,已集成到 ov_genai_speculative_decode.py 示例中。
性能基准测试:内置 llama-bench 风格的基准测试工具,自动将测试结果存入 SQLite 数据库,记录每次推理的 TTFT(首个 Token 生成时间)、Prefill Throughput、Decode Throughput、TPOT(每 Token 耗时)等指标。
多 GPU 流水线并行:对于需要更大算力的场景,OpenArc 支持跨多张 Intel 显卡分配模型层,实现更高的并发吞吐量。
模型转换门槛:OpenVINO 推理需要先将 HuggingFace 的原生模型(PyTorch/ safetensors)转换为 OpenVINO 格式(.xml/.bin)。虽然 optimum-cli 可以一键转换,但转换后的模型文件体积较大,且每次切换模型都需要重新转换,相比 GGUF 格式的灵活性不足。
Intel 独显生态尚小:NVIDIA 显卡拥有成熟的推理生态(vLLM、TensorRT),Intel Arc 显卡的优化仍在快速迭代中。某些最新模型可能在 OpenArc 上需要等待 Intel 发布对应优化后才能获得最佳性能。
社区规模有限:作为一个社区驱动项目,OpenArc 的开发者资源相对集中(核心贡献者在 Discord 社区协作),文档和教程不如商业项目完善。
OpenArc 代表了一种务实的技术路线:不追求"什么都能跑"的通用性,而是在 Intel 硬件这个细分领域做到极致。对于手中持有 Intel 显卡或 CPU 的开发者、AI 爱好者来说,OpenArc 提供了一条零门槛的本地推理路径——只需 docker-compose up,就能把一台普通的 Intel PC 变成可用的 AI 服务器。随着 Intel Arc 显卡市场份额的提升和 OpenVINO 工具链的持续迭代,这条路线的吸引力只会越来越大。
