
LinkAlign
Satissss/LinkAlign加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你是一家电商公司的数据分析师。业务数据库里有上百张表——用户表、订单表、商品表、库存表、日志表……它们之间通过外键和业务逻辑交织在一起,形成了一张庞大而复杂的网。现在,老板让你写一条 SQL:"找出过去30天内购买频次最高的用户,以及他们购买最多的3个品类"。
你很清楚这张表在某个角落里,但你不知道具体叫什么名字、哪几列对应哪个业务概念。这种"知道答案存在,但找不到入口"的困境,就是数据工程师日常最头疼的问题——Schema Linking(数据库架构链接)。
LinkAlign 解决的,正是这个问题。
Text-to-SQL 任务,即让大语言模型(LLM)根据自然语言问题直接生成 SQL 查询语句,是大模型落地企业场景最核心的能力之一。近年来随着 GPT-4、Qwen 等强推理模型的出现,单数据库单表场景下的 Text-to-SQL 准确率已经有了显著提升。
然而现实世界远比 benchmark 复杂:
这正是 LinkAlign 要解决的两大挑战:数据库检索(Database Retrieval)和 Schema 项关联(Schema Item Grounding)。
LinkAlign 的技术方案分为两个阶段、三个步骤:
Step 1 - 多轮语义增强检索(Multi-round Semantic Retrieval)
项目使用 BGE-Large-EN-v1.5 作为文本嵌入模型,将所有数据库的元信息(表名、列名、注释)编码为向量存入向量数据库。Query 时,先通过语义检索找到候选数据库,再通过多轮对话让 LLM 判断是否找到了正确的数据库,并在必要时扩大搜索范围。
Step 2 - 无关信息隔离(Irrelevant Information Isolation)
即便找到了正确的数据库,里面可能还有大量与 Query 无关的表和字段。这一步通过 LLM 分析,排除不相关的 Schema 项,生成一个"精简版"的 Schema 子集,显著降低后续 SQL 生成的噪声。
Step 3 - Schema 提取增强(Schema Extraction Enhancement)
对精简后的 Schema 子集进行更精细的语义增强,确保 SQL 生成时能准确匹配列与自然语言描述。
LinkAlign 还支持 Agent 模式:在每个步骤中引入多轮反思机制(turn_n 参数),让 Agent 反复审视自己的选择是否正确。实验数据显示,turn_n=5 时 Step 1 的平均耗时约58秒、消耗约9600个 token;turn_n=1 时约12秒、1600个 token——精度与效率之间可以动态调节。
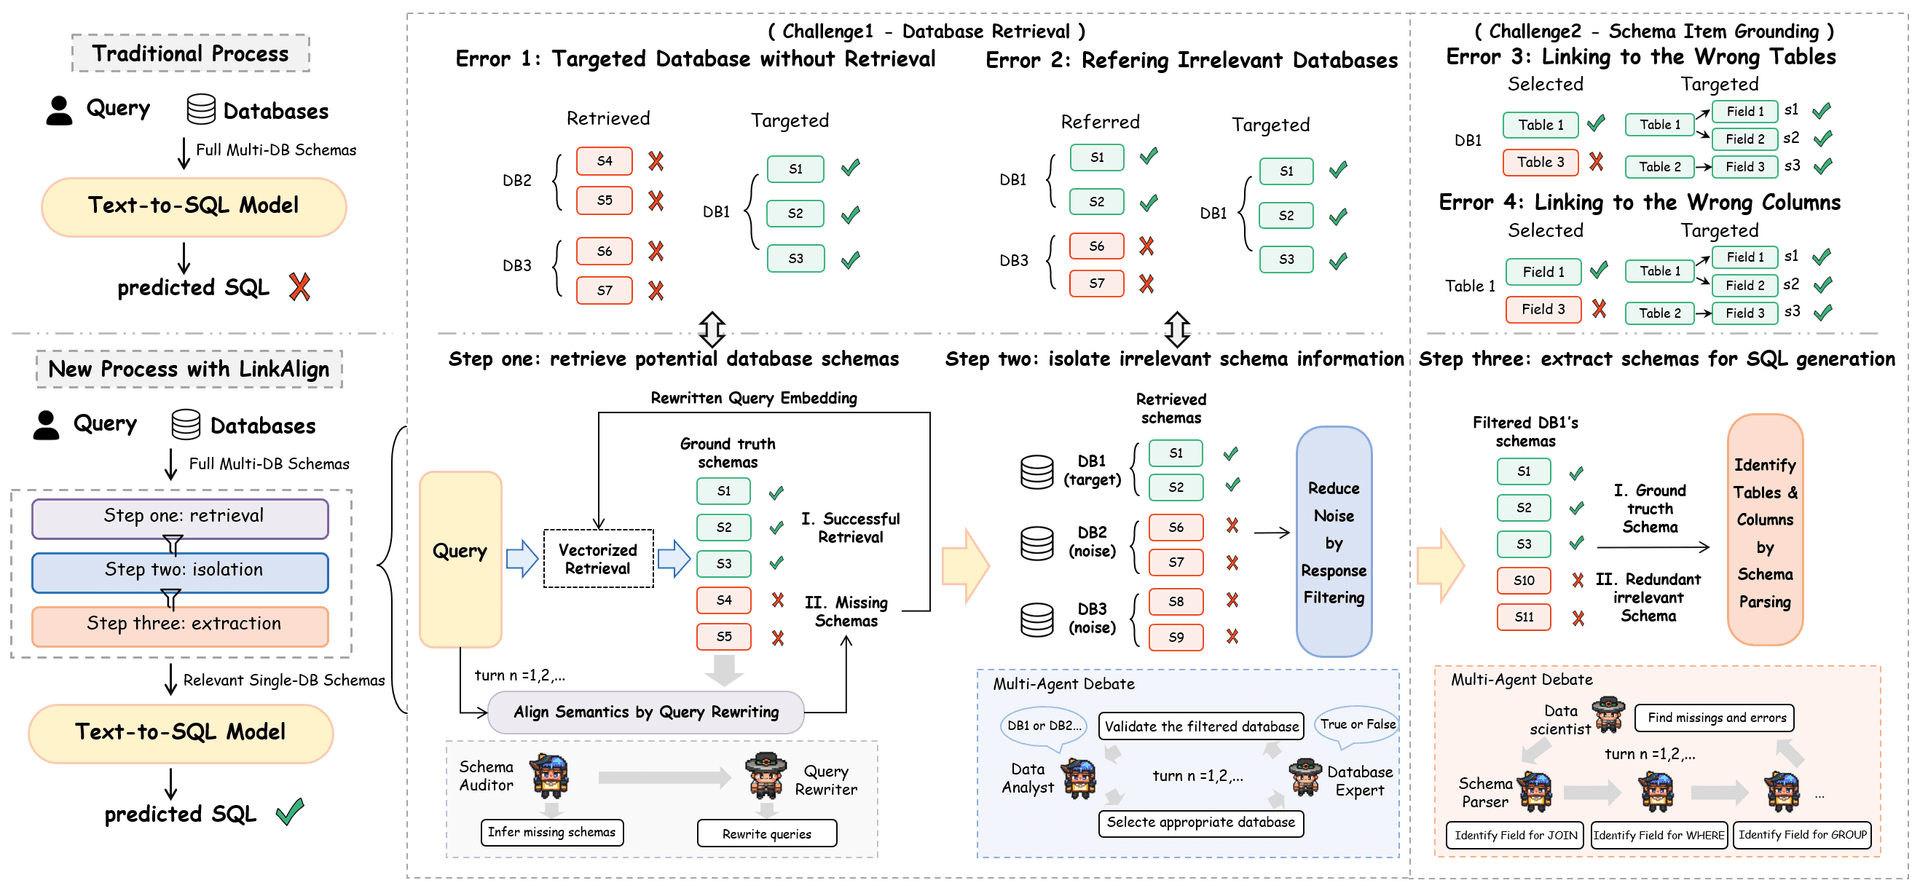
图:LinkAlign 整体框架,左侧为 Pipeline 模式,右侧为 Agent 模式
LinkAlign 的代码结构非常清晰,模块化程度高:
| 目录/文件 | 职责 |
|---|---|
embed_model/ | 嵌入模型封装,支持 BGE 等主流嵌入模型 |
llms/ | LLM 适配层,支持 Qwen、DeepSeek、Zhipu(智谱) |
pipes/RagPipeline.py | RAG 检索管道,负责数据库 Schema 向量化存储和检索 |
tools/SchemaLinkingTool.py | 核心 Schema 链接工具,封装了多步检索逻辑(25707字节,最大的文件) |
prompts/ | 提示词工程,Pipeline 和 Agent 两种模式的 Prompt 分别管理 |
generate_data/ | 数据生成工具,用于构建训练数据集 |
preprocess.py | 数据预处理脚本 |
核心依赖为 LlamaIndex(0.10.62)作为 RAG 框架,sentence-transformers 做嵌入,transformers + torch 提供模型支持。
LinkAlign 是一篇 EMNLP 2025 Main Track 论文的开源实现,定位是研究级别的代码仓库,而非面向终端用户的工具。
本地部署有相当门槛:
embeddings/huggingface/base.py 注释掉 safe_serialization 参数,在 indices/vector_store/retrievers/retriever.py 中为 VectorIndexRetriever 类增加3个成员方法。这是项目作者为了适配自己的需求而做的临时修改,尚未合入上游。因此,它更适合 NLP/数据库研究领域的学者和工程师,用于复现论文或集成到自己的 Text-to-SQL pipeline 中,而非普通开发者拿来直接使用。
LinkAlign 在三个权威数据集上验证了效果:
在 SPIDER 2.0-lite 的多数据库设置下,LinkAlign 超越了所有不使用长思维链(Long CoT)推理模型的方法,排名第一。Pipeline 模式下,单次查询(Qwen-Turbo + BGE-Large)平均耗时约 13.6 秒、消耗约 3300 个 token;Agent 模式(turn_n=2)约 72 秒、约 21000 个 token——性价比突出。
LinkAlign 最有价值的地方,在于它直面了学术界长期回避的问题:真实企业环境中的多数据库、大规模 Schema 场景。大多数 Text-to-SQL 论文在 SPIDER 上刷到 80%+ 准确率,但放到真实环境里往往折戟——因为 benchmark 只测试单数据库、单表 Schema,现实中根本没有这种"理想条件"。
作者在论文(arXiv:2503.18596)中指出,Schema Linking 才是 Text-to-SQL 落地最大的瓶颈,而不是 SQL 生成本身。LinkAlign 填补了这一空白,为未来"企业级 Text-to-SQL"的发展提供了可参考的技术路线。
| 维度 | 评价 |
|---|---|
| 创新性 | ★★★★☆ Schema Linking 问题定义清晰,Pipeline+Agent 双模式设计合理 |
| 工程完整度 | ★★★☆☆ 核心功能完整,但需修改上游依赖,尚非生产就绪 |
| 文档质量 | ★★★☆☆ README 内容完整,有 Benchmark 数据,但缺少快速上手 Demo |
| 研究价值 | ★★★★☆ EMNLP 2025 Main,方法论扎实,有明确的 Problem Statement |
| 部署难度 | ★★☆☆☆ 高,需修改源码,依赖外部 API,研究用而非开箱即用 |
**LinkAlign 是近年来 Text-to-SQL 领域难得一见的、真正关注"落地最后一公里"的研究工作。**如果你在构建企业级 NL2SQL 系统,或从事数据库 + AI 的学术研究,这个项目值得深入研究。
