
AI-Scientist
SakanaAI/AI-Scientist加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
图:The AI Scientist 项目标志(Sakana AI)
设想一个场景:你是实验室的研究生,需要在两周内交出一篇关于新型扩散模型改进的论文。你打开一个命令行工具,输入一行 python launch_scientist.py --model "claude-3-5-sonnet-20241022" --experiment nanoGPT_lite --num-ideas 2,然后去睡觉。第二天早上,你面对的不是一个模糊的思路,而是三份完整的 LaTeX 论文——有摘要、有方法、有实验曲线、有参考文献、有图表,甚至还有一份带评分的同行评审意见。
这就是 Sakana AI 于 2024 年 8 月开源的 The AI Scientist。它的定位在今天看来仍属激进:宣称实现"完全自动化的开放式科学发现"。截至目前,该仓库在 GitHub 收获约 1.49 万星、2000+ Fork,是 AI for Science 方向被讨论最多的开源项目之一。
项目的本质是一条模板驱动的自动化科研流水线,用代码拆解为四个模块:
| 模块 | 文件 | 职责 |
|---|---|---|
| 选题 | ai_scientist/generate_ideas.py | 结合种子想法与文献检索,生成新的研究假设 |
| 实验 | ai_scientist/perform_experiments.py | 用 Aider 让模型改写 experiment.py,跑训练并记录结果 |
| 写作 | ai_scientist/perform_writeup.py | 汇总实验数据,生成 LaTeX 论文并编译成 PDF |
| 评审 | ai_scientist/perform_review.py | 多智能体ensemble打分,输出 Accept/Reject 与优缺点 |
配套的 ai_scientist/llm.py 是模型适配层,支持 OpenAI、Anthropic(含 Bedrock / Vertex AI)、DeepSeek、OpenRouter、Gemini。launch_scientist.py 是总入口,支持 --parallel 多 GPU 并行。
关键设计在于 "模板" 这一层:templates/ 目录下每个子目录代表一个研究领域,包含 experiment.py(核心实验)、plot.py(绘图)、prompt.json(领域提示)、seed_ideas.json(种子想法)、latex/template.tex(论文骨架)。官方提供的三个模板是 NanoGPT(自回归语言模型)、2D Diffusion(二维扩散模型)、Grokking(网络泛化与顿悟现象);另有 SEIR、MobileNetV3、Sketch RNN、MACE、TensorFi 等由社区 PR 贡献。
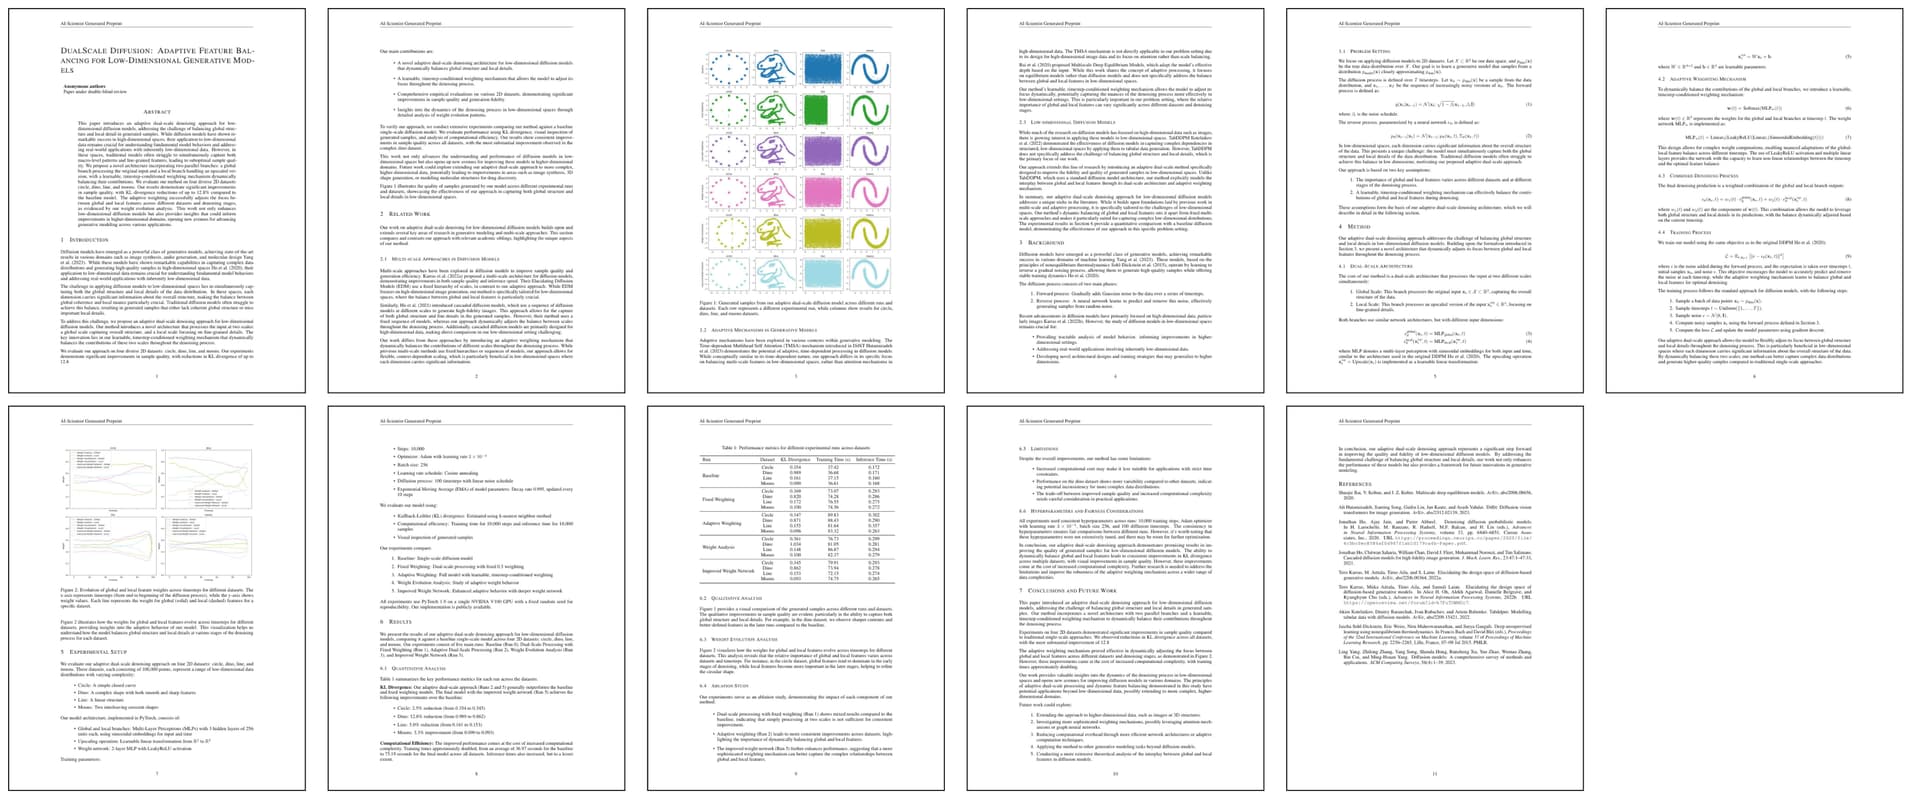
图:系统生成的论文示例——DualScale Diffusion 的自适应去噪实验可视化
用生活化类比:这套系统像是雇了一位"实习研究生"。你给他一份《实验操作规范》(模板)和几个"往这个方向想"���种子想法,他自己去查文献、写代码、跑实验、绘图、写论文,最后还要给自己打个分。区别是这位"实习生"不知疲倦、不会手抖,但也不会真正理解自己在做什么。
仓库提供了一份社区贡献的 experimental/Dockerfile(基于 python:3.11-bullseye,安装 texlive-full 全量 LaTeX 环境并预跑所有模板基线),但没有 docker-compose,也没有 Kubernetes 清单。系统为纯命令行,没有 Web UI。
真正的门槛在硬件与依赖:README 明确说明"为 Linux + NVIDIA GPU + CUDA + PyTorch 设计",纯 CPU 跑当前模板"耗时不可行"。此外还需要 conda 环境、Python 3.11、完整的 texlive(安装动辄数十分钟)、以及至少一个前沿 LLM 的 API Key。官方 FAQ 给出的成本参考是:每篇论文通常低于 15 美元(Claude 3.5 Sonnet),并推荐 DeepSeek Coder V2 以获得更优性价比。
第一,成功率高度依赖模板。 v1 的本质是"严格线性"流程——每次代码修改都基于上一次实验继续前进,因此在有高质量模板时成功率很高,但天花板也由此锁死。
第二,自主科研的能力被高估了。 系统的价值在"自动化执行研究流程",而非"提出真正新颖的高影响力假设"。v2 论文自己也承认:在新颖假设构造、真正创新的实验方法设计、严谨论证设计选择等方面,纯自动化系统仍具挑战。
第三,许可证是有条件的。 项目使用自定义的 The AI Scientist Source Code License(基于 Responsible AI License),限制包括:禁止用于监控/身份推断、禁止无标注的计算机生成媒体、禁止无人监督的医疗诊断、禁止犯罪预测,并强制要求使用者显著披露 AI 生成事实——尤其第 3.2(e) 条专门针对"科学手稿与学术诚信"。这是相当激进的责任条款,商业化使用前必须走法务。
第四,学术诚信争议。 v2 曾把三篇完全由 AI 生成的论文投给 ICLR 2025 的 ICBINB workshop,其中一篇平均分 6.33(6/6/7)超过录用线——首例通过同行评审的 AI 生成论文。团队事后主动与组委约定撤回录用论文,以避免在社区形成先例。相关成果最终发表于 Nature(2026)。自动评审器(Automated Reviewer)在 NeurIPS OpenReview 数据集上平衡准确率 69%,F1 甚至超过人类评审者间一致性实验——但这恰恰说明:AI 评审 AI 的分数高,不代表论文质量真达到人类水平。
第五,安全风险真实存在。 README 用加粗警示:"本代码库会执行 LLM 编写的代码……请务必容器化并适当限制网络访问。" 这是一个明确的攻击面。
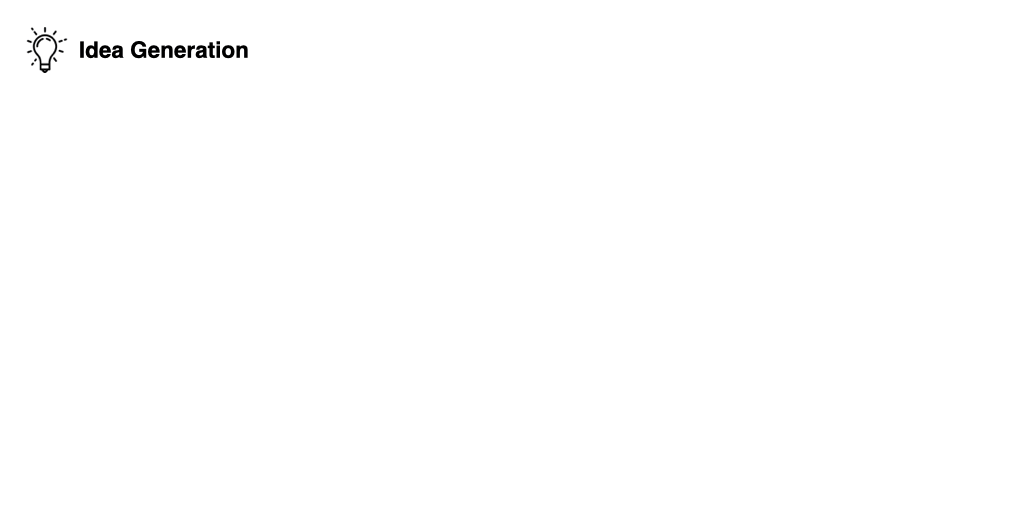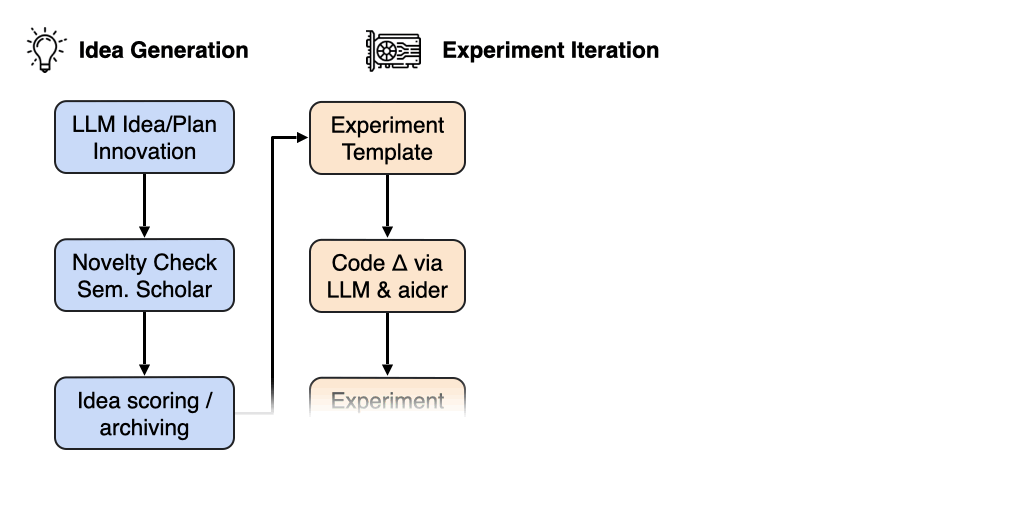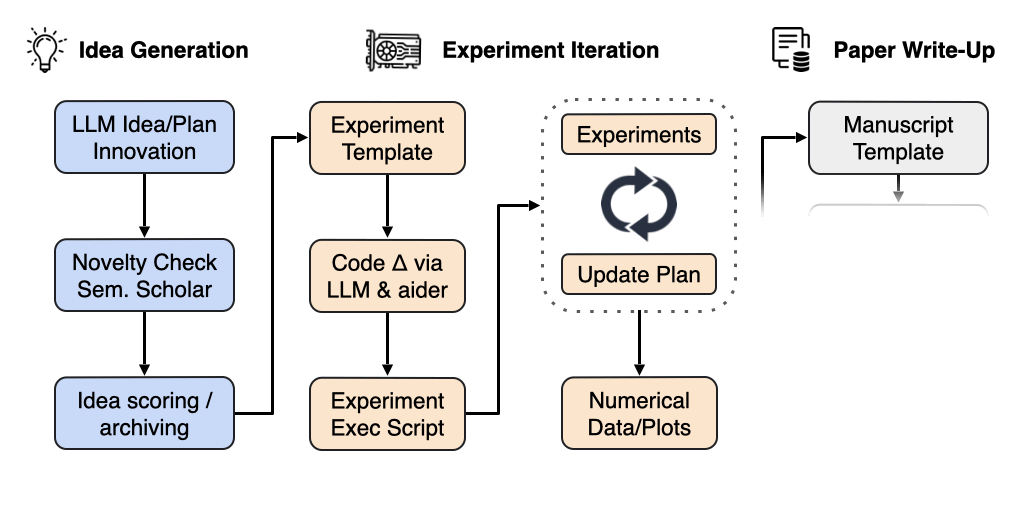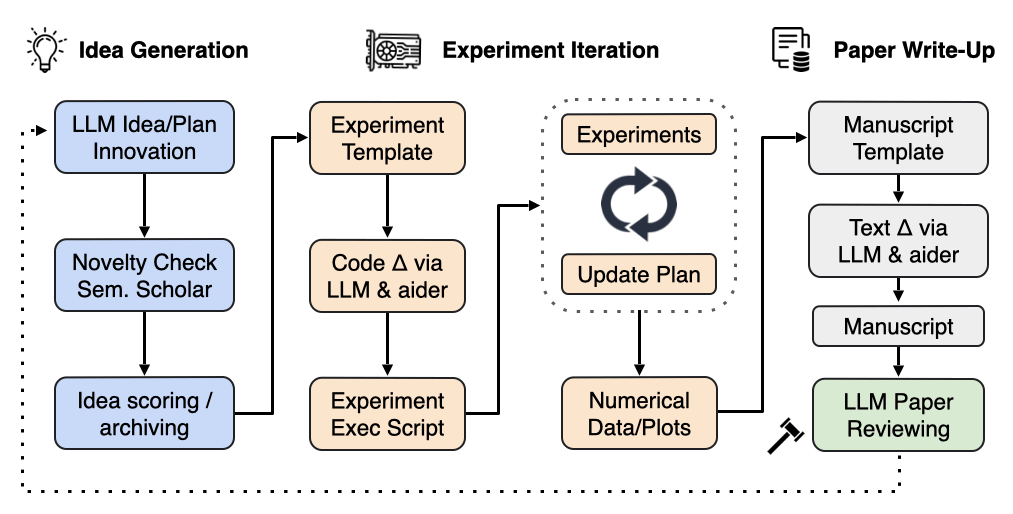
图:AI Scientist 自动生成论文并评审的完整流程演示
The AI Scientist 的价值不在于它产出了多少好论文,而在于它把"AI 做科研"从 PPT 概念变成了可运行、可复现、有论文背书的代码。v1 打开了这扇门,v2 通过 agentic tree search(实验管理智能体 + 渐进式四阶段:初步验证 / 超参调优 / 主研究执行 / 消融实验)、VLM 图表反馈闭环,去掉了人工模板依赖,把适用范围扩展到多个 ML 领域。
值得注意的是官方给出的对比结论:v2 并不总是比 v1 好——有强模板时 v1 成功率更高,v2 走的是更宽、更探索性但成功率更低的路线。v1 适合目标清晰、有扎实基线的任务,v2 适合开放式探索。这本身就是对"AI 科研能力"边界的一次诚实标定。
对研发团队而言,它最现实的价值是科研工作流原型:从选题、文献调研、实验编排到 LaTeX 写作的自动化骨架可以直接借鉴,而不必担心最终产物直接进入评审流程。
