
ComfyUI-Step_Audio_EditX_TTS
Saganaki22/ComfyUI-Step_Audio_EditX_TTS加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:深夜,你在剪辑一段 vlog,视频旁白需要换成更专业的音色——但配音演员已经下班,录音棚费用高昂,AI 合成的声音又总有一股"机械味"。这时候,你只需要一段 10 秒的参考音频,就能让 AI 学会那个声音,然后用它说出任何内容。ComfyUI Step Audio EditX TTS 正是为这类需求而生。
语音合成(TTS)在过去几年突飞猛进,GPT-4o、StyleTTS2 等模型已经能生成相当自然的声音。但克隆一个特定人的音色——保留他独特的口音、语调、情绪表达——始终是个技术门槛极高的事。传统方案要么需要数小时的训练数据,要么对硬件要求离谱,普通创作者根本无法上手。
StepFun AI(阶跃星辰)推出的 Step-Audio-EditX 模型,试图解决这个问题。它来自一篇 2025 年 11 月的 arXiv 论文(arXiv:2511.03601),采用了一种创新的双码本分词器(VQ02 + VQ06)架构,配合 3B 参数的 LLM 来生成高质量语音。GitHub 用户 Saganaki22 将这个模型封装成了 ComfyUI 原生节点,让任何使用 ComfyUI 的创作者都能零门槛体验这一技术。
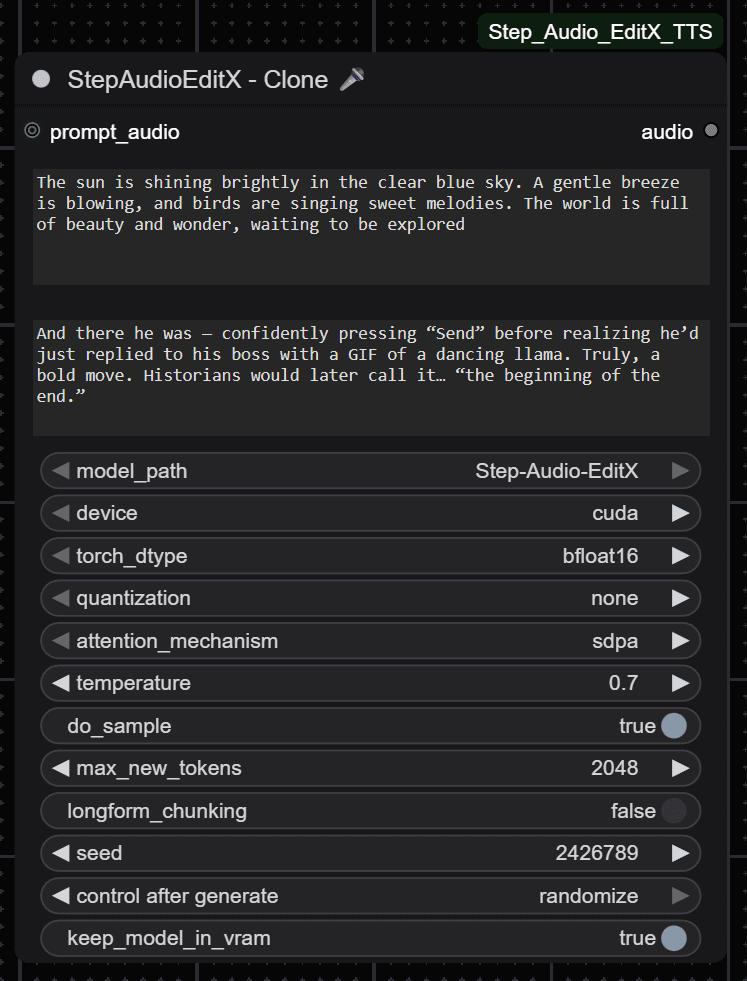 Clone Node 界面 — 只需提供参考音频和文本,即可克隆任意音色
这个项目实际上包含两个互补的节点:Clone(克隆) 和 Edit(编辑)。
Clone 节点的逻辑非常直接:给它一小段参考音频(3-30 秒)和对应的原文转写,再输入你想让 AI 说的话,它就能用参考音色的特征生成新语音。背后的技术路径是:Whisper 提取音频特征 → Step-Audio-EditX 的 3B LLM 理解语义并生成音频 token → CosyVoice vocoder 将 token 还原为 24kHz 波形。Edit 节点则更进一步,在不改变音色身份的前提下,对已有音频注入情感(happy、sad、angry、excited)、调整语速(0.6x ~ 1.5x)、添加拟声词(笑声、呼吸声、叹息声),甚至降噪。
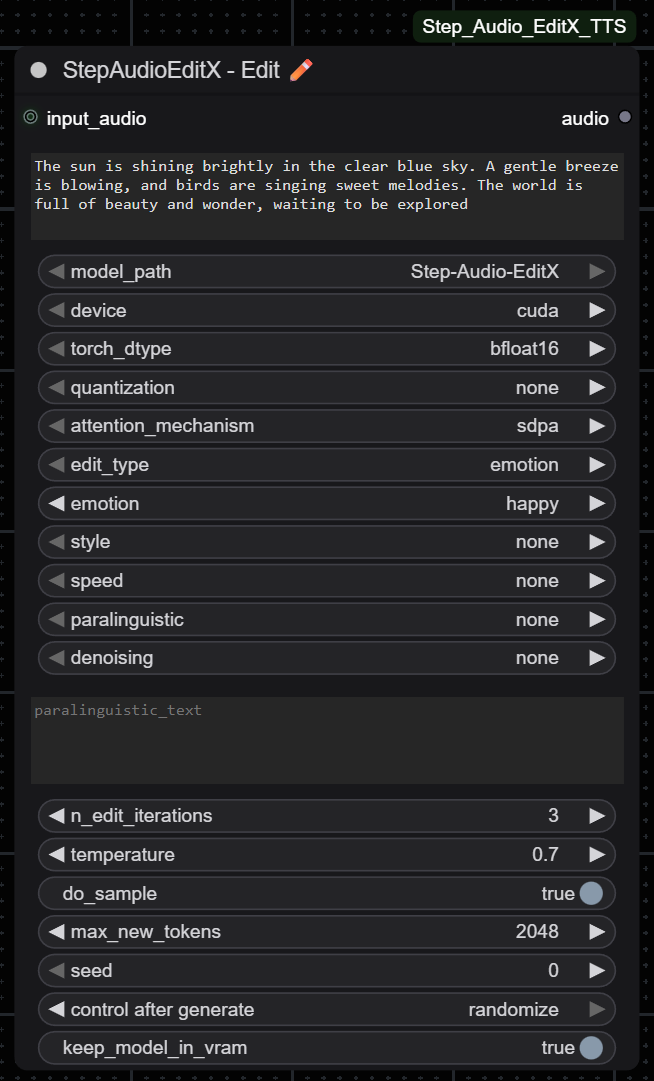 Edit Node 界面 — 对音频注入情感、改变说话风格或语速
项目最值得关注的技术亮点在于其**双码本分词器(Dual-codebook Tokenizer)**设计。传统语音 TTS 通常将语音编码为单一 token 序列,信息密度受限。Step-Audio-EditX 创新地使用 VQ02 和 VQ06 两个量化码本,分别捕捉语音的不同维度特征——一个负责韵律和语调,另一个负责音色和音质。3B 参数的 LLM 在这两个码本之间建立关联,生成时再通过 CosyVoice vocoder 还原为高质量音频。
这种架构带来的直接好处是:零样本克隆(无需模型微调)和精细的音频风格控制。从代码结构看,项目的实现也相当规范:core/ 目录下包含 voice_cloner.py(克隆逻辑)、audio_editor.py(编辑逻辑)、longform_chunker.py(长文本分段与拼接)和 model_manager.py(模型生命周期管理);step_audio_impl/ 则包含了完整复现的 TTS pipeline,从分词器到生成器到 vocoder 一应俱全。
依赖方面,项目对 transformers 版本有严格锁定(必须是 4.53.3,新版本存在 token 生成 bug),同时依赖 torchaudio、librosa、soundfile 处理音频 I/O,以及 openai-whisper 做语音识别。FFmpeg 作为系统级依赖必须单独安装。
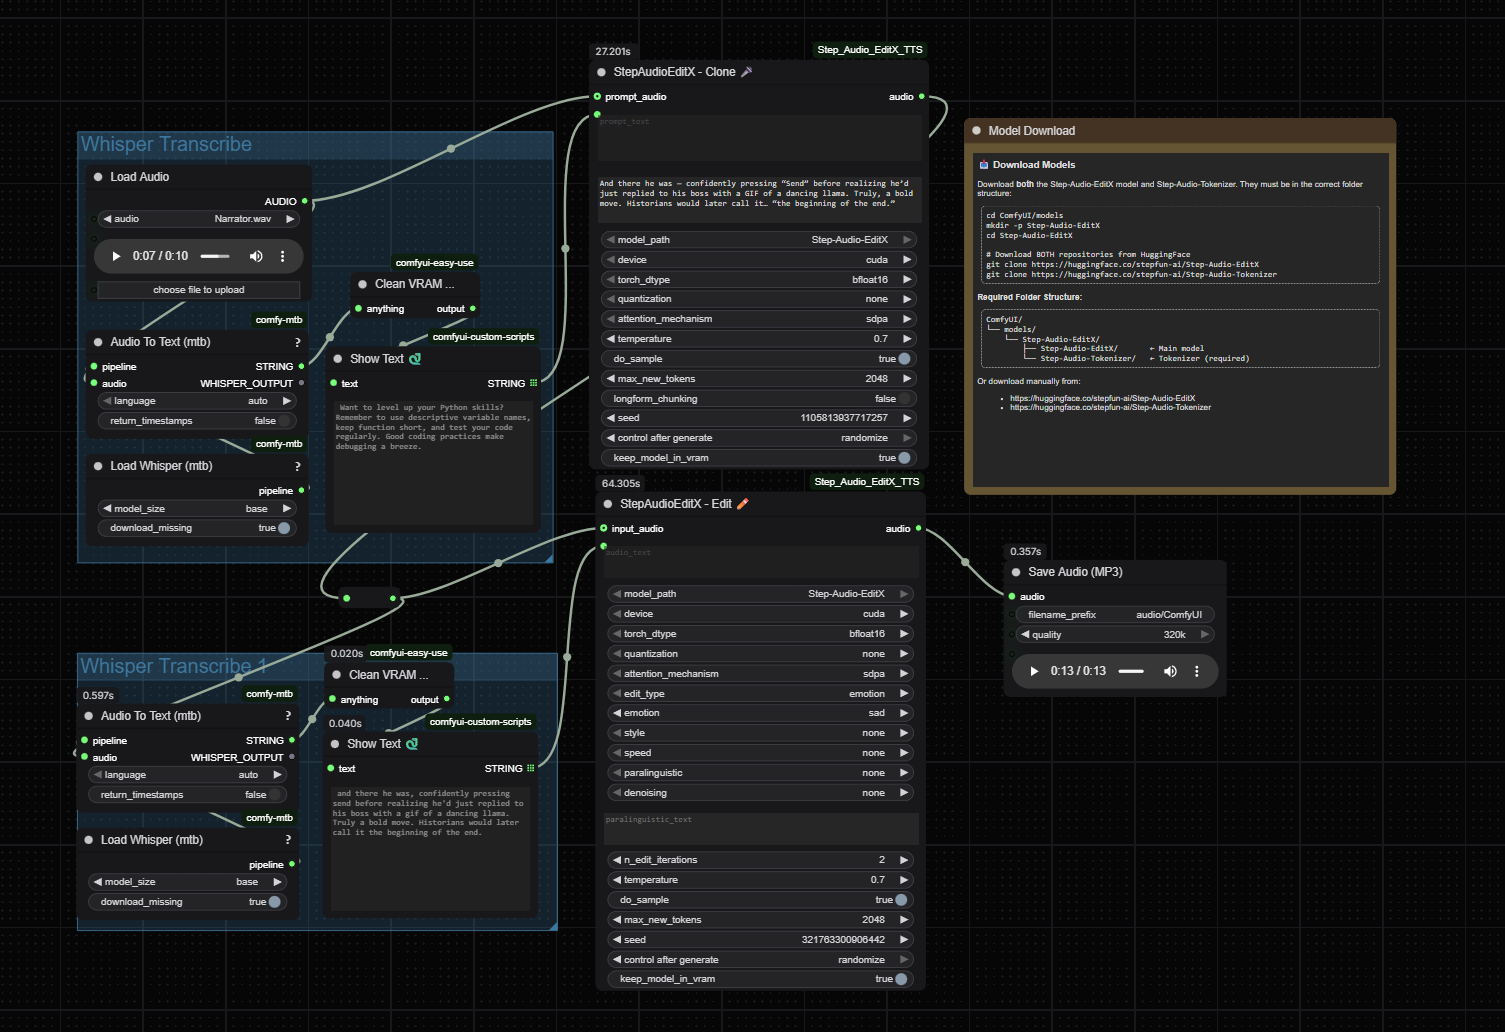 高级工作流:Whisper 识别 + Clone + Edit 全链路处理
必须直面一个现实:这不是一个轻量级项目。Clone 节点在 bfloat16 无量化模式下需要 11-14GB VRAM,Edit 节点更是 14-18GB。这意味着 RTX 3090 是最低门槛,RTX 4090 / A6000 才是理想配置。项目提供了 int8 和 int4 量化选项,可以将 VRAM 需求降低到 9-12GB,但会牺牲一定音质。
值得注意的是,Edit 节点对音频长度有硬性限制:被编辑的音频必须在 0.5-30 秒之间,超过 30 秒的音频必须先切分才能处理。这是一个重要的工程约束,在使用前必须规划好工作流。
项目在 README 中坦承了几个局限:首先,依赖版本管理复杂,transformers 版本锁定意味着与 ComfyUI 其他节点可能存在依赖冲突;其次,量化模型仍在等待 Step AI 团队发布优化版本,当前的 int4 量化质量损失明显;最后,Edit 节点的 30 秒限制在处理播客、长视频旁白等长内容时需要额外的工作流设计。
此外,项目仓库中有部分遗留链接指向已不存在的 issue 页面,说明维护状态略有滞后,需要用户有一定的自主排查能力。
Step-Audio-EditX 的出现,代表了音频 AI 从"通用合成"向"个性化克隆"的演进方向。配合 ComfyUI 的可视化工作流,它将高门槛的语音克隆技术带到了更广泛的创作者群体中。随着量化技术成熟和模型优化,这个方向的发展空间仍然值得期待。
本报告基于 GitHub 仓库 Saganaki22/ComfyUI-Step_Audio_EditX_TTS (v1.0.6, Apache-2.0) 生成,分析时间 2026-08-11。
