
AI_Teammates_in_SE3
SAILResearch/AI_Teammates_in_SE3加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你打开 GitHub,发现一个仓库里堆满了来自同一个「开发者」的 PR——它每天提交上百个代码改动,从不抱怨,从不请假,凌晨三点也在孜孜不倦地修 Bug。这个「开发者」,其实是一行代码都没有的 AI。
这正是 SAILResearch/AI_Teammates_in_SE3 这份研究试图回答的核心问题:当 AI 编程代理(AI Coding Agent)开始大规模参与真实软件工程活动时,整个生态会变成什么样子?
这个仓库是论文 "The Rise of AI Teammates in Software Engineering (SE) 3.0: How Autonomous Coding Agents Are Reshaping SE" 的复现包,由上海人工智能实验室(SAIL)的研究团队发布,并入选了 MSR 2026 Mining Challenge(与 ICSE 2026 同期在里约热内卢举办)。
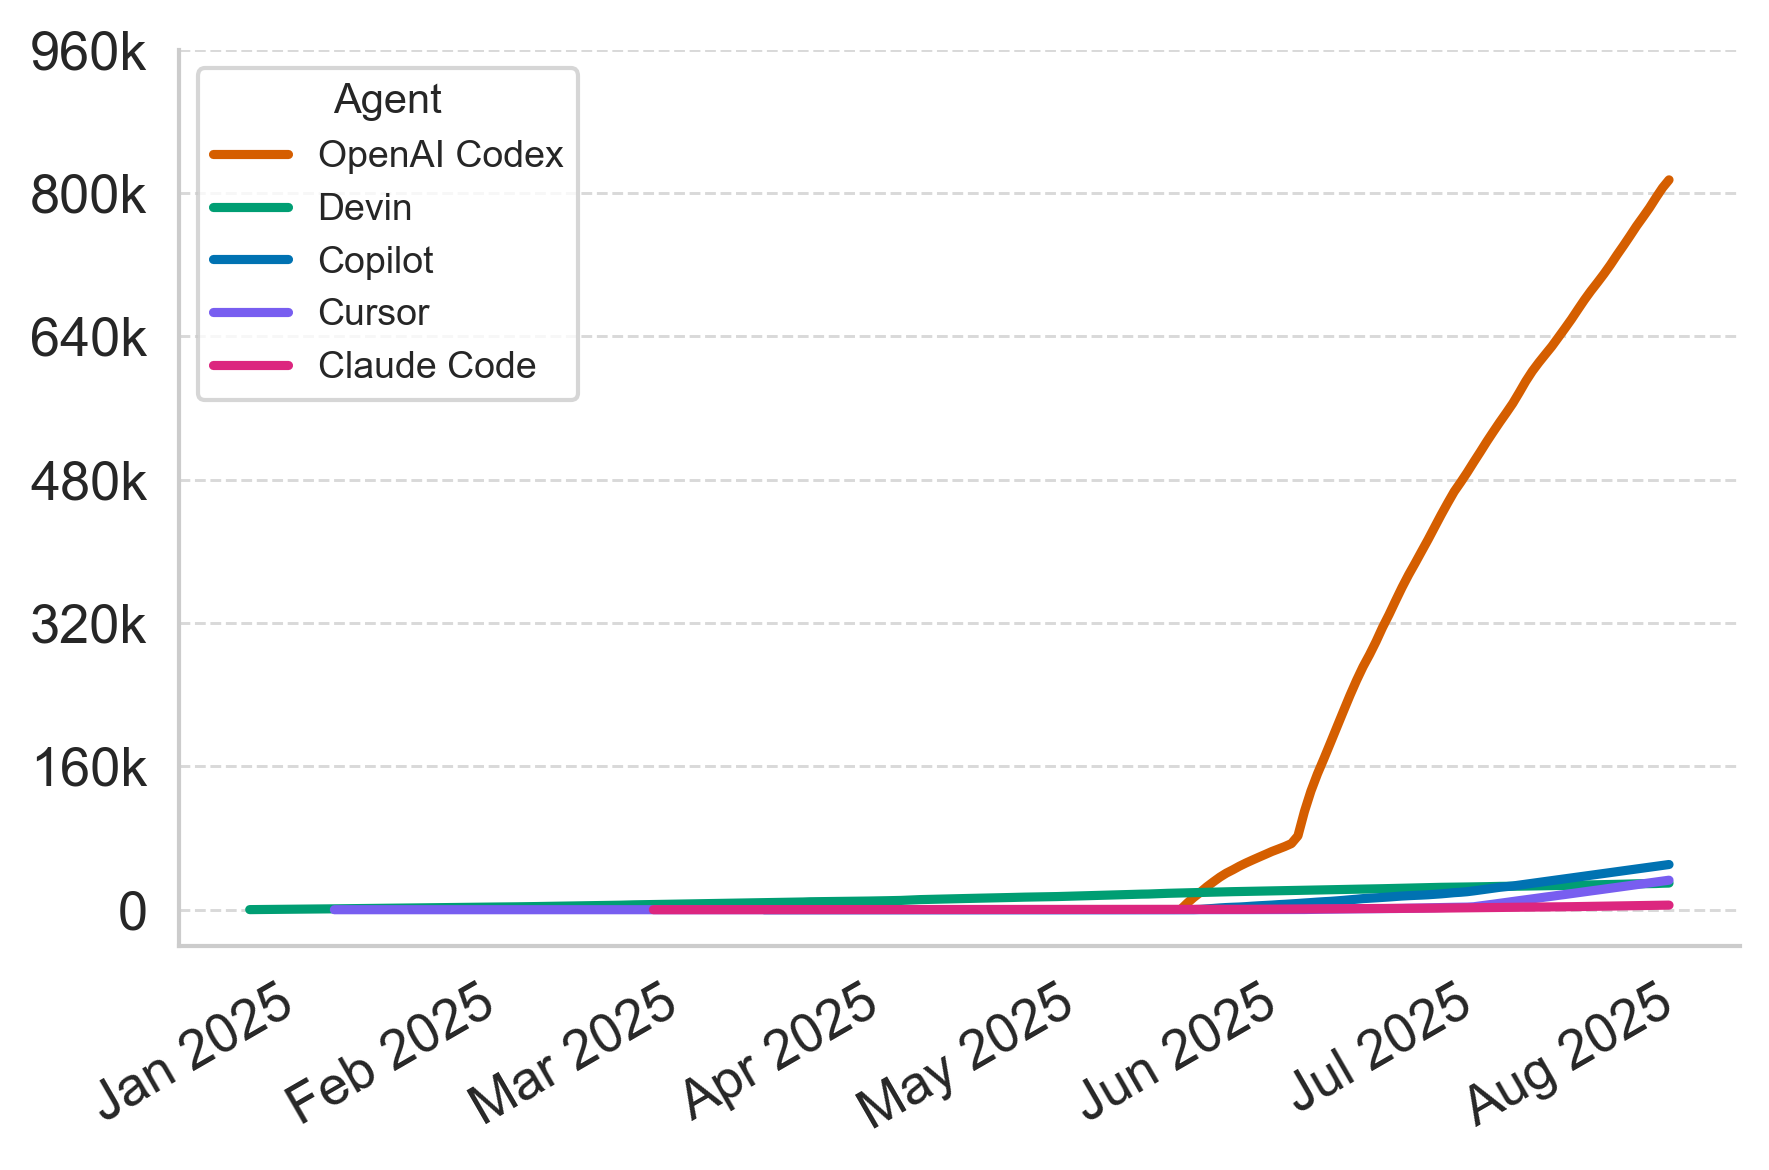
AIDev 数据集是目前关于 AI 编程代理最全面的开源数据集之一。它从 GitHub 挖掘了 932,791 条 PR,涉及 116,211 个仓库和约 7.2 万名开发者(注意:部分 AI 代理如 Devin 和 GitHub Copilot 不公开具体用户数)。
数据集覆盖五大主流 AI 编程代理:
| AI 代理 | PR 数量 | 涉及仓库数 |
|---|---|---|
| OpenAI Codex | 814,522 | 84,704 |
| Devin | 29,744 | 4,747 |
| GitHub Copilot | 50,447 | 14,492 |
| Cursor | 32,941 | 12,699 |
| Claude Code | 5,137 | 1,915 |
OpenAI Codex 凭借先发优势占据了绝对主导地位——81 万条 PR,占总数近 87%。但 Claude Code 和 Cursor 作为后起之秀,增长曲线值得关注。
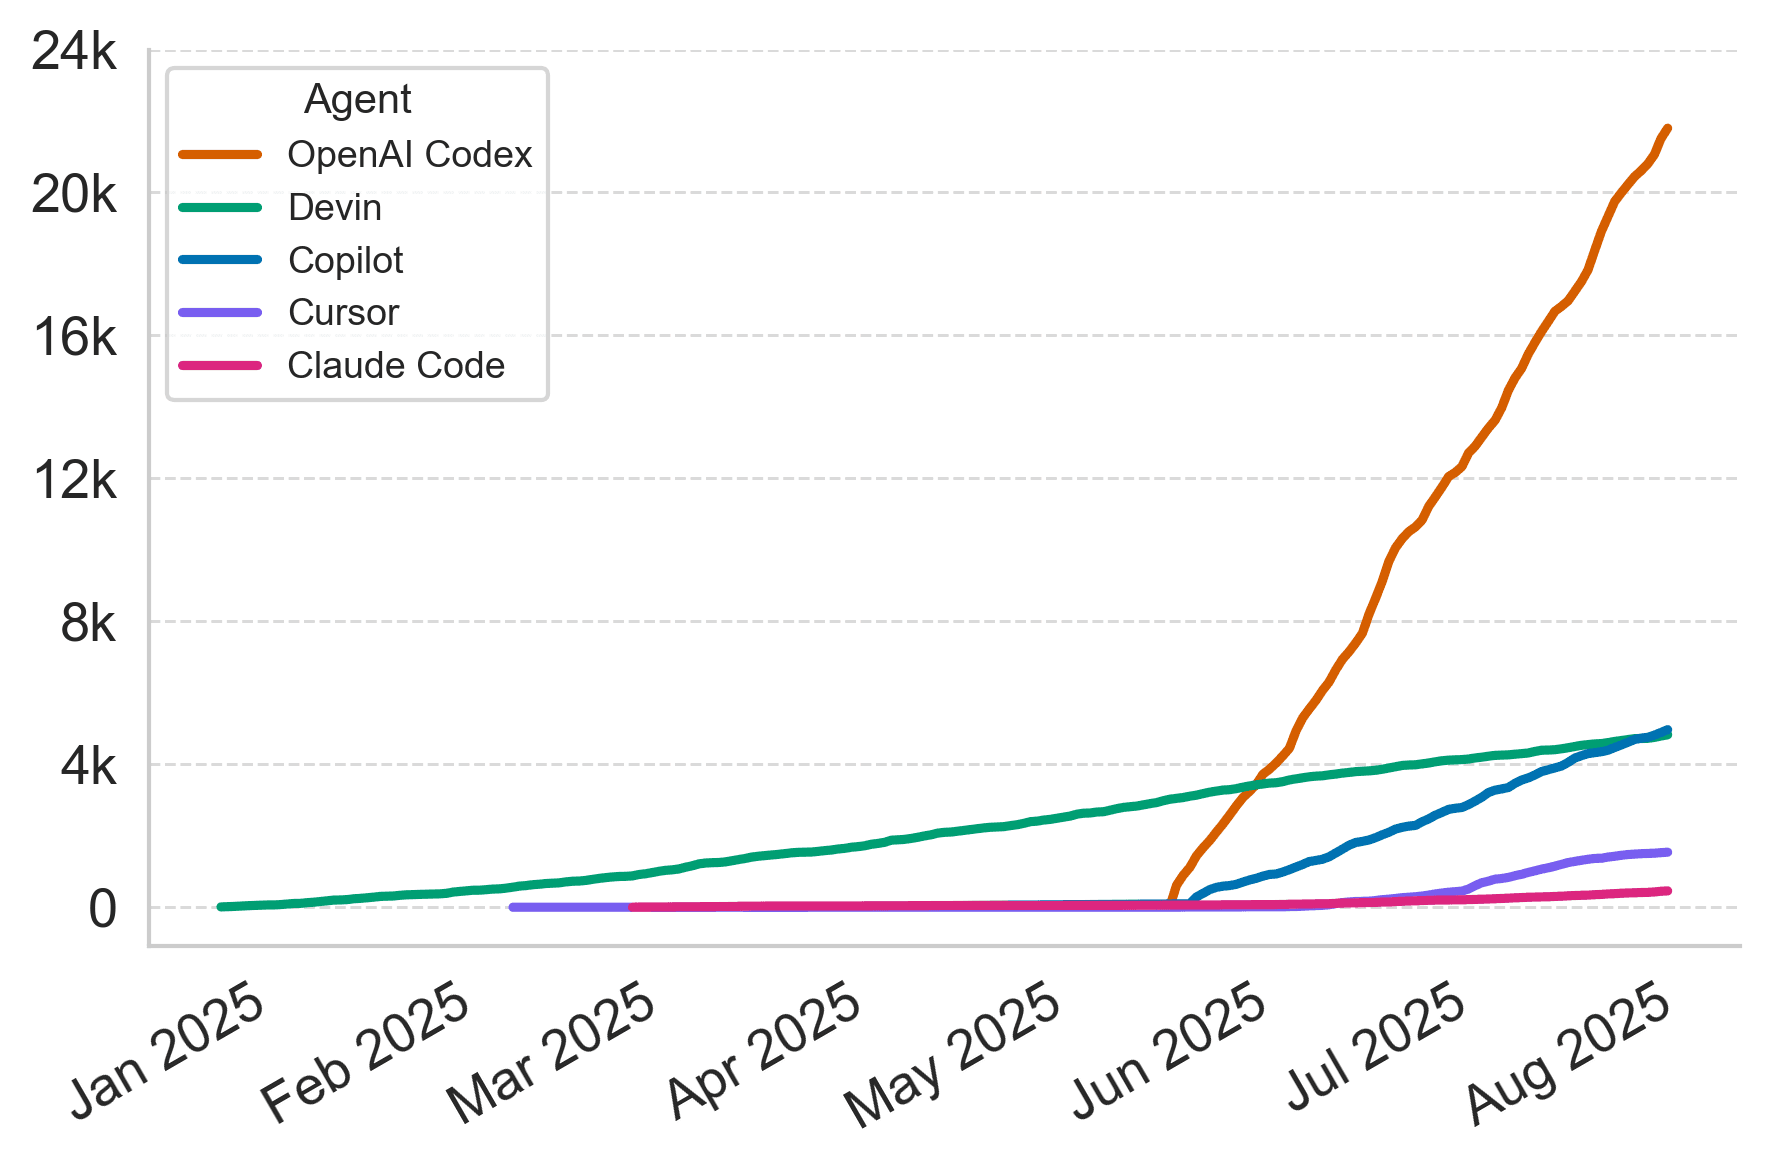
对于高质量项目(AIDev-pop 子集,筛选标准:仓库 stars > 100),数据略微平衡了一些:OpenAI Codex 仍有 2.1 万条 PR,但 Cursor 和 Claude Code 的占比明显提升,说明专业开发者更愿意为高星项目付费使用 AI 工具。
研究团队对各 AI 代理的 PR 合并率进行了多维度对比分析,从代码质量、变更规模、测试覆盖等角度构建了综合雷达图。
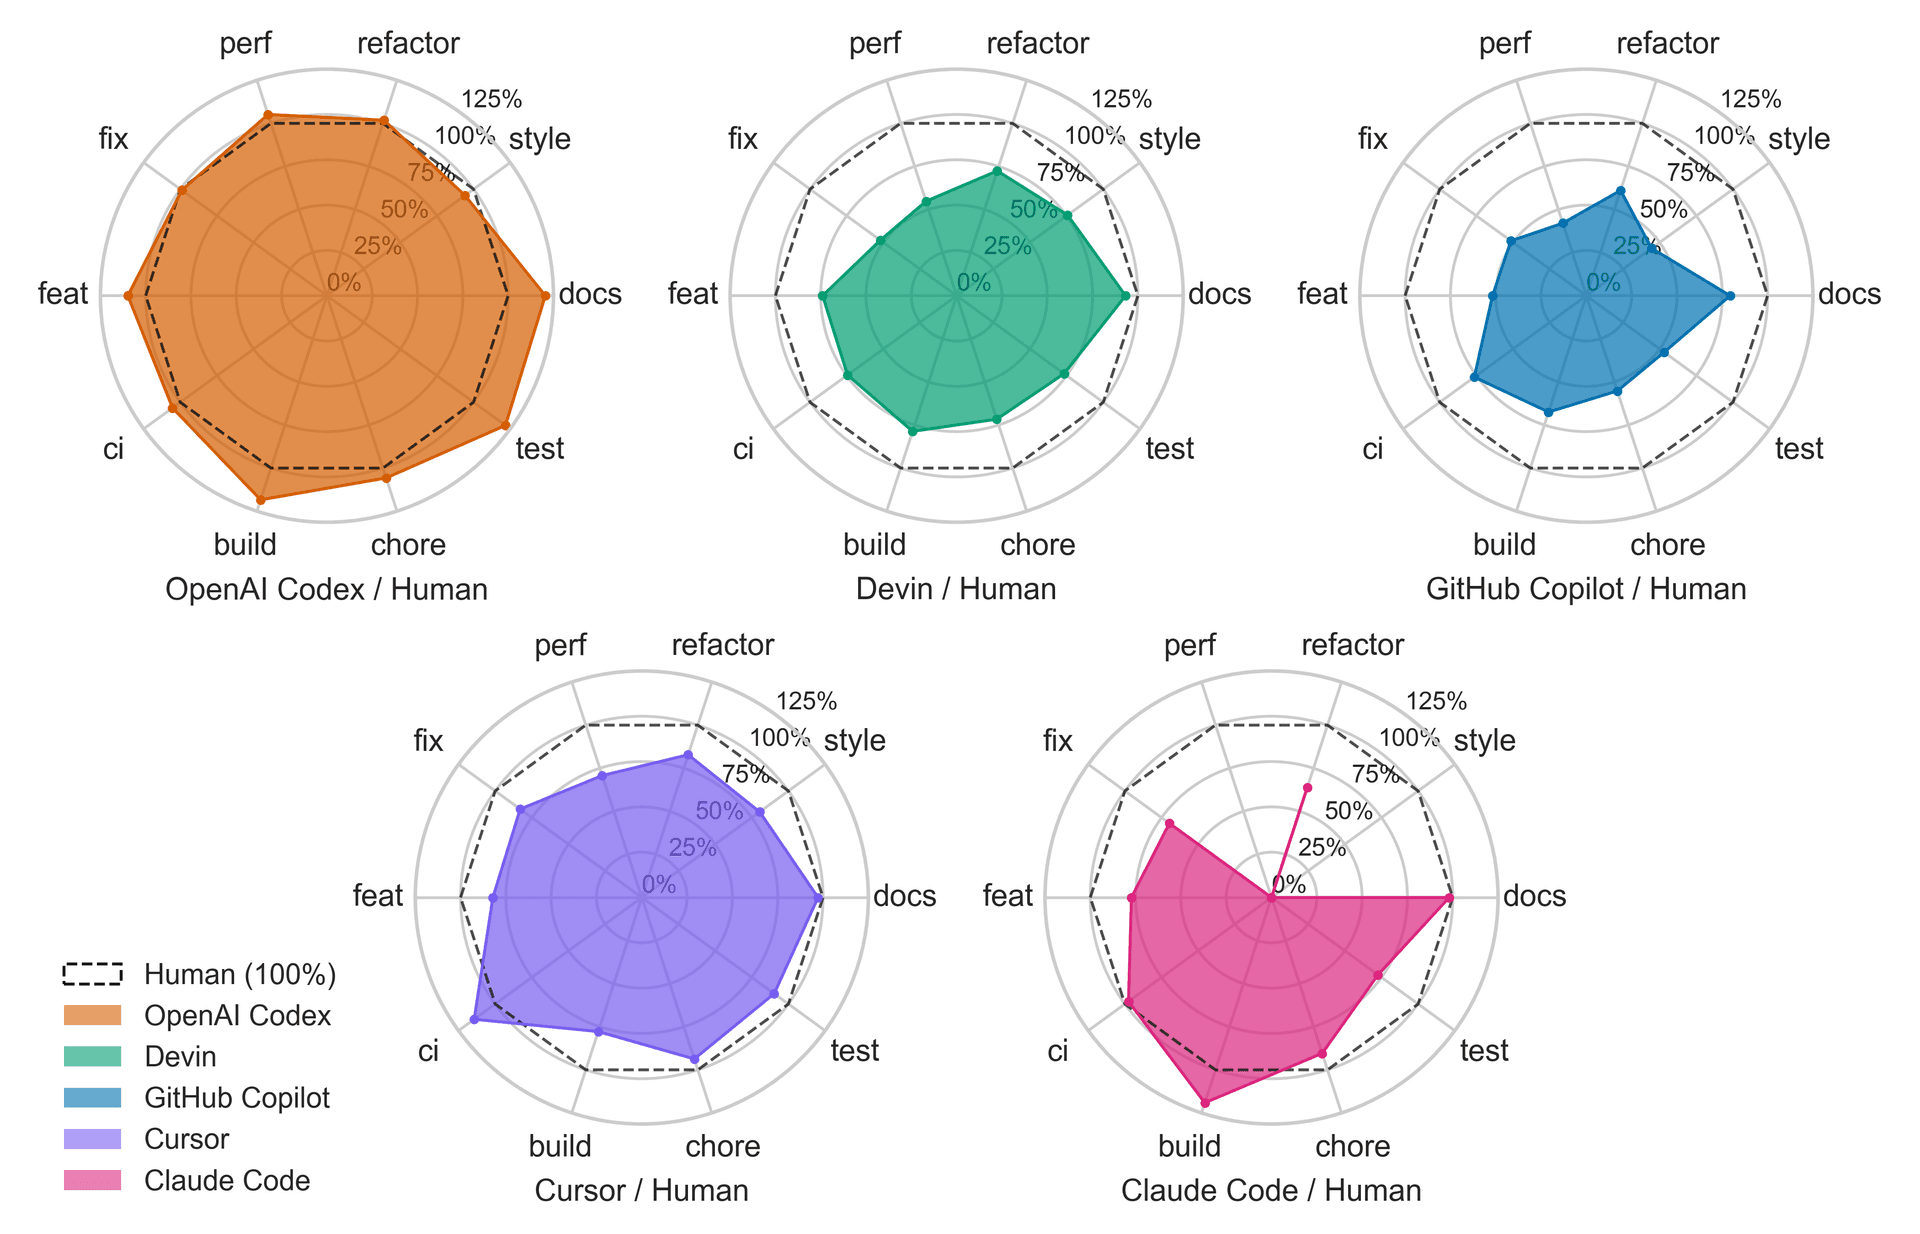
一个值得深思的发现是:AI 代理的高 PR 提交量并不意味着高接受率。Devin 提交了约 3 万条 PR,但高星项目中的合并率表现并不突出——这可能暗示自主性越强的代理,越容易产生偏离人类开发者预期的代码风格或实现路径。
研究还分析了 AI 代理的 PR 周转时间(从提交到合并或关闭的耗时)。
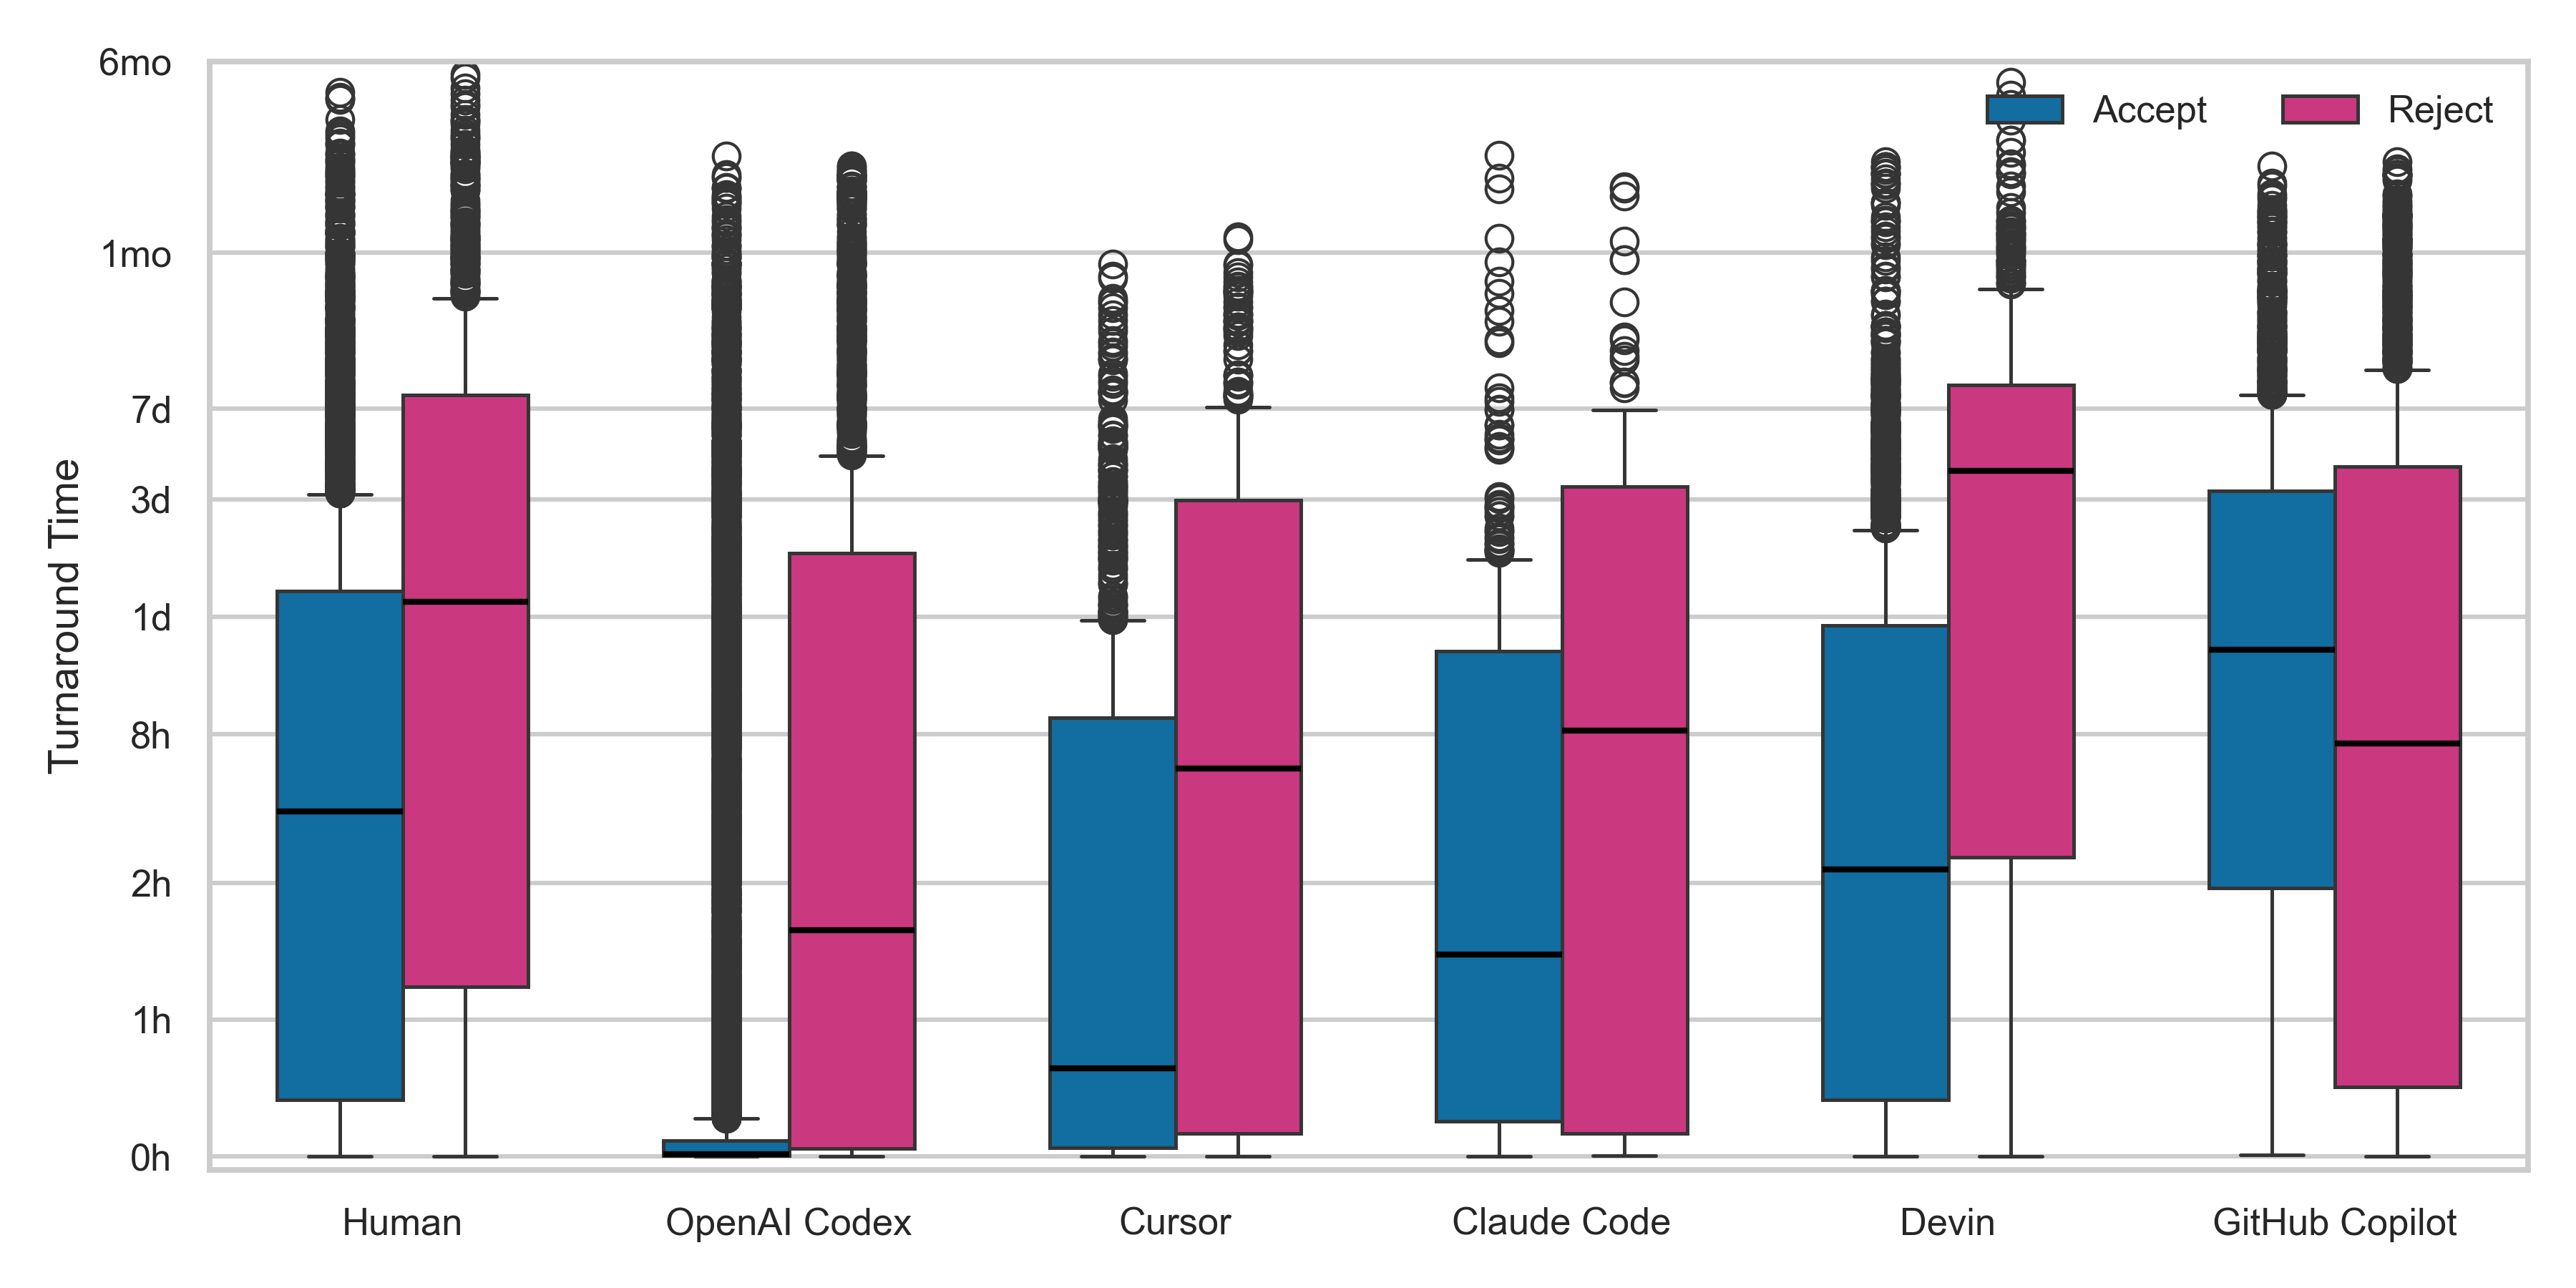
数据显示,GitHub Copilot 的中位处理时间远低于其他代理——大量 PR 在 15 分钟内完成,这与其深度集成 GitHub 生态、在提交前就能与代码库上下文紧密对齐有关。相比之下,Claude Code 和 Cursor 的周转时间分布更广,说明它们在处理更复杂任务时会花费更多时间。
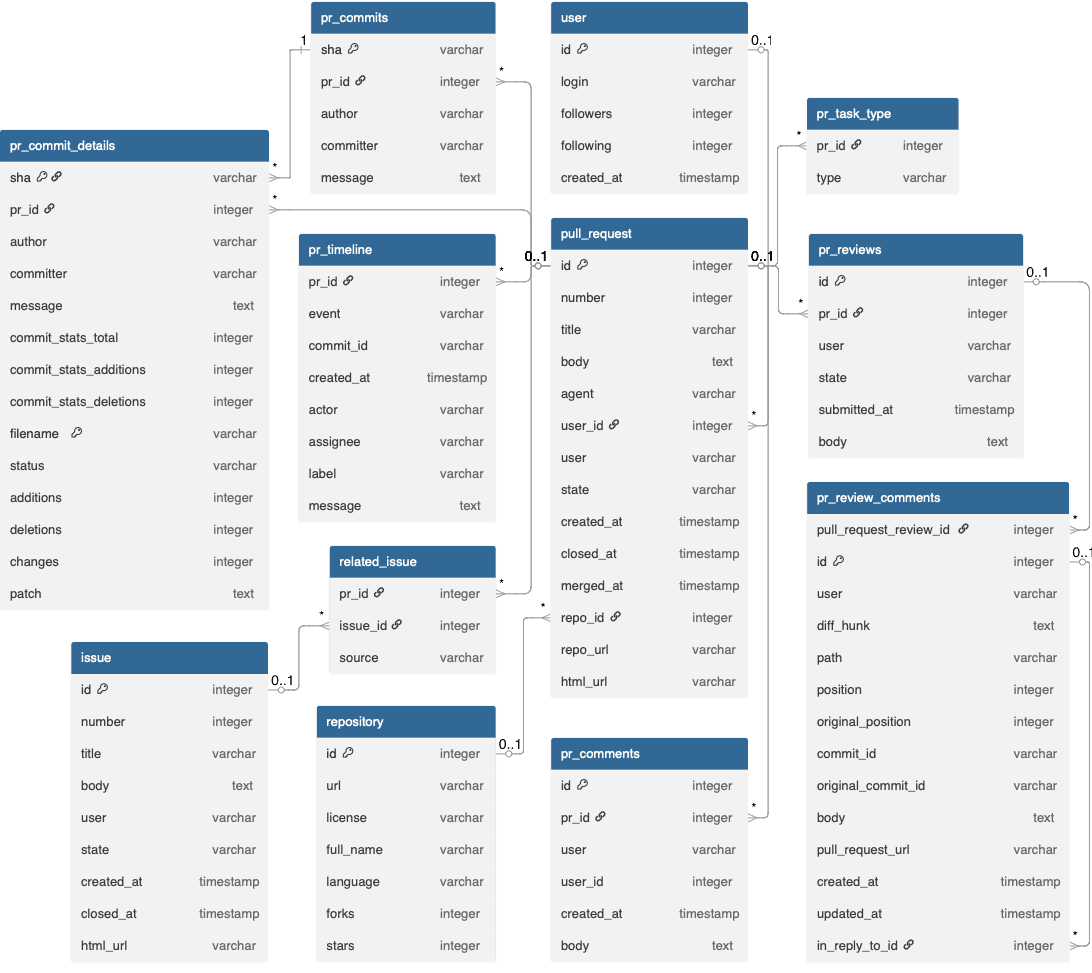
数据集的核心字段包括:PR 基本信息、AI 代理类型(通过提交邮箱或 GitHub App 识别)、代码语言分布、仓库元数据等。完整数据集(约 GB 级别)托管在 HuggingFace 上,仓库本身仅包含复现脚本和轻量级样本。
本仓库是一个纯数据分析型研究项目,核心技术栈为 Python + Jupyter Notebook,主要依赖:
核心分析脚本位于 analysis/ 目录下:
load_AIDev.ipynb:加载数据集的基础用法dataset_overview.ipynb:数据集全局概览language_usage.ipynb:各编程语言的使用分布分析productivity.ipynb:PR 合并率与周转时间生产力分析classify_pr.py:PR 分类脚本代码结构清晰、注释详尽,体现了学术复现包的严谨性。
任何研究都有其局限性,这项研究也不例外:
1. 识别方法的精确性问题:AI 代理通过 GitHub App 安装邮箱或特定提交模式识别,但这些标识符可以被伪造或滥用,数据集的纯净度依赖于识别算法的准确性。
2. 代理能力的时代偏差:Claude Code 和 Cursor 的数据量相对较少,可能是因为它们出现时间较晚(2024 年),还未积累足够的使用数据,与 OpenAI Codex 的对比存在时间维度的天然不公平。
3. PR 合并率 ≠ 代码质量:合并率高可能是因为 AI 代理更擅长处理简单、低风险的重复性任务(如依赖更新、文档修复),而非复杂的功能开发。
论文标题中的「SE 3.0」是一个值得关注的概念框架:
这份研究通过大规模实证数据,为 SE 3.0 的现状画了一张「全家福」。无论你是 AI 研究者、软件工程学者,还是正在考虑引入 AI 编程工具的工程团队,这份数据集和复现包都值得认真研读。
完整数据和最新更新请访问:https://huggingface.co/datasets/hao-li/AIDev
