
text-to-sql
RominaElenaMendezEscobar/text-to-sql加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你是电商公司的运营分析师,双十一零点刚过,GMV 数据在数据库里翻涌。你想知道"今天广东地区 30 岁以下用户的客单价排名",但 SQL 语句要写半小时——等写完,报表早就凉透了。
Text-to-SQL 就是来解决这个问题的:你说一句"广东30岁以下用户客单排名",AI 直接吐出 SQL,1 秒出结果,你直接看图表就行。
RominaElenaMendezEscobar/text-to-sql 项目就是这样一个基于自然语言查询数据库的实战教程,基于 Vanna.AI + Streamlit 构建,适合想快速落地 Text-to-SQL 能力的开发者参考。
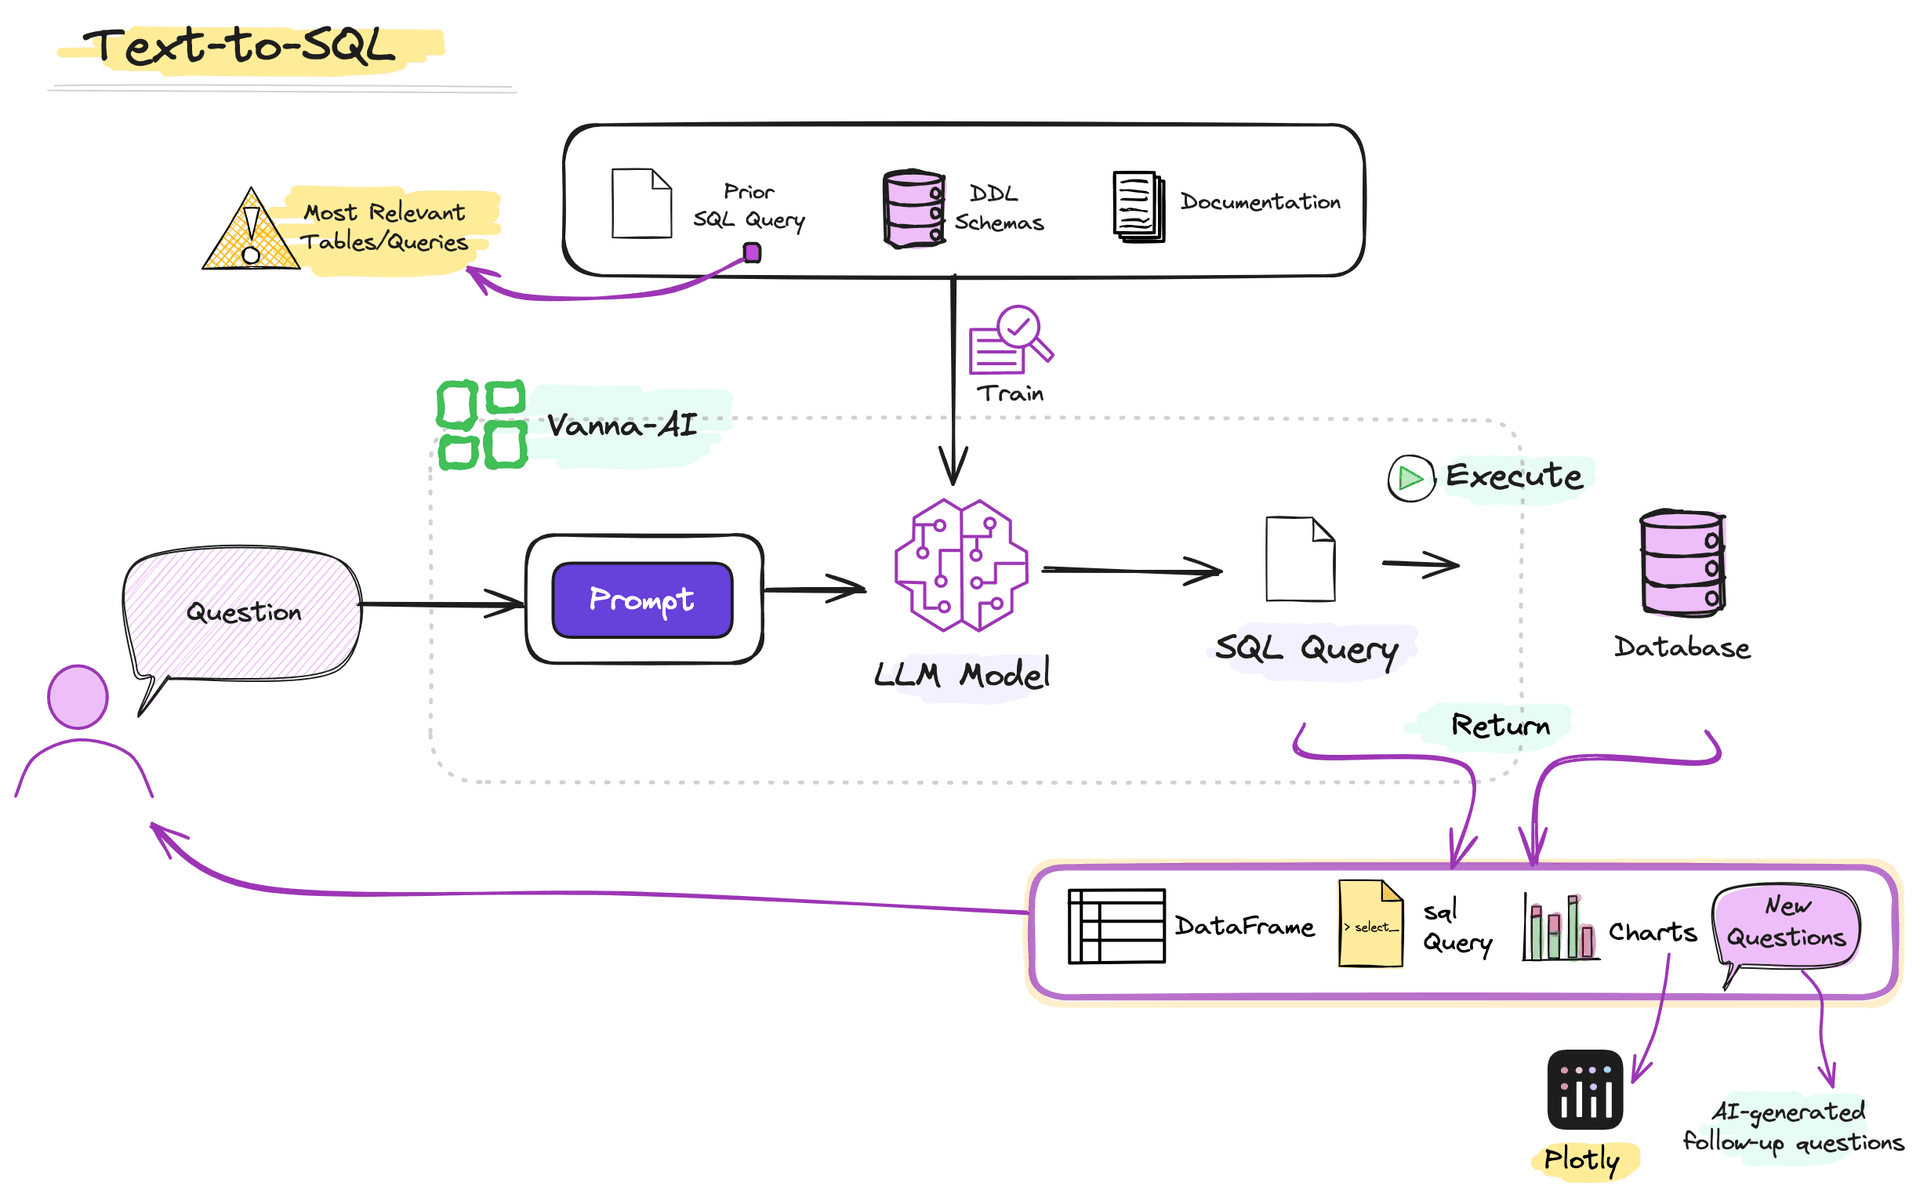 Text-to-SQL 核心流程:自然语言 → LLM → SQL → 数据库 → 结果返回
Vanna.AI 是一个专注于 Text-to-SQL 场景的开源 Python 库,核心思路是 RAG(检索增强生成):
这种"先训练再推理"的模式,比直接让 LLM 自由发挥准确率高得多——Vanna 官网称在复杂数据库上准确率可达 90%+。
本项目并非 Vanna.AI 的官方库,而是一个 手把手实战教程(Jupyter Notebook + 配套源码),作者 Romina 通过 Streamlit 构建了一个可交互的对话界面,演示了完整的 Text-to-SQL 工作流。
用户只需在 Chat 对话框输入业务问题,例如:
"列出 2024 年销售额超过 10 万的城市"
Vanna.AI 自动解析语义,检索训练数据,生成对应 SQL 并执行,返回 DataFrame 或 Plotly 图表。
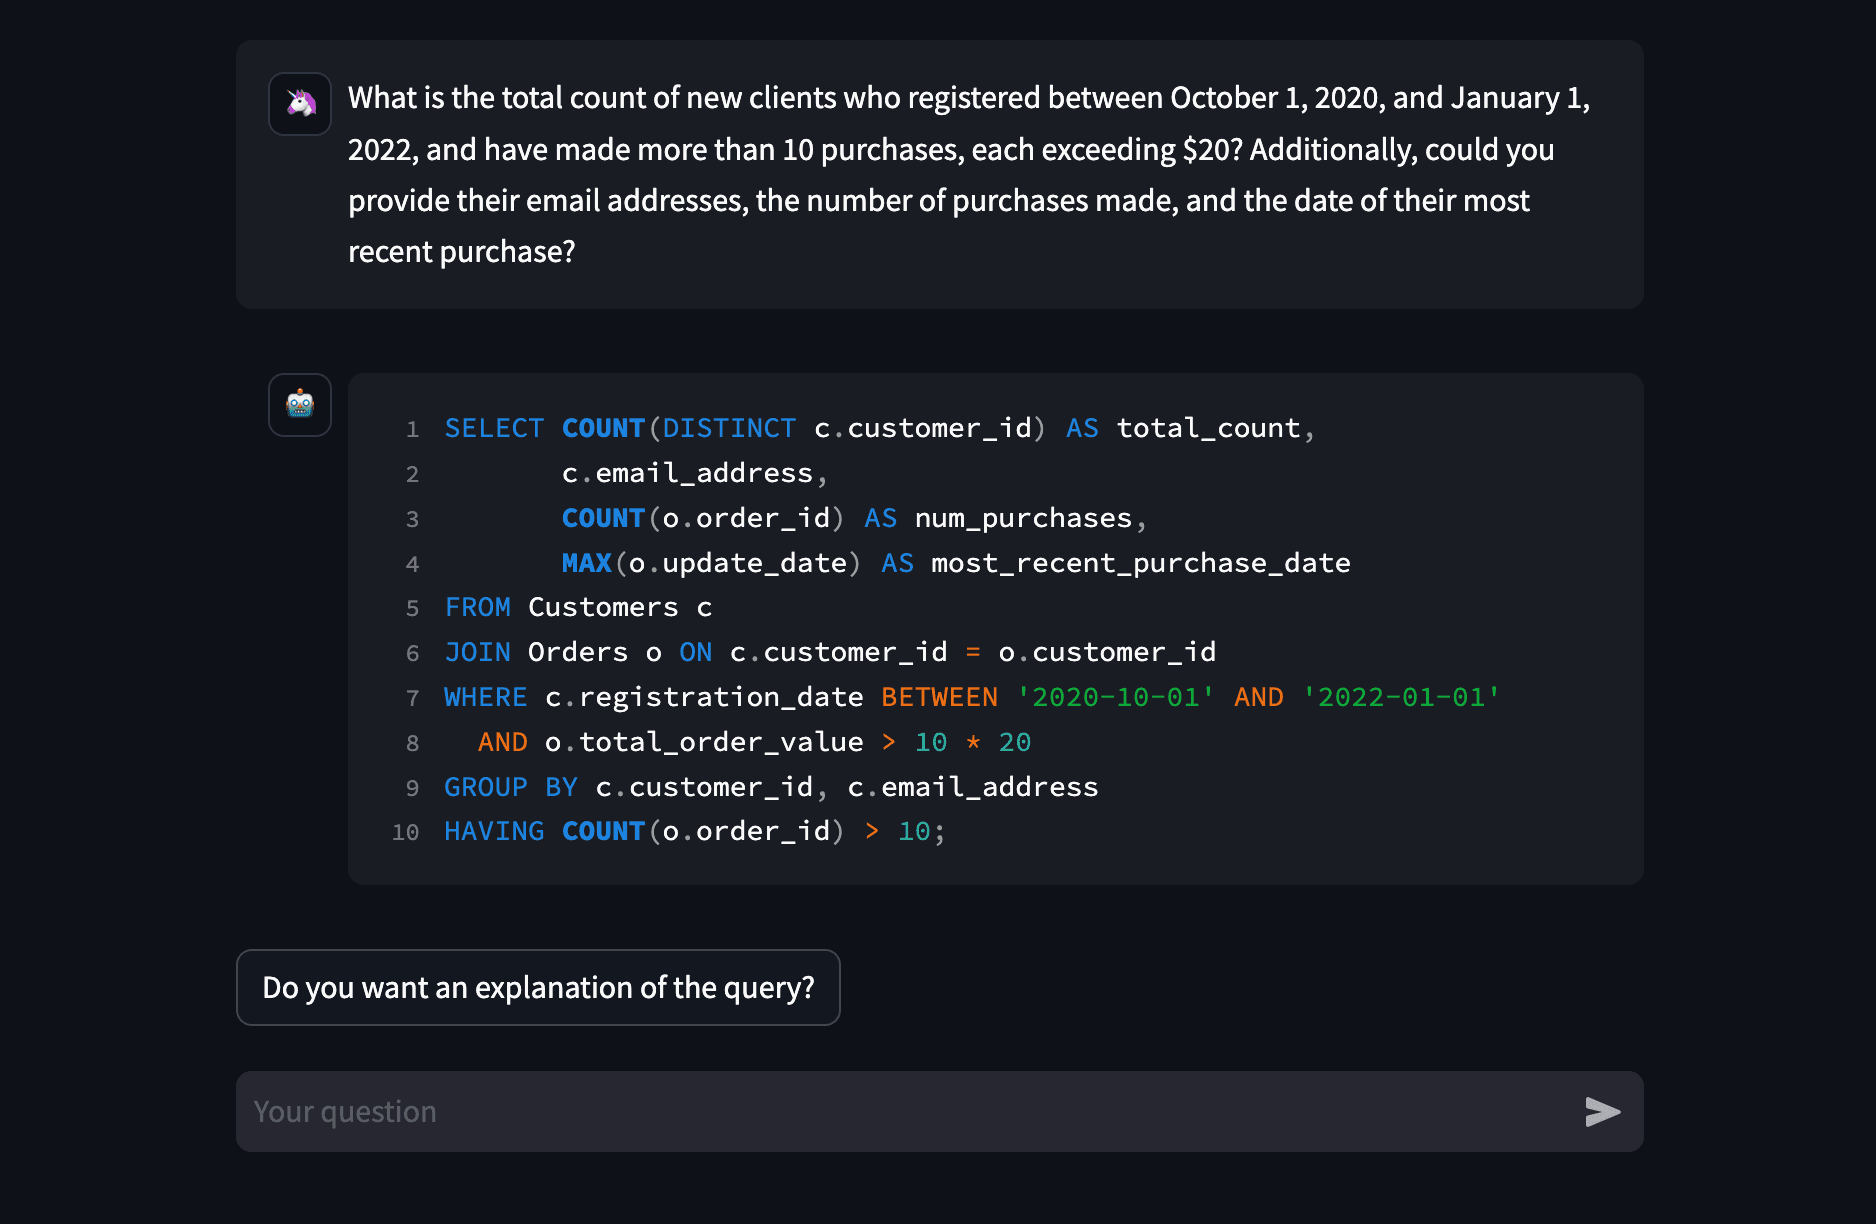
 基于 Streamlit 的对话界面,支持 SQL 代码高亮展示
生成的 SQL 是什么意思?点击"Do you want an explanation of the query?"按钮,AI 会自动解释这条 SQL 的逻辑——取数范围、聚合维度、过滤条件一一说明。这对业务人员理解数据很有帮助。
 AI 自动解释 SQL 语句含义,便于业务人员理解
Vanna.AI 支持 PostgreSQL、MySQL、SQLite、BigQuery 等多种数据库连接,一次训练可复用于同一个数据库的多次查询。
text-to-sql/
├── src/
│   ├── main.py          # Streamlit 主界面
│   ├── train_model.py   # Vanna 模型训练逻辑
│   └── utils.py         # 文件读取工具(YAML/SQL)
├── db/
│   ├── ddl/             # 数据库 DDL(表结构)
│   ├── queries/         # 历史 SQL 样例
│   └── *.md             # 数据库文档
└── requirements.txt     # 依赖清单
| 依赖 | 用途 |
|---|---|
vanna>=0.0.30 | Text-to-SQL RAG 核心引擎 |
streamlit | Web UI 界面 |
pandas | 数据结果展示 |
numpy | 数值计算 |
PyYAML | 数据库配置读取 |
main.py 的对话流程:
# 用户输入问题 → model.ask()
response = model.ask(question)       # 生成 SQL
st.code(response, language="sql")    # 高亮展示

# 用户点击解释按钮 → model.explain()
explanation = model.explain(sql)    # 生成解释
st.write(explanation)
train_model.py 的训练流程:
# 三类数据分别训练,构建 RAG 知识库
vn.train(ddl=utils.read_files(path="db/ddl", file_type="sql"))          # 表结构
vn.train(documentation=utils.read_files(path="db", file_type="md"))     # 文档说明
vn.train(sql=utils.read_files(path="db/queries", file_type="sql"))       # 历史查询
| 场景 | 难度 | 说明 |
|---|---|---|
| 业务分析师 | ⭐ | 有 SQL 基础但想提高效率,直接用 Streamlit 界面即可 |
| 数据工程师 | ⭐⭐ | 需要接入真实数据库,参考 Vanna 训练流程 |
| AI 开发者 | ⭐⭐⭐ | 想深入理解 RAG+LLM 在数据库场景的落地,需研究源码 |
pip install -r requirements.txtvanna.key 和 vanna.model_namestreamlit run src/main.py⚠️ 关键限制:当前版本依赖 vanna.ai 云端 API,不支持完全离线部署。若对数据隐私有要求,需自行部署 Vanna 开源版本 + 本地 LLM。
项目使用 vanna.ai 托管服务,API Key 外泄或服务不可用时应用直接中断。数据需经过第三方服务器,存在数据隐私风险(敏感业务数据不建议使用)。
在复杂多表 JOIN、嵌套子查询场景下,Vanna.AI 生成的 SQL 可能出现逻辑错误。生产环境使用必须对输出 SQL 进行人工复核,不能完全信任 AI。
RAG 系统的效果高度依赖 DDL 和 SQL 样例的质量。样例过少或覆盖面窄,复杂查询就会"瞎猜"。需要持续积累高质量 SQL 样例来提升准确率。
Text-to-SQL 是 NLP 与数据库领域交叉的重要方向,近两年随着 LLM 能力跃升突破明显。Vanna.AI 等开源方案让"人人都是 SQL 高手"成为可能。
从 GitHub 趋势看,Text-to-SQL 相关项目在 2024-2025 年增长显著,侧面反映了市场需求——数据分析需求爆发,而 SQL 人才供不应求,AI 辅助查询成为破局点。
RominaElenaMendezEscobar/text-to-sql 是一个清晰、实用的 Text-to-SQL 入门项目,以 Vanna.AI 为引擎、Streamlit 为界面,完整演示了从数据准备→模型训练→对话查询→SQL 解释的闭环。
对于想快速验证 Text-to-SQL 能力的团队,这个项目是很好的起点;但生产级应用还需解决离线部署、SQL 复核等工程问题。
