Qwen
QwenLM/Qwen加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2023年8月,阿里云一纸公告震动AI圈——Qwen-7B开源发布,成为国内首个突破性的百亿参数开源大语言模型。此后数月内,Qwen系列迅速扩展至18B、14B、72B全尺寸,并于2023年11月30日推出支持32K上下文的Qwen-72B,一举将国产开源大模型推至与LLaMA2-70B正面抗衡的高度。截至本文分析时,该仓库已累计斩获超过21000颗GitHub Stars,成为中文开源大模型领域最具影响力的标杆项目之一。
图1:Qwen 官方品牌标识
Qwen的意义远不止"又一款开源大模型"那么简单。它的出现填补了中文开源大模型生态的关键空白。在Qwen之前,中文开发者若想使用高性能大模型,选项极为有限:GPT-4/GPT-3.5依赖API调用,存在数据隐私顾虑和成本问题;LLaMA2虽开源但中文能力薄弱;国内其他开源模型则在效果和生态成熟度上存在明显短板。Qwen的出现改变了这一格局——它在中文理解、数学推理、代码生成等关键能力上大幅超越同规模竞品,同时依托阿里云生态提供了从模型权重、训练代码到部署工具的完整闭环。
从技术演进角度看,Qwen代表了一条"以规模换效果"的务实路线。项目文档显示,Qwen-72B在3万亿tokens上完成预训练,这一规模显著高于同期同类开源模型。反映在benchmark上,Qwen-72B在MMLU(77.4%)、C-Eval(83.3%)、GSM8K(78.9%)等权威评测集上全面超越LLaMA2-70B,在10项任务中有7项追平甚至超越GPT-3.5。这对于一款开源模型而言,是相当令人印象深刻的成绩。
Qwen并非单一模型,而是一个覆盖1.8B至72B参数规模的完整系列,并衍生出基础模型(Qwen)和对话模型(Qwen-Chat)两大分支。两者共享相同的预训练基座,对话模型在此基础上通过SFT(监督微调)和RLHF(人类反馈强化学习)实现了指令遵循能力的对齐。
| 规格 | Qwen-1.8B | Qwen-7B | Qwen-14B | Qwen-72B |
|---|---|---|---|---|
| 预训练Tokens | 2.2T | 2.4T | 3.0T | 3.0T |
| 最大上下文 | 32K | 32K | 8K | 32K |
| 最小QLoRA显存 | 5.8GB | 11.5GB | 18.7GB | 61.4GB |
| Int4推理显存 | 2.9GB | 8.2GB | 13.0GB | 48.9GB |
在功能层面,Qwen-Chat的能力边界远超传统对话模型。除了基础的聊天和文字创作,它还具备:摘要生成、多语言翻译(以中文和英文为主)、代码生成与调试、数学推理、以及至关重要的——**工具调用(Function Calling)**能力。此外,Qwen还支持Code Interpreter(代码解释器)能力,能够在沙箱环境中执行代码并根据执行结果调整输出。
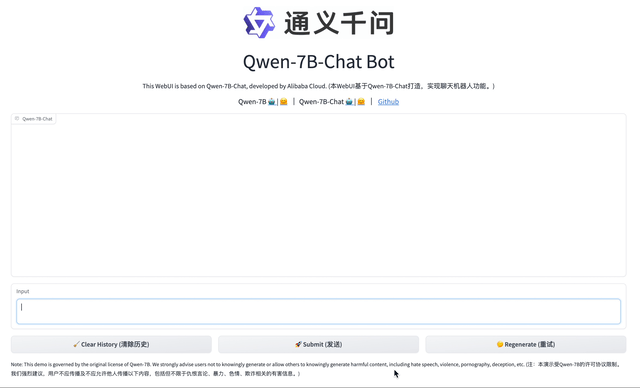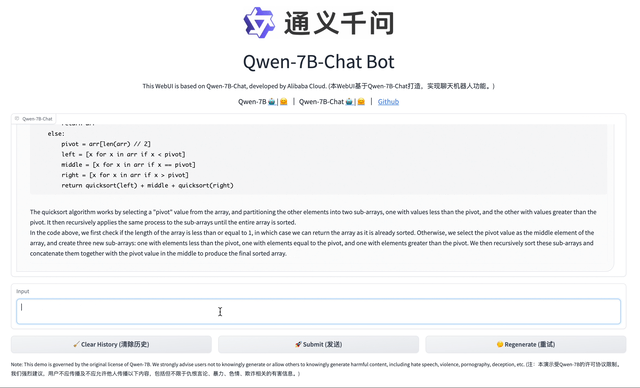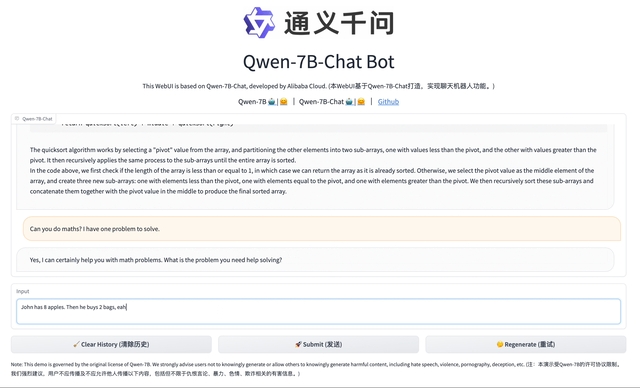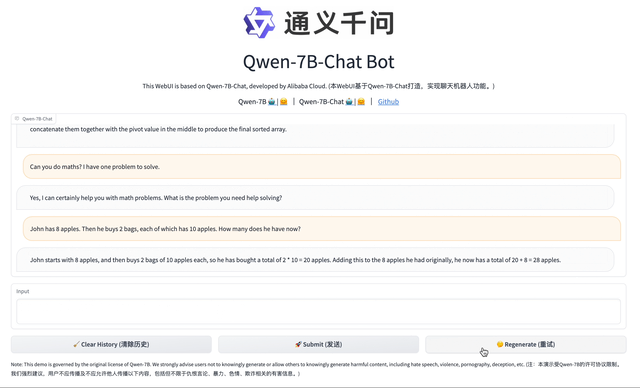
图2:Web Demo运行界面
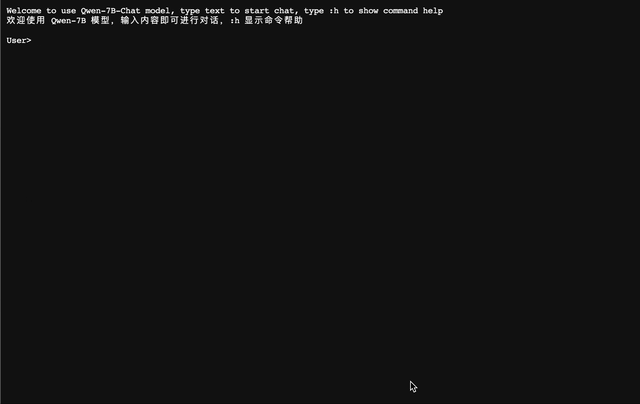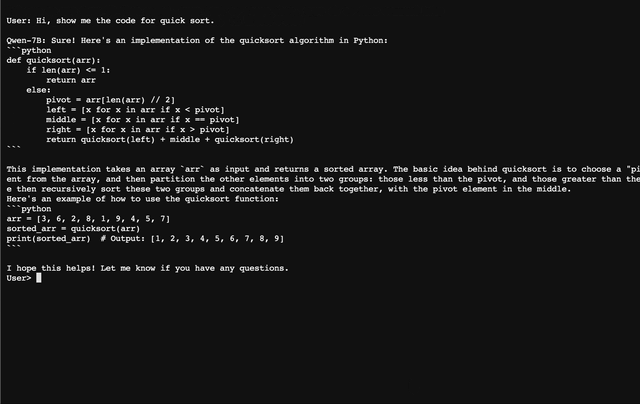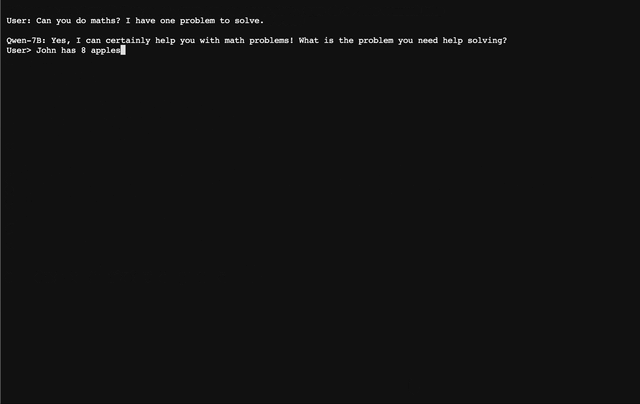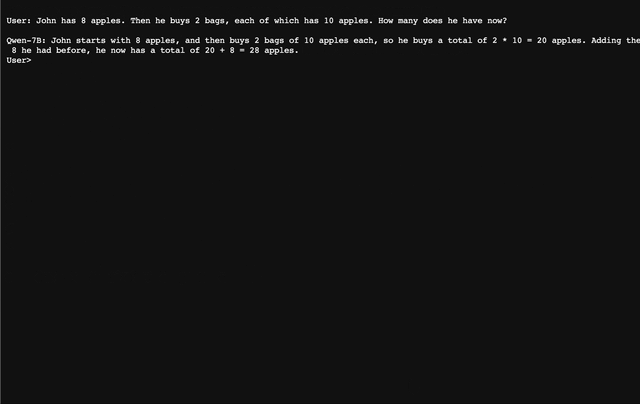
图3:CLI Demo运行界面
从代码组织来看,Qwen项目采用了典型的Python工程化结构,核心模块清晰分层:推理核心(openai_api.py提供FastAPI OpenAI兼容API)、微调引擎(finetune.py)、Web界面(web_demo.py)、命令行Demo(cli_demo.py)、容器化部署(docker/目录)等。
技术栈方面,项目以Python为核心生态,主要依赖:PyTorch作为深度学习框架,Transformers(Hugging Face)作为模型加载和推理库,以及FastAPI提供Web服务。openai_api.py是整个部署体系的核心,它基于FastAPI构建了一个与OpenAI API完全兼容的推理服务端点,支持流式输出(Server-Sent Events)、聊天补全和函数调用,这使得开发者可以零成本将现有OpenAI应用迁移至Qwen。
推理性能优化上,项目支持Flash Attention 2(可选安装),可显著降低长序列推理时的显存占用和延迟。此外,Qwen还支持GPTQ量化(INT8/INT4),以显存换速度,14B模型INT4量化后仅需13GB显存即可运行。
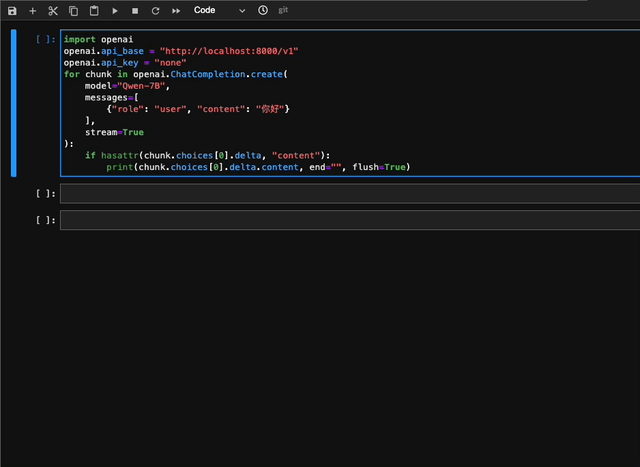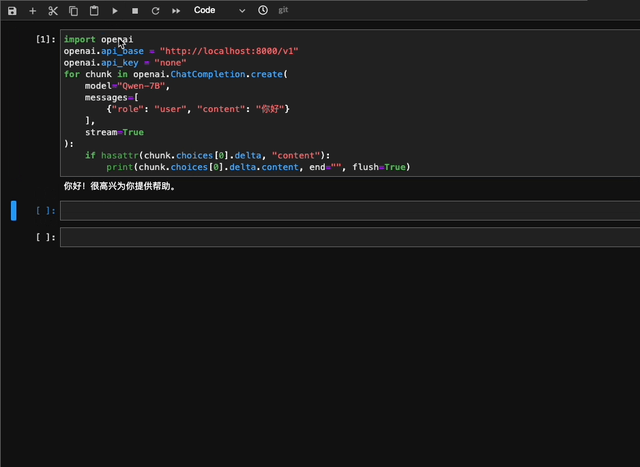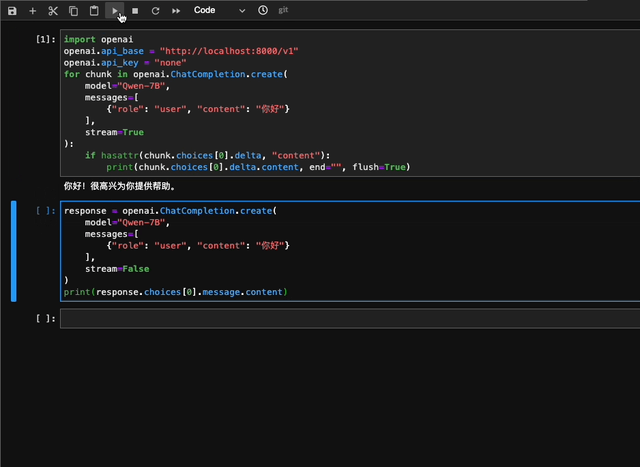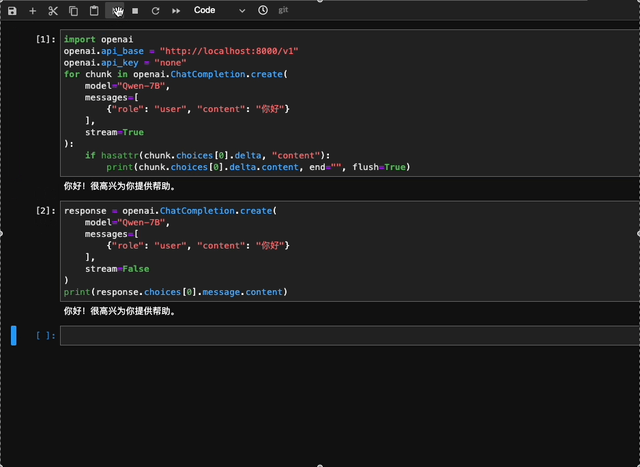
图4:OpenAI兼容API运行演示
Qwen提供了三种主要部署路径,适合不同场景:
路径一:Docker一键部署(最推荐)
项目在docker/目录下提供了完整的Dockerfile,覆盖CUDA 11.4和CUDA 12.1两个主流版本,并配有三种场景的启动脚本:docker_cli_demo.sh(命令行交互)、docker_openai_api.sh(OpenAI兼容API服务)和docker_web_demo.sh(Web界面)。对于希望快速验证的开发者,这是最省心的方式——一行命令即可拉起完整的推理服务。
路径二:OpenAI兼容API自托管
openai_api.py封装了完整的FastAPI服务,启动后默认监听localhost:8000,访问/docs即可查看自动生成的API文档。由于完全兼容OpenAI Chat Completions格式,现有的LangChain、LlamaIndex等应用只需修改API Base地址即可无缝切换到Qwen。
路径三:Web UI/CLI Demo本地体验
web_demo.py基于Gradio提供了轻量级的Web交互界面,适合非技术人员快速上手。cli_demo.py则是极简的命令行交互模式,直接pip install后运行脚本即可。
显存需求是部署的关键约束:Qwen-7B全精度推理至少需要16GB显存(fp16),INT4量化后可降至8GB;Qwen-72B全精度需要80GB+(A100/H100),INT4量化后约49GB。这一门槛决定了它不适合普通消费者的个人电脑,更适合有GPU集群或云计算资源的开发者和企业。
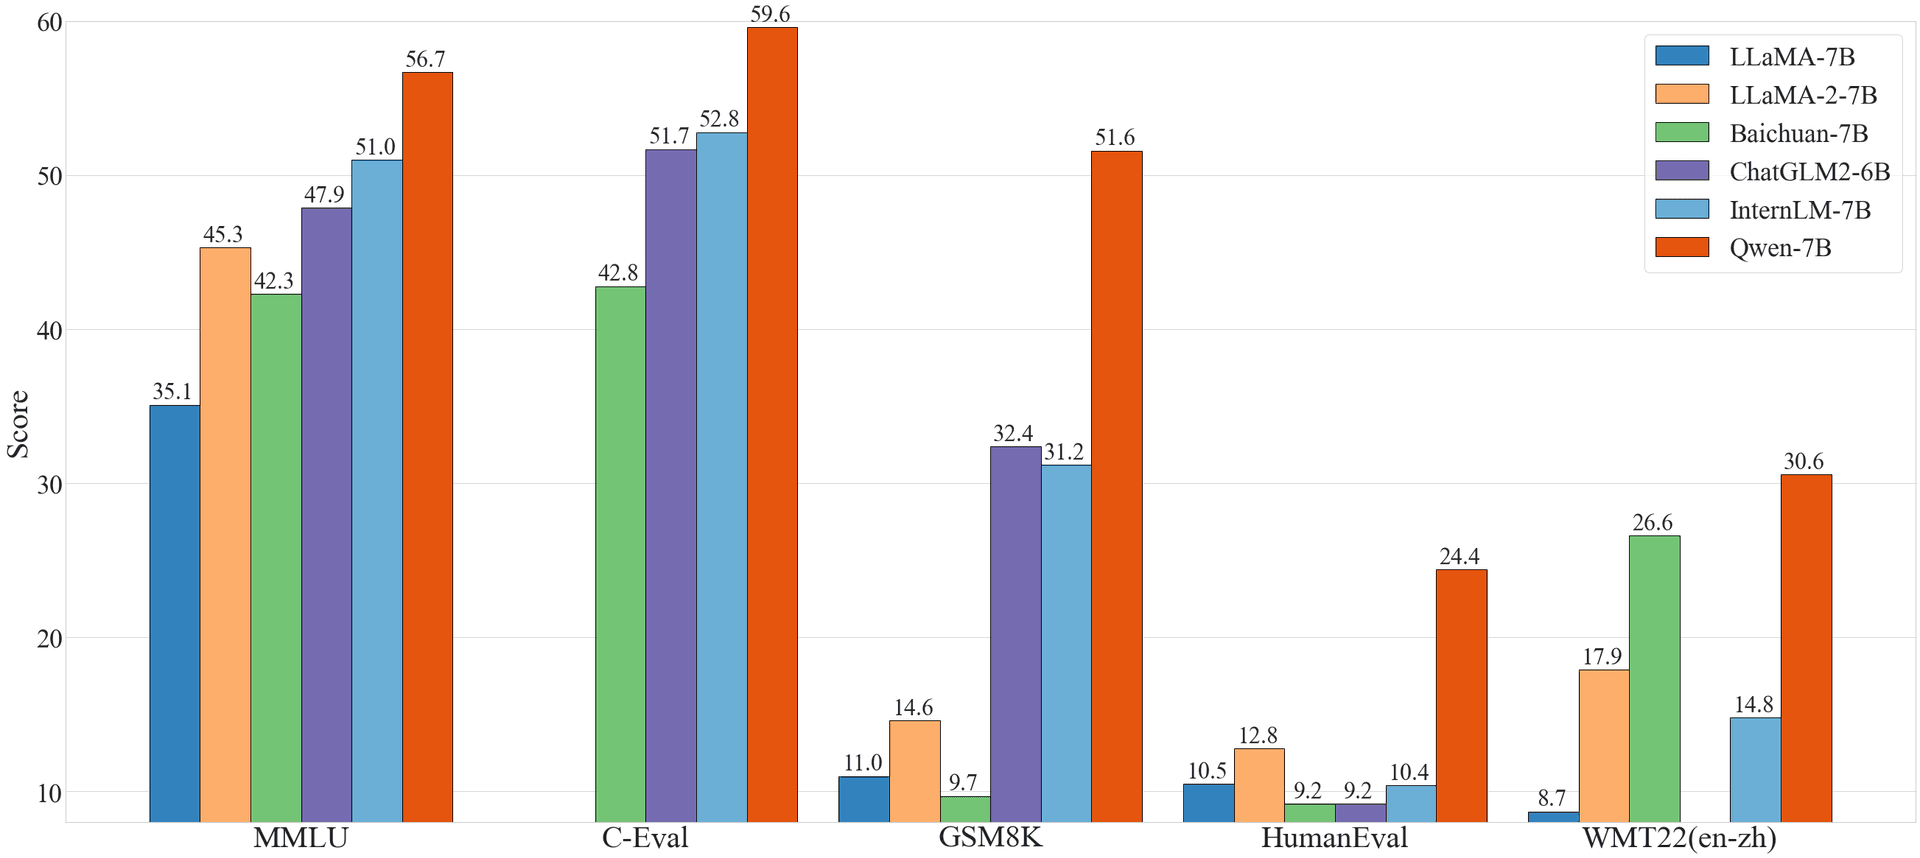
图5:性能评测数据
对于希望在特定领域定制Qwen的开发者,项目提供了完整的微调工具链。finetune.py是主程序,支持三种微调策略:全参数微调(需DeepSpeed ZeRO-3)、LoRA微调(仅训练低秩适配器)、Q-LoRA微调(在量化基座上做LoRA,显存需求最低)。项目还提供了配套的DeepSpeed配置文件,开箱即用。
客观地说,Qwen也存在一些局限。首先,这是一个已停止维护的仓库——README明确指出Qwen2已另开仓库维护,QwenLM/Qwen不再更新主要功能,这意味着使用旧版Qwen的开发者需要考虑迁移到Qwen2。其次,72B全精度模型对硬件要求极高,普通开发者难以本地部署,只能依赖量化版本或云端API。第三,上下文长度存在版本差异:14B版本最大仅支持8K上下文,而1.8B/7B/72B支持32K,这对需要处理长文档的场景构成限制。此外,Qwen采用了阿里云的"Tongyi Qianwen License",商业使用需遵守阿里云的相关条款。
尽管Qwen已演进至Qwen2/Qwen2.5,但QwenLM/Qwen这一仓库本身的意义不可忽视。它不仅是一款模型,更是中文大模型开源运动的重要推手。Qwen的成功证明了:其一,中文大模型完全可以在开源生态中与英文最强模型正面竞争;其二,开源模型不仅能用于研究,更能支撑企业级应用;其三,"预训练+对齐"的两阶段范式在开源社区已被验证为可行且高效的路线。
对于AI爱好者和开发者而言,Qwen是一个值得深入研究的标杆项目——它展示了如何将前沿大模型研究成果工程化落地,从模型设计、训练优化到部署服务的完整闭环,为后续开源大模型项目提供了极具价值的参考模板。
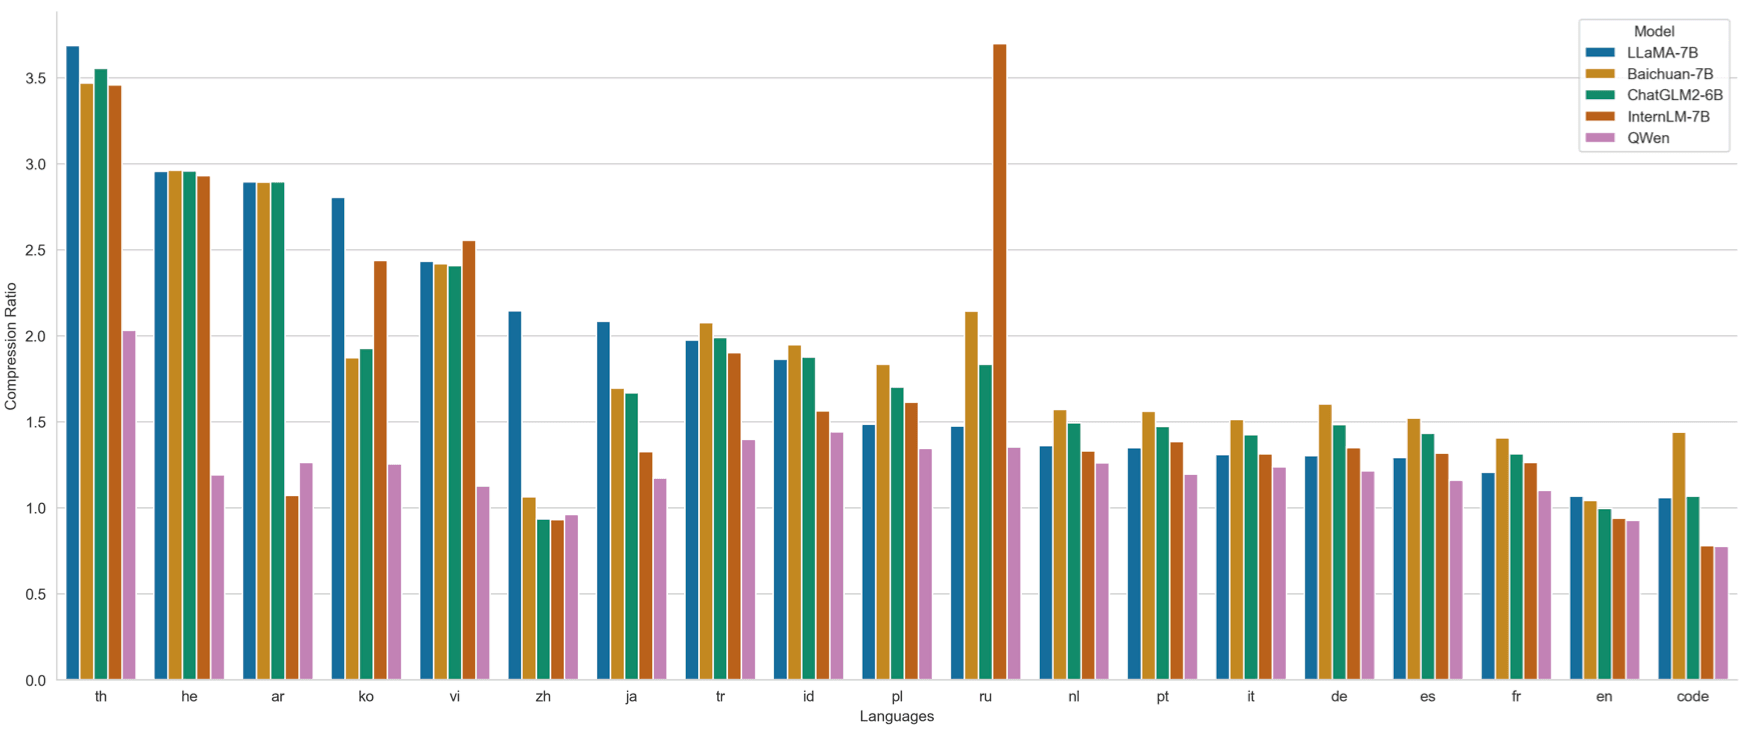
图6:Tokenizer可视化