
answer-me-with-html
QingYunA/answer-me-with-html加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
项目地址:https://github.com/QingYunA/answer-me-with-html Star:5085 | Fork:344 | License:MIT | 语言:JavaScript | 贡献者:20 人 | 提交:292 次 版本:v0.5.10(2026-10-26 发布) | 最新提交:2026-11-02
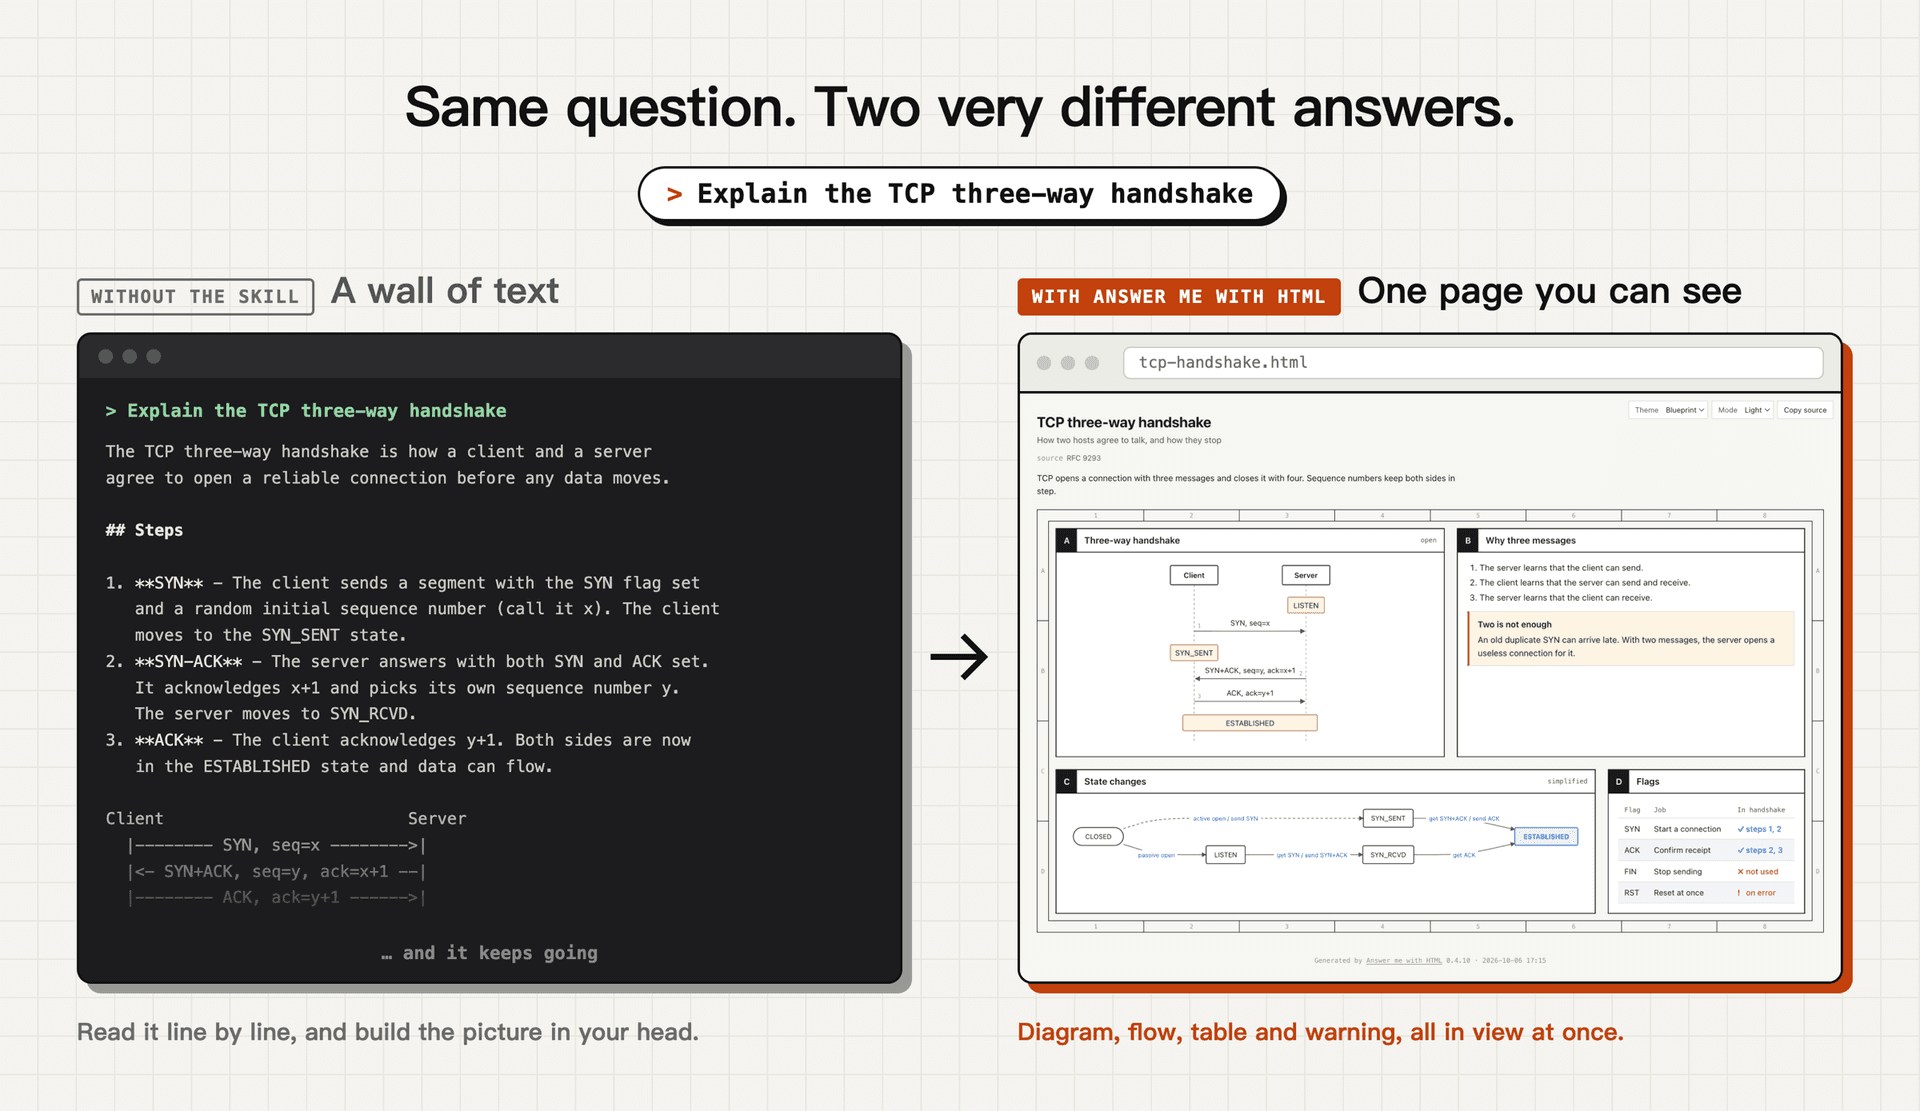
想象一个很具体的场景。你在终端里问 Claude Code 或者 Codex 一个问题:"讲讲 TCP 三次握手",或者"这个仓库的模块是怎么串起来的"。模型很尽职,输出了 200 行 Markdown 纯文本。你开始读,读到第三行发现自己在心里给角色编号,到第十行你已经忘了开头讲的是什么。你被迫在脑子里"渲染"——把 SYN、SYN-ACK、ACK 三条消息想象成两个端点之间来回飞的小箭头。
Andrej Karpathy 在 2026 年的一条推文里点出了这件事的核心:随着 LLM 承担越来越多工作,"跟上它的输出"变成了难的那一半。相较于大段文本,一张图或一个网页容易消化得多。
作者 QingYunA 试过直接让模型写 HTML。页面质量其实不差——但慢得离谱:一个像样的页面要花一两分钟,绝大部分时间耗在每次都要重写一遍的几百行雷同 CSS 上。图示更糟:模型必须手算 SVG 坐标,箭头经常指向空气。
于是有了 Answer me with HTML:模型只写内容,CLI 负责排版、配色和绘图。
这是理解整个项目的钥匙。作者把生成一页解释性页面这件事,拆成了两个角色:
am 命令负责选模板、排面板、套主题、用 dagre 布局流程图、按标签宽度给时序图留间距、生成 SVG 坐标、输出单一 HTML 文件。模型写的内容长这样:
---
title: TCP three-way handshake
---
## A Three-way handshake {span=2}
```sequence num
Client -> Server: SYN, seq=x
Server -> Client: SYN+ACK, seq=y, ack=x+1
Client -> Server: ACK, ack=y+1
note Client, Server: ESTABLISHED
这就是全部。CSS、配色、坐标、深色模式,全部不在模型的输出里。
### 省下来的究竟有多少
作者在 `bench/corpus/tokens.json` 里留了可复现的实测数据(`node bench/corpus.mjs` 可重跑)。他们统计了 9 个模型手写 HTML 的页面,平均 4893 token,其中 **SVG 坐标与路径占 47%,CSS 占 15%,HTML 标签占 17%,真正的文字只占 21%**。也就是说,近八成的 token 花在了"呈现"而非"内容"上。
用上这个技能后,同类问题模型只需写 612 token——**约为手写 HTML 的八分之一**。时间从 31 秒降到 12 秒(3 个主题 × 3 轮取中位数,Claude Sonnet 5.5,纯净 Claude Code 环境)。

这里有个容易被误读的点:账单只降了约 15%,而不是 87%。因为每一轮对话都要读系统提示词、用户问题和上下文历史,这部分开销与是否使用技能无关。作者在 `bench/README.md#where-the-cost-goes` 里专门解释了成本去向,这种坦诚在开源项目里不多见。
### 生活化类比
把模型想象成一个只会写内容、不懂排版的编辑。而 `am` 是一套专业排版系统:你交上去的是结构化的稿子("这里放时序图,这里放对比表"),系统负责选字号、配配色、算坐标。你不需要每次都重新手写一份 CSS 模板,也不需要自己算箭头终点。
## 三、核心功能盘点
### 1. 组件体系:按信息形状选工具
项目提供 14 类可视化组件,每类对应一种信息形态:
| 组件 | 适用场景 |
| :--- | :--- |
| `flow` | 架构、调用链、决策分支,含分组/决策/数据库节点 |
| `er` | 数据模型:带 PK / FK / UK 标注的实体与乌鸦脚关系 |
| `sequence` | 多方之间随时间来回传递的消息 |
| `tree` | 目录、模块、分类体系 |
| `timeline` | 历史、版本、阶段演进 |
| `limits` | 一个数值对照它的上限 |
| `chart` | 条形/折线/饼图,支持多序列、负值、高亮行 |
| `annot` | 逐句批注,指出问题词并给修改建议 |
| `kv` | 元数据、图标题栏 |
| `callout` | 结论、提示、警告 |
| `ask` | 页面上让用户做决策,默认不预选任何项 |
| 代码块 | 从真实文件引用代码(`src=` `lines=`),不是重打一遍 |
| 表格 | 多维对比,单元格写 `ok`/`no`/`warn` 自动渲染 ✓ ✗ ! |
### 2. "自己修正自己的错误"
这是我认为设计上最见功力的一点。草稿写错了,CLI 会返回**行号、组件名和一个正确的示例**——不是一堆模糊的报错。因为报错带定位、带示范,模型基本一次就能改对。这个"可自我修复的编译错误"设计,比单纯抛异常要有用得多。
### 3. 真实代码引用与安全边界
代码块可以写 `src=` `lines=` 直接引用本地文件里的行。但有明确红线:**文件夹外的文件会被拒绝,含密钥的文件也会被拒绝**。这在"让模型读本地文件"这类功能里是必要的克制。
### 4. 三套主题 + 亮暗双模式
`blueprint`(工程制图风格)、`shadcn`(干净卡片)、`paper`(长文阅读)。默认逻辑是长文本选 paper、图示选 blueprint。支持用户自定义主题,也有主题市场(`marketplace/themes/` 下已内置 anthropic-clay、comic、cyberpunk-cool、manga、mint-signal、pop 等),主题编辑器在 `site/src/theme-editor.js`。

### 5. 单文件离线产物
每个页面是一个自包含的 `.html`,**没有任何 CDN 链接、没有网络字体**。可以离线打开,可以直接发给别人。这在企业内部文档流转里是个实打实的优势——不依赖公司的网络代理和白名单。
### 6. 讲解视频
作者在 README 里提到 Karpathy 有一条"理解阶梯"(the ladder of understanding),最后一级是讲解视频。请求方式是"做个 3b1b 风格的 TCP 握手视频"。
模型写和页面一样的草稿,再加每段一句旁白。`am video` 生成播放器页面:图示随旁白逐步构建,摄像机跟随方括号中命名的节点。**语音内嵌在页面里,离线可播。**播放器有章节条、变速按钮,以及浏览器内编码导出(本地文件或 localhost,不需要 ffmpeg);加 `--mp4` 才需要 ffmpeg。

作者实测:视频比页面省得更多,约 18 倍输出 token、12 倍速度。
### 7. 在页面上回答
任意面板可加评论,Agent 提出的决策(`ask` 组件)可以在页面上选。"Reply" 按钮把你的选项和评论汇总成一条消息贴回给 Agent。这是把"单向输出"变成"闭环交互"的关键设计。
### 8. ASD-STE100 写作检查
ASD-STE100 是航空维修手册用的受控英文体例:句子要短、一个词一个意思、步骤写成命令。Karpathy 提过,让 LLM 遵守这些规则会让它的写作明显更好读。
每次渲染都会检查机器能查的部分:句长、冗词、被动语态,以及常见的中文错别字和含糊词。**默认只警告不拦截**,可通过 `style strict` 改成严格模式直接拒收不合格草稿。
### 9. 多语言
简体中文、繁体中文、英语、日语各有独立按钮和字体。其他语言可用英语按钮。文档本身有中英双版本(README.md / README.zh-CN.md),官网也有 i18n。
## 四、它和同类项目的区别
作者主动在 README 里做了对比,态度比较坦率:
- **Archify**(tt-a1i/archify):从 JSON spec 生成**一张**交互式图示。本项目是用一份 Markdown 草稿生成**整页**答案——文字、表格、代码、图示都有。
- **GenUI 类插件**(如 omdsh-dev/dsh-genui):在一个聊天应用里渲染组件。本项目把整个问题回答成一页,且**任何能执行 shell 命令的 Agent 都能用**,不绑定特定宿主。
## 五、部署与上手门槛
### 安装路径
作者写了一篇**给 Agent 看的** INSTALL.md,让 Agent 自己读并照做。四条路径:
1. **让 Agent 自己装(推荐)**:粘贴一句"读 https://raw.githubusercontent.com/QingYunA/answer-me-with-html/main/INSTALL.md 并照做"。安装脚本只会在 Node.js 缺失或低于 v20 时问一次,其余全自动,结束前用 TCP 握手页面自检。
2. **Claude Code 插件**:`/plugin marketplace add` + `/plugin install`。
3. **DeepSeek Harness 插件**:`dsh plugin --pr...`
4. **一条命令**:`npx -y skills add QingYunA/answer-me-with-html -g -y -a <agent>`
INSTALL.md 里有几条值得学习的自律约束:**每种 Agent 只装一种方式**(技能和插件同名会冲突加载、指令打架);**绝不覆盖已有安装**;**不要自作主张把 always-on 规则写进规则文件**,只能在最终报告里建议、问过用户才做。
### 硬性前置
Node.js v20+(ESM,`engines: node >=20`)。没有 `npm install` 步骤——CLI 已打包在技能里。装完之后:
- `am render <file>` — 生成页面
- `am video <file>` — 生成视频
- `am serve` — 本地 HTTP 服务(默认 127.0.0.1:8765)
- `am config` / `am config set <k> <v>` / `am config reset` — 配置
- `am clean` — 清理堆积的页面
- `am theme` / `am list` / `am export` / `am lint`
### 关于 `am serve` 的安全性
代码里看得出作者在网络暴露上做了不少防护:每次启动生成新密钥写入 `serve.json`(权限 0600,退出时删除);链接形如 `/p/<token>/<file>`,token = HMAC-SHA256(secret, "<目录>/<文件>");服务端不维护链接列表,**一个链接不泄露其他任何页面的存在**;重启即换密钥,旧链接全部失效;只服务 pages/ 和 videos/ 目录**直接子级**的 .html;Host 头只接受回环地址(LOOPBACK_HOST 正则),防 DNS rebinding;支持 LAN/Tailscale 绑定并对私有网段做优先级排序(Docker bridge 172.17.0.1 排在 192.168/16 之后)。
这部分工程质量明显高于同类小工具的普遍水平。
### 容器化
仓库**没有** Dockerfile / docker-compose / k8s manifest。这符合它的定位——它不是一个需要跑起来的服务,而是一个 CLI 工具。但如果你要在 CI 里批量生成页面,就得自己包一层容器。
## 六、工程实现剖析
### 技术栈
极简,纯 JavaScript ESM,无 TypeScript。运行时依赖只有 4 个:
- `marked` — Markdown 解析
- `@dagrejs/dagre` — 流程图自动布局
- `temml` — TeX 数学公式渲染
- `@fontsource/bangers` — 字体
开发依赖是 `esbuild`(打包单文件 bundle)和 `yaml`。打包产物 `skills/answer-me-with-html/scripts/am.mjs` 是把所有依赖内联进去的单文件 CLI——这就是"没有 npm install 步骤"的技术实现。
### 代码结构
`src/` 下 70+ 个模块,按关注点切得很细:`components/`(14 类组件各自一个文件)、`runtime/`(渲染运行时,含 remark 解析、DOM 布局、视频导出)、`themes/`(主题系统与 CSS)、`svg/`(SVG 文本与图形渲染)、`lint/`(STE 检查器 + 中英文词表)、`languages/`(多语言注册表)。`src/serve.js`、`src/cli.js`、`src/export.js`、`src/csp.js`(CSP 策略)各自独立。
`src/lint/wordlist.zh.js` 和 `wordlist.en.js` 是专门维护的中英文模糊词/错别字词表——这不是随便能写出来的,需要真实的中文技术写作审校经验。
### 测试与 CI
测试规模相当可观:`test/` 下 **90 个测试文件**,用 Node 内置 `node --test`,覆盖度目标写死在 `package.json` 里:行覆盖 85%、函数覆盖 85%、分支覆盖 80%。包含大量 `-browser.test.js` 命名的浏览器侧测试。
CI 矩阵:Linux 上跑 Node 20/22/24 三个版本,macOS 和 Windows 各一个。完整检查(bundle、coverage、examples、website、HTML snapshot、真实安装)只在 ubuntu + Node 22 上跑一遍。还配了每周一 3:17 的定时任务,专门盯上游 skills CLI / Claude Code 变化导致的安装失败。
`npm run snapshot` 会把渲染出的 HTML 与 `origin/main` 比对——**重构不允许改变输出**,这是个很硬的质量约束。
### 项目治理的成熟度
有 CONTRIBUTING.md(14.6 KB,详述生成 bundle、页面格式、快照检查、评审 PR、发版流程)、changelog/ 目录下 20 个版本记录、多个 GitHub workflow(ci / pages / release / theme-submission / triage)、issue 模板、PR 模板、CodeRabbit 配置、FUNDING.yml,还有 Ko-fi 和爱发电两个赞助渠道。
20 位贡献者、292 次提交、2026-10-02 创建、到 2026-11-02 仍在推送——**一个月内从 0 冲到 5085 Star**,在 Agent Skill 这个赛道上是相当快的起量。
## 七、争议与局限
不回避问题地说几点:
1. **前提是 Agent 会主动调用技能。** 项目本质是"提示词工程 + CLI",模型必须被正确触发。如果宿主 Agent 不遵守 SKILL.md 的描述逻辑,效果大打折扣。作者通过"always-on 模式"(往 Agent 规则文件里加一条全局规则)来缓解,但这需要用户主动配置。
2. **内容质量仍取决于模型。** CLI 负责呈现,不负责事实。图表坐标再精确,画错了的逻辑还是错的。STE100 检查也只查机器能查的部分。
3. **单文件 HTML 的取舍。** 无 CDN、无网络字体,换来离线可读,代价是字体和交互能力受限。
4. **视频导出的依赖分叉。** WebM 走浏览器内编码(无需 ffmpeg),MP4 需要 ffmpeg。跨环境复现会有摩擦。
5. **生态仍年轻。** 一个多月的项目,版本号还在 0.5.x,changelog 粒度很细但也可能意味着接口仍在变动。
6. **中文写作检查的覆盖度存疑。** 词表能查的错别字和含糊词有限,中文技术写作的语义问题不是正则能解决的。
## 八、行业意义
2026 年 Agent 生态的一个真实趋势是:**输出形式正在从"文本"迁移到"结构化产物"**。Answer me with HTML 代表的思路是——不要试图让模型做得更多,而是**把模型从它不擅长的事情上解放出来**。模型擅长写内容、梳理逻辑,不擅长手算坐标、重复劳动 CSS;那就让它只做前者。
它的可复用思路不止于这个项目本身:
- **"模型写内容、工具做呈现"**是所有 Agent 工具链的通用范式(MCP 工具、报告生成器、可视化管线同理)。
- **带定位和示范的错误返回**,比抛异常更适合 LLM 自修复循环,这个模式值得在自研工具里复制。
- **单文件、离线、无 CDN** 的产物形态,对企业内部传播和安全合规有直接价值。
- **可复现的 benchmark 公开在仓库里**(`bench/corpus.mjs` 可重跑),并主动解释"为什么账单只降 15% 而不是 87%",是少见的工程诚实度。
从 Karpathy 的"理解阶梯"出发,Answer me with HTML 把阶梯的两级——图示和讲解视频——都做成了产品化的能力。5 千 Star 说明这个需求被真实用户确认过:**跟上 LLM 的输出,确实已经成为瓶颈。**
## 九、上手建议
如果你想试:
1. 确认 Node.js v20+。
2. 让你的 Agent 读 INSTALL.md 自装(最省事),或者 `npx -y skills add QingYunA/answer-me-with-html -g -y -a <agent>`。
3. 先手动跑一次 `am render examples/tcp.en.md --no-open` 看效果——仓库里有现成例子:`examples/tcp.en.md`、`examples/ste100.md`、`examples/architecture.md`、`examples/video-tcp.md`。
4. 觉得好用再开 always-on 模式(记得这一步要你自己确认后写进规则文件)。
5. `am clean` 定期清理 `~/.answer-me-with-html/pages/`。
本地开发:`npm install && npm test`,`npm run build` 后重新打包 `am.mjs`,`npm run snapshot` 验证输出未变。
## 十、总结
Answer me with HTML 是一个思路清晰、完成度很高的 Agent Skill 项目。它没有试图做一个通用可视化引擎,而是精准切中一个具体痛点:**复杂解释的呈现成本**。用 CLI 把 80% 的非内容 token 消掉,同时把"图表坐标算错"这个 LLM 的老毛病彻底解决——这是典型的"用工程手段解决模型短板"。
项目成熟度也超出同期同类作品:90 个测试文件、三版本 Node CI 矩阵、HTML 快照回归、单文件 bundle、HMAC 能力链接、防 DNS rebinding、每周定时巡检上游安装。一句话概括它的设计哲学:**模型只管写,剩下的交给确定性代码。**
