
pythainlp
PyThaiNLP/pythainlp加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你拿到一段泰国文字,想要让它「可计算」——分词、翻译、拼写纠错、分析情感……没有专门工具的情况下,这几乎无从下手。泰语是一种没有显式词边界的语言(类似中文),词与词之间没有空格隔开,这使得基本的分词就成为所有 NLP 任务的第一道门槛。PyThaiNLP 就是来解决这个问题的。
PyThaiNLP(发音「派泰 NLP」)是一个专注于泰国语自然语言处理的 Python 开源库,2016 年由泰国开发者 Wannaphong Phatthiyaphaibun 发起,定位为「Python 生态中的泰国语 NLTK」。它将散落在各处的泰国语处理工具统一封装,提供分词、词性标注、机器翻译、拼写纠错、音译、文本摘要、指代消解等全栈 NLP 能力,背后还有预训练语言模型支撑。截至 2026 年 7 月,该项目在 GitHub 拥有 1144 Stars,299 次 Fork,在 NLP-OSS 2023 学术会议上发表论文,被引用 167 次,是泰国语 NLP 领域最具影响力的开源项目之一。
泰国语属于壮侗语系,是泰国约 7000 万人口的母语。与英语不同,泰语没有空格分词,词与词之间紧密相连,同一句话可以有完全不同的切分方式,带来天然的语言处理挑战。
在 PyThaiNLP 诞生之前,泰国语 NLP 工具分散在各个小项目、论文代码甚至个人博客里,没有一个统一的标准库。研究者想用泰语分词,需要找到专门的算法实现;想做情感分析,又得去另一个地方找模型。Python 生态里 NLTK 是处理英语 NLP 的标杆,但泰国语几乎是一片空白。PyThaiNLP 的出现,正是要填补这个生态位——做一个泰国语版的「NLTK」,让泰国语 NLP 研究者和开发者有一个统一的起点。
PyThaiNLP 的功能覆盖了泰国语 NLP 的几乎所有核心任务,可以分为以下几个大类:
语言学单元切分(分词)是 PyThaiNLP 最基础也是最重要的功能。泰国语没有空格隔词,分词直接决定了后续所有任务的质量。PyThaiNLP 支持多种分词策略:sent_tokenize 分句、word_tokenize 分词、subword_tokenize 子词切分。底层支持 attacut 等多种分词算法,用户可以根据精度和速度需求自由选择。
词性标注与实体识别(pos_tag)能够对切分后的词语标注词性和命名实体。这是情感分析、主题分类、信息抽取等下游任务的基础。PyThaiNLP 提供了泰国语专用的标注模型,在泰国本土数据集上训练,效果优于通用标注器。
音译与罗马化(transliterate)可以将泰文转换为罗马字母(拉丁字母),方便不懂泰语的开发者处理。例如把「สวัสดี」转成「sawatdi」。支持 IPA(国际音标)转换,适用于语言学研究场景。
拼写纠错(spell、correct)能检测并修正泰国语拼写错误。泰语键盘布局特殊,容易输入错误的辅音或元音字母,拼写纠错功能对搜索纠错、OCR 后处理等场景很有价值。
文本生成与摘要(summarize、generate)支持泰国语文本摘要和生成任务,结合预训练语言模型,可以完成新闻摘要、文本生成等应用。
翻译与语种转换(translate、transliterate)支持泰语与其他语言之间的翻译,extra 包 translate 提供了机器翻译支持。
此外还有泰语数字转文字(bahttext,比如「1,234.56」转成「一千二百三十四点五六」)、日期格式化(thai_strftime)、Soundex 语音编码、键盘布局纠错(用户打错键盘时自动纠正)等实用工具,覆盖了泰国语 NLP 研究和工程中的高频场景。
 图 1:PyThaiNLP 项目 Logo
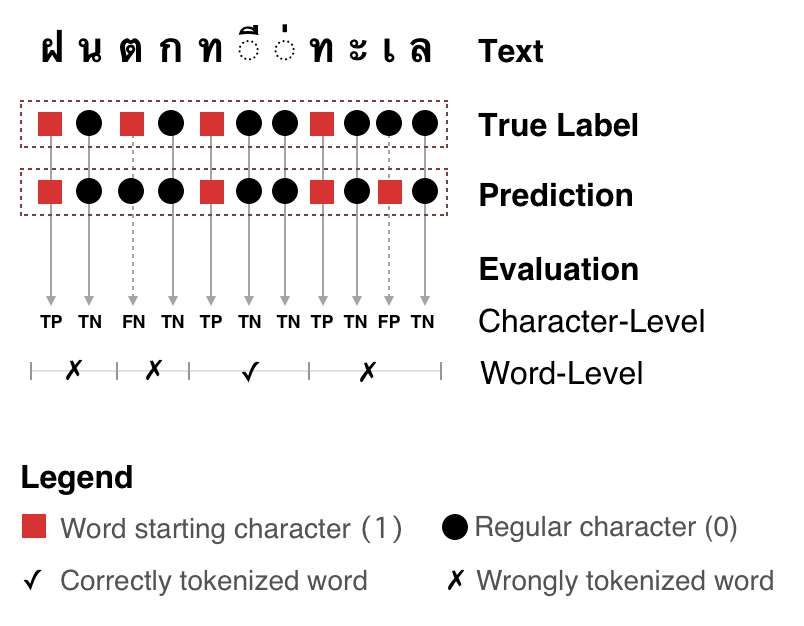 图 2:PyThaiNLP 在多个任务上的评测结果对比
PyThaiNLP 不仅仅是一个传统 NLP 工具库,它还集成了现代 Transformer 预训练语言模型,让泰国语 NLP 赶上了深度学习时代。
WangchanBERTa 是 PyThaiNLP 内置的最重要预训练模型之一,由 VISTEC(泰国科学技术研究院)开发,是首个基于 Transformer 架构的泰国语预训练语言模型,参数量级与英语 BERT-base 相当。在泰国语理解任务(如情感分析、命名实体识别)上,WangchanBERTa 显著优于传统方法。PyThaiNLP 直接封装了 pythainlp.wangchanberta 模块,几行代码即可加载模型做推理:
from pythainlp.wangchanberta import NamedEntityRecognition
ner = NamedEntityRecognition()
result = ner.tag("วันที่ 1 มกราคม 2566 นายสมชาย พบนายสมหญิง ที่กรุงเทพฯ")
Phayathaibert 是另一个内置的泰国语预训练模型,同样基于 BERT 架构,提供类似的能力。PyThaiNLP 通过 pythainlp.phayathaibert 模块提供便捷调用。
词向量(pythainlp.word_vector)支持加载预训练词向量(Word2Vec/FastText 格式),做词语相似度计算、类比推理等任务。
指代消解(Coreference Resolution)是一个相对前沿的 NLP 任务,解决「他」「她」「它」等代词指向哪个实体的问题。PyThaiNLP 支持两种实现:基于 fastcoref 的轻量版(pythainlp.coref.fastcoref)和基于 Han Coref 的完整版(pythainlp.coref.han_coref)。这是很多通用 NLP 库尚未充分覆盖的领域。
PyThaiNLP 的安装极为简单——一行 pip 命令即可:
pip install pythainlp
这个基础安装包含了核心分词、标注等基础功能。如果需要更多能力,可以通过 extra 包扩展:
pip install "pythainlp[translate]"     # 机器翻译
pip install "pythainlp[wordnet]"       # WordNet 词网
pip install "pythainlp[full]"          # 全部可选依赖
pythainlp[compact] 是一个推荐的基础配置,提供稳定且体积较小的依赖集,适合生产环境。
PyThaiNLP 还提供了命令行工具 thainlp,无需写 Python 代码即可操作:
thainlp data catalog   # 查看可用的语料库/模型列表
thainlp help           # 显示帮助
thainlp misspell --output result.txt  # 批量拼写检查
Google Colab 集成也是一个亮点。项目在 GitHub README 中提供了 Colab 链接,点击即可在浏览器里运行 Jupyter Notebook,无需本地配置环境。开发者 Lalita Lowphansirikul 维护了一套 PyThaiNLP 教程 Notebook,覆盖从入门到进阶的各种场景。
有一点需要特别注意:PyThaiNLP 首次运行时会自动下载语言数据和模型到 ~/pythainlp-data 目录。如果在 Docker 或分布式环境中使用,建议通过 PYTHAINLP_DATA 环境变量指定数据目录位置,并通过 PYTHAINLP_OFFLINE=1 或 PYTHAINLP_READ_ONLY=1 控制数据下载行为,避免在只读文件系统中写入失败。
PyThaiNLP 的源码结构高度模块化,所有功能都组织在 pythainlp/ 主包下:
| 模块目录 | 核心能力 |
|---|---|
tokenize/ | 分词算法(词/句/子词) |
tag/ | 词性标注、命名实体识别 |
spell/ | 拼写检查与纠错 |
transliterate/ | 音译(罗马化/IPA) |
translate/ | 机器翻译 |
summarize/ | 文本摘要 |
generate/ | 文本生成 |
coref/ | 指代消解(fastcoref + Han Coref) |
classify/ | 文本分类 |
lm/ | 语言模型 |
parse/ | 句法分析 |
ulmfit/ | ULMFiT 迁移学习方法 |
wangchanberta/ | WangchanBERTa 模型封装 |
phayathaibert/ | Phayathaibert 模型封装 |
word_vector/ | 词向量加载与推理 |
wsd/ | 词义消歧 |
ancient/ | 古典泰语处理 |
khavee/ | 泰语诗歌韵律分析(Khavee 是泰国古典诗体) |
braille/ | 布莱叶盲文转换 |
chat/ | 聊天机器人 |
augment/ | 数据增强 |
corpus/ | 语料库管理 |
整体架构遵循「核心库 + 领域扩展 + 预训练模型」三层结构:基础层(分词/标注/纠错等)不依赖重型模型,可独立使用;扩展层(摘要/翻译/指代消解)依赖深度学习模型;预训练模型层(WangchanBERTa、Phayathaibert)提供开箱即用的高质量推理接口。
项目使用 hatchling 作为构建系统,pyproject.toml 管理所有依赖,支持 Python 3.9 到 3.14。当前稳定版本 5.3.4,维护状态非常活跃——项目在 2024 年 2 月发布了 v5.0 大版本,2025 年 2 月发布 v5.1.0,持续迭代。
作为纯 Python 库,PyThaiNLP 本身没有 Web 服务接口,不提供 HTTP API,属于「工具包」而非「Web 应用」。但它在工程化方面做了充分准备:
Docker 支持:项目提供了 Dockerfile(基于 python:3.12 + venv 隔离)和 docker-compose.yml,可以一键构建容器镜像。docker-compose 配置了数据卷挂载和工作目录,适合在容器内进行开发或批量处理任务。
环境变量控制:PyThaiNLP 提供了细粒度的数据管理环境变量:
PYTHAINLP_DATA:指定数据目录(默认 ~/pythainlp-data)PYTHAINLP_OFFLINE=1:禁止自动下载语料(离线环境)PYTHAINLP_READ_ONLY=1:只读模式(适合 Docker 只读卷或共享集群挂载)这些控制能力对于企业级部署非常重要——在 Kubernetes 集群、HPC 环境和无外网访问的服务器上,都能正常工作。
分布式计算兼容:文档中专门提到了 Apache Spark 分布式环境下的使用方式,通过在映射到 worker 节点的函数内部设置 PYTHAINLP_DATA 环境变量来确保数据一致访问。
无 GPU 需求:PyThaiNLP 的基础功能(分词、标注、纠错)完全在 CPU 上运行,不需要 GPU。只有加载和使用大型预训练语言模型(WangchanBERTa、Phayathaibert)时才需要额外内存。整体硬件门槛不高,普通开发机即可。
尽管 PyThaiNLP 功能全面,但它也有一些明显的局限需要正视:
模型更新滞后:预训练语言模型(WangchanBERTa 等)发布于 2020-2021 年,彼时是大模型浪潮的初期。与 GPT-4、Claude、LLaMA 等当代大模型相比,这些模型的规模和能力存在代差。对于需要生成式 AI 或复杂推理的任务,当前版本的 PyThaiNLP 内置模型力有不逮。
文档语言门槛:虽然项目有英文 README 和泰文 README(README_TH.md),但大量教程、API 文档以英文为主,对中文用户存在一定门槛。pythainlp.org 网站有英文文档,但详细教程集中在英文博客和 Colab Notebook 中。
离线使用门槛:首次使用需要下载数百 MB 到数 GB 的语言模型数据。如果在网络受限的环境中使用,需要提前通过 thainlp data catalog 查看需要哪些数据,手动下载到本地。
生产环境监控缺失:PyThaiNLP 是一个离线工具库,没有内置的请求监控、性能指标或日志追踪机制。在生产环境中作为批处理任务使用没有问题,但如果要包装成 API 服务,需要开发者自行实现监控和限流。
维护可持续性:项目高度依赖核心维护者的个人投入(尤其是创始人 Wannaphong Phatthiyaphaibun)。虽然有机构资助,但相比商业 NLP 服务,项目的长期维护存在不确定性。
PyThaiNLP 的意义远不止于一个工具库——它是泰国语 NLP 领域的基础设施。
从学术角度看,PyThaiNLP 大幅降低了泰国语 NLP 研究门槛。在它出现之前,研究者需要花大量时间复现和整合各种零散工具,现在可以直接基于 PyThaiNLP 快速构建实验pipeline。论文引用量 167 次就是最好的证明。
从产业角度看,泰国多家企业和政府机构已经在使用 PyThaiNLP 处理泰国语文档——INTHEWILD.md 文件列出了采用者名单,包括泰国金融机构、媒体公司、政府研究部门等。
从技术生态角度看,PyThaiNLP 填补了 Python NLP 生态中「非英语语言处理」的空白,与 NLTK、SpaCy 等主流工具形成互补。它证明了小语种 NLP 社区有能力建立和维护自己的开源基础设施。
从开源协作角度看,PyThaiNLP 的贡献者背景多元——有 VISTEC 的博士生、有 Research Ireland 资助的研究员、有 Chulalongkorn 大学的实习生,体现了真正的国际化协作。MacStadium 捐赠的 M1 Mac Mini 解决了 Apple Silicon 测试难题的插曲,也展示了开源社区互助的温情一面。
