
browsegenie
PushpenderIndia/browsegenie加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你在某电商平台看上了一款降噪耳机,想把全网 50 家店铺的价格和评价扒下来做横向对比。你会怎么做?手动一家家复制粘贴?那得花上大半天。写爬虫?BeautifulSoup 的选择器语法足够把人绕晕,更别说还要处理反爬、动态加载、验证码这些拦路虎。
BrowseGenie 解决的就是这个问题——你只需要说一句"帮我提取所有商品名称、价格和评分",剩下的交给 AI。
BrowseGenie 诞生于 2024 年,由独立开发者 Witeso 创建,目前在 GitHub 拥有 42 颗星、7 个 Fork,遵循 GPL-3.0 开源协议。项目已发布至 PyPI,累计下载量持续增长,是当前 AI 辅助网页抓取领域的活跃开源项目之一。
它的核心思路非常清晰:不让用户写选择器,而是让 AI 学会看网页。整个流程从输入 URL 到输出结构化 JSON,全部自动化,用户只需要提供 API Key 和想要提取的字段名称。
BrowseGenie 包含三大功能模块:
Scraper Agent(抓取代理) — 专注于静态页面的结构化数据提取。用户传入 URL 和目标字段(如"商品名称""价格""评分"),Scraper Agent 自动完成:HTML 抓取 → 智能清洗 → AI 生成 BeautifulSoup 提取代码 → 执行提取 → 输出 JSON/CSV。
整个流程中有一个精妙设计:智能 HTML 清洗器。它会移除脚本、样式、内联 SVG 广告、导航栏等非内容元素,将 HTML 体积压缩 98%,只保留核心内容结构。这不仅降低了 AI 的上下文消耗,还大幅提升了代码生成的准确性。清洗后的内容还会根据 URL + 清洗规则生成结构哈希,用于缓存 AI 生成的提取代码——同类页面再次抓取时直接复用,无需重复调用 LLM。
Browser Agent(浏览器代理) — 基于 Playwright 构建,适用于需要 JavaScript 渲染的动态网页或需要与页面交互(点击、滚动、填写表单)的场景。支持自然语言指令驱动,例如"点击登录按钮,输入用户名,然后提交"。内置实时事件回调,可输出每个执行步骤的截图和日志,便于调试复杂的自动化流程。
MCP Server(MCP 服务器) — 基于 Model Context Protocol 构建,将 BrowseGenie 的工具暴露为标准化 MCP 工具。这意味着任何兼容 MCP 的 AI 助手(如 Claude Desktop)都可以直接调用 BrowseGenie 的抓取能力,无需额外集成代码。
输入 URL + 字段列表
    ↓
HtmlFetcher(CloudScraper 反爬 + Selenium 降级)
    ↓
HtmlCleaner(去广告、去样式、去噪音,压缩98%)
    ↓
TechStackDetector(检测页面技术栈)
    ↓
LLM Code Generator(Gemini/LiteLLM 生成 BeautifulSoup 提取代码)
    ↓
Code Cache(哈希缓存,复用同类页面)
    ↓
BeautifulSoup 执行 + DataExtractor 输出
关键技术选型:
安装方式极为简单:
pip install browsegenie
browsegenie https://example.com/jobs --output jobs.json
通过 Web UI 使用:
python -m browsegenie.web_ui
# 访问 http://localhost:5000
Browser Agent 的调用方式:
from browsegenie import browse

result = browse(
    task="登录 GitHub,输入用户名和密码,点击登录按钮",
    api_key="your_api_key",
    model_name="gemini-2.5-flash",
    headless=False  # 设为 False 可观察浏览器执行过程
)
注意事项:Browser Agent 需要本地安装 Chrome/Chromium(通过 Playwright 自动管理)。抓取行为应遵守目标网站的 robots.txt 和服务条款。
BrowseGenie 并非万能。首先,反爬机制仍然是最大的不确定性因素——尽管有 CloudScraper 和 Selenium 的双重保护,但大型商业网站(如 Amazon、LinkedIn)的反爬系统仍然可能阻断抓取。项目 Roadmap 中也明确列出了"验证码识别"和"代理轮换"作为待开发功能。
其次,AI 生成提取代码的成功率受页面结构复杂度影响。对于结构规整的列表页(如电商搜索结果页),AI 生成的 BeautifulSoup 代码往往能一次成功;但对于结构混乱或大量使用动态 ID 的页面,可能需要多次重试。
第三,项目尚未支持容器化部署,没有 Dockerfile 或 docker-compose,无法实现一键部署。对于希望在服务器环境运行的用户,需要手动配置 Python 环境和浏览器依赖。
BrowseGenie 代表了"AI + 爬虫"交叉领域的一个清晰方向:用自然语言界面替代结构化选择器。这类工具正在降低数据采集的技术门槛,让非程序员也能快速获取网页数据。随着 MCP 协议的普及,BrowseGenie 这类工具将越来越多地被集成到 AI Agent 的工作流中,成为"AI 看网页、读网页"的事实标准组件之一。
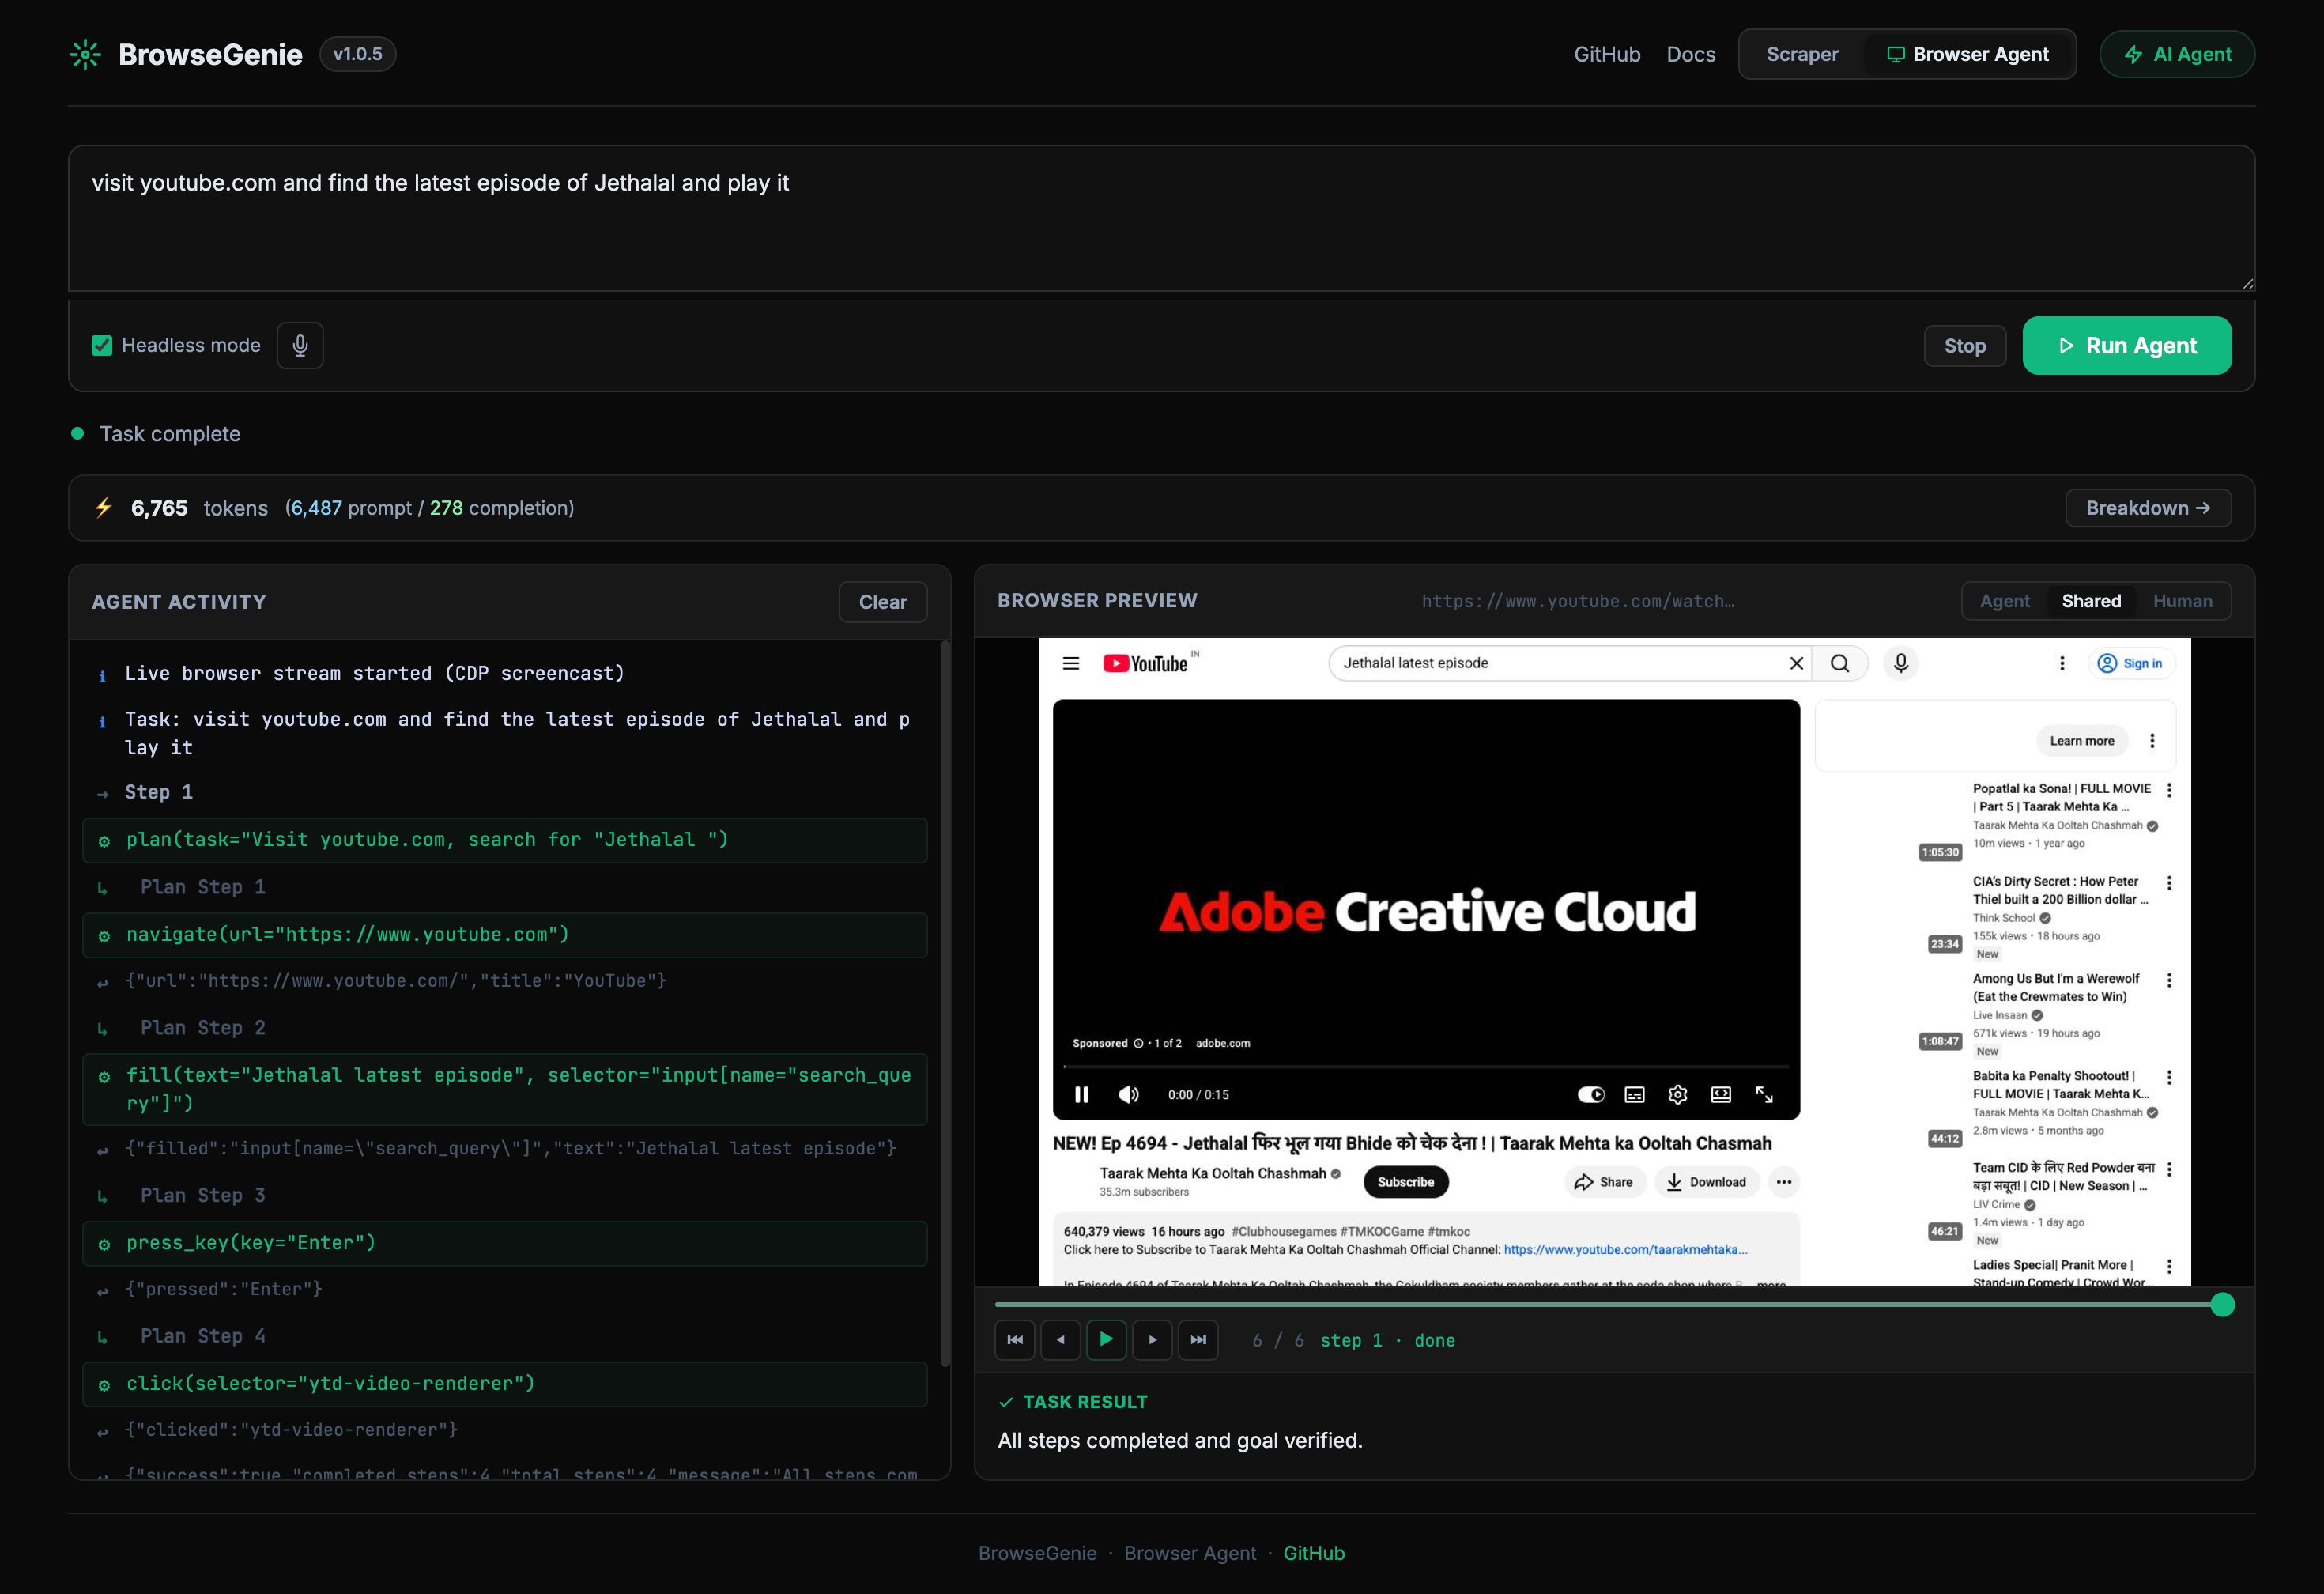
图1:BrowseGenie Browser Agent 工作流程 — 展示从用户自然语言指令到浏览器自动化执行的完整流程
