
larkos
Okerew/larkos加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
当你打开大模型的论文,满眼都是「Attention is All You Need」的后继者,是否想过——如果换一种底层结构,神经网络会不会走得更远?
Larkos(Lattice-Associated Recursive Knowledge Organization System,晶格关联递归知识组织系统)就是这个问题的实验性答案。它的作者 Okerew 没有选择继续优化 Transformer,而是回头看向人类大脑:从神经元如何在层中去中心化组织,到记忆如何在神经网络中动态生长,试图用纯 C 代码复现一种完全不同的智能形式。
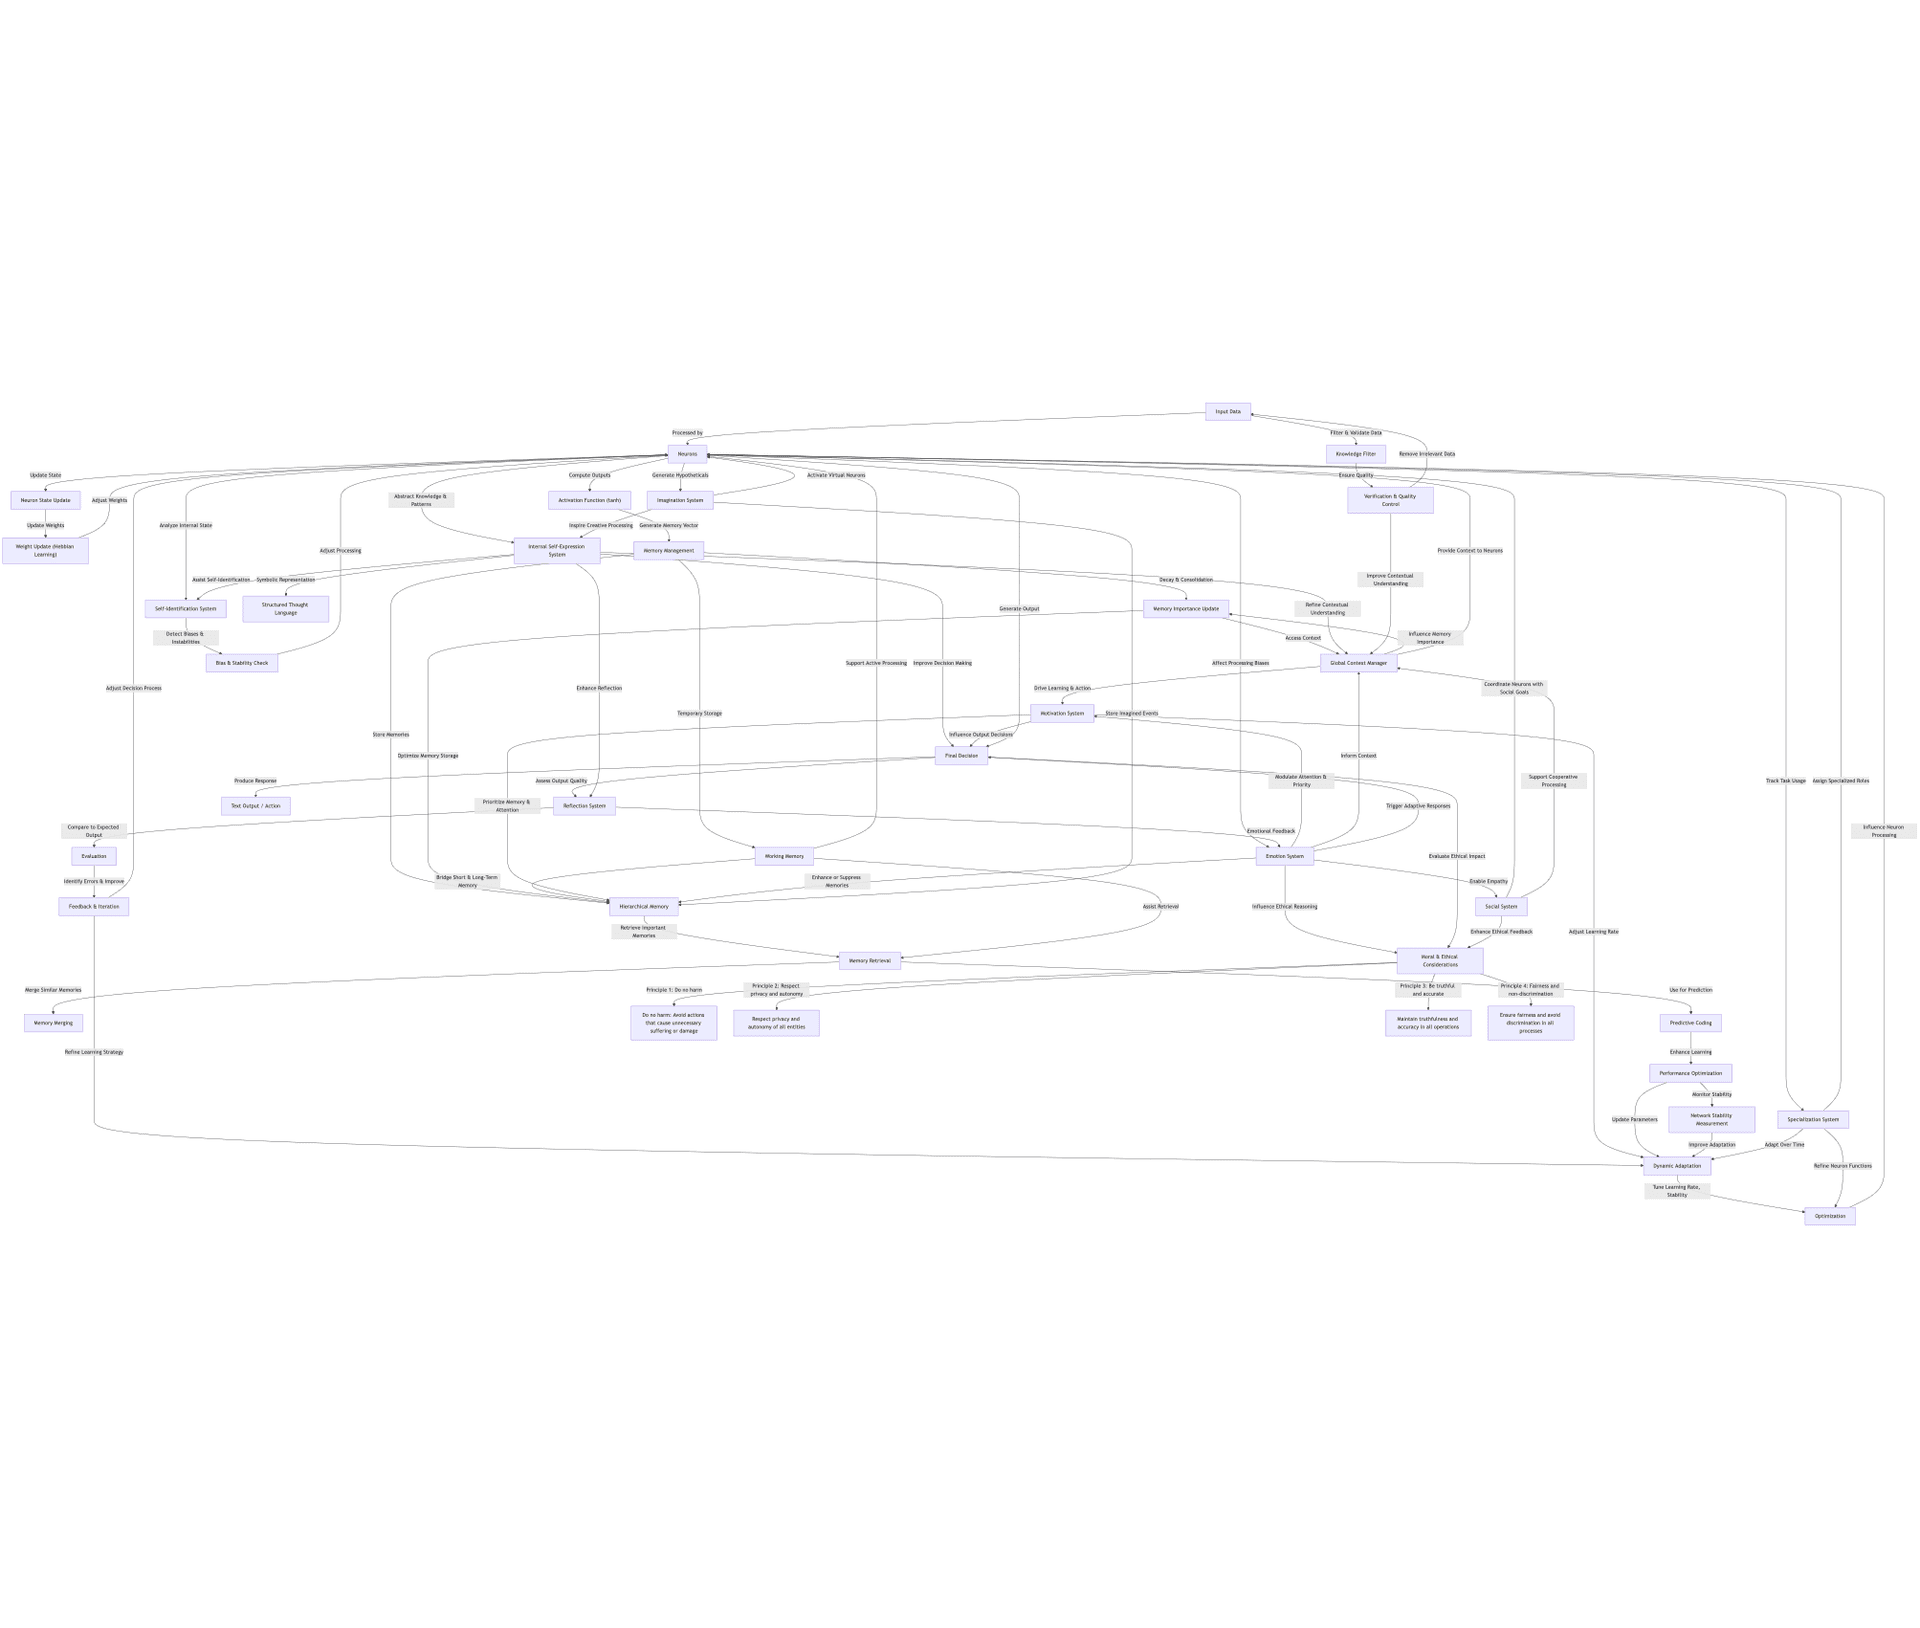 Larkos 的整体架构图,展示了去中心化神经网络与层级记忆管理系统的交互关系
当前主流深度学习模型的局限在哪里?权重和激活值是神经元唯一可以改变的东西。 但真实的大脑神经元远不止于此——它们能改变自己的结构(突触重塑)、化学特性(神经递质调节)、时序行为(动作电位模式)。
Larkos 的核心设计哲学是:神经元不只存储权重,而是拥有多维可塑性:
用生活化的比喻:传统神经网络像是固定的印刷电路板——元件位置固定,只能调节电阻值;而 Larkos 更像是活的神经网络——神经元可以移动、新生或消亡,连线可以重塑。
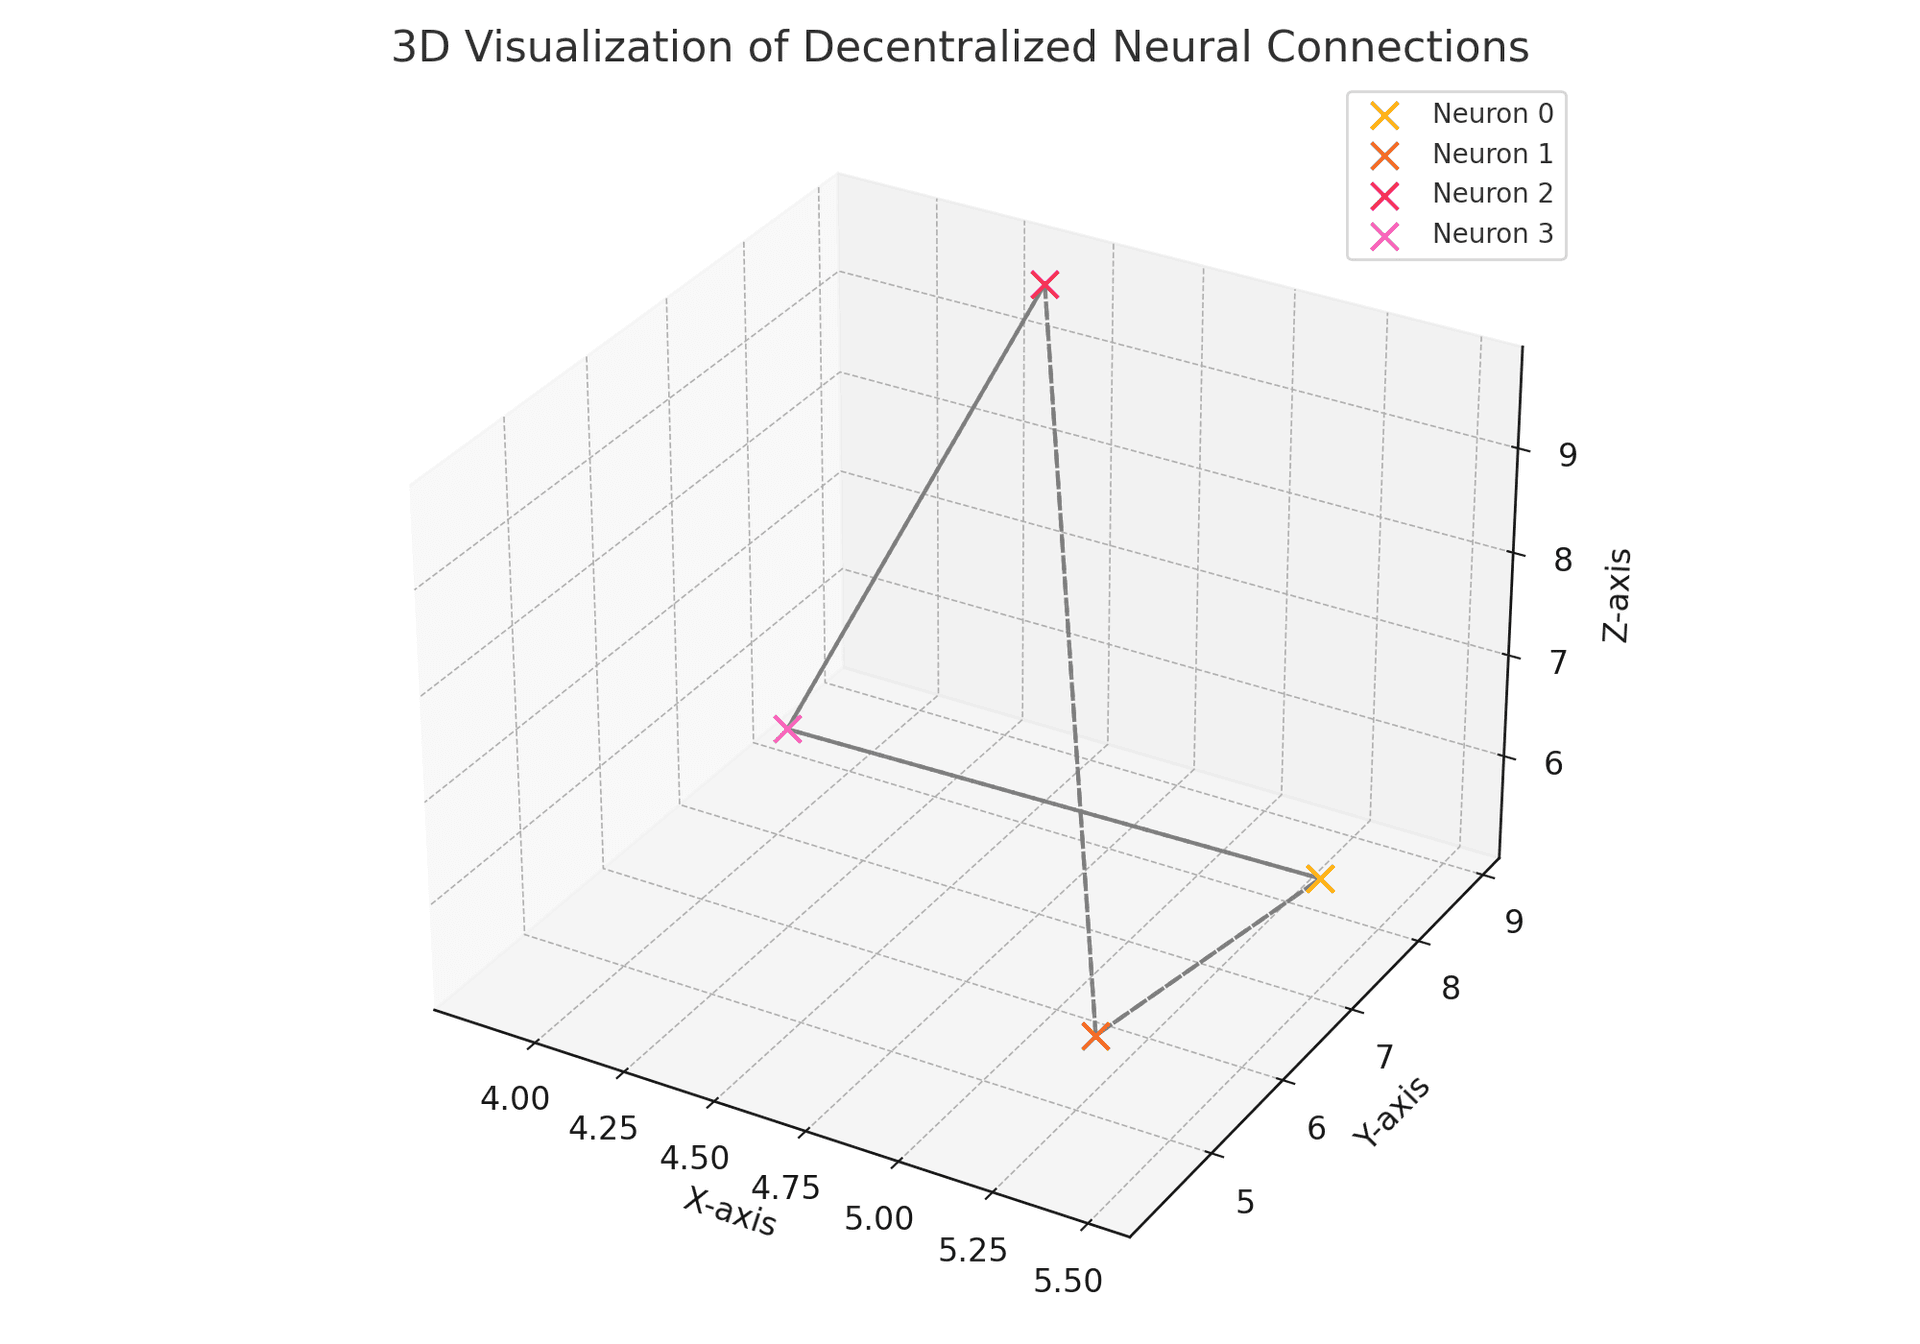 神经元连接的三维可视化图,展示了去中心化网络中复杂的连接关系
项目完全用 C 语言 编写(核心文件 neural_web.c 超过 46 万字节),核心设计思路是将计算抽象为统一的接口,底下接入不同硬件:
| 计算后端 | 技术 | 说明 |
|---|---|---|
| CPU SIMD | immitrin_functions.c | 利用 x86 SIMD 指令集(类 SSE/AVX)加速向量运算 |
| CUDA GPU | src/cuda/ | NVIDIA GPU 并行计算后端 |
| Metal | neuron_update.metal | Apple Silicon (macOS/iOS) GPU 后端 |
| 通用 Shader | shader | 跨平台 GPU 抽象层 |
核心接口定义在 src/include/nw.h(约 35KB),这是整个项目的 API 契约层。
// 核心头文件暴露的接口示意(来自 expose_from_*.h)
void expose_from_immitrin_...();  // SIMD 后端暴露函数
void expose_from_simd_functions_...(); // 通用 SIMD 函数
从 example/test_ctypes.py 可以看到,这个神经网络的调用方式是通过 Python ctypes 加载编译好的 .so 共享库:
import ctypes
lib = ctypes.CDLL('./neural_web.so')
# 然后调用 lib.neural_web_* 系列函数
这意味着 Larkos 本质上是一个高性能计算库,用 C 实现核心算法,暴露 C API,再由 Python/Lua 等高级语言通过 FFI 调用。
src/
├── neural_web.c        # 核心神经网络实现(最大文件)
├── immitrin_functions.c # x86 SIMD intrinsics
├── simd_functions.c   # 通用 SIMD 实现
├── neuron_update.metal # Apple Metal shader
├── Dockerfile         # 容器化编译脚本
├── cuda/              # CUDA GPU 实现
├── include/           # 头文件目录
│   ├── nw.h           # 主 API 定义(35KB)
│   ├── definitions.h  # 宏定义
│   └── expose_from_*.h # 各后端函数暴露
├── train_embeddings/  # 嵌入训练相关
└── vocab_converter/   # 词汇表转换工具

Documents/
├── an_idea_of_a_neural_web.pdf  # 理论论文(PDF)
└── training_example.md          # 训练示例文档

example/
├── example_dataset.txt  # 示例数据集
├── vocabulary.txt      # 词汇表(5557 词)
├── custom_embeddings.txt # 自定义嵌入
└── test_ctypes.py      # Python ctypes 调用示例
项目还包含一份详细的 PDF 论文(an_idea_of_a_neural_web.pdf),系统阐述了去中心化神经网络的理论基础。
不适合纯 AI 爱好者,因为:
.so 库后用 ctypes 加载适合谁?
编译步骤:
# Linux (SIMD)
gcc -shared -fPIC -o neural_web.so neural_web.c immitrin_functions.c -ljson-c

# 或使用 src/Dockerfile
docker build -f src/Dockerfile -t larkos .
编译产物是 .so 共享库,之后通过 Python ctypes 调用,或直接编写 C 程序链接。
性能未经大规模验证:目前只有 15 颗 GitHub stars,项目更多停留在原型阶段,缺乏 ImageNet/CIFAR 等标准 benchmark 对比数据。
去中心化带来的训练复杂度:传统神经网络的梯度反向传播(Backpropagation)在 Larkos 中如何实现,文档中没有清晰描述——这可能是该项目最核心的技术挑战。
生态极度匮乏:没有预训练权重,没有标准数据集基准,没有 Python high-level API。研究者如果想用它做实验,需要从零构建所有基础设施。
C 语言双刃剑:极致性能的同时,也意味着没有自动微分、没有动态图调试——开发效率远低于 PyTorch/JAX。
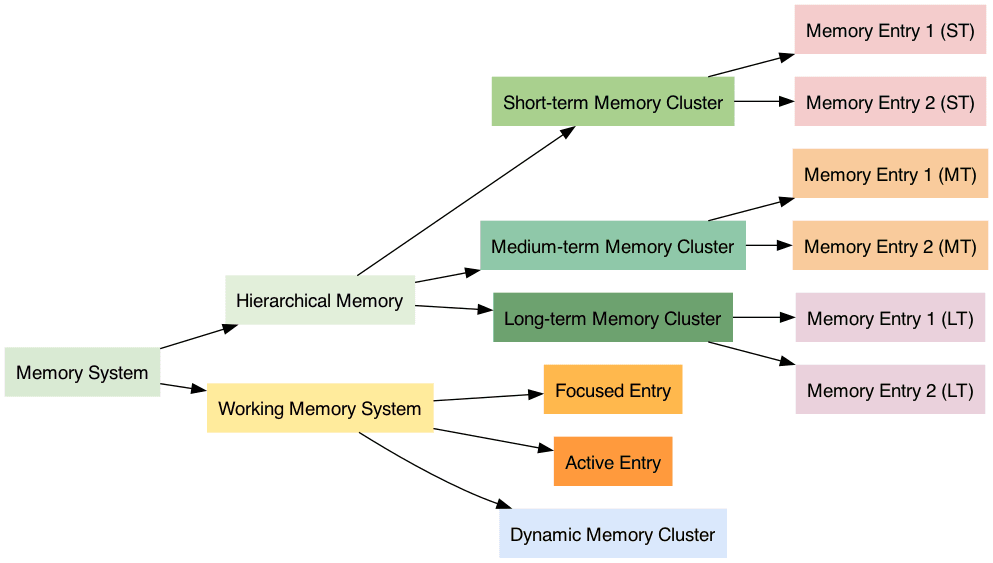 Larkos 的层级记忆系统架构
尽管 Larkos 距离实用还有很长的路,但它代表了一种宝贵的探索精神:不是所有神经网络都必须长成 Transformer 的样子。
当前 AI 领域对 Scaling Law 的迷信、对 Transformer 架构的路径依赖,其实隐藏着巨大的脆弱性——如果 Scaling 撞上了数据墙或算力墙,我们需要有备选方案。
Larkos 的价值不在于现在能做什么,而在于它证明了另一种可能性是存在的。就像生物进化中,神经系统独立演化出了多种解法(昆虫的链状神经、章鱼的分散神经、人类的层级皮层),神经网络也许并非只有 Transformer 一条路。
对于 AI 研究者和资深开发者,Larkos 是一个值得在周末午后打开源码、细细品味的实验性项目。
