
Strata
Niko1221/Strata加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个周末:你想在自己电脑上跑一个大模型来写代码、修 Bug、读文档,不想把对话内容传到别人的服务器,也不想每月付 API 账单。你打开机箱看了一眼——RTX 5070,12GB 显存,64GB 内存。
然后你想起 Qwen3.8-Flash-Next 有 1250 亿参数,即使是最粗糙的 2bit 量化也要 66GB 起步。显存差了 5 倍多。按常理,这事没戏。
Strata 就是来把这个"没戏"变成"能跑"的。这不是一个模型,不是一个聊天壳子,而是一整套为单一模型量身定制的本地推理引擎:C++/CUDA 写的核心,Python 写的服务层,Tauri 写的桌面外壳,把 24576 个专家拆散,分别安置在显存、内存和固态硬盘三个层级里协同工作。截至 2026 年 10 月底,它在 GitHub 上拿下了约 37,000 star 和 4,000 fork,开源协议 MIT。
Strata 的核心洞察写在仓库的技术论文《Running a 125-Billion-Parameter Model on a Normal PC》里:Qwen3.8-Flash-Next 是一个混合专家(MoE)模型,每个 token 只激活约 60 亿参数,也就是 24576 个专家里只用 10 个。既然如此,为什么非要把全部专家都塞进显存?
于是 Strata 干了三件事:
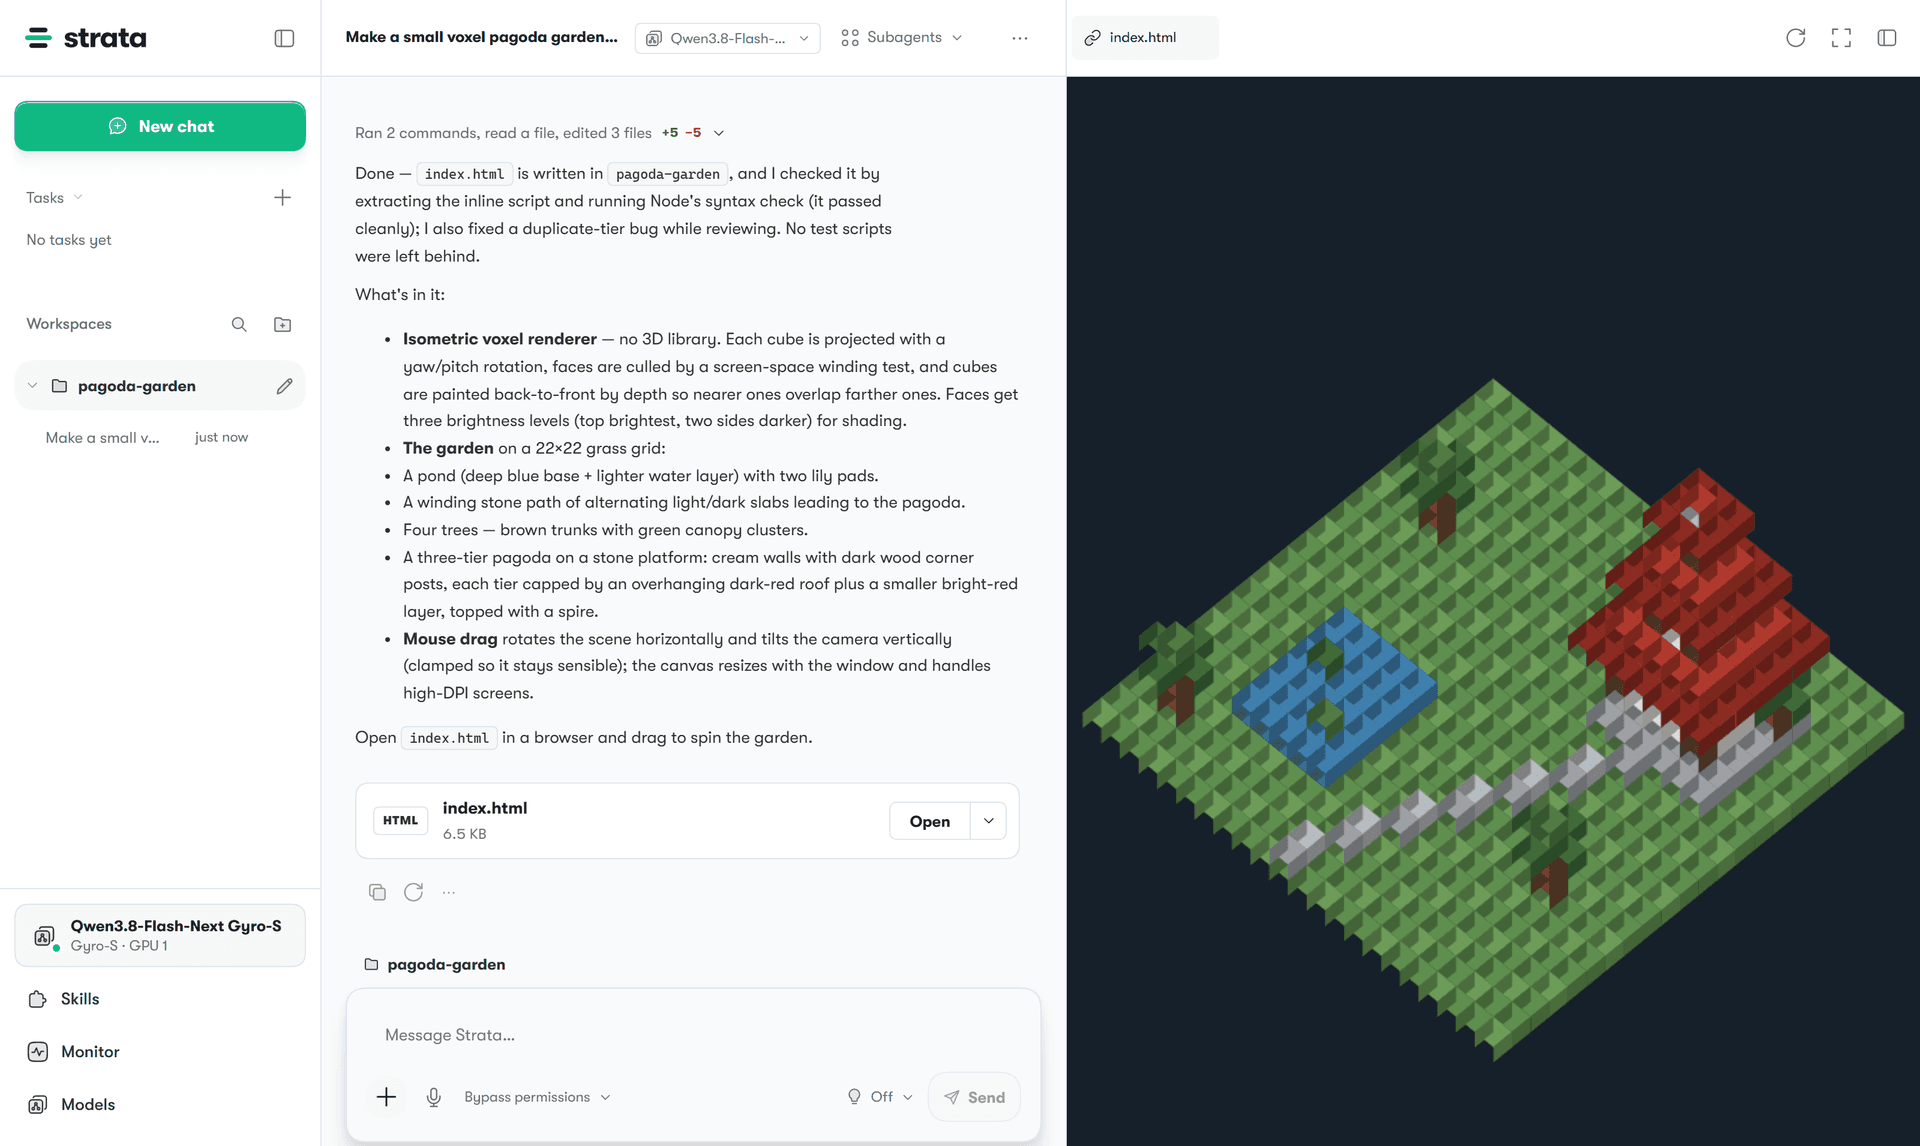
桌面应用把对话、文件管理和代码实时预览放在同一个窗口里,普通用户不需要碰终端。
另外还有一个"投机解码"优化:模型自带一层 MTP(多 token 预测)头,可以廉价地猜后面几个 token,然后大模型一次性批量校验,猜对几个就吐出几个。官方称平均每次前向能确认 2.4-3.2 个 token,整体提速 1.6-1.8 倍。关键在于,这个小助手只负责猜,大模型仍然逐字决策,所以输出质量与朴素贪心解码完全一致——论文里用"强制错误草稿 + 回滚"的测试验证了这一点。
Strata 的安装门槛设计得相当克制,给了三条路:
Strata-0.2.9-windows-x64-setup.exe、Strata-0.2.9-linux-x86_64.AppImage、Strata-0.2.9-macos-arm64.dmg),装完选模型直接聊。首次启动会按你的显卡自动下载对应引擎。curl -fsSL .../install.sh | sh(Windows 用 irm ... | iex),然后 strata launch。不需要管理员权限。docker/compose/ 下备好了 nvidia、amd、intel 三套 compose 文件,镜像已经发布到 ghcr.io/niko1221/strata。以 NVIDIA 为例,docker compose -f docker-compose.nvidia.yml up -d 就能拉起一个带 OpenAI/Anthropic 兼容 API 的服务,默认只监听 127.0.0.1:8080。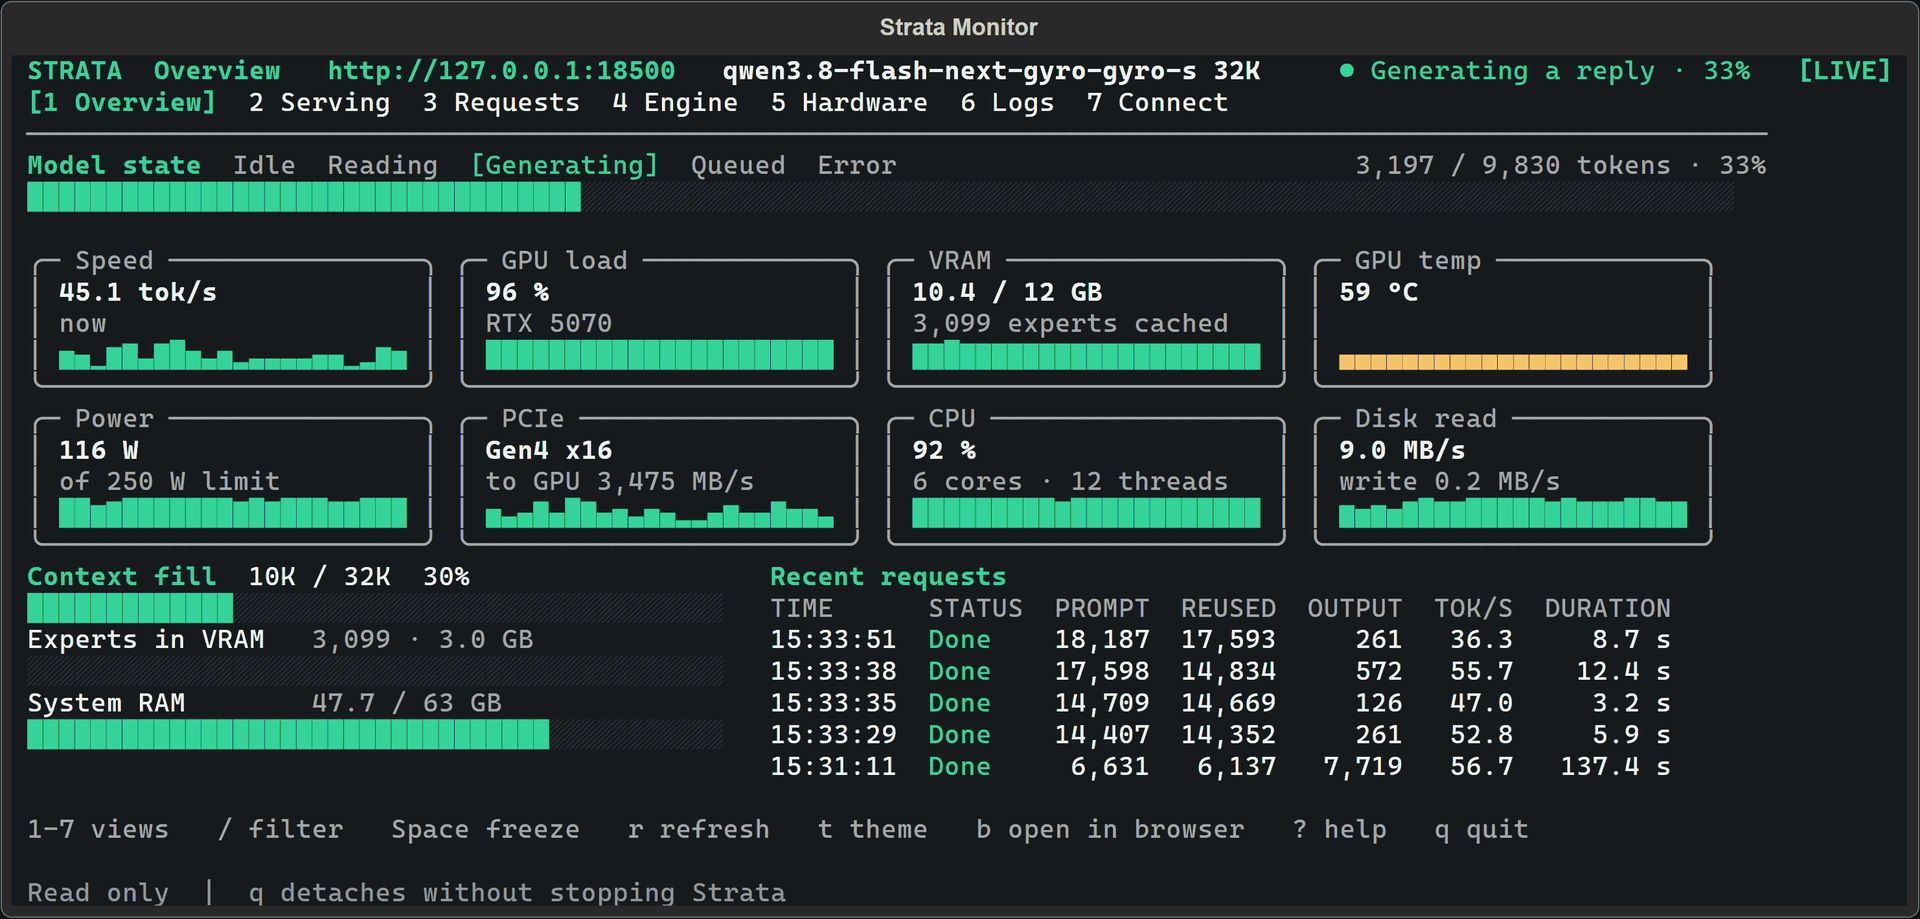
终端版的监控面板实时显示吞吐、显存/内存占用和请求记录,适合把它当常驻服务挂在角落。
值得点赞的是 --plan 模式:先打印"将要下载什么、占多少磁盘、需要多少内存",什么都不动,确认后再 --yes --no-tui 真正启动。这种把决策权留给用户的做法在开源推理引擎里并不常见。
服务端 serve/server.py 暴露的是双协议接口:OpenAI 兼容的 /v1/chat/completions 和 Anthropic 兼容路径。所以 Claude Code、Codex CLI、OpenCode、OpenClaw、以及 Hermes Agent 这类工具,改个 base_url 就能接上。strata connect 命令会列出已适配的应用,甚至可以 --check 发一条真实提示词加一次工具调用做连通性验证。
代码组织上大致是三层:
src/ + include/ + metal/ + sycl/:C++ 推理内核,按后端分 CUDA / HIP / SYCL / Metal。src/core/ 下能看到 expert_cache、pinned(内存钉住)、mtp、verify(投机解码校验)等核心模块,verify.cpp 有 29 万字符,是整个项目最重的单文件。serve/:Python HTTP 服务层,约 100KB 起步的 server.py 加上一堆按功能拆分的模块(images、mcp、replicas、telemetry、prometheus、structured 等)。apps/:Tauri 桌面外壳 + Node host 与 Web UI;strata_cli/、strata_control/ 是终端端 CLI 与控制通道。官方在 RTX 5070(12GB)+ Ryzen 5 7600 + 64GB DDR5 上的实测:2bit 的 Q2_0 量化在 4K 上下文下输出 95 tokens/s,prompt 处理速度 285-571 tokens/s。这个数字已经超过不少云端 API 的实际体感。
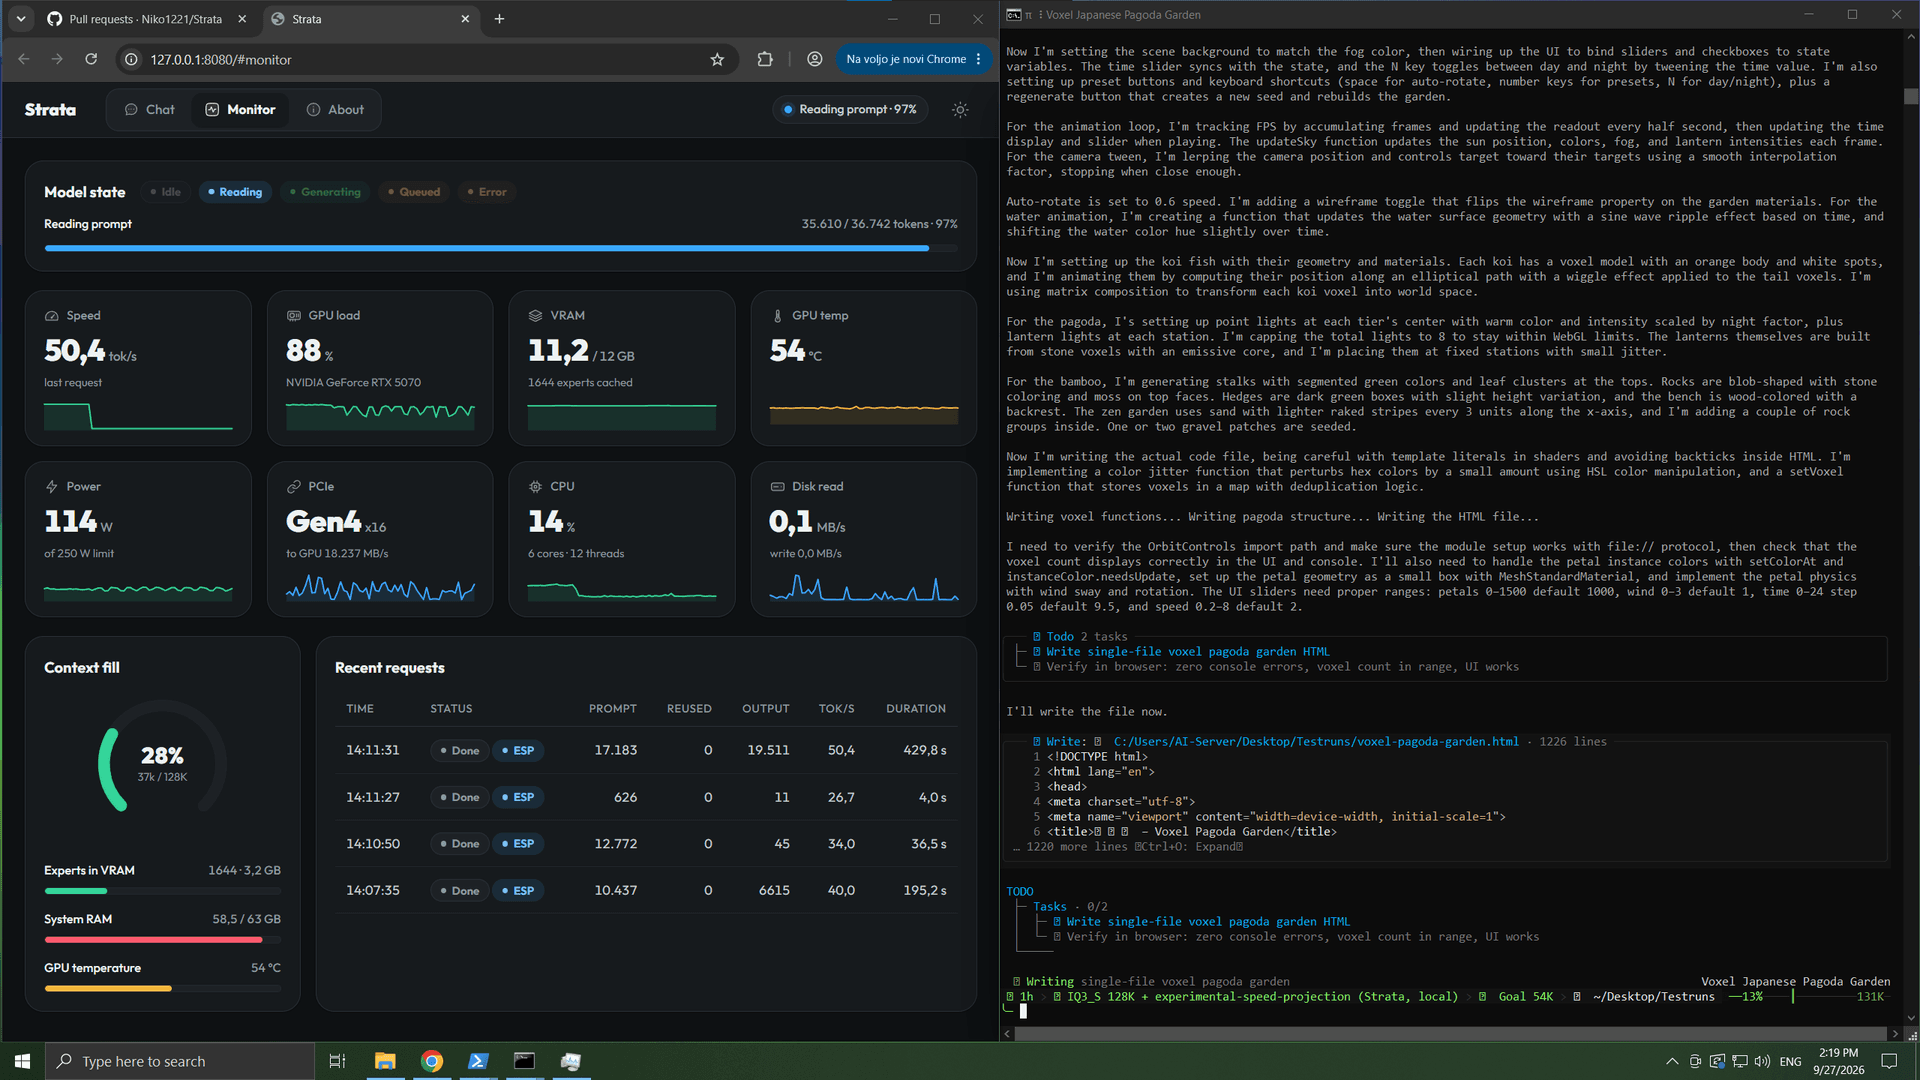
不同硬件差异很大,仓库里有一份社区基准(docs/COMMUNITY_BENCHMARKS.md)和第三方复现。有用户在 Proxmox 虚拟机上用 RTX 3060 12GB + 56GiB 内存跑 IQ3_S,得到约 36-38 tokens/s,并提到一个真实坑点:高推理强度会吃掉几千个 token 却迟迟不给出最终答案,需要显式配置推理预算。
必须说清楚的几点:
Strata 代表了一个清晰的趋势:本地推理的竞争点,正在从"能不能跑起来"转向"能不能把消费级硬件榨干到极限"。过去两年这个问题的答案是 llama.cpp 的量化 + 显存卸载;现在 Strata 给出的答案是更激进的三级存储架构 + CPU/GPU 细粒度协同 + 投机解码,把"12GB 显卡"这个约束条件直接写进了架构设计里。
对研发团队的现实价值有三点:一是隐私敏感、不能出内网的代码助手场景,现在有了开箱即用的本地方案;二是成本,本地跑完 32K 上下文的长文档审阅,边际成本是电费;三是供应链,一旦某家 API 涨价或停服,你的工具链不用改。
它当然不是 Llama.cpp 的替代品,两者目标不同。但如果你的场景恰好是"大模型 + 消费级显卡 + 大量本地调用",Strata 值得放进评估清单。
技术要点速览
| 维度 | 结论 |
|---|---|
| 项目定位 | 面向单模型深度定制的本地 MoE 推理引擎 |
| 核心语言 | C++(CUDA/HIP/SYCL/Metal)+ Python 服务层 + Tauri 桌面端 |
| 部署方式 | 桌面安装包 / 一行 shell 脚本 / Docker Compose(ghcr 预构建镜像) |
| 最低硬件 | 12GB 显存 + 32GB 内存 + 80GB 磁盘(推荐 64GB 内存) |
| 接口 | OpenAI 兼容 + Anthropic 兼容 API,附带 Web 聊天与监控界面 |
| 优化手段 | GPU/RAM/SSD 三层专家分层、CPU-GPU 并行、MTP 投机解码、prompt 查找草稿、CUDA Graph 捕获 |
| 许可证 | 引擎 MIT(模型权重各有独立协议) |
| GitHub 数据 | 约 37,050 star / 4,008 fork / 1,035 open issues / 295 位贡献者,最新版本 v0.2.9(2026-10-31) |
