
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
凌晨两点,一封邮件静静躺在客服队列里:
"你们重复扣了我三次钱,赶紧退款,否则我取消订阅。"
如果让 GPT-4o 来处理,这条工单需要:先理解邮件意图,再判断是否合理,再决定路由部门——一次完整的 autoregressive 生成需要数百毫秒,还要面对幻觉风险。
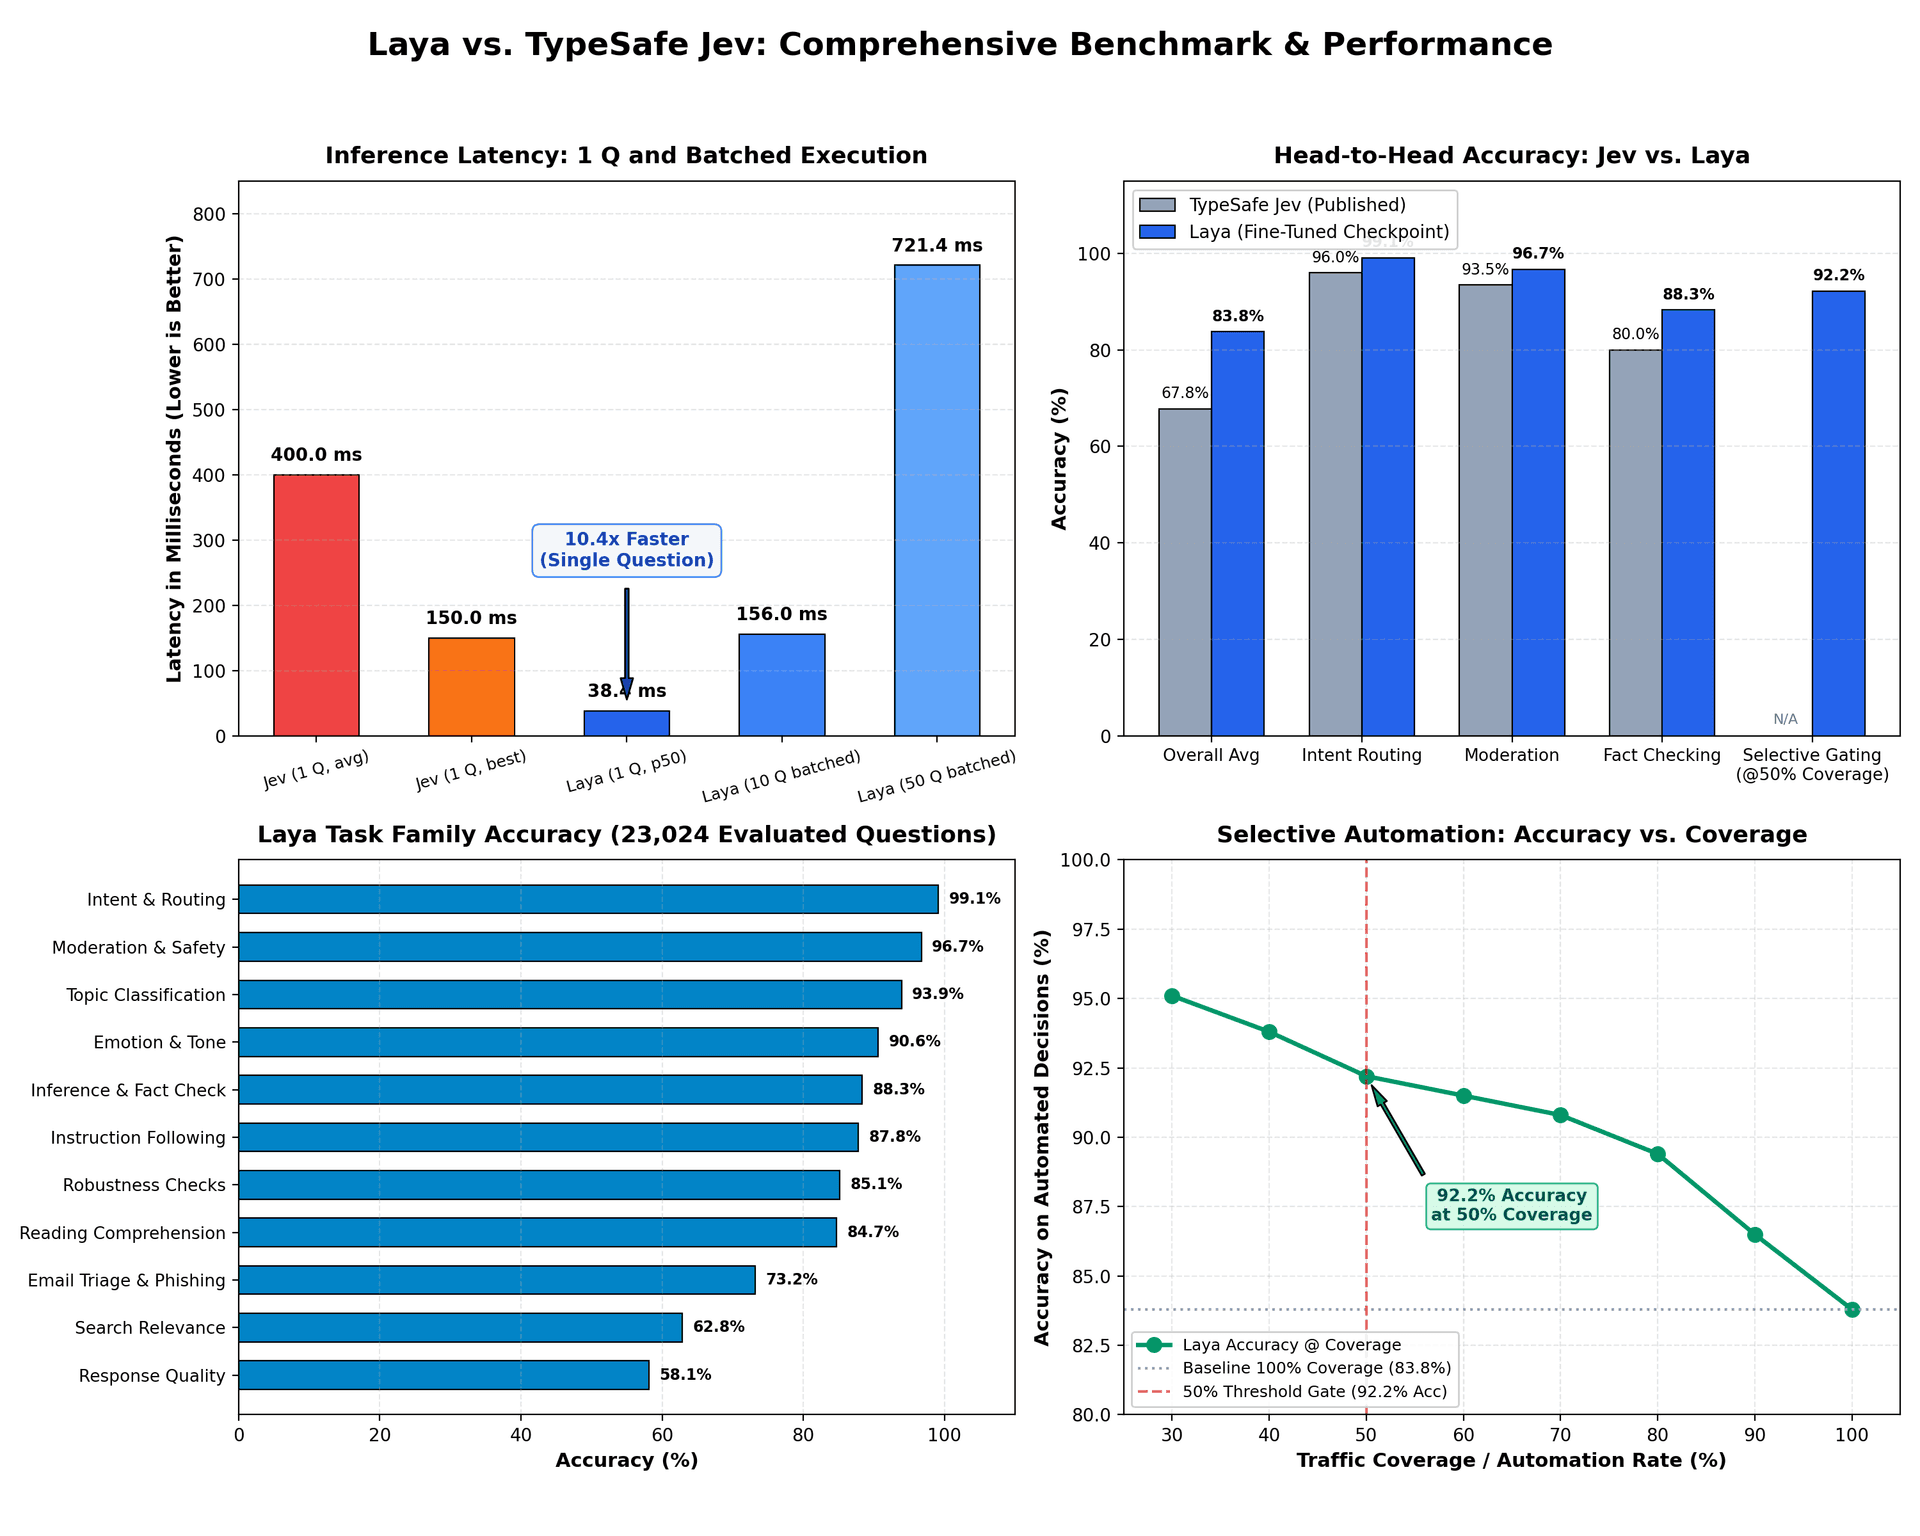
而 Laya 只需要 33 毫秒,不需要生成任何文字,直接给出结构化决策:这是账单部门、紧急度 0.87、会话挽留概率 0.91。
这就是 Laya 想要解决的问题:不是所有 AI 任务都需要一个会说话的 chatbot,高速、结构化、可置信的决策引擎,有时候更合适。
Laya 的作者 Nandha Kishor(Convai Innovations)从 2024 年 3 月就在 arXiv 发表了一篇关于 RLCD(Reinforcement Learning for Calibrated Decisions)的论文——用强化学习训练决策模型,使其输出数学上严格校准的概率分布。
他把这个想法叫做 "System 1 Decision Engine",灵感来自 Kahneman 的双系统理论:System 1 是快思考,像条件反射;System 2 是慢思考,像 chatGPT。LLM 是 System 2,而 Laya 要做的是 极快的 System 1。
2025 年下半年,TypeSafe 发布了一款商业决策引擎 Jev,定价 $0.042/M tokens,公开了 RLCD 的概念但没有开源。Nandha 决定自己复现并开源,在 2026 年发布了 Laya,代码、权重、benchmark 全部公开,采用 Apache 2.0 许可。
如果把 LLM 类比成一名翻译员——它理解上下文,然后用文字表达理解;那么 Laya 就是一个 考试阅卷机——你给它题目(question)和答卷(state),它直接涂卡(choice/score/noul)。
三种作答模式:
choice:多选分类,例如"这条工单应该分配给哪个部门?"score:打分排序,例如"这封投诉的紧急程度打几分?"noul:是/否概率,例如"用户是否在威胁取消订阅?"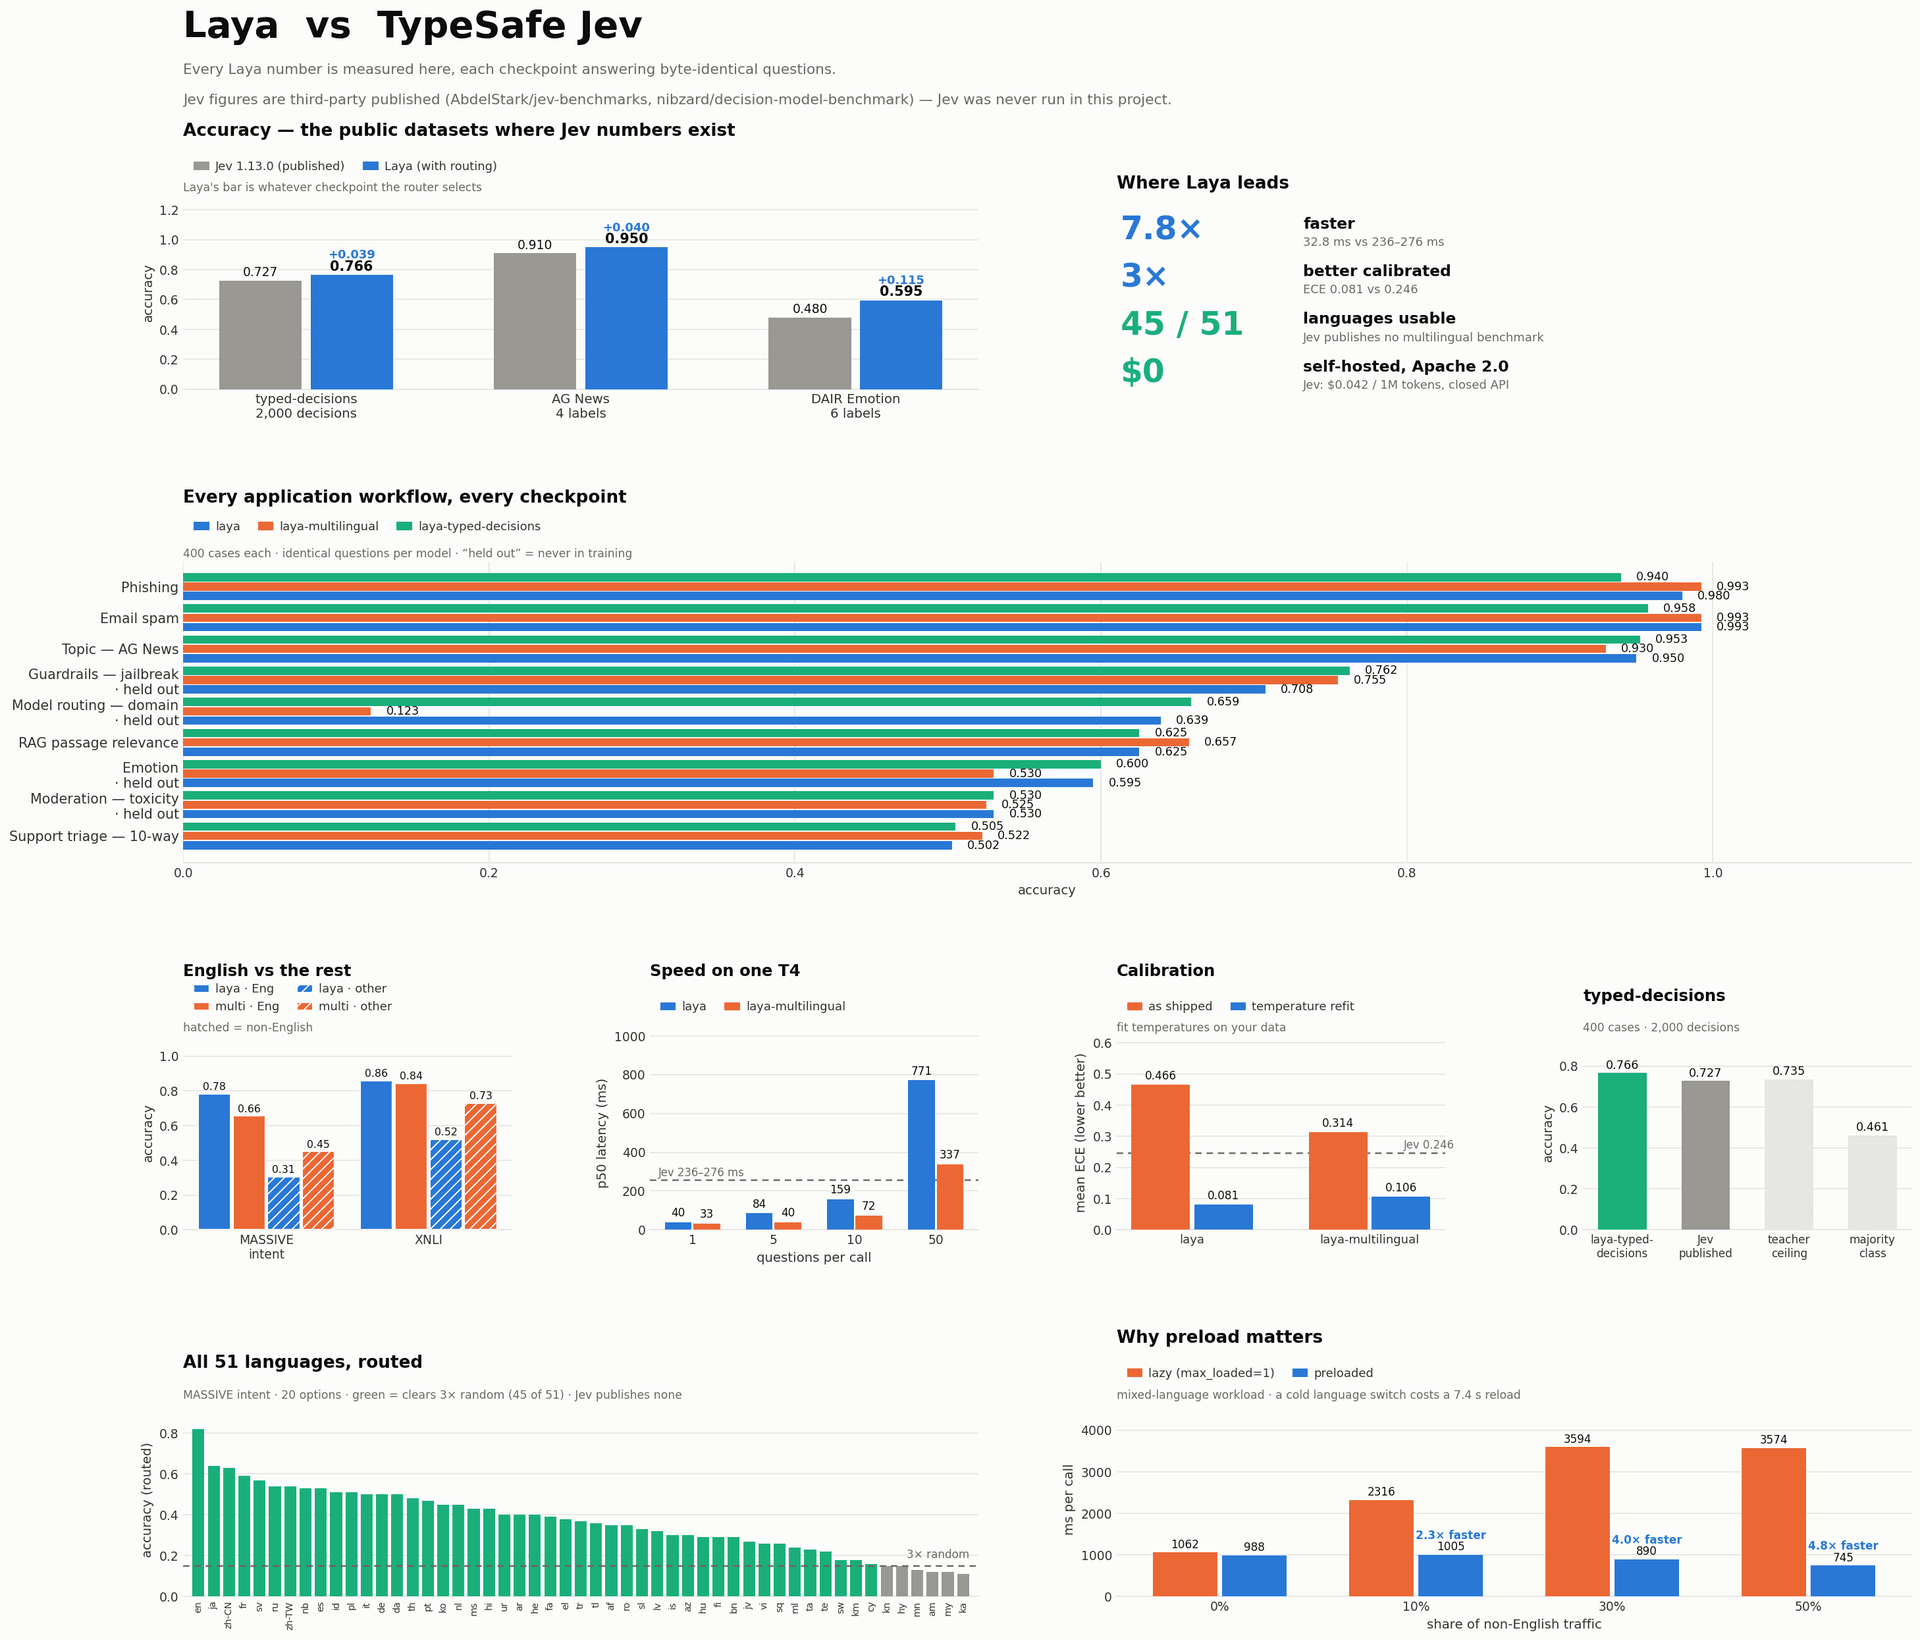
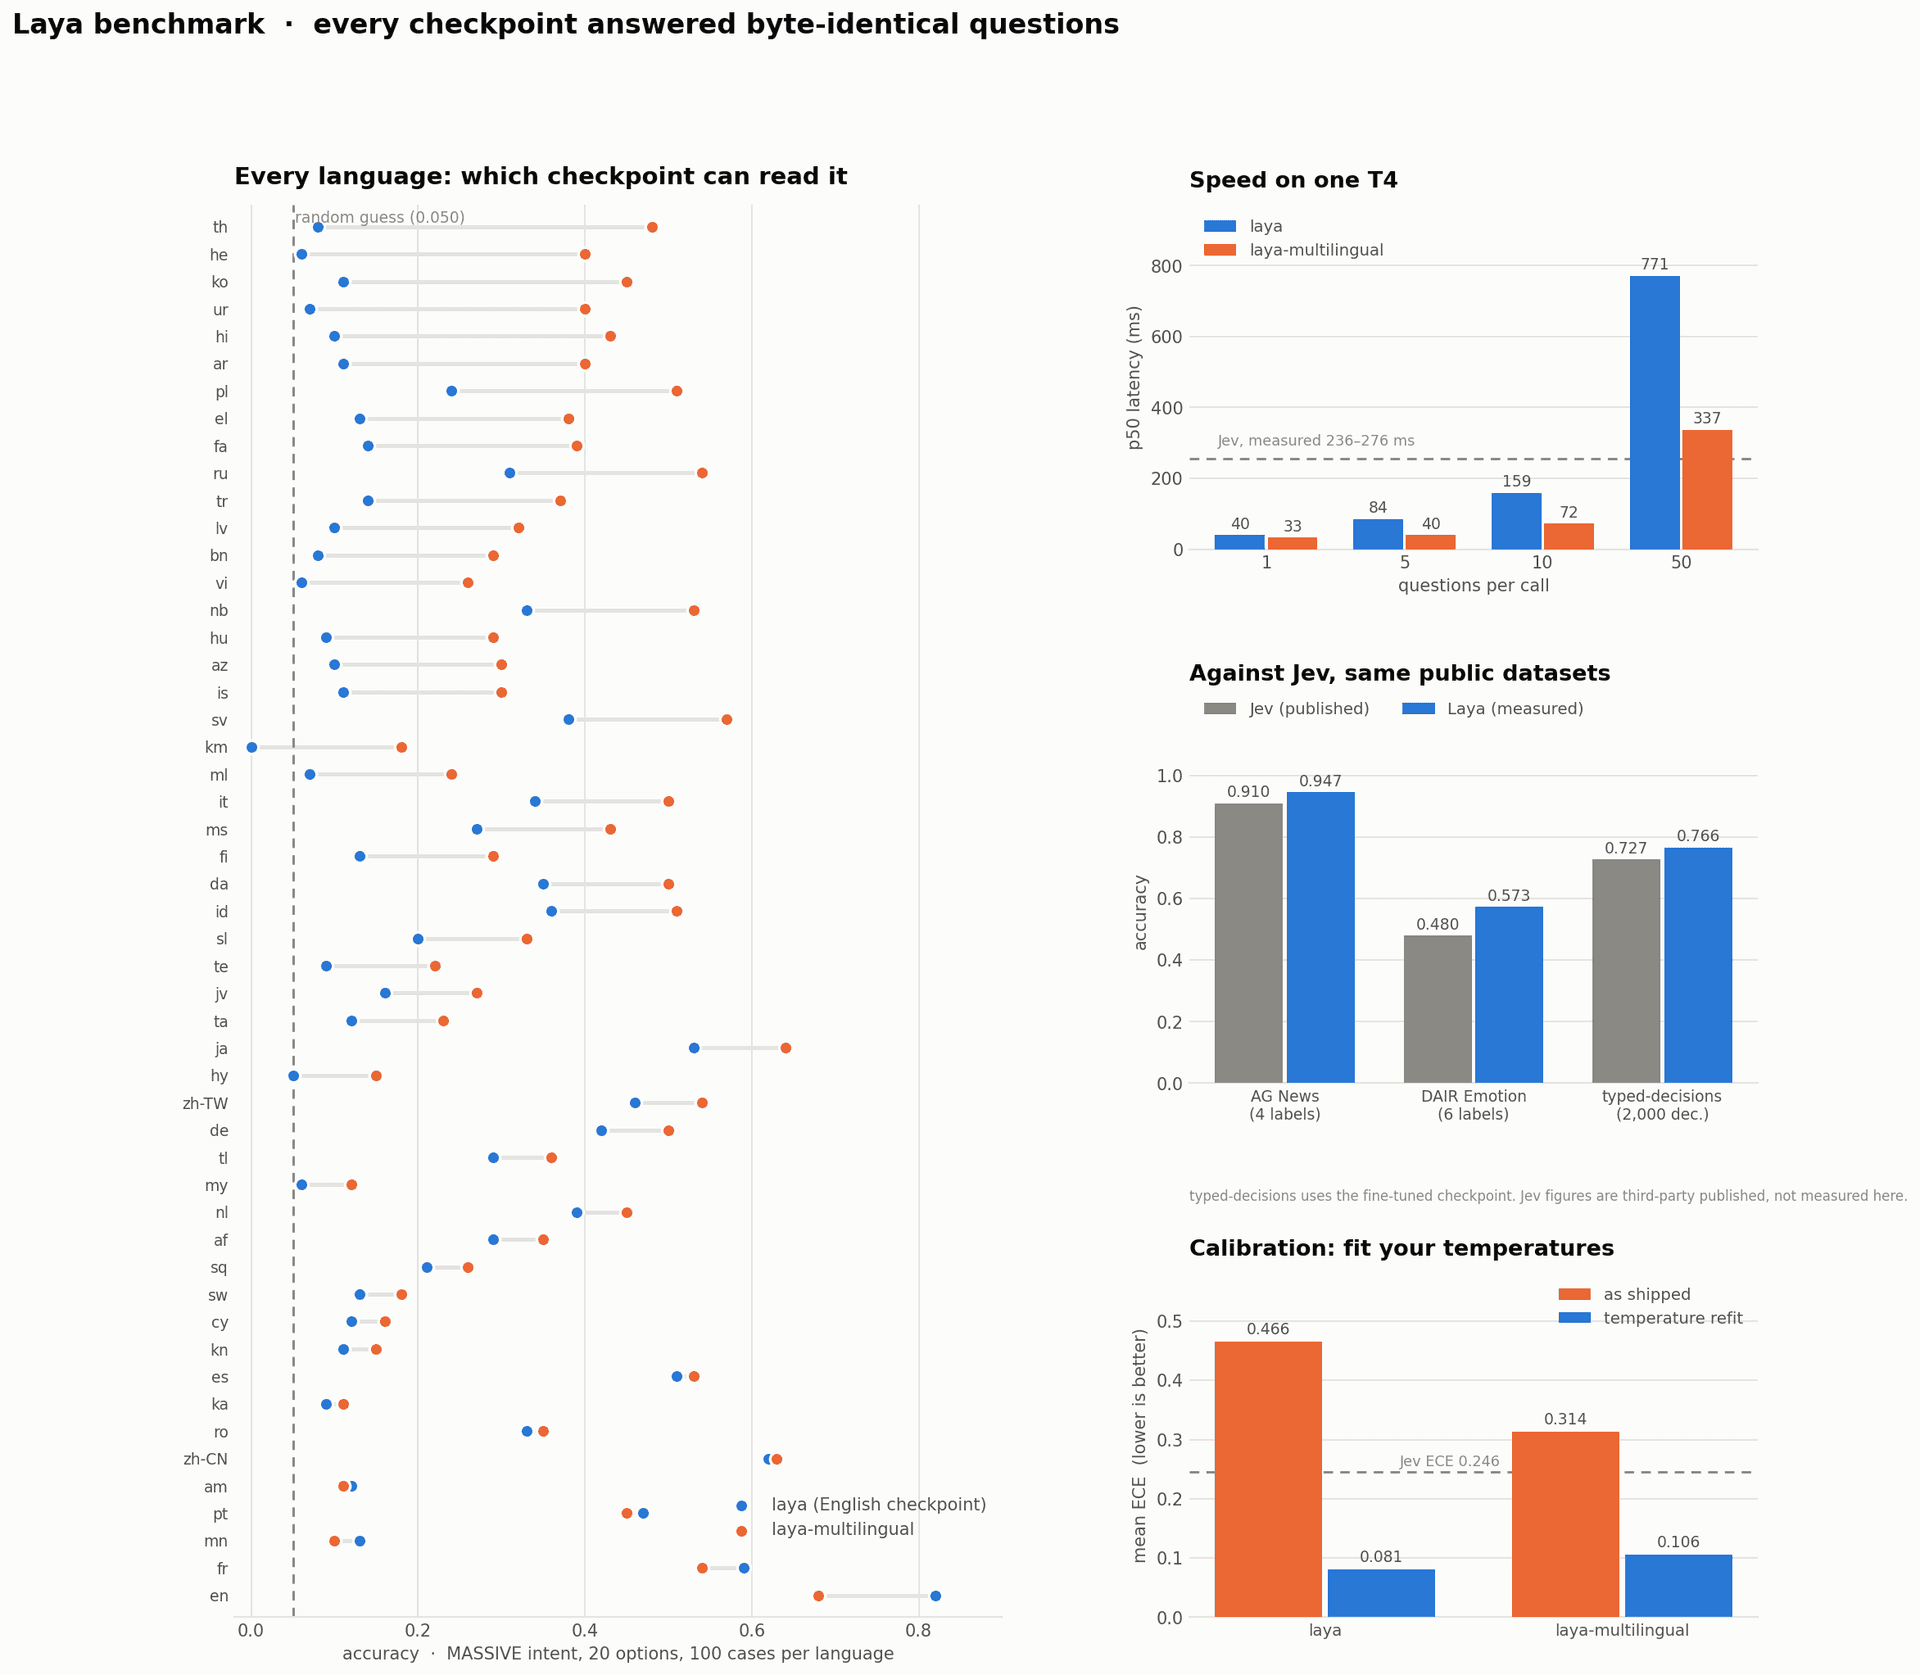
这三种输出都带有 数学校准的概率,置信度和真实准确率高度一致——ECE(Expected Calibration Error)仅为 0.081,而竞品 Jev 为 0.246。这意味着你可以放心地根据置信度做业务决策,而不只是把它当作参考分数。
Laya 的核心创新在于 RLCD(Reinforcement Learning for Calibrated Decisions)训练范式:
这种方法的核心洞察是:KL 散度最小化和校准是两个不同的目标,KL 散度会让模型走向"自信但错误",而 Proper Scoring Rule 才能让模型同时做到"准确且诚实"。
Laya 提供了 三个专用 checkpoint,由 Router 智能路由:
| Checkpoint | 底座 | 参数量 | Context | 适用场景 |
|---|---|---|---|---|
laya | ModernBERT-large | 421M | 512 tokens | 英语(最高精度) |
laya-multilingual | mmBERT-base | 322M | 1024 tokens | 100+语言(2x 速度) |
laya-typed-decisions | ModernBERT-large | 421M | 1024 tokens | 结构化决策场景 |
Router 的路由逻辑:
task="typed_decisions" 或开启 auto_task_detection=True实测数据显示路由带来的精度提升非常显著:在 MASSIVE 意图识别任务中,英语 checkpoint 对印地语准确率仅 0.100(随机猜测为 0.050),但 Multilingual checkpoint 达到 0.430;在 XNLI 跨语言推理中,Multilingual 比英语 checkpoint 高出 21 个百分点。
在客服系统中,每分钟可能涌入数百条消息。传统方案是 LLM 做意图分类,但成本高、延迟大。
from laya import Router

router = Router(preload=True)  # 预加载所有 checkpoint

questions = {
    "department": {
        "type": "choice",
        "criteria": {
            "billing": "发票、付款、退款",
            "technical": "Bug、宕机、系统错误",
            "sales": "定价、新合同",
            "other": "其他"
        }
    },
    "urgency": {"type": "score", "criteria": ["不紧急", "尽快", "紧急阻断"]},
    "churn_risk": {"type": "noul", "instructions": "用户是否威胁取消订阅?"}
}

state = {"subject": "重复扣款", "body": "被扣了三次钱..."}
result = router.predict(state, questions)
# 输出:department="billing" (confidence: 0.94), urgency=0.78, churn_risk=0.91
from laya import Agent

agent = Agent(model="english")
questions = {
    "is_spam": {"type": "noul", "instructions": "这是垃圾邮件吗?"},
    "is_phishing": {"type": "noul", "instructions": "这是钓鱼攻击吗?"},
    "toxicity_level": {"type": "score", "criteria": ["无毒", "轻微", "严重"]}
}
result = agent.predict({"text": email_body}, questions)
在 RAG 系统中,可以用 Laya 对候选段落做相关性打分,快速筛选 top-k 而不需要生成摘要。
支持 MASSIVE 数据集的全部 51 种语言,包括:英语、中文、日语、韩语、印地语、阿拉伯语、泰语等。laya-multilingual checkpoint 在全部 51 种语言上的 macro accuracy 达到 0.366(随机基准为 0.050)。
Laya 提供了开箱即用的预设问题集,不需要从零设计 questions:
email_questions:邮件工单分析(部门、紧急度、挽留风险、退款请求)triage_questions:医疗分诊(紧急度、科室)moderation_questions:内容审核(垃圾、钓鱼、毒性)guard_questions:护栏检查(敏感话题、安全风险)router_questions:通用路由Laya 的安装极其简单:
pip install laya
核心依赖:torch >= 2.0.0、transformers >= 4.45.0、safetensors、huggingface_hub、numpy。
CPU 运行:可以跑,速度约为 GPU 的 1/4。作者在 Reddit 表示正在针对低端 CPU 优化。
GPU 运行:推荐 NVIDIA GPU(任意 CUDA 设备),推理速度最快。首次使用自动从 HuggingFace 下载 checkpoint(约 1-2GB)。
无容器化:没有 Dockerfile 和 docker-compose,无法一键容器部署。适合有 Python 环境可以直接 pip install 的场景。
HuggingFace Space 在线体验:https://huggingface.co/spaces/convaiinnovations/laya-demo 有 7 个 Tab 的完整交互演示(分诊、邮件、护栏、RAG、审核、路由、Playground),可直接体验。
对于习惯 Docker 一键部署的团队,Laya 目前没有提供 Dockerfile。这意味着在无 Python 环境的服务器上部署需要手动配置依赖。
Laya 基于 ModernBERT 和 mmBERT,属于 encoder-only 架构。对于需要强上下文推理(如"这段话讽刺了什么")的场景,encoder 的天花板低于 decoder 模型。
作者强调 ECE=0.081 的校准精度,但这只代表模型在基准数据集上的表现。生产环境中数据分布偏移(distribution shift)可能导致校准失效——低置信度不代表"我确定不会错",而只是"在这个数据上我不确定"。
这个 checkpoint 专门针对四类结构化决策场景训练,但 Router 默认不会自动选中它,需要显式指定。这对新手来说容易踩坑。
Laya 的发布(尤其是 Apache 2.0 开源)在 Hacker News 和 Reddit 上引发了热烈讨论。一位 Reddit 用户评论:"终于有了一个能实际用于生产的非生成式 AI 工具,不是又一个 chatbot wrapper"。
从更宏观的视角看,Laya 代表了一个新兴趋势:非自回归决策模型(Non-autoregressive Decision Models)。这类模型不做文字生成,只做快速分类/打分,优势是:
在这个大模型"越大越好"的军备竞赛时代,Laya 用 322-421M 参数做到了很多 LLM 要贵得多的事情。它的出现证明了:有时候更专业、更小的模型,比通用的大家伙更好用。
项目信息
pip install laya