
synthda
NVIDIA/synthda加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
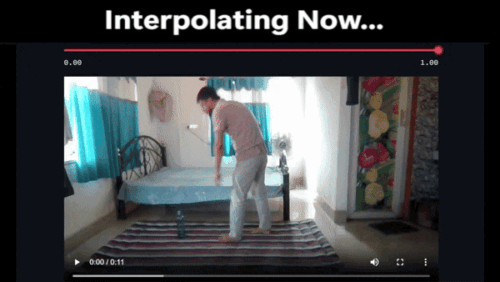
图:SynthDa 在 NVIDIA 技术博客的官方演示 GIF,展示姿态插值数据增强的实际效果(来源:NVIDIA Developer Blog)
凌晨三点,养老院的摄像头静静记录着走廊。老人踉跄了一下,摔倒在地——这是看护人员最希望 AI 立即发现的情况。但现实是,大多数动作识别模型在训练时几乎没有见过"摔倒"的样本,于是它犹豫了、迟疑了,最终没有发出警报。
这不是算法不够聪明,而是数据不均衡的经典困境:人类日常行为中,"摔倒""挥手呼救""突然蹲下"这类罕见动作的数据远远少于"正常行走"和"站立"。当模型面对类别严重不平衡的训练集时,它自然会更擅长识别常见动作,而对稀有但关键的行为"视而不见"。
采集更多稀有动作数据的成本极高——你不能让演员反复摔倒在各种光线下录制,还要处理隐私问题。SynthDa 正是为了解决这个矛盾而生。
SynthDa(Synthetic Data Augmentation for Action Recognition)最早由 NVIDIA AI 科技中心(亚太区)与新加坡理工学院(SIT)联合发起,最初论文发表于 ISMAR 2022。
此后项目经历了多次重要迭代:
| 年份 | 里程碑 |
|---|---|
| 2022 | SynDa 论文首次发表于 ISMAR 2022,提出基于骨架的合成数据生成 pipeline |
| 2023 | Siggraph Asia 2023 发表 SynthDa,提出结合真实数据生成可用合成数据的完整框架 |
| 2024 | Siggraph Asia 2024 发表设计指南,降低框架使用门槛 |
| 2025 | 集成生成式 AI(GPT 描述 + Text-to-Motion),发布 AutoSynthDa(当前版本) |
| 2026 | MMM 2026 发表 AutoPose,证明姿态混合增强对稀有动作识别有明显提升 |
核心作者 Megani Rajendran(Aik Beng Ng 等,NVIDIA)与新加坡理工学院团队历时四年,将一个学术研究项目打磨成一套完整可用的开源工具链。
SynthDa 的创新之处在于在姿态(Pose)层面做数据增强,而不是直接渲染完整的逼真视频帧。这种"骨架先行"的方法有三个显著优势:
第一,精细动作控制。 骨骼关节点的位置和旋转直接决定了动作语义,改变关节点坐标就能精确控制"手腕抬起多高""头部转动角度"——这是像素级生成很难做到的。
第二,避免纹理干扰。 传统图像合成容易产生皮肤、服装等纹理伪影,而姿态级表示天然与纹理解耦,生成的运动轨迹在运动学上更可信。
第三,模块可替换。 姿态估计可以用 OpenPose、MediaPipe 或 NVIDIA TAO;渲染可以用 Blender、PyTorch3D;优化循环可以用 SlowFast、I3D 等任意动作识别网络。每个环节都能独立替换。
SynthDa 提供两种互补的增强路径:
Real Mix(真实混合):取两段真实视频,通过骨骼插值生成中间帧——比如把"行走"和"奔跑"混合出"快步行走"。不需要任何生成模型,纯几何操作。
Synthetic Mix(合成混合):先用 Text-to-Motion 生成 AI 动作描述,再用生成模型创建骨骼序列,最后与真实视频混合。这样可以创造训练集中完全不存在的动作变体。
从代码仓库结构看,SynthDa 由以下核心组件串联而成:
输入视频 → 姿态估计(StridedTransformer)
              ↓
        GPT 动作描述生成(OpenAI API)
              ↓
        Text-to-Motion 生成合成骨骼序列
              ↓
        骨骼重定向 + 优化(joints2smpl)
              ↓
        Blender 渲染合成视频
              ↓
        SlowFast / TAO Toolkit 动作识别优化
关键依赖包括:
在线体验(推荐先试): 项目在 HuggingFace Spaces 提供了在线演示,无需任何安装即可体验基础功能。同时还提供了多个 Colab Notebook,适合快速试用。
本地部署: 需要满足以下条件:
SynthDa 不仅仅是一个开源项目,背后有扎实的学术积累。目前已发表的论文包括:
许可证:NSCLv2(非商业研究专用许可证)
这是一个常被忽略但非常重要的限制。NSCLv2 仅允许将 SynthDa 用于非商业目的的研究或评估,商业产品不得使用。
| 维度 | 评价 |
|---|---|
| 核心能力 | 姿态级数据增强,缓解动作识别数据不均衡问题 |
| 技术深度 | 学术积累深厚(4年,顶会论文5+篇),模块化架构清晰 |
| 部署难度 | 较难(需手动配置5个子仓库+多组权重,非Docker化) |
| 许可证 | NSCLv2,仅限非商业研究 |
| 适用人群 | 动作识别研究者、视频理解工程师、医疗/养老 AI 开发者 |
| 推荐程度 | ⭐⭐⭐⭐ 研究价值高,但部署门槛限制了广泛使用 |
如果你正在研究动作识别、数据增强或人体姿态估计,SynthDa 绝对是值得关注的项目。如果只是想快速体验,可以先从 HuggingFace Spaces 入手;如果是工程落地,则需要评估 NSCLv2 许可证是否满足需求。
