
context-aware-rag
NVIDIA/context-aware-rag加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你给大模型一份上百页的 PDF 合同,让它总结关键条款。大模型自信满满地告诉你"甲方有权单方面终止合同"——但这份条款根本不在 PDF 里,是模型"幻觉"出来的。这种一本正经的胡说八道,正是 RAG(检索增强生成)技术要解决的核心问题:让模型"先查资料,再回答",而不是凭"记忆"瞎编。
NVIDIA 推出的 Context-Aware RAG(CA-RAG) 正是这一理念的深度实现。它不仅仅是一个 RAG 检索库,更是一套端到端的数据摄入 + 语义检索 + 知识图谱构建的完整基础设施,由 NVIDIA 企业级团队背书,专为需要处理结构化知识的企业场景设计。
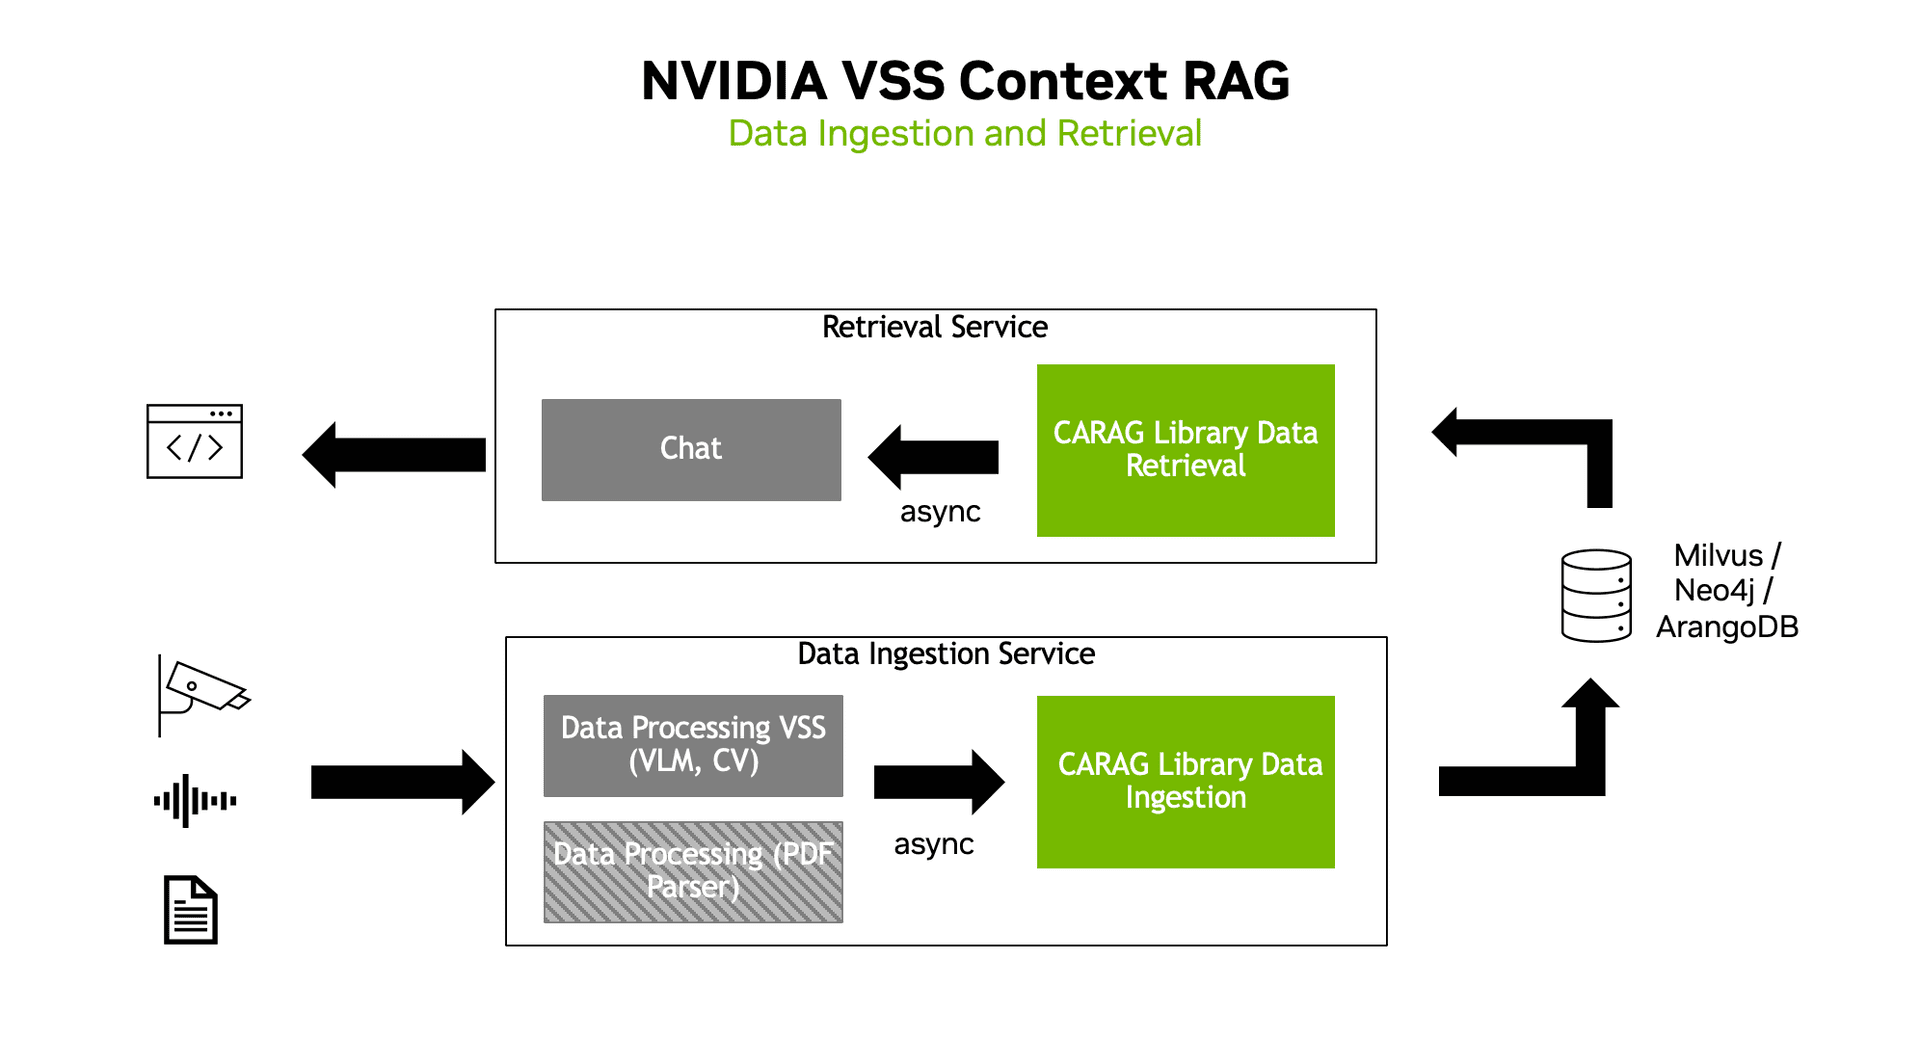 图1:CA-RAG 整体数据架构,支持多源数据摄入 → 图谱构建 → 语义检索全链路
传统 RAG 的做法很直接:把文档切成小块(chunk),每个块转成向量,存进向量数据库(如 Milvus)。用户提问时,把问题也转成向量,去向量库里找最相似的文本块,拼进 prompt 喂给 LLM。
这套方案在简单场景下效果不错,但有两个致命弱点:
GraphRAG(基于知识图谱的 RAG)正是为解决这两个问题而生。CA-RAG 则是 NVIDIA 给出的生产级 GraphRAG 实现方案,整合了 Neo4j 图数据库 + Milvus 向量数据库双重检索能力。
CA-RAG 提供了一套插件化的数据摄入框架,支持从多种数据源导入内容:
数据摄入后,内容被分解为两路存储:
 图2:数据摄入与检索的完整 Pipeline,支持向量检索 + 图谱检索双路召回
检索时,CA-RAG 支持三种策略:
| 检索策略 | 说明 | 适用场景 |
|---|---|---|
| 向量检索 | Milvus 语义相似性搜索 | 语义模糊的查询 |
| 图谱检索 | Neo4j Cypher 查询 | 关系型问题(如"谁向谁汇报?") |
| 混合检索 | 向量 + 图谱双路召回,RRF 融合排序 | 复杂问答 |
项目还内置了重排序(Reranker) 工具(基于 langchain-milvus 的 reranker 集成),进一步提升检索精度。
CA-RAG 原生集成 OpenTelemetry,通过 opentelemetry-sdk 和 OTLP 导出器,可对接 Prometheus、Grafana、Jaeger 等监控工具。docker-compose 中预置了完整的可观测性栈:Prometheus + Grafana + Phoenix(分布式追踪),开箱即用。
项目还提供了丰富的工具组件,可直接被 AI Agent 调用:
CA-RAG 的亮点之一是自动从非结构化文本中抽取知识图谱。通过 src/vss_ctx_rag/functions/rag/ 目录下的图谱构建函数,配合配置目录 config/ 中的 adv_graph_prompt.yaml 等提示词模板,LLM 被引导从文本中抽取三元组(实体-关系-实体),存入 Neo4j 图数据库。
| 层级 | 技术选型 |
|---|---|
| LLM 框架 | LangChain + LangChain-NVIDIA-AI-Endpoints |
| 向量数据库 | Milvus(通过 pymilvus) |
| 图数据库 | Neo4j(原生 Cypher) |
| 可选图库 | ArangoDB(通过 vss_ctx_rag_arango 插件) |
| 后端框架 | FastAPI + Uvicorn |
| 对象存储 | MinIO(S3 兼容) |
| 可观测性 | OpenTelemetry + Prometheus + Phoenix |
| 数据处理 | pdfplumber(PDF 解析) |
| 包管理 | uv(Astral 推出的高性能 Python 包管理器) |
src/vss_ctx_rag/
  base/          # 基类:Function(函数组件)、Tool(工具组件)
  context_manager/  # 上下文管理
  functions/     # 核心业务函数:rag/(图谱+检索)、summarization/(摘要生成)、notification/
  models/        # 数据模型定义
  plugins/       # 插件系统
  tools/         # 工具集:embedding/、llm/、reranker/、storage/、gnn/
  utils/         # 通用工具函数
架构上采用了 Component 模式:Function(负责业务逻辑)和 Tool(负责外部交互)均继承自各自的 Base 类,通过 Factory 模式动态实例化。这种设计让 CA-RAG 的扩展性很强——如果要新增一个 LLM 后端,只需实现对应的 Tool 子类,注册到 Factory 中即可。
tests/ 目录,配置了 .pre-commit-config.yaml 规范提交;LICENSE.3rdparty,清晰透明;# 1. 克隆仓库
git clone git@github.com:NVIDIA/context-aware-rag.git
cd context-aware-rag/
# 2. 配置环境变量(创建 .env)
# 需设置 NVIDIA_API_KEY、OPENAI_API_KEY 及各数据库密码
# 3. 构建 Docker 镜像
make -C docker build
# 4. 启动所有服务(数据摄入 + 检索 + Neo4j + Milvus + 监控栈)
make -C docker start_compose
启动后获得以下服务:
http://<HOST>:8000 — 数据检索服务http://<HOST>:8001 — 数据摄入服务http://<HOST>:7474 — Neo4j 图数据库管理界面http://<HOST>:16686 — Phoenix 分布式追踪界面http://<HOST>:9090 — Prometheus 监控界面# 要求 Python 3.12+
uv venv --seed .venv
source .venv/bin/activate
uv pip install -e . # 基础安装
uv pip install -e .[arango] # 可选:ArangoDB 支持
uv pip install -e .[nat] # 可选:NAT 支持
项目在 examples/ 目录提供了两个 Notebook:
pdf_qna.ipynb:演示如何对 PDF 进行问答;qna_nat.ipynb:演示 NAT(Named Entity Recognition + 图谱)增强问答。1. 部署复杂度较高:docker-compose 涉及 7+ 个容器(VSS-RAG-retriever、VSS-RAG-ingestion、Neo4j、Milvus、MinIO、Phoenix、Prometheus),初学者需要时间熟悉各组件作用。
2. GPU 强依赖:docker-compose 中 retriever 服务声明了 deploy.resources.reservations.devices: [gpu],没有 NVIDIA GPU 无法运行。虽然摄入服务可以在 CPU 上运行,但检索服务的 LLM 推理必须 GPU 支持。
3. API Key 管理:项目需要 NVIDIA NIM 或 OpenAI API Key,Key 管理和使用成本是企业用户需要考虑的问题。
4. 图谱抽取质量依赖 LLM:从非结构化文本中抽取高质量知识图谱,对提示词设计和 LLM 能力都有要求,"garbage in, garbage out" 的风险始终存在。
5. 相对小众:截至分析时约 89 stars(PIFS 数据),远不及 LangChain(80k+ stars)等成熟项目,新用户社区支持资源有限。
CA-RAG 体现了 RAG 领域的一个明确趋势:从"向量检索"向"知识图谱+向量混合"演进。GraphRAG 已成为微软、Meta 等大厂探索的方向,NVIDIA 的这一开源实现提供了完整可参考的工程实践。
同时,LangChain 的深度集成使得 CA-RAG 可以无缝接入更广泛的 Agent 生态。MCP 工具的提供更是瞄准了 Agent Workflow 的未来——在 AutoGPT、LangGraph 等 Agent 框架中直接调用 RAG 能力。
NVIDIA Context-Aware RAG 是一款生产级的知识图谱增强 RAG 基础设施库,适合需要处理复杂关系型问答、企业知识管理、多跳推理等场景的技术团队。它的优势在于架构完整(数据摄入→图谱构建→检索→可观测性全链路)、NVIDIA 官方背书、以及与 LangChain 生态的深度集成。
上手门槛主要集中在 Docker/微服务基础设施熟悉度、GPU 环境准备、以及 API Key 管理。如果你正在构建企业级 AI 知识库系统,CA-RAG 值得重点关注;如果只是个人学习或简单 RAG 需求,LangChain 自带的简单 RAG 功能可能更轻量。
