
auto-ontology
NVIDIA/auto-ontology加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
一个刚上 Hacker News 首页、两周内从 0 涨到 7700 星的项目,赌的是"Agent 写 SQL 的瓶颈不在模型,而在语义"。
想象这样一幕:某电商公司的业务负责人问 AI 助手:"6 月在宾夕法尼亚州,USB 食品闪光寿司卷这个产品的营收是多少?"
助手 3 秒返回:588.80 美元。
但财务团队不接受这个数字。原因是同一个"revenue",数据仓库里定义了三套口径:订单表用 extendedprice,结算表用含税金额,渠道表按实收记。这三套定义算出来的数字能差 12%。Agent 不知道该用哪一套,于是每次回答都像一个随机的骰子——答得再快,数字错了也一文不值。
NVIDIA 在 2026 年 10 月 21 日随 Agent Knowledge Foundation 一起发布的 Auto Ontology,赌的就是解决这件事:不改 Agent 的模型,不改数据库,而是在 Agent 和数据之间插一层"语义地图"。
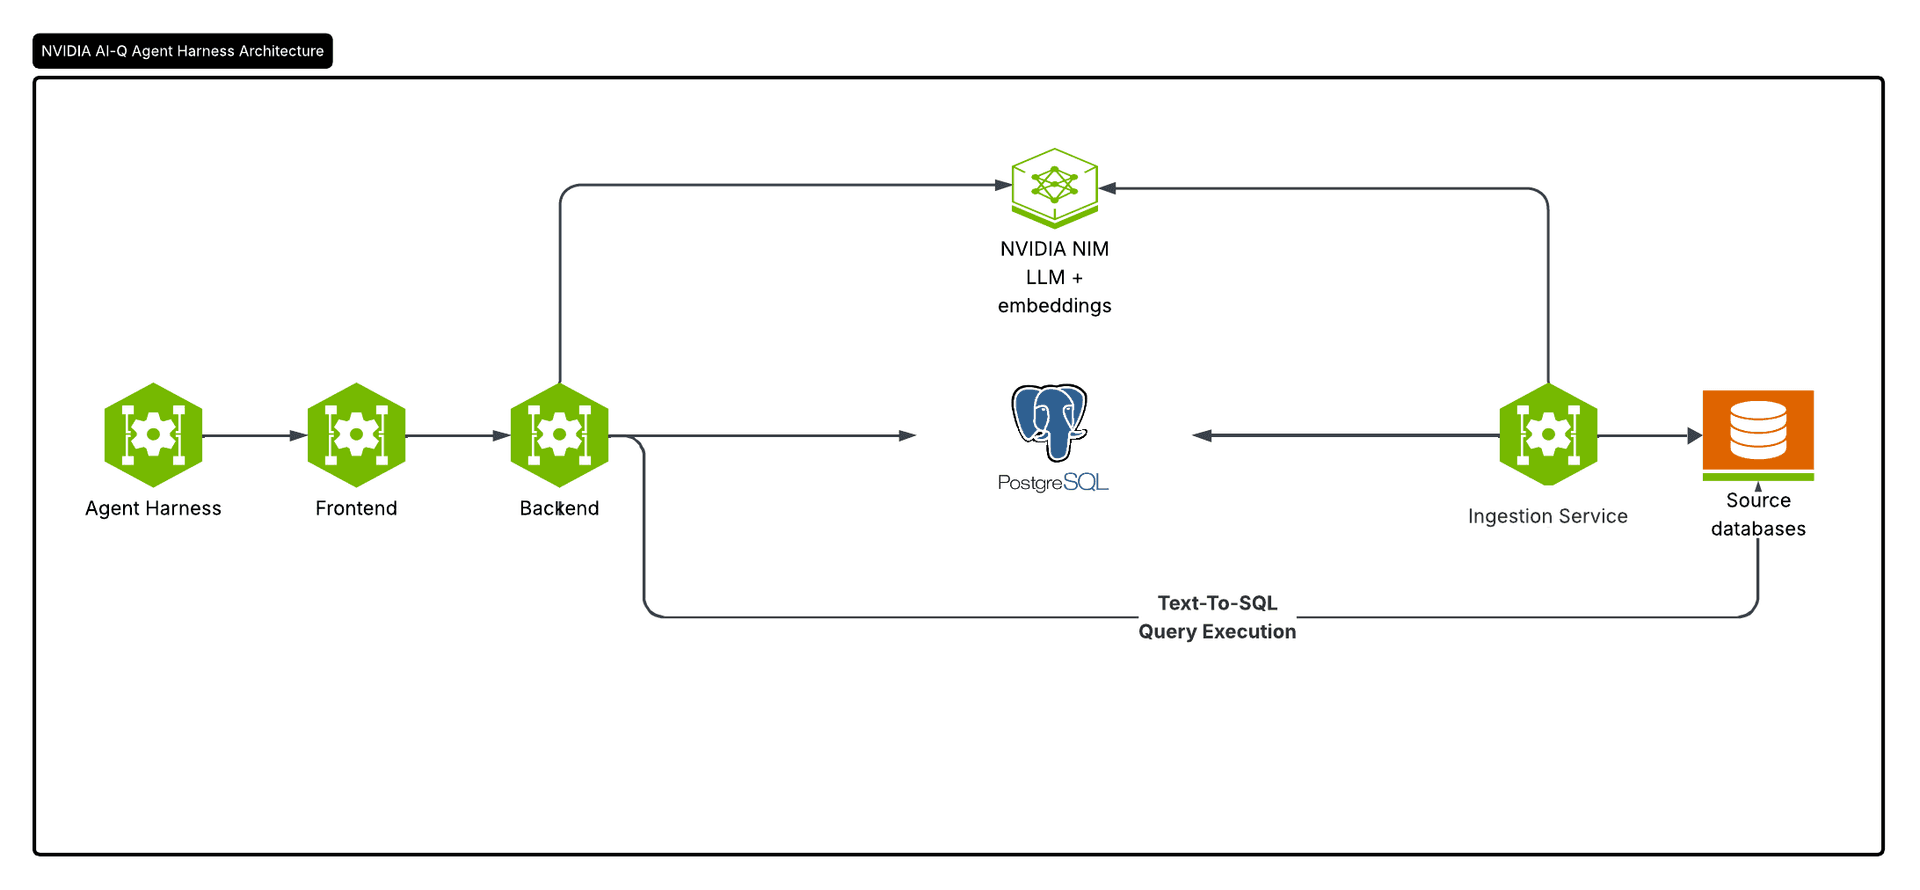
图:Auto Ontology 架构——从企业元数据生成本体,经人工认证,通过 MCP/CLI/API 暴露给任意 Agent Harness
这一代 Agent 工具链已经把"检索文档"和"查数据库"都做成了基本能力。但从工程角度看,两者之间还隔着一道鸿沟:Agent 知道数据在哪(表、字段、schema),却不知道数据是什么(哪个字段是"活跃客户")、能不能用(这条口径是否已认证)、该怎么用(正确的 JOIN 路径)、从哪来(血缘与来源)。
企业自身的语义模型(dbt metrics、Looker LookML、指标字典)通常散落在不同系统里,口径互相打架。Auto Ontology 的定位很明确:它不替代企业已有的语义模型,而是从企业元数据里自动生成一层本体的补充与对齐。
其产物是一张语义图谱,里面装三类定义:
README 里的 Wide World Importers 样例库跑完一次编译后生成了 31 个术语,在 UI 里点开 Order 就能看到它的描述、相关术语、映射列和 SQL 属性。
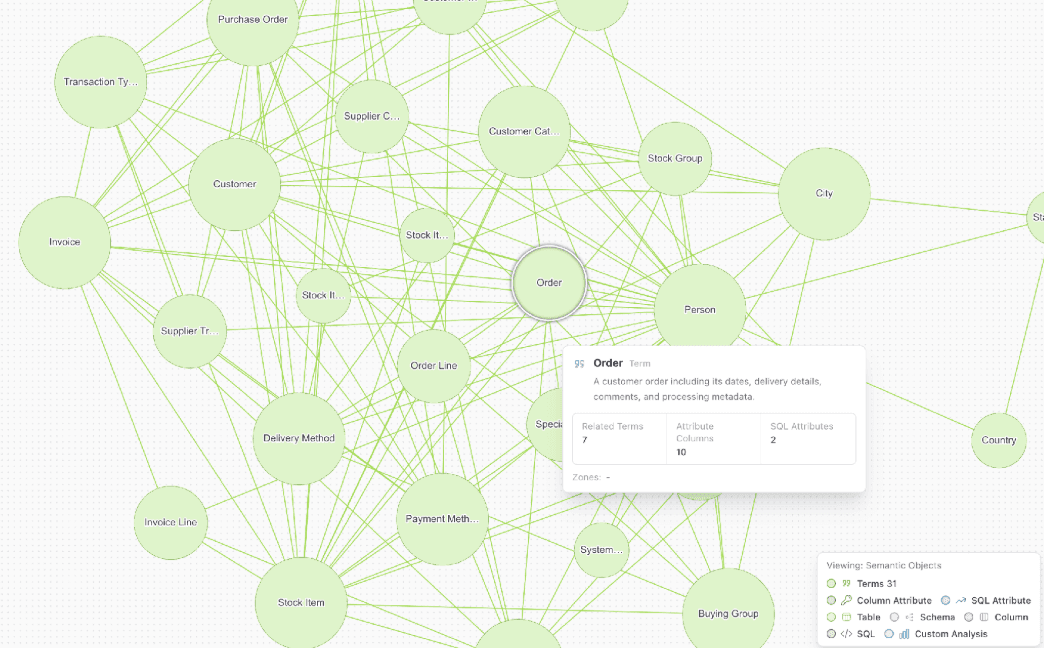
图:Wide World Importers 编译出的本体语义图谱,选中 Order 术语
如果 Agent 是个刚入职的分析师,这个框架就是给他配一位跟了公司五年的老员工:
老员工知道"营收"在这家公司指哪个字段,知道订单表要经客户表再经城市表才能落到州表,知道哪些指标定义已经过财务认证,也知道哪些问题数据根本答不了("广告投放 ROI"——库里压根没有广告数据)。
更妙的是这个老员工会拒绝回答。Auto Ontology 提供 check_answerable 工具,让 Agent 在生成 SQL 前先判断"本体里有没有词条覆盖这个问题",覆盖度不足就反问用户澄清,而不是硬编一个 SQL 出来糊弄。
摄取服务(ingestion service)从源数据库自动编译第一版本体:
人在 Web UI 或通过 API 里精修术语描述、SQL 属性,然后认证它们。README 里写得明白:"人让草稿变得可信。"
每个问题走五步固定流水线:
第 4 步是这类系统最容易被跳过、但最能决定准确率的一环。
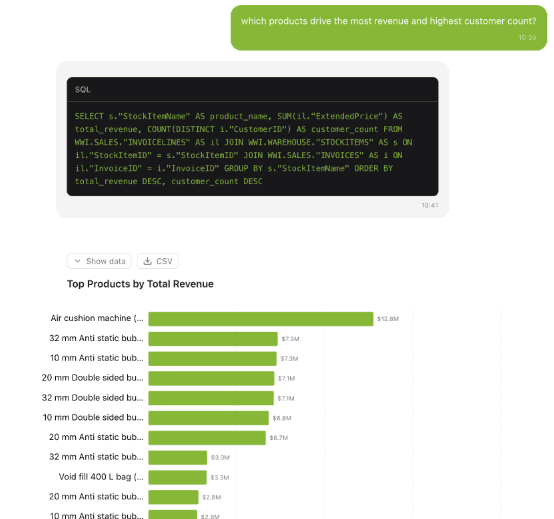
图:Chat 中生成的 SQL 与营收图表,可查看行数据、导出 CSV
| 方式 | 用途 | 说明 |
|---|---|---|
| MCP Server | 任意 Agent Harness | 9 个只读工具:check_readiness、search_terms、get_term、get_term_columns、get_term_sql_attributes、get_sql_attribute、describe_table、check_answerable、ask_question |
| CLI / REST API | 脚本与后端集成 | POST /api/chat/completions 返回 SSE 流,result 事件带答案 |
| Agent Skills | 编码 Agent | 三个 skill:nvidia-ontology-setup、nvidia-ontology-management、nvidia-ontology-query |
MCP 服务器刻意设计成只读:不提供浏览原始 schema 或裸列的工具,所有请求都必须走语义层;它自己不持有任何数据库凭据,身份完全由登录用户决定,"一个 viewer 只能拿到 viewer 的答案"。
uvx --from "git+https://github.com/NVIDIA/auto-ontology.git#subdirectory=mcp" auto-ontology-mcp
只需一个 AUTO_ONTOLOGY_API_URL,MCP 服务器就能挂到 Cursor 或 Claude Desktop 上。
git clone https://github.com/NVIDIA/auto-ontology.git && cd auto-ontology
cp .env.example .env   # 填 nvapi key、AUTH_SECRET、各类密码
docker compose up -d --wait postgres
docker compose up -d --build
打开 http://localhost:3000 登录,去 Settings → Semantic Compilation 打开语义编译开关,等提示 "Semantic compilation is ready" 就能在 Chat 里提问。
CPU 即可,不需要 GPU——推理走 NVIDIA NIM 云端端点(默认 nvidia/nemotron-3.5-lightning-30b-a3b 作推理、nemotron-3.5-embed-1b 作嵌入、nemotron-3.5-rerank-8b 作重排),也可自建 NIM 或任意 OpenAI 兼容端点。需要 Docker Compose v2、uv、PostgreSQL 17 + pgvector、Node 20+/pnpm(仅自建前端时)。
支持的源库有十种:PostgreSQL、MySQL、Databricks、Snowflake、ClickHouse、Trino、Apache Kyuubi、HeavyDB、DuckDB、SQLite。凭据可选存 HashiCorp Vault。
这一节比上面所有优点都重要。
1. 认证只是"徽章",不是"闸门"。 FDEInterviews 逐行读完 v1.1.0 代码后指出:术语上的 certified 标志(名称、描述、各列属性、各 SQL 定义)会被聚合成 certified/partial/pending 供展示,但在 text-to-SQL 链路上找不到对这些标志的任何引用。NVIDIA 自家的 management skill 文档也承认当前认证字段"不是一个原子的评审/晋升系统"。也就是说——Agent 可能用一个没人审过的定义去回答财务问题。若客户规则要求"只有评审过的定义才能答财务口径",这个检查得你自己写。
2. 没有公开的 text-to-SQL 准确率。 NVIDIA 自称本体构建时间下降 90%,但那是"建上下文层"的耗时,不是"SQL 对不对"。配套仓库 ontology-sql-eval 提供了评测工具箱(BIRD Dev 1534 题、mini-dev 500 题、FDABench-Lite 169 题、BEAVER 默认 100 题,schema-only 对照组 + 执行结果比对,不用 LLM judge),但只发布工具,不发布结果。FDEInterviews 直言:那些流传的"90%"数字在两个仓库里都找不到出处。在自己业务问题上跑过基准之前,准确率应视为未知。
3. 开源有星号。 许可证是 Apache-2.0,仓库公开,但 README 明说当前不接受外部贡献;MCP 安装指南里仍把 Auto Ontology 描述为"NVIDIA 内部使用",且截至 11 月 3 日 MCP 包尚未发布到 PyPI。要落地只能从仓库源码或 NGC 容器装。
4. 信任边界需要自己守。 FastAPI 直接信任前端转发来的 x-auto-ontology-user-id 头;摄取服务的 ingest/delete/reset/compile 端点自身没有任何认证。README 明确要求把 3001/3002 端口放在私有网络,客户端一律走 3000 端口的 Web 应用。自己组网时别照搬默认。
5. 门槛不止于 Docker。 首次运行要 clone 仓库、装 uv、配 .env 里的至少 6 处密钥、克隆另一个仓库跑种子脚本、打开语义编译开关等它编译完成。官方也承认要用 Wide World Importers 样例库先跑通。对想"五分钟看到效果"的人,这是一条长路。
Auto Ontology 的星标曲线很说明问题:11 月 3 日上 Hacker News 首页时约 3570 星,两天后我采集时已 7730 星。
它代表的方向很清晰:当 Agent 成为数据的主要消费者,语义层就要从"给 BI 看的目录"变成"给 Agent 用的契约"。 这个契约里不仅有表结构,还有"什么口径算权威""什么可以被回答""答案从哪来"。
三条线索汇合成这个趋势:
ossie-converters 里有 NVIDIA 转换器,可导入导出 Ossie YAML)。这让 dbt/Looker 资产不至于作废。给不同人的结论:
ontology-sql-eval,并自己补上"认证闸门"——这一环官方目前没做。uvx 起 MCP 服务器,接一个已有的 Auto Ontology 部署。一句话总结: Auto Ontology 证明了"Agent 写不对 SQL 不是模型不够强,而是没人告诉它什么是真的"。但它目前是一个设计正确、认证单薄、且还没交出成绩单的框架——值得密切跟踪,不宜盲目依赖。
