
TensorRT
NVIDIA/TensorRT加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你把一个训练好的 BERT 模型部署到线上,压测一看,吞吐只有每秒几十条。同事凑过来看了一眼 GPU 利用率:30%,显存占了大半,CPU 却在满负荷跑。问题出在哪?神经网络在 PyTorch 里是"逐层解释执行"的——每层算完存回显存,再交给下一层。中间那些显存读写、来回调度,就是实打实的等待。
TensorRT 干的事,本质上类似"把菜谱交给工厂":它接手网络定义,为目标 GPU 逐层挑选最快的内核,把原本分离的算子融合(Conv+BN+激活合成一个 kernel),最后编译成一个序列化的二进制文件——Engine(也叫 plan)。运行时只需反序列化这一个文件,一次性载入 GPU,不再有逐层解释的开销。
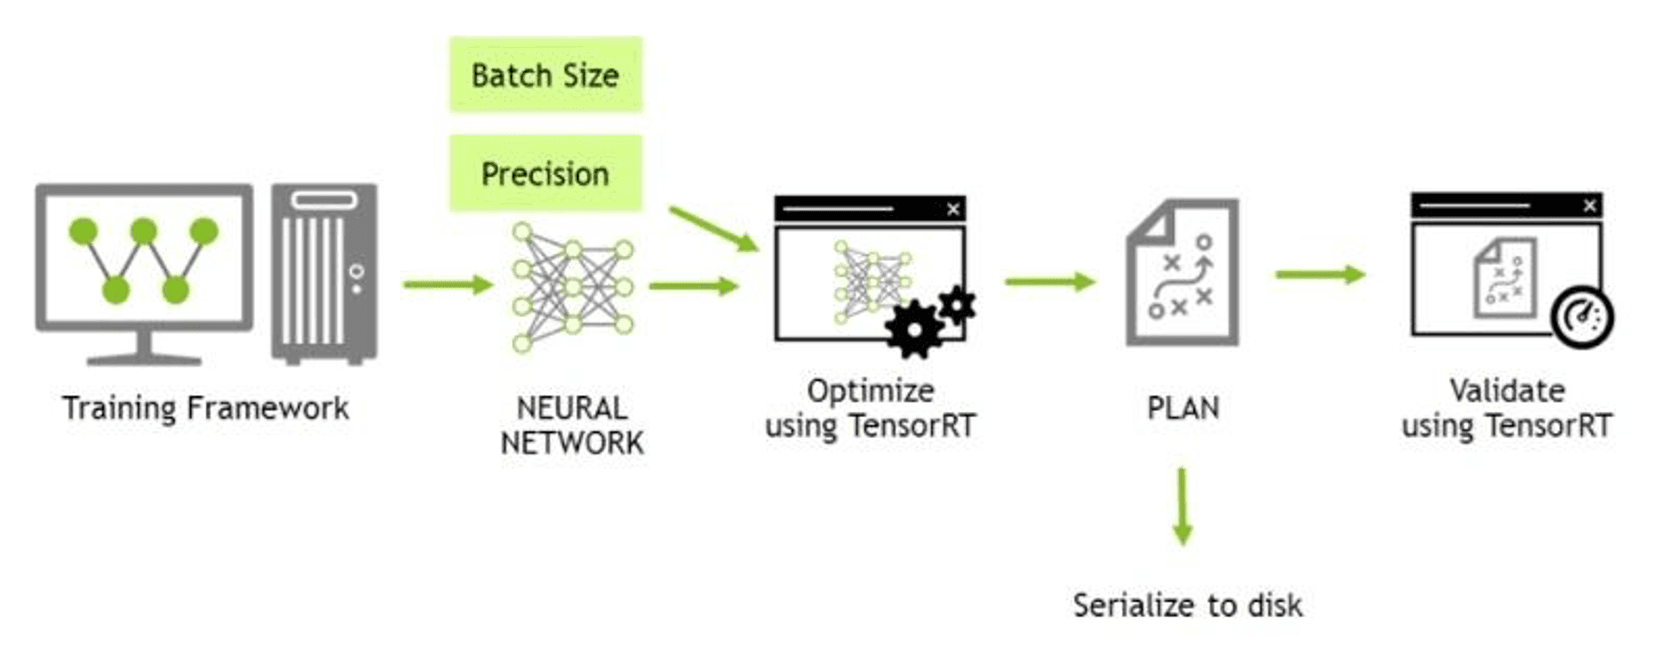
图:TensorRT 的 Build 阶段与 Runtime 阶段(来源:TensorRT Quickstart Notebook)
这里有个关键事实必须先讲清楚:GitHub 上这个仓库不是完整的 TensorRT,而是 TensorRT 的"开源组件子集"(TensorRT-OSS),采用 Apache-2.0 协议。2019 年 6 月,NVIDIA 在官方博客宣布开源 TensorRT 的解析器(parsers)和插件(plugins)两个部分。
仓库里真正有源码的是这些:
核心的 Builder/Runtime 内核、cuDNN 融合算法、层融合决策逻辑都是闭源的,NVIDIA 以预编译二进制 + 官方镜像 + NGC 分发的形式提供。所以你在 GitHub 上 clone 下来是编不出完整产品的——还需要从 NVIDIA Developer Zone 下载 TensorRT GA 包。
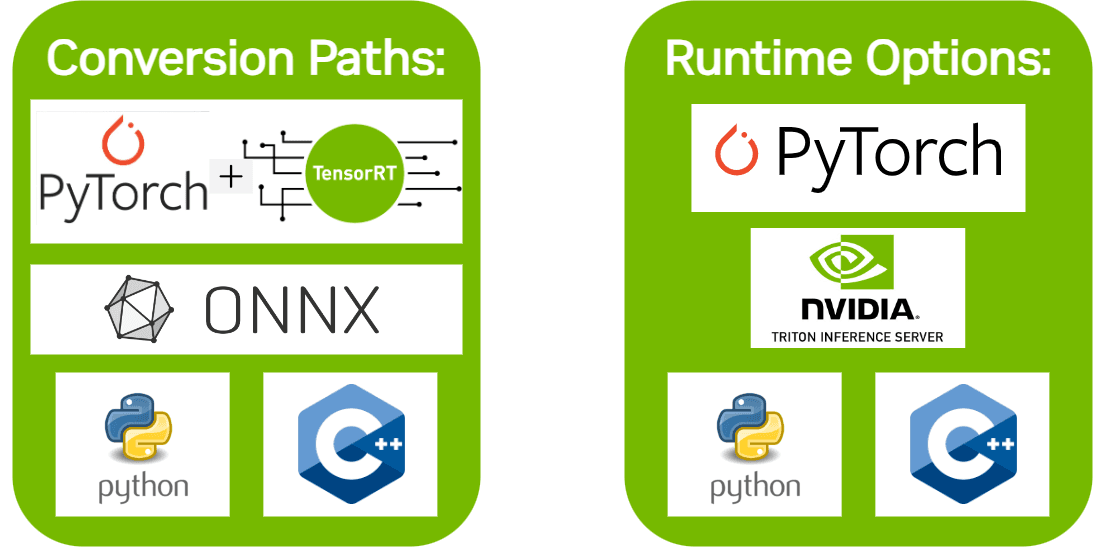
图:TensorRT 在 NVIDIA 推理栈中的位置(来源:TensorRT Quickstart Notebook)
1. 层融合(Layer Fusion) 把 Convolution + BatchNorm + ReLU 合并成一个 kernel,省掉中间结果落显存再读回的往返。对 ResNet 这类网络,典型收益在 20%~40%。
2. 内核自动调优 Builder 会针对具体的 GPU 型号与精度组合枚举候选实现并实测计时,选最快的。所以引擎文件(plan)是不可跨硬件迁移的——A100 上编译的引擎拿到 T4 上不能用,因为硬件指令集不同。这是使用 TensorRT 最容易踩的坑之一。
3. 显式量化(Explicit Quantization) TensorRT 11.x 彻底移除了"隐式量化"(设个 BuilderFlag::kINT8 就自动降精度的黑盒做法),改为显式地在网络里插入 Q/DQ 节点。这样精度损失可观测、可回退,工程上更可控。官方同时开源了 TopK V3 插件(移植自 TensorRT-LLM 的 AIR TopK 内核),支持比原生内核大得多的 K 值。
4. LLM 推理专项优化
11.x 新增 TRT_Attention、TRT_MoE、TRT_KVCacheUpdate 三个自定义算子;IAttention 支持 ragged(packed)批处理,可变长序列直接拼接而不用 padding 到最长长度;IKVCacheUpdateLayer 支持压缩更新;还支持多设备推理(把注意力层切分到多卡,需 NCCL ≥ 2.7)。Blackwell 架构(SM10x/SM110)上 MoE 推理的后端优化尤为明显。
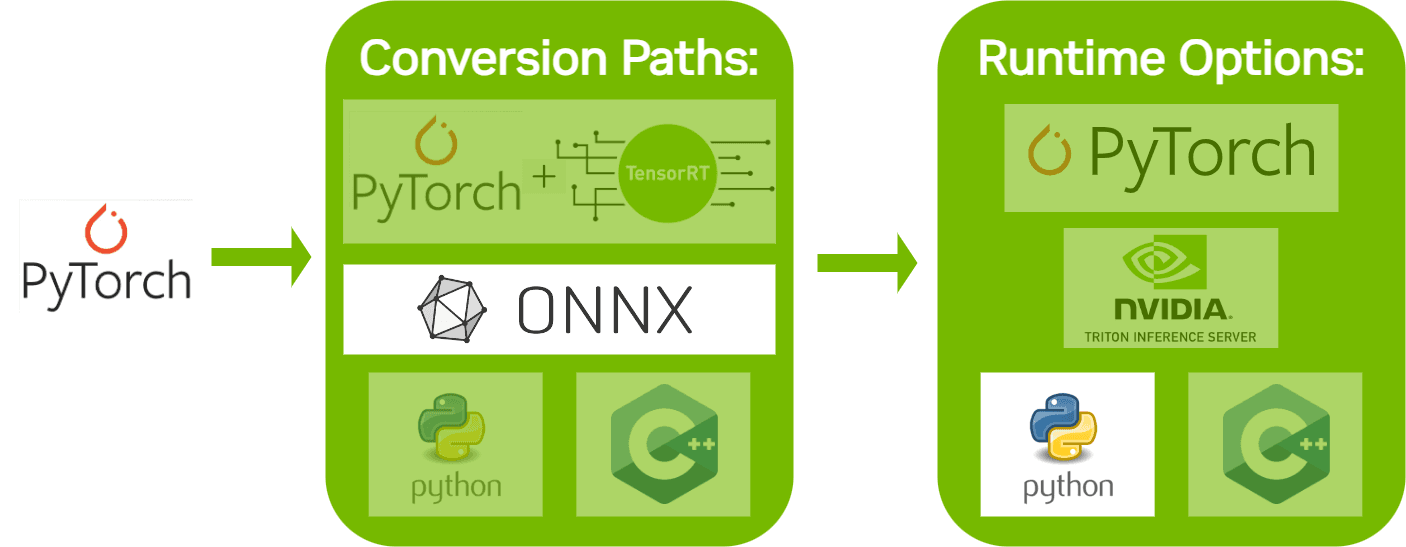
图:PyTorch 导出 ONNX 再导入 TensorRT 的标准路径(来源:TensorRT Quickstart Notebook)
路径 A:直接 pip 安装(最省事)
官方提供预编译的 tensorrt Python 包,能跳过整个编译环节:
pip install tensorrt
适合只想快速验证加速效果的人。
路径 B:官方容器(工程推荐)
docker/ 目录提供了 7 个 Dockerfile:ubuntu-22.04、ubuntu-24.04、ubuntu-26.04、ubuntu-24.04-aarch64、ubuntu-cross-aarch64、rockylinux8、rockylinux9。基础镜像是 nvidia/cuda:13.4.1-devel-ubuntu22.04,TensorRT 库预装在 /usr/lib/x86_64-linux-gnu,开箱即用且不用自己编译。
路径 C:源码编译 OSS 组件 前置条件相当硬:CUDA 12.9 或 13.4、CMake ≥ 3.31、GNU Make ≥ 4.1、Python 3.10–3.14、git submodule 递归拉取,还要先把 TensorRT GA 包(v11.4.0.106)从 Developer Zone 下载解压并指定路径。完整流程 2–6 小时属于乐观估计。
Web UI:没有。 这是个纯 SDK/命令行工具,没有可视化界面。图形化体验得靠 Nsight Deep Learning Designer(11.x 已用它取代 TREX 工具)、Polygraphy 的 Jupyter 示例,或者更上层的 Triton Inference Server。
硬门槛是 GPU:必须有 NVIDIA GPU 与驱动,且是 Ampere/Ada/Hopper 及更新架构。TensorRT 没有 CPU 后端。显存 8GB+、内存 16GB+、磁盘 20GB+ 是现实起点。这决定了它在没有独显的机器上完全跑不起来。
第一,开源不等于可用。 这是最容易被误读的点。GitHub 仓库里 2.47 亿字节的 C++ 代码里,核心推理引擎是缺失的。你能读到的是插件怎么写、解析器怎么转图、示例怎么用,但"为什么这次融合比上次快"的核心决策逻辑是黑盒。想深度定制推理栈的人,需要的是 TensorRT-LLM 而非 TensorRT。
第二,版本破坏性变更密集。 11.0 一次性砍掉弱类型网络、隐式量化、IPluginV2 全家桶(换 IPluginV3)、TREX 工具,Python 3.9 绑定移除,RHEL 8/9 的 RPM 改为依赖 Python 3.12。官方给出迁移指南,但升级意味着改代码。
第三,引擎反序列化的安全边界。 NVIDIA 官方文档明确警告:反序列化一个不可信来源的 engine 文件,等价于在 GPU 和主机上执行不受信任的原生代码,文件格式没有沙箱。多租户部署必须在可信主机上构建引擎,并通过签名、完整性校验的通道分发。
第四,硬件绑定带来的运维成本。 引擎与 GPU 型号强绑定,意味着从 A100 迁移到 H100 需要重新构建全部引擎;CI 环境里需要缓存不同硬件对应的二进制制品。
第五,社区规模有限。 贡献者仅 84 人,且绝大多数是 NVIDIA 内部工程师。虽然仓库从 2019 年至今保持高频发布(最新 v11.4,2026-10-09),但本质上仍是"单向开源 + 社区打补丁"的模式。
TensorRT 代表了一条清晰的技术路线:把推理从"通用解释执行"推向"目标硬件专用编译"。这个思路后来被 Intel OpenVINO、AMD Ryzen AI、华为 CANN、以及大量推理引擎(Triton、OpenVINO、ONNX Runtime、TensorRT-LLM)共同继承。
从数据看它的生命力:13,422 stars、2,418 forks、Apache-2.0 协议、2026 年一年内发布 11.0 到 11.4 共 5 个 GA 版本。更值得注意的是 .agents/skills/ 目录——NVIDIA 在仓库里放入了面向 AI 编码助手的技能包,Polygraphy 子项目也带了自己的 .agents/skills,说明连 NVIDIA 自己都在用 Agent 来做 SDK 的开发与调试工作流。
对国内团队的实际启示:如果你的业务是自有模型 + 自有 NVIDIA 显卡的推理服务,TensorRT(或封装它的 TensorRT-LLM / Triton)仍然是压榨 GPU 性能的首选;但要清楚它的封闭属性,避免把核心业务逻辑绑定在无法自控的编译产物上。同时注意 11.x 的 LLM 专项优化(ragged attention、MoE、多设备推理)——如果你的场景是自建 LLM 推理服务,评估 TensorRT-LLM 的性价比远高于直接用 TensorRT。
参考信息
